

Планирование и автоматизация: расписания, сенсоры, триггеры
dagster - это не только инструмент для оркестрации задач, но и целостная платформа для реализации управляемого и воспроизводимого конвейера данных. В контексте планирования он предлагает три базовых механизма: расписания, сенсоры и триггеры. Расписания обеспечивают предсказуемый запуск по времени, сенсоры - реактивность на внешние события и изменения данных, триггеры - управление стартами и повторными запусками в ответ на сценарии эксплуатации. Эта глава исследует архитектурные принципы, паттерны проектирования и практические подходы к внедрению планирования и автоматизации, с акцентом на устойчивость, воспроизводимость и наблюдаемость.
В рамках подхода hybrid мы сочетательно рассматриваем элементы архитектуры Dagster, функциональные возможности продукта и организационные процессы внедрения. Такое сочетание позволяет не только корректно проектировать конвейеры, но и выстраивать процессы управления изменениями, тестирования и эксплуатации pipeline‑экосистемы.
- Архитектура Dagster в части планирования: как взаимодействуют расписания, сенсоры и триггеры с Job/Pipeline, RunLauncher и хранилищем состояния.
- Практики моделирования времени: таймзоны,partitioning, окна выполнения и параметры запусков.
- Реактивность к данным: детекция появления данных, внешних событий и устойчивость к дубликатам.
- Операционная эффективность: наблюдаемость, тестирование планирования, CI/CD и безопасность.
Краткое содержание главы
- Архитектура планирования Dagster: компоненты, контракты и взаимодействия между планировщиком и исполнителем.
- Расписания: концепции, временные окна, параметризация запусков и паттерны динамических расписаний.
- Сенсоры: типы датчиков, паттерны детекции данных и взаимодействия с внешними системами.
- Триггеры: сценарии запуска, backfill и ручные триггеры, подходы к идемпотентности.
- Практики эксплуатации: мониторинг, тестирование, CI/CD, безопасность и управление изменениями.
Архитектура планирования Dagster
Архитектура Dagster в части планирования строится вокруг трёх координирующих механизмов: расписания, сенсоры и триггеры. Расписания выполняют временные запускы конвейеров, сенсоры следят за внешними событиями и создают RunRequest при обнаружении релевантной ситуации, триггеры - позволяют гибко управлять запуском, включая повторные запуски или реакцию на внешние сигналы. Все три механизма обмениваются с исполнительной частью через контракты RunRequest и события выполнения, что обеспечивает единое поведение и воспроизводимость независимо от среды исполнения.
Компоненты планирования и их роль
- Расписания (schedules) - предсказуемые по времени драйверы, задающие расписание для определённого набора задач. Они не зависят от внешних систем напрямую; их задача - инициировать запуск согласно заданному cron‑расписанию или иной форме временного графика.
- Сенсоры (sensors) - реактивные элементы, которые смотрят на внешние источники: файлы, очереди сообщений, изменения в базе данных и т. д. При срабатывании сенсор возвращает RunRequest или перечисляет несколько запусков, что позволяет создать реактивную архитектуру конвейера.
- Триггеры - механизмы управления запусками в сценариях эксплуатации: ручной запуск, всплытие событий, backfill и другие сценарии, которые требуют более сложной координации и обеспечения идемпотентного поведения.
Контракты между планировщиком и исполнителем устанавливают границы обмена информацией. RunRequest, возвращаемый сенсором или триггером, формирует параметры запуска, необходимые контейнерам исполнения. Важно обеспечить консистентность параметров и версий артефактов (код, зависимости, данные) между запусками, чтобы повторные прогоны не приводили к рассинхронизации результатов.
// Пример концептуального определения сенсора в Dagster
from dagster import sensor, RunRequest, SensorDefinition

@sensor(pipeline_name="data_pipeline")
def file_arrival_sensor(context):
    if context.has_file("s3://bucket/new_data.csv"):
        yield RunRequest(run_key="file_" + context.get_file_etag("s3://bucket/new_data.csv"))
В этом примере сенсор реагирует на появление нового файла во внешнем хранилище. Обратите внимание на идемпотентность: использование уникального ключа запуска позволяет повторно запустить конвейер без дублирования результатов.
Контракты и обмен данными: RunRequest и конфигурации
RunRequest - основной механизм передачи параметров запуска между планировщиком и исполнительной средой. Он может включать:
- идентификатор контекста (run_key) для идемпотентности;
- конфигурацию запуска (run_config);
- параметры, влияющие на выбор артефактов и источников;
- ссылку на конкретную версию кода или на арену выполнения (worker/launcher).
Управление версиями и зависимостями в контексте RunRequest критично для повторяемости. Необходимо применять паттерны "однообразной конфигурации" и "динамических параметров" только через безопасные каналы: переменные окружения, переменные в конфигурационных файлах и централизованные секреты. В противном случае повторные прогоны могут привести к неоднозначным результатам.
Работа с временем и зависимостями
Управление временем требует учёта часовых поясов и partitioning. Расписания и сенсоры должны корректно работать с часовыми поясами, особенно если конвейеры распределены по регионам или выполняются в разных кластерах. Партиионинг (partitioning) позволяет запускать одну и ту же логику по данным, разбитым по времени или по данным источника, что упорядочивает зависимые шаги и упрощает повторный прогон конкретной части данных.
Алгоритмы исполнения и устойчивость
При планировании важно учитывать:
- идемпотентность запусков: повторные запуски не должны приводить к дублированию данных;
- детерминированность: одинаковые входные параметры должны давать одинаковые результаты;
- устойчивость к сбоям: конфигурации повторного запуска, ретраи и backoff;
- мониторинг и трассировка: чтобы быстро локализовать проблему между планировщиком и исполнителем.
Эти принципы определяют не только архитектуру, но и требования к инфраструктуре: использование устойчивых хранилищ артефактов, единых версий образов исполнения и согласованных стратегий отката.
Расписания: концепции и модели
Расписания - это центральный конструкт, который задаёт регулярность прогонов, временные окна и параметры выполнения. В Dagster они реализуются через декорированные функции ScheduleDefinition или синхронные конструкторы, возвращающие RunRequest. Важно различать разные форматы расписаний и их влияние на данные конвейера.
Концепции расписания
- Временная ориентация: расписания работают в заданном временном окне, с учётом временной зоны и DST. Это критично для конвейеров, зависящих от расписания загрузки данных в регионе или от дневной нагрузки.
- Фрагментация по времени: partitions позволяют запускать одну и ту же логику с разной конфигурацией для разных периодов данных (например, по дням или по месяцам). Это улучшает управляемость и ускоряет ретроспективный прогон.
- Параметризация запусков: расписания могут динамически настраивать параметры запуска без изменения самого кода конвейера, что упрощает внедрение изменений и A/B‑пилоты.
Параметризация и динамические окна
Параметры запуска могут принимать значения из внешних источников или генерироваться внутри расписания. Важно обеспечить ограничение диапазона параметров и валидировать их на входе. Динамические окна выполнения позволяют адаптировать расписание под загрузку системы, например временно «тормозить» прогоны во времена пиковой нагрузки.
Пример конфигурации расписания
from dagster import schedule, job, RunRequest

@job(...)
def daily_etl():
    ...

@schedule(cron_schedule="0 2 * * *", job=daily_etl, execution_timezone="UTC")
def nightly_etl_schedule(_context):
    return RunRequest(
        run_key=None,
        run_config={
            "resources": {"db": {"config": {"schema": "staging"}}}
        }
    )
Данный пример иллюстрирует базовую схему: расписание инициирует запуск конвейера в заданное время и может передавать конфигурацию для конкретного дня. В реальных сценариях параметризация может включать выбор источника данных, параметры фильтрации, выбор брокера очередей и пр.
Управление временем и устойчивость расписаний
- Проверяйте корректность конфигураций: ошибки в конфигурации должны приводить к понятной диагностике и явной остановке прогона без частичного выполнения.
- Обработку временных сбоев держите в рамках ретраев и backoff‑путей, чтобы не перегружать систему и сохранять воспроизводимость.
- Инструменты мониторинга времени запуска и задержек необходимы: метрики по реализации расписания позволяют выявлять узкие места в инфраструктуре и оптимизировать пропускную способность.
Сенсоры: реактивность к данным и внешним событиям
Сенсоры обеспечивают реактивность потока данных: они следят за состоянием внешних систем, файловых площадок, очередей или метрик и запускают pipelines по событиям. Это один из ключевых механизмов охлаждения задержек и устранения «узких мест» в обработке данных.
Принципы работы сенсоров
- Политика детекта: сенсоры не просто «слушают» изменившиеся данные, они формируют RunRequest с необходимыми параметрами и, при необходимости, распределяют задания по нескольким конвейерам.
- Детекция идемпотентности: повторное срабатывание сенсора не должно приводить к дублированию результата, если состояние не изменилось. Обычно это достигается через запоминаемые ключи запусков (run_key) и проверку ранее запущенных задач.
- Локализация сбоев: сенсоры должны аккуратно обрабатывать временные отклонения во внешних системах и возвращать понятные сообщения об ошибках в логи и дашборды.
Типы сенсоров
- Файловые сенсоры: реагируют на появление файлов или изменений в облачном хранилище.
- Сенсоры баз данных: активируются при изменениях в таблицах или при достижении пороговых значений.
- Сообщения в очередях: реагируют на приход новых сообщений в Kafka, RabbitMQ или аналогичных системах.
Пример сенсора: детекция файла
from dagster import sensor, RunRequest

@sensor(pipeline_name="data_pipeline")
def new_file_sensor(context):
    if context.resources.storage.list_files("incoming/"):
        for f in context.resources.storage.list_files("incoming/"):
            yield RunRequest(run_key=f"process_{f.name}", tags={"source_file": f.name})
Здесь сенсор опрашивает хранилище и инициирует запуск для каждого нового файла. Важно учитывать возможность обработки батчами и ограничения по параллелизму, чтобы избежать гонок за ресурсы.
Типичные паттерны для сенсоров
- Батч-детекция: групповые события за фиксированный интервал времени, чтобы минимизировать перегрузку исполнения.
- Дедупликация на уровне сенсора: запись состояния последнего обработанного события для предотвращения повторного прогона.
- Этапность: сенсор может вызывать цепочку запусков, где первый запуск подготавливает данные, а последующие шаги расширяют конвейер.
Триггеры: управление запуском и повторными запусками
Триггеры выполняют роль дополнительных механизмов запуска вне обычного расписания и сенсоров. Они полезны, когда требуется гибкая координация, реагирование на outage‑события, обработка backfill‑задач и организация ручных запусков.
Типы триггеров и сценарии использования
- Ручные триггеры: запуск через UI/API для тестирования, откатов или специальных выпусков.
- Backfill-триггеры: повторная обработка исторических периодов, например пропусков за прошлые дни. Они обеспечивают согласованность данных при исправлениях и миграциях.
- Внешние триггеры: интеграция с системами управления событиями, которые инициируют прогон в ответ на бизнес‑событие. Это может включать внешние API‑запросы или события очереди.
Управление повторными запусками и идемпотентность
Управление повторными запусками требует явной политики обработки дубликатов. В Dagster можно использовать run_key и детерминированные параметры, чтобы повторный запуск не создавал противоречивых данных. В критических конвейерах желательно фиксировать последовательность шагов и ограничивать параллелизм для повторных прогонов, чтобы обеспечить детерминированность результатов.
Примеры триггеров и интеграции
- Ручной запуск через Dagster UI или API: позволяет операторам оперативно инициировать прогон для проверки изменений перед выпуском.
- Backfill workflow: частый сценарий для восстановления пропусков или исправления ошибок в данных в прошлом периоде. Dagster поддерживает управление зависимостями между параллельными прогонами и детальные логи процессов.
- Встраивание триггеров во внешние сервисы: например, система мониторинга может отправлять HTTP‑запрос, который запускает конвейер через Dagster API. В реальных условиях такие интеграции требуют строгого контроля прав доступа и защиты от атак повторного запуска.
Практики эксплуатации: мониторинг, тестирование и CI/CD
Любая система планирования обязана обладать средствами observability и устойчивыми операционными процессами. В Dagster это достигается через единый набор концепций: логи, метрики, трассировка и автоматизированное тестирование конвейеров в контексте расписаний, сенсоров и триггеров.
Наблюдаемость и мониторинг
- Метрики исполнения: длительности прогонов, задержки между запуском и началом выполнения, процент успешных прогонических запусков.
- Логи и трассировка: структурированные логи по каждому прогону, детальная трассировка шагов внутри pipeline.
- Алёрты: параметры SLA по времени, количество неуспешных прогонов и частота ретраев.
Тестирование планирования
- Юнит‑тесты для отдельных оповещений и сенсоров: эмуляция внешних событий без реальных зависимостей.
- Интеграционные тесты расписаний: проверка корректности cron‑вычислений, окон и зависимостей между запуском и конфигурациями.
- Энд‑ту‑энд тесты: включая сенсоры, расписания и исполнение в изолированной среде, чтобы проверить сценарии backfill и manual trigger.
CI/CD и инфраструктура
- Инфраструктура как код: хранение конфигураций планирования в репозитории и применение через IaC‑практики.
- Верификация изменений: автоматические проверки совместимости конфигураций и зависимостей перед внедрением в продакшн.
- Безопасность: минимизация прав доступа, шифрование секретов и аудиты изменений в расписаниях и сенсорах.
Безопасность и устойчивость
Политика доступа к данным и управляемость ключами должны быть встроены в процесс разработки и эксплуатации. Используйте отдельные средовые конфигурации для тестирования и продакшна, чтобы исключить риск случайных прогонов в продакшен окружении.
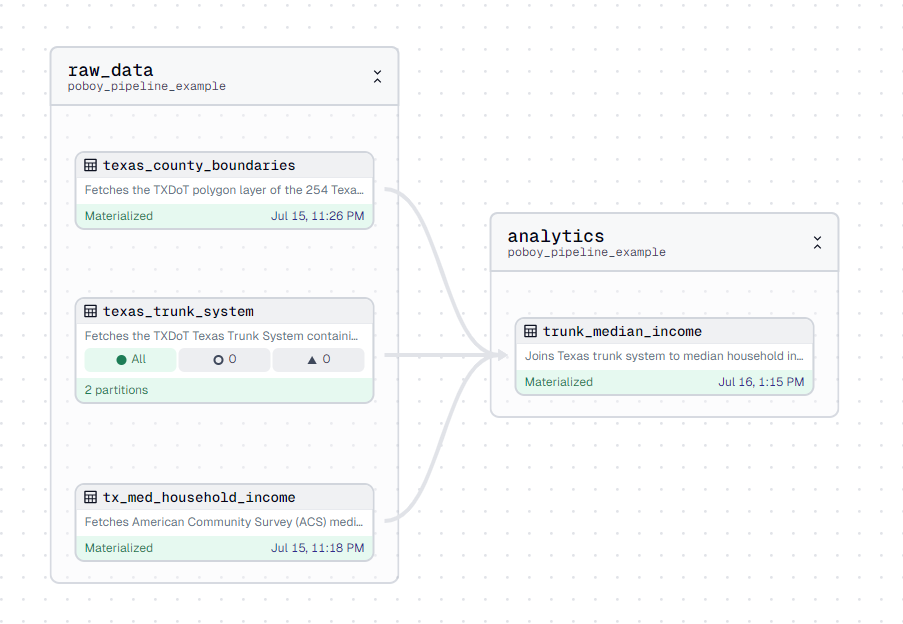
Примеры реализации архитектурных схем (практические паттерны)
- Паттерн «Time-and-events» объединяет расписания и сенсоры: расписания запускают конвейер по времени, сенсоры дополняют его реакциями на события, создавая единое окно данных.
- Паттерн «Partitioned backfill» - новая версия данных для определённых периодов: планирование поддерживает актуальную обработку, сенсоры отвечают за обнаружение изменений, триггеры управляют ретрансляциями и откатами.
- Паттерн «Idempotent RunRequests» - все прогонные данные сопровождаются уникальными ключами, чтобы повторные запуски минимизировали дублирование и риск неконсистентности.
Эти паттерны применимы как в моноредком окружении, так и в распределённых кластерах: они обеспечивают согласованность данных, устойчивость к сбоям и управляемость отраслевыми регламентами.
Key takeaways
- Расписания, сенсоры и триггеры образуют связочный слой планирования Dagster, обеспечивая и временную предсказуемость, и реактивность к данным.
- Контракты обмена RunRequest между планировщиком и исполнителем критически важны для воспроизводимости и детерминированности прогона.
- Включайте в архитектуруPartitioning и параметризацию запусков для гибкости и масштабируемости конвейеров.
- Обеспечивайте идемпотентность и детерминированность: повторные запуски не должны портить данные.
- Поддерживайте observability: мониторинг, логи, трассировку и алерты по расписаниям и сенсорам.
- Интегрируйте практики CI/CD и IaC для безопасной и повторяемой настройки планирования.
- Поддерживайте стандарты безопасности и управления изменениями при работе с планированием и данными.
FAQ
- Что такое RunRequest и зачем он нужен в Dagster?
RunRequest - это механизм передачи параметров запуска конвейера между планировщиком и механизмом исполнения. Он позволяет определить ключ прогона, конфигурацию и контекст, в котором будет выполнен pipeline. Это критично для воспроизводимости и управляемости запусков, особенно в сценариях сенсоров и триггеров, где каждый запуск зависит от внешних условий.
- Какой выбор между расписаниями и сенсорами в типичном конвейере?
Расписания подходят для предсказуемых, времённых прогонов, например ежночный ETL или утренние сборы. Сенсоры эффективны для реактивной обработки событий: появления файлов, изменений в БД, сообщений в очереди. В большинстве сценариев рекомендуется сочетать оба механизма: расписания для регулярных прогонов и сенсоры для событийной части, чтобы не пропускать критические данные и не терять задержку.
- Какие риски связаны с неправильной конфигурацией времени и часовых поясов?
Неправильная настройка часовых поясов может привести к неконсистентности данных между регионами, дублированию прогонов и пропуску критических окон. Решение - фиксировать ExecutionTimezone на уровне расписаний и тестировать конвертации времени в тестовой среде, особенно при миграциях и изменениях в инфраструктуре.
- Какие подходы обеспечивают идемпотентность при сенсорных запусках?
Используйте run_key, уникальные идентификаторы запуска и запоминайте состояние последнего обработанного события. В случаях сенсоров, которые могут инициировать несколько прогонов для одного события, применяйте дедупликацию на уровне сенсора и ограничивайте параллельность.
- Как обеспечить устойчивость к сбоям и безопасное откатывание?
Включайте ретраи и backoff-политики для прогонов. Планы отката должны быть частью конфигурации и тестироваться в CI. При backfill важно контролировать зависимые прогоны, чтобы не нарушать целостность данных в прошлых периодах.
- Какие практики наблюдаемости являются критичными для планирования?
Ключевые аспекты - метрики задержек между запуском и началом выполнения, доля успешных прогонов, частота ретраев и время обработки. Логи должны быть структурированными и доступными через дашборды. Трассировка полезна для локализации проблем в рамках цепочки запуска.
- Как интегрировать CI/CD с планированием Dagster?
Храните конфигурации планирования в системе контроля версий, применяйте IaC для инфраструктуры планирования, тестируйте изменения в изолированной среде, где воспроизводимость прогонов подтверждается через автоматические тесты. Включайте проверки совместимости параметров и зависимостей перед внедрением изменений в продакшн.
- Какие типичные ошибки при внедрении сенсоров и как их избегать?
Среди частых ошибок - опрос целевых систем слишком часто, недооценка задержек внешних сервисов, отсутствие ограничений на параллелизм и недостаточная обработка ошибок связи. Избегайте «обхода» внешних ограничений через агрессивное параллелирование, внедряйте ограничение количества concurrent запусков и используйте ограниченные интервалы повторных попыток.
- Как эффективнее тестировать планирование в Dagster?
Проводите модульные тесты для сенсоров и расписаний, эмулируя внешние события. Разрабатывайте интеграционные тесты, которые запускают конвейеры под разными конфигурациями и временными условиями. Энд‑ту‑энд тесты должны покрывать сценарии backfill и ручных запусков, включая мониторинг и алерты.
- Какие открытия в архитектуре помогают масштабировать планирование?
Ключевые решения - поддержка partitioning и динамических параметров, ограничение параллелизма и корректная обработка зависимостей между прогонами. Архитектура должна разделять зоны планирования и исполнения, обеспечивая устойчивость к задержкам в внешних системах и облегчающую миграцию конфигураций между средами.


