

Руководство по созданию платформы данных
Существует множество технологий, которые можно использовать для создания платформы данных.., но что Вам действительно нужно?
Один из самых частых вопросов, которые мы получаем от клиентов звучит так: "Как мне создать платформу данных ?”
Для большинства организаций создание платформы данных - это не просто что-то что хотелось бы иметь, а необходимость. Многие компании выделяются на фоне конкурентов благодаря способности извлекать из имеющихся данных эффективные решения.
Тем не менее, обосновать бюджет, ресурсы и сроки, необходимые для создания платформы данных с нуля не так-то и просто. Каждая компания находится на разных этапах развития в области данных, что усложняет определение приоритетов, в какие части платформы следует инвестировать в первую очередь. Как и в случае с любым другим новым решением, Вам необходимо 1) определить, какие ожидания может «закрыть» продукт, а какие нет, и 2) планировать как долгосрочную, так и краткосрочную окупаемость инвестиций.
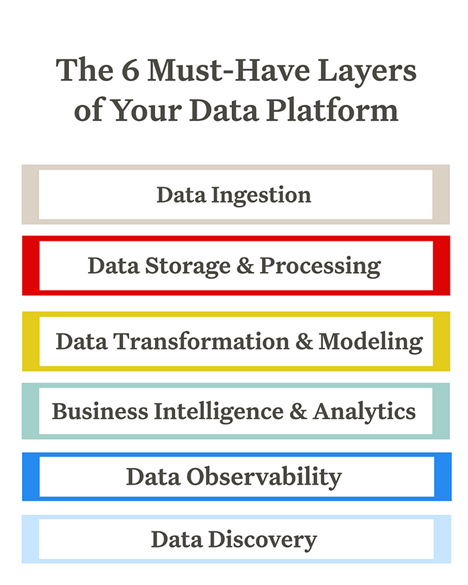
Чтобы несколько упростить задачу, мы описали 6 обязательных уровней, которые необходимо включить в платформу данных, а также порядок, в котором профи предпочитают их внедрять.
Представляем Вашему вниманию 6-уровневую платформу данных
После вопроса "как создать платформу данных?" самым частым вопросом, который я получаю - "с чего начать?".
Само собой разумеется, что создание платформы данных - это не универсальная задача, и рассмотренные нами уровни (и инструменты) - это лишь малая часть того, что доступно на современном рынке. "Правильный" стек данных будет выглядеть совершенно иначе для компании электронной коммерции со штатом в 5000 человек, чем для стартапа со штатом в 200 человек, но есть несколько основных уровней, которые в той или иной форме должны присутствовать во всех платформах данных.
Имейте в виду: по аналогии с тем, как нельзя построить дом без фунд амента, каркаса и крыши, настоящую платформу данных нельзя построить без каждого из этих 6 уровней. Но как именно Вы решите построить свою платформу данных, зависит только от Вас.
Ниже мы расскажем о том, как выглядит "базовая" платформа данных, и перечислим несколько самых популярных инструментов (скорее всего, Вы уже используете несколько из них):
Ввод данных
Первый уровень? Ввод данных.
Данные не могут быть обработаны, сохранены, преобразованы и применены, если они не были сначала получены. Как и в случае с практически любой современной платформой данных, возникает необходимость переводить данные из одной системы в другую. Поскольку инфраструктуры данных становятся все более сложными, перед командами специалистов по работе с данными встает непростая задача получения структурированных и неструктурированных данных из самых разных источников. Это часто называют этапом извлечения и загрузки данных - Extract Transform Load (ETL) и Extract Load Transform (ELT).
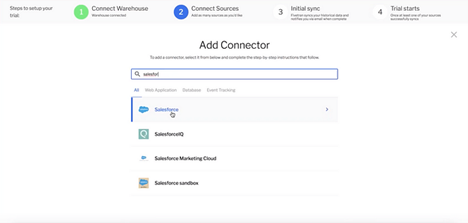
Ниже мы приводим описание некоторых популярных инструментов в этой области:
- Fivetran — ведущее корпоративное решение ETL, которое управляет доставкой данных от источника данных до места назначения;
- Singer — open source инструмент для перемещения данных из любого источника в любой пункт назначения;
- Stitch — облачная платформа с открытым исходным кодом, позволяющая быстро перемещать данные из любого источника в любой пункт назначения;
- Airbyte —open source платформа, которая позволяет легко синхронизировать данные из разных приложений;
- Apache Kafka —open source платформа для обработки потоковой аналитики и ввода данных.
Даже при наличии большого количества инструментов для ввода данных, доступных на современном рынке, некоторые команды по работе с данными предпочитают создавать собственный код для ввода данных из внутренних и внешних источников, а многие организации даже создают собственные фреймворки для решения этой задачи.
Оркестрация и автоматизация рабочих процессов с помощью таких инструментов, как Apache Airflow, Prefect и Dagster также часто встраиваются в уровень ввода данных.
Однако я бы сказал, что оркестрацию можно (и нужно) встраивать в платформу только после того, как Вы справитесь с уровнями хранения, обработки и бизнес-аналитики.
Хранение и обработка данных
После создания уровня ввода данных необходимо место для их хранения и обработки. Поскольку компании переносят свои ландшафты данных в облако, облачно-нативные data warehouses, data lakes и даже data lakehouses завоевали рынок, предлагая более доступные и недорогие варианты хранения данных по сравнению со многими локальными решениями.
Выбор хранилища данных, озера данных или их комбинации зависит только от потребностей данных. В последнее время активно обсуждается вопрос о выборе решений с открытым или закрытым исходным кодом (диалог между маркетинговыми командами Snowflake и Databricks’ действительно проливает на это свет), когда дело доходит до создания стека данных.
Независимо от того, чью сторону займете именно Вы, Вам будет сложно создать масштабируемую и гибкую платформу данных без инвестиций в облачные хранилища и вычисления.
Ниже мы перечислим некоторые самые популярные варианты в области современных облачных хранилищ, озер или [вставьте здесь свой вариант]:
- Snowflake —облачное хранилище данных Snowflake обеспечивает гибкую структуру оплаты, поскольку пользователи платят за вычисления и хранение данных по отдельности;
- Google BigQuery — Облачное хранилище Google BigQuery обеспечивает бессерверную архитектуру, которая позволяет быстро выполнять запросы за счет параллельной обработки;
- Amazon Redshift — Amazon Redshift, один из наиболее распространенных вариантов, работает на базе Amazon Web Services (AWS) и легко интегрируется с другими инструментами для работы с данными;
- Firebolt — Облачное хранилище данных на базе SQL, которое утверждает, что его производительность в 182 раза выше, чем у других вариантов, поскольку хранилище обрабатывает данные более легким способом благодаря новым методам сжатия данных;
- Microsoft Azure — Облачные вычисления от Microsoft распространены среди команд, использующих мощные интеграции Windows;
- Amazon S3 — S3 - служба объектного хранения структурированных и неструктурированных данных - предоставляет вычислительные ресурсы для создания озера данных с нуля;
- Databricks — Databricks, платформа Apache Spark, стала пионером в области озер данных, предоставляя пользователям возможность использовать как структурированные, так и неструктурированные данные и предлагая недорогие функции хранения данных, характерные для озер данных.
- Dremio — движок Dremio для работы с озерами данных предоставляет аналитикам, специалистам по исследованию данных и дата-инженерам интегрированный интерфейс самообслуживания для работы с озерами данных;
- Starburst — Starburst предоставляет PrestoSQL (теперь Trino) в качестве управляемой услуги, облегчая анализ и доступ к данным в Вашем озере данных.
Трансформация и моделирование данных
Преобразование данных и моделирование часто используются как взаимозаменяемые понятия, но это два совершенно разных процесса. Когда Вы преобразуете данные, Вы берете необработанные данные и очищаете их с помощью бизнес-логики, чтобы подготовить данные для анализа и отчетности. Когда Вы моделируете данные, Вы создаете визуальное представление данных для хранения в хранилище данных.
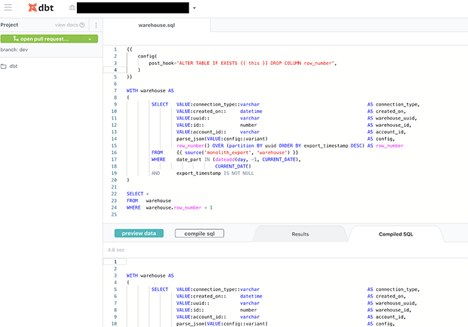
Ниже мы приводим список популярных инструментов, которые позволяют дата-инженерам эффективно преобразовывать и моделировать данные:
- dbt — Сокращение от data build tool - инструмент с открытым исходным кодом для трансформации данныхa после их загрузки в хранилище;
- Dataform — теперь часть Google Cloud. Данный инструмент позволяет преобразовывать необработанные данные из Вашего хранилища в данные, пригодные для использования инструментами BI и аналитики;
- Sequel Server Integration Services (SSIS) — инструмент, разработанный компанией Microsoft, который позволяет извлекать и преобразовывать данные из различных источников, которые затем можно использовать для загрузки в выбранное место назначения;
- Пользовательский код Python и Apache Airflow — до появления таких инструментов, как dbt и Dataform, дата-инженеры писали свои «преобразования» на чистом Python. Хотя использование пользовательского кода для преобразования данных может быть достаточно заманчивым, оно увеличивает вероятность ошибок, поскольку код нелегко воспроизвести и его приходится переписывать каждый раз, когда происходит процесс трансформации.
Уровень трансформации и моделирования данных превращает их в нечто более полезное и удобоваримое, подготавливая их к следующему этапу своего путешествия - аналитике.
Business Intelligence (BI) и Аналитика
Данные, которые Вы собрали, преобразовали и сохранили для своего бизнеса, не принесут никакой пользы, если Ваши сотрудники не смогут ими воспользоваться.
Если бы платформа данных была книгой, то слой BI и аналитики был бы ее обложкой, дополненной привлекательным названием, визуальными эффектами и кратким изложением того, что данные на самом деле пытаются Вам сказать. Именно этот уровень чаще всего приходит на ум конечным пользователям, когда они представляют себе платформу данных, и не зря: он делает данные действенными и интеллектуальными, без него Ваши данные не имеют никакого смысла.
Ниже мы приводим описание некоторых BI-решений, которые популярны среди профи по работе с данными:
- Looker — BI-платформа, оптимизированная для работы с большими данными и позволяющая членам Вашей команды легко сотрудничать в процессе создании отчетов и дашбордов;
- Tableau — его часто называют лидером в BI-индустрии, отличительная особенность - простой в использовании интерфейс;
- Mode — платформа для совместной работы с данными, объединяющая SQL, R, Python и визуальную аналитику в едином пользовательском интерфейсе;
- Power BI — инструмент на базе Microsoft, который легко интегрируется с Excel и обеспечивает возможность самообслуживание в области аналитики для всех членов Вашей команды.
Этот список ни в коем случае не является исчерпывающим, но он поможет Вам начать поиск подходящего BI-уровня именно для Вашего стека.
Наблюдаемость данных
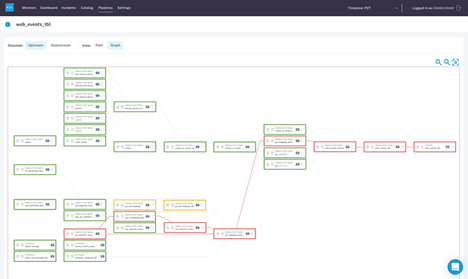
Поскольку конвейеры данных становятся все более сложными, а организации полагаются на данные для принятия своих решений, необходимо, чтобы поступающие, хранящиеся, обрабатываемые, анализируемые и преобразуемые данные были надежными и достоверными. Проще говоря, организации больше не могут позволить, чтобы данные были неполными, неточными или ошибочными.
Применяя те же принципы наблюдаемости приложений и проектирования инфраструктуры к нашим платформам данных, команды по работе с данными могут гарантировать, что данные будут пригодны для использования и принятия решений. По нашему мнению, зачастую хуже принимать решения на основе плохих данных, чем не иметь никаких данных вообще.
Ваш уровень наблюдаемости данных должен быть способен отслеживать и предупреждать о следующих составляющих наблюдаемости:
- Свежесть: свежие ли у Вас данные? Когда они были сгенерированы в последний раз? Какие исходные данные включены/не включены?
- Распределение: находятся ли данные в пределах допустимых диапазонов? Правильно ли они отформатированы? Полны ли они?
- Объем: все ли данные поступили?
- Схема: какова схема и как она изменилась? Кто и по каким причинам внес эти изменения?
- История: для каждого конкретного актива данных: каковы источники и активы, расположенные выше и ниже по течению, на которые он влияет? Кто генерирует эти данные и кто полагается на них при принятии решений?
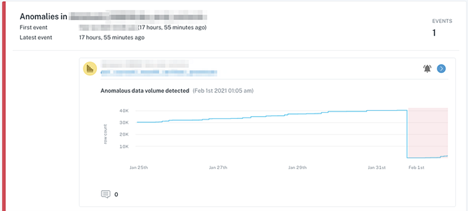
Эффективное решение для наблюдения за данными быстро и без проблем подключается к существующему стеку, обеспечивая сквозной контроль, который позволяет отслеживать последующие зависимости. Кроме того, оно будет автоматически отслеживать данные в состоянии покоя, не требуя извлечения данных из хранилища. Такой подход гарантирует соответствие самым высоким требованиям безопасности.
Обнаружение данных
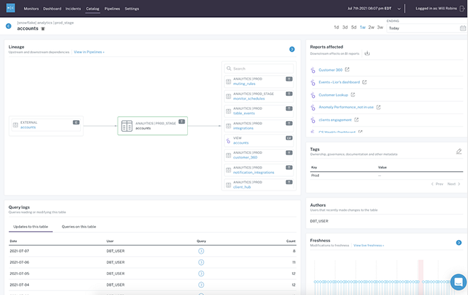
При создании платформы данных большинство руководителей ставят перед собой задачу выбора (или создания) каталога данных, но, на наш взгляд, такой подход уже недостаточен.
Не поймите меня неправильно: каталоги данных важны, и современным командам, работающим с данными, необходим надежный, масштабируемый способ документирования и понимания критически важных активов данных. Но поскольку данные становятся все более сложными и работают в режиме реального времени, процессы и технологии, лежащие в основе этого уровня платформы, тоже должны развиваться.
Там, где традиционные каталоги данных несовершенны (например, ручное управление, плохая масштабируемость, отсутствие поддержки неструктурированных данных и т. д.), на помощь приходит обнаружение данных. Если традиционные каталоги данных - это карта, то обнаружение данных - это навигационная система Вашего смартфона, постоянно обновляемая и дополняемая самой последней информацией.
Как минимум, обнаружение данных должно решать следующие задачи:
- Самостоятельное обнаружение и автоматизация: команды, работающие с данными, должны иметь возможность легко использовать свой каталог данных, не прибегая к услугам специальной группы поддержки. Самообслуживание, автоматизация и оркестрация рабочих процессов для инструментария данных устраняют разделение между этапами конвейера данных, упрощая доступ к данным. Повышение доступности естественным образом ведет к росту внедрения данных, снижая нагрузку на команду дата-инженеров;
- Масштабируемость по мере изменения данных: по мере того как компании получают все больше данных, а неструктурированные данные становятся нормой, способность масштабироваться будет иметь решающее значение для успеха Ваших инициатив в области данных. Обнаружение данных использует машинное обучение, чтобы получить представление о Ваших активах данных по мере их масштабирования. Таким образом, потребители данных получают возможность принимать более разумные и обоснованные решения, а не полагаться на устаревшую документацию или, что еще хуже, принимать решения, полагаясь на интуицию;
- Видимость состояния данных в режиме реального времени: в отличие от традиционного каталога данных, обнаружение данных обеспечивает видимость текущего состояния данных в режиме реального времени, в отличие от их "каталогизированного" или идеального состояния. Поскольку обнаружение охватывает то, как Ваши данные поступают, хранятся, агрегируются и используются потребителями, Вы можете понять, является ли данный набор данных достоверным или когда данная таблица была обновлена в последний раз;
- Поддержка управления и оптимизации хранилищ/озер данных: с точки зрения управления, запросы и обработка данных в озере часто выполняются с использованием различных инструментов и технологий (Spark на Databricks, Presto на EMR и т. д.), в результате часто нет единого, надежного источника истины для чтения и записи (как это делает хранилище). Правильный инструмент обнаружения данных может служить таким центральным источником истины.
Обнаружение данных позволяет командам, работающим с данными, убедиться в том, что их предположения о данных соответствуют реальности, что обеспечивает высокую степень надежности всей инфраструктуры данных, независимо от домена.
Создать или купить свою 6-уровневую платформу данных? Единого правильного ответа не существует
Создание платформы данных - непростая задача, и при ее решении необходимо учитывать множество факторов. Одна из самых больших проблем, с которой сталкиваются наши клиенты, заключается в том, создавать ли определенные уровни только своими силами, инвестировать в SaaS-решения или исследовать широкий мир открытого кода.
Наш ответ? Если Вы не Airbnb, Netflix или Uber, то, как правило, Вам необходимо использовать все три варианта.
У каждого из этих решений есть свои плюсы и минусы, но Ваше решение будет зависеть от многих факторов, включая:
- Размер Вашей команды по работе с данными. У дата - инженеров и аналитиков забот хватает; требовать от них создания собственных инструментов может занять гораздо больше времени, чем Вы думаете (и обойтись гораздо дороже, чем Вы можете себе представить). Инвестиции в легко настраиваемые, автоматизированные или популярные решения (например, с открытым исходным кодом или SaaS с кодом/без кода) – выбор многих команд по работе с данными, не относящихся к Uber/Airbnb/Netflix.
- Объем данных, которые хранит и обрабатывает Ваша организация. При выборе решения важно выбрать то, которое сможет масштабироваться по мере развития Вашего бизнеса. Одинокому волку-аналитику данных в компании из 20 человек нет смысла покупать решение для трансформации данных за 10 тысяч долларов в год, если все, что Вам нужно для выполнения работы - это всего лишь несколько строк кода;
- Бюджет Вашей команды по работе с данными. Если Ваша команда работает с ограниченным бюджетом, но при этом располагает большим количеством рабочих рук, то варианты с открытым исходным кодом вполне могут Вам подойти. Однако имейте в виду, что при настройке и внедрении инструментов с открытым исходным кодом в стеке данных Вы, как правило, предоставлены сами себе. Если принять во внимание тот факт, что только 2 процента от общего количества проектов демонстрируют реальный рост по истечении первых нескольких лет работы, нужно быть максимально осторожным и внимательным с тем, что Вы продаете.
Независимо от того, какой путь Вы выберете, создание выше перечисленных основных уровней обеспечит Вам мощный фундамент для дальнейшего роста и масштабирования, а главное - для предоставления информации и продуктов, которым Ваша компания сможет доверять.
В конце концов, иногда самый простой вариант - это самое лучшее решение.


