

Архитектура медальона: лучшие практики по управлению бронзовым, серебряным и золотым слоями
Многие мои клиенты используют архитектуру медальона для логической организации данных в Lakehouse. Они обрабатывают входящие данные, пропуская их через различные этапы или слои. Наиболее распространенная схема, показанная ниже, включает в себя бронзовый, серебряный и золотой слои, поэтому и используется термин «Архитектура медальона».
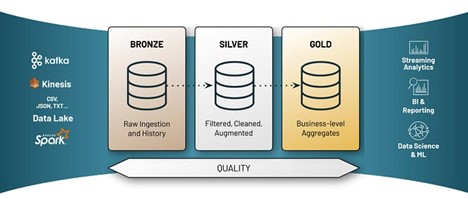
Хотя трехслойная структура является общепринятой и хорошо известной, о целях и лучших практиках, применимых к каждому из слоев, до сих пор очень много спорят. Я также заметил тот факт, что между теорией и практикой существует огромная разница. Поэтому позвольте мне поделиться своими личными размышлениями о том, как именно должна быть реализована эффективная многоуровневая архитектура данных.
Стратегия платформы данных
Первое и самое важное соображение при построении многослойной архитектуры - это определение того, КАК используется Ваша платформа данных. Структура централизованной платформы данных будет существенно отличаться от структуры федеративной мультиплатформенной схемы, используемой в нескольких доменах. Организация слоев также во многом зависит и от того, к какой стороне архитектуры Вы относите свою платформу (платформы) - к стороне системы-источника или к стороне системы-потребителя. Платформу, ориентированную на систему-источник, легче стандартизировать, чем платформу, ориентированную на потребителя, (учитывая более разнообразные характеристики использования данных на стороне потребителя).
Принимая во внимание все эти соображения, давайте рассмотрим каждый слой более подробно.
Landing area
Landing area или landing zone - это уровень, который используется организациями, создающими платформу данных, по желанию, то есть он не является обязательным. Данный слой служит местом временного хранения данных, собранных из различных источников, до момента их передачи на бронзовый слой. Этот уровень особенно необходим, когда извлечение данных из целевой исходной системы оказывается затруднительным, например, при работе с внешними клиентами или поставщиками SaaS. В таких случаях может возникнуть ряд сложностей, например, данные могут быть получены в неподходящем формате.
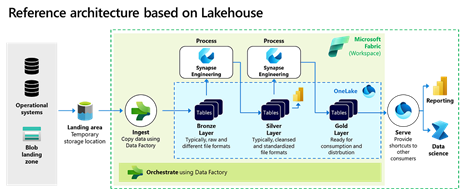
Landing zone в различных компаниях организована по - разному. Зачастую это просто учетная запись Blob-хранилища, но в некоторых случаях данная зона интегрирована в сервисы озера данных, например в контейнер или определенную папку, в которую поступают данные. Данные, размещаемые в landing zone, также разнообразны. Допустимые форматы файлов - CSV, JSON, XML, Parquet, Delta и так далее.
Бронзовый слой
Бронзовый слой обычно представляет собой резервуар, в котором данные хранятся в их исходном состоянии. Он содержит непроверенные данные (без необходимости предварительного определения схем). Здесь Вы получаете данные либо с помощью полной загрузки, либо с помощью дельта-загрузки. Данные, хранящиеся в бронзовом слое, обычно обладают следующими характеристиками:
- Сохраняют свое исходное состояние из источника данных в структуре "как есть";
- Неизменяемы (доступны только для чтения);
- Управляются с помощью таблиц с интервальными разделами, например, с использованием структуры папок YYYYMMDD или datetime;
- Сохраняют полную (необработанноую) историю каждого набора данных в определенном формате хранения, например, Parquet или Delta;
- Для транзакционных данных - могут добавляться инкрементально, и их объем может увеличиваться с течением времени;
- Есть возможность воссоздания любого состояния системы данных;
- Могут быть любой комбинацией потоковых и пакетных транзакций;
- Могут включать в себя дополнительные метаданные, такие как информация о схеме, имена исходных файлов или запись времени обработки данных.
Часто я сталкиваюсь с таким вопросом: "Какой формат файлов лучше выбрать - Delta или Parquet?" Безусловно, Delta обеспечивает более высокую скорость операций, но если Ваши данные уже версионированы или историзированы с помощью структуры папок, все преимущества данного формата теряют свою значимость. В этом случае ведение журнала транзакций или применение версионности не имеет решающего значения. Бронзовые данные - это, как правило, новые или добавленные данные, поэтому выбор Parquet в данном случае вполне оправдан. Однако для того, чтобы сохранить согласованность с другими слоями, можно выбрать и Delta.
Некоторые утверждают, что «бронзовые» данные полезны для бизнес-пользователей, выполняющих различные запросы или специальную аналитику. Однако, основываясь на своем опыте работы с клиентами, совершенно точно могу сказать, что сырые данные достаточно редко используются в качестве исходных данных для задач подобного рода. С необработанными данными сложно работать, поскольку они требуют глубокого понимания устройства исходной системы. Также необходимо расшифровывать сложную бизнес-логику, заложенную в данных. Кроме того, из-за наличия множества маленьких таблиц защитить данные становится практически невозможно. В заключение хотелось бы отметить тот факт, что бронзовый слой служит в качестве источника для других слоев, доступ к которым, в основном, имеют технические специалисты.
Серебряный слой
Серебряный слой обеспечивает уточненную структуру полученных данных. Он представляет собой проверенную, обогащенную версию данных, которой можно доверять и которую можно использовать для последующих целей, как операционных, так и аналитических. Кроме того, серебряный слой обладает следующими характеристиками:
- Для проверки и обработки полученных данных применяются правила по определению качества данных;
- Как правило, содержит только функциональные данные. Таким образом, технические или нерелевантные данные из бронзового слоя отфильтровываются;
- Как правило, применяется историзация путем слияния всех данных. Данные обрабатываются с использованием медленно изменяющихся измерений (SCD) либо 2, либо 4 типа. Это означает то, что добавляются дополнительные столбцы, такие как начальный, конечный и текущий;
- Данные хранятся в определенном формате хранения: предпочтительно Delta, альтернативный вариант – Parquet;
- Для отката ошибок обработки используется версионность;
- Работает с отсутствующими данными, стандартизирует чистые или пустые поля;
- Данные обычно обогащаются справочными и/или основными данными;
- Зачастую данные все еще согласованы и организованы в исходной системе. Таким образом, они еще не интегрированы с другими данными домена.
Для серебряного слоя характерны три важных аспекта, на которые стоит обратить свое внимание:
Некоторые специалисты полагают, что серебряный слой может функционировать как временный слой хранения, позволяющий удалять устаревшие данные или спонтанно создавать учетные записи. Клиенты часто спрашивают меня, разделяю ли я данную точку зрения. На самом деле, это зависит от каждой конкретной ситуации. Если Вы не планируете использовать данные для операционной отчетности или операционной аналитики, то данный слой действительно может быть временным слоем. Однако если Ваша цель заключается в том, чтобы сохранить исторические данные и задействовать серебряный слой для операционной отчетности и аналитики, то в этом случае я бы порекомендовал Вам использовать его именно как постоянный слой.
Если Вы работаете с «серебряными» данными, требующими запросов, Вам рекомендовано использовать денормализованную модель данных. Такой подход устраняет необходимость в обширных объединениях и лучше согласуется с архитектурой распределенного хранения на основе столбцов. Означает ли это, что Вам следует отказаться от 3-нормальной формы или модели данных в стиле Data Vault? Скорее всего, нет. Что касается историзации, то формат дельта-файлов уже версифицирует файлы Parquet для безопасности. Кроме того, в бронзовом слое у Вас есть история, из которой Вы можете перезагрузить необходимые данные. Для автоматизации и адаптации рекомендуется использовать стратегию управления таблицами и блокнотами на основе метаданных. Что касается избыточности данных, то хранение в озере обходится гораздо дешевле, чем вычислительная обработка и объединение данных. В заключение можно сказать, что если у Вас нет необходимости в значительных ежедневных изменениях схемы, то и усложнять хранилище данных совсем ненужно. Для дальнейшего изучения этой темы настоятельно рекомендую просмотреть видеоролик Саймона Уайтли.
Я часто обсуждаю вопрос о том, нужно ли на данном этапе заниматься интеграцией данных между приложениями и исходными системами. Вопрос, на самом деле, интересный. Лично я советую, по возможности, разделять данные для того, чтобы эффективнее управлять ими. Из этого следует то, что в случае, когда Вы используете серебряный слой для операционной отчетности или аналитики, не стоит преждевременно объединять и интегрировать данные из исходных систем, поскольку это может привести к появлению ненужных точек соединения между приложениями. Например, пользователь, заинтересованный в данных только из одного источника, будет также связан и с другими системами, поскольку перед предоставлением данные сначала объединяются в гармонизированный слой. Следовательно, такие пользователи с большей вероятностью будут подвержены потенциальному воздействию со стороны других систем. Если Вы стремитесь к более изолированной схеме, тогда интеграцию или объединение данных из разных источников следует перенести на золотой слой.
Точно также, если Вы планируете создавать продукты данных и твердо намерены согласовать права собственности на данные, то я не советую Вам преждевременно соединять данные из приложений в других доменах.
При рассмотрении возможностей обогащения данных также необходимо учитывать некоторые важные особенности. Например, если Ваша цель – это создание операционной отчетности, требующей обогащения, я рекомендую начать обогащать данные уже на серебряном слое. Это может привести к возникновению потребности в дополнительной калибровке при объединении данных на золотом уровне. Безусловно, это потребует дополнительных усилий с Вашей стороны, но поверьте, что возросшая степень гибкости, которая будет Вам доступна в этом случае, действительно того стоит.
Золотой слой
В архитектуре Lakehouse золотой слой содержит данные, структурированные в "проектные" базы данных, что делает их легкодоступными для дальнейшего потребления. Подобная интеграция данных из различных источников может привести к смене владельца данных. Для данного слоя я рекомендую использовать денормализованную и оптимизированную для чтения модель данных с меньшим количеством соединений, например, звездную схему в стиле Кимбалла. В целом, золотой слой обладает следующими характеристиками:
- Золотые таблицы представляют собой данные, преобразованные для потребления или дальнейшего использования;
- Данные хранятся в определенном формате, предпочтительно Delta;
- Для отката ошибок обработки используется версионность;
- Историзация применяется только для определенных вариантов использования или потребителей. Таким образом, золотой слой может представлять собой выборку или агрегацию данных, содержащихся в серебряном слое;
- В золотом слое применяются сложные бизнес-правила. Таким образом, используется множество действий по постобработке, вычислению, обогащению и оптимизации данных;
- Данные строго регламентированы и документированы.
Зачастую золотой слой - самый сложный слой, поскольку его схема зависит от сложности Вашей архитектуры. Если Ваш Lakehouse ориентирован исключительно на систему-источник, тогда данные золотого слоя представляют собой "продукт данных", что делает их удобными для использования и пригодными для распространения в другие домены. После того, как данные будут распространены, предполагается, что их можно будет разместить на другой платформе, возможно, даже в другом Lakehouse.
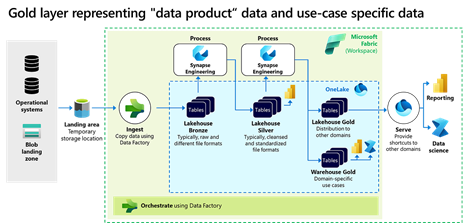
В зависимости от масштаба Вашей архитектуры золотой слой может представлять собой конгломерат данных о продуктах данных.
В этом случае предполагается, что золотой слой будет отвечать определенным потребностям потребителей аналитических данных. Следовательно, данные моделируются, приобретают структуру и адаптируются в зависимости от каждого конкретного случая. Этот метод позволит доменам работать только с внутренними данными, которые не распространяются напрямую на другие домены. Таким образом, некоторые таблицы могут быть гибкими и настраиваемыми в любой момент времени, в то время как другие таблицы будут использоваться другими объектами. Отражение данной схемы можно увидеть на изображении выше.
Если сфера применения Вашего Lakehouse широка и охватывает как поставщиков, так и потребителей, тогда обязательно предусмотрите дополнительные уровни. Их также часто называют рабочими пространствами или презентационными слоями. В подобных конфигурациях данные золотого слоя являются более универсальными, интегрированными и готовыми к различным вариантам использования. Эти рабочие или презентационные слои содержат подмножества данных. Такая модель во многом напоминает типичное моделирование данных в хранилищах данных. По сути, золотой слой служит универсальным интеграционным слоем, из которого можно наполнять карты данных или подмножества данных.
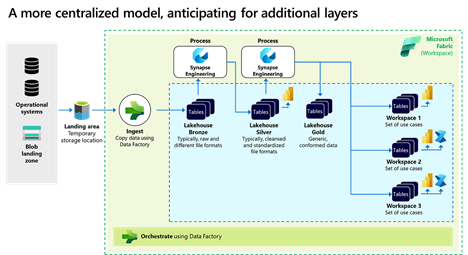
Архитектура, демонстрирующая более централизованную операционную модель. Последний презентационный слой может представлять собой хранилища данных, озера данных или карты данных.
Некоторые организации используют эти рабочие пространства или презентационные слои для распространения данных среди других платформ. Для этого они отбирают и/или предварительно фильтруют данные в зависимости от различных задач. Другие организации применяют так называемую токенизацию, которая заключается в замене конфиденциальных данных рандомизированными строками. Некоторые компании используют дополнительные сервисы для того, чтобы сделать данные анонимными. Такие данные можно рассматривать как аналог "продукта данных".
Золотой слой отличается от других слоев именно своей «приверженностью» общекорпоративным стандартам. Несмотря на то, что моделирование корпоративных данных - процесс сложный и трудоемкий, многие организации по-прежнему используют его для стандартизации данных. В случае Lakehouse модель корпоративных данных представляет собой абстрактную основу для организации данных в "озера" команд. Альтернативным подходом к установлению стандартов в масштабах предприятия является сбор данных и их согласование в другой архитектуре Lakehouse. Оттуда данные могут быть использованы другими доменами. Такой подход похож на управление основными данными. В качестве альтернативы можно поручить командам взять на себя ответственность за конкретные гармонизированные объекты. В большинстве случаев стандартизация и гармонизация данных происходят именно на золотом уровне.
Когда дело касается архитектуры платформы данных, особенно это относится к золотому уровню, важно понимать, что выбор базы данных или сервиса - это очень сложная процедура. Данный вопрос требует учета различных факторов и предполагает множество компромиссов. Помимо структуры данных, Вам также необходимо определить Ваши требования в отношении согласованности, доступности, кэширования, своевременности и индексирования данных для повышения производительности работы. Существует множество методов хранения и извлечения данных. Вопреки мнению некоторых энтузиастов, я с уверенностью могу сказать, что ни один сервис не в состоянии учитывать все эти аспекты одновременно. Поэтому типичная архитектура Lakehouse обычно включает в себя набор различных технологических сервисов, таких как бессерверный SQL-сервис для специальных запросов, колоночное хранилище для быстрой отчетности, реляционная база данных для более сложных запросов, хранилище временных рядов для IoT и потокового анализа и т. д.
Надеюсь, эта статья оказалось для Вас полезной. Всем, кто создает платформу данных следующего поколения, желаю удачи!


