

Введение: Data Vault с нуля - цели, контекст и ценность
Data Vault представляет собой методологию моделирования хранилищ данных, ориентированную на устойчивую интеграцию разрозненных источников, хранение исторических изменений и масштабируемость в условиях роста корпоративных данных. В условиях цифровой трансформации организации сталкиваются с необходимостью оперативной выдачи достоверной информации, аудируемости изменений и возможности параллельной разработки. Data Vault призван обеспечить архитектурно устойчивый фундамент для таких требований, минимизируя технический долг и упрощая эволюцию хранилища по мере усложнения бизнес-логики и источников.
Настоящая глава затрагивает цели и контекст применения Data Vault, его ценностные стороны для бизнеса и IT, а также организационные аспекты, которые являются ключевыми для успешной реализации. В центре внимания - процессы, роли и практики, обеспечивающие непрерывную доставку данных в соответствии с бизнес-объемами, требованиями к качеству и регуляторными нормами. В рамках подхода методологического характера рассмотрены принципы планирования, управления изменениями и контроля качества на всех этапах проекта.
Ключевые идеи главы сформулированы таким образом, чтобы способствовать не только теоретическому пониманию паттерна, но и практической применимости в условиях корпоративной среды: от выбора источников и определения бизнес-ключей до организации командной работы, разработки и валидации моделей, а также поддержки масштаба и устойчивости к изменениям во времени. В конце главы будут систематизированы выводы и ответы на наиболее распространенные вопросы, связанные с началом внедрения Data Vault в рамках существующей IT-архитектуры.
Краткое содержание главы
- Цели, контекст и ценность Data Vault в рамках корпоративной архитектуры и цифровой трансформации.
- Основные концепции: hubs, links и satellites, принципы моделирования и историчности.
- Организационные аспекты внедрения: методология, процессы, роли, управление изменениями.
- Этапы реализации и архитектурные решения: MVP, эволюционные планы, выбор платформ и инструментов.
Контекст и цели Data Vault в корпоративной архитектуре
Data Vault выступает как ответ на возрастающую сложность интеграции данных, разнообразие источников и требования к аудиту. Цели применения этой методологии можно разделить на несколько уровней.
Во-первых, обеспечить устойчивость к изменению внешних источников. В современных enterprise-средах источники данных - это ERP-системы, CRM, файловые репозитории, облачные сервисы и IoT-устройства. Все они эволюционируют по-разному, что приводит к постоянной переработке схем и ETL-процессов. Data Vault минимизирует влияние изменений благодаря разделению бизнес-ключей, связей и описательных атрибутов на независимые части: наборы сущностей, их взаимоотношения и исторические слои.
Во-вторых, повысить аудитируемость и воспроизводимость загрузки данных. В условиях регуляторных требований и необходимости прослеживаемости данных по времени крайне важно иметь ясную схему lineage и возможность версионности. Data Vault поддерживает это благодаря хранению исторических изменений в спутниках и неизменности ядра моделей в виде хабов и связей.
В-третьих, обеспечить гибкость в предоставлении аналитики. Архитектура DV позволяет параллельно разворачивать новые источники и новые аналитические употребления без значительной переработки фундаментального слоя. Это особенно важно при многогранной BI-логике, где потребуются разные представления данных и ускоренная адаптация к новым бизнес-подразделениям.
Наконец, усилить управляемость и качество данных в ходе трансформаций. В рамках DV акцент делается на управлении сигнатурами бизнес-ключей, на разделении данных по областям ответственности и на поддержке повторяемой методологии загрузки. Это способствует снижению риска ошибок в ETL/ELT и упрощает операционное сопровождение.
На концептуальном уровне Data Vault - это сочетание трех элементарных паттернов: хабы (Hubs) для бизнес-ключей, связи (Links) для выражения отношений между ними и спутники (Satellites) для хранения описательных атрибутов и изменений во времени. Такой подход обеспечивает не только структурную ясность, но и масштабируемость при росте объемов данных и количества источников.
Практический вывод: внедрение Data Vault требует не только технической реализации, но и выстраивания управляемых процессов, которые охватывают сбор требований, моделирование, загрузку данных, качество и метрические оценки. Без согласованной методологии и ролей проект редко достигает заявленных целей по скорости поставки, полноте и устойчивости к изменениям.
Концепции и принципы моделирования DV
Data Vault опирается на принципы модульности и истории. Основные элементы:
- Хабы (Hubs) сохраняют уникальные бизнес-ключи. Они служат якорем для бизнес-сущности и не содержат описательной информации, которая может меняться во времени.
- Связи (Links) отражают отношения между бизнес-ключами и позволяют документировать связи между сущностями. Они связывают хабы и формируют граф отношений.
- Спутники (Satellites) хранят контекст и параметры, включая изменяемые атрибуты и их исторические версии. Именно спутники фиксируют эволюцию данных во времени.
Ключевые принципы:
- Неразрушающее изменение: загрузка новых версий записей выполняется без изменения существующей истории уже сохранённых записей.
- Историчность: поведение системы учитывается во времени за счет спутниковых слоёв.
- Изоляция изменений: архитектура поддерживает параллельную загрузку новых источников без риска нарушения существующих бизнес-правил.
- Масштабируемость: добавление новых источников не требует радикальной перестройки существующей схемы.
- Управляемая линейка трансформаций: каждая загрузка и трансформация имеют явный источник, требования к качеству и валидируемую логику.
Технологически Data Vault допускает работу на самых разных платформах и комбинациях инструментов, от on-premises решений до облачных хранилищ данных. В рамках методологии следует уделять внимание совместимости с используемыми инструментами ETL/ELT, управлению метаданными и поддержке гибких сценариев развертывания. Важной частью является выбор способа реализации hash-ключей (хеш-функции, которые обеспечивают детерминированность и устойчивость к дубликатам), а также проектирование satellite-слоев с учётом частоты обновлений источников и требований к histórico.
Ниже приведена простая наглядная иллюстрация соответствий элементов DV и их базовых функций. Таблица демонстрирует взаимосвязь между элементами и тем, какие данные они несут в базовую и дополнительные слои.
| Элемент DV | Что хранит | Основная функция |
|---|---|---|
| Хаб | Бизнес-ключи (уникальные идентификаторы бизнес-домена) | Идентификация бизнес-сущностей, единая точка учета |
| Связь | Отношения между ключами хабов | Моделирование связей и зависимостей между сущностями |
| Спутник | Описательные атрибуты и их история | Хранение контекста и изменений во времени, аудируемость |
Таким образом, DV объединяет структурную ясность и историческую глубину, обеспечивая базу для устойчивой аналитики и прозрачного управления данными.
Основные концепции и паттерны моделирования
Data Vault опирается на сочетание трех паттернов и обеспечивает баланс между гибкостью и контролем. В практической работе следует помнить:
- Базовый набор элементов: хабы, связи, спутники.
- Управление ключами: использование детерминированных хешей для устойчивости к изменению естественных ключей источников.
- Версионирование характеристик: спутники позволяют хранить обе версии атрибутов и состояния объектов во времени.
- Разделение слоев: staging, raw DV (core DV), business DV (presentation) - каждый слой имеет свою роль и требования.
- Метаданные и lineage: соответствующая регистрация источников, версий моделей, трансформаций и зависимостей.
- Границы ответственности: позволение отдельным командам работать над ядром DV и над слоями presentation, не вмешиваясь в другие функциональные области.
В рамках этого раздела полезно рассмотреть конкретное развертывающееся представление: фаза загрузки источников переводит данные в staging area, затем выполняется загрузка в raw DV-модель, где данные фиксируются исторически, и далее формируются представления для аналитических потребителей. Такой подход позволяет отделить логику интеграции от бизнес-отображения и снижает риск нарушения целостности в процессе изменений источников.
Ценности, свойства и принципы внедрения
Внедрение Data Vault несет множество преимуществ для организаций, стремящихся к устойчивой архитектуре данных и Flex-умной аналитике. Основные ценности:
- Масштабируемость. Архитектура DV хорошо растет по мере увеличения количества источников и объема данных за счет независимости слоев и возможностей параллельной обработки.
- Гибкость интеграций. Новые источники можно подключать без радикальной переработки существующих моделей; добавляются новые хабы, связи и спутники.
- Аудируемость и прослеживаемость. Исторические слои фиксируются с атрибутами изменений и временем их возникновения, что упрощает соответствие требованиям аудита и регуляторным нормам.
- Предсказуемость изменений. Нормирование ETL/ELT-процессов и строгие правила загрузки снижают риск регрессий и несогласованности между данными.
- Управление качеством через метаданные. Полная документация источников, версий и трансформаций обеспечивает прозрачность и улучшает доверие к данным.
- Совместная работа команд. Разделение ролей (архитектор данных, DV-моделер, ELT-инженер, дата-сте-вард и т. д.) облегчает распределение ответственности и ускоряет выпуск MVP.
Из методологической перспективы важным моментом является соблюдение принципов Data Vault 2.0, которые подчеркивают неразрушающее обновление, целостность ссылок и управляемые этапы загрузки. В рамках проекта целесообразно внедрять практики DataOps: автоматизация CI/CD-пайплайнов для моделей DV, тестирование на уровне источников, автоматическую генерацию документации и метаданных, мониторинг производительности загрузок и качества данных.
В контексте архитектуры следует также согласовать выбор платформы хранения. Облачные хранилища типа Snowflake, Google BigQuery или Amazon Redshift предоставляют богатые возможности для масштабирования, географической репликации и гибкой стоимости. Выбор конкретной платформы должен опираться на требования к латентности, объему данных, скорости загрузки и бюджету, а также на совместимость с инструментами ETL/ELT и управления метаданными.
Организационные изменения являются неотъемлемой частью успешного внедрения DV. Рекомендованы следующие практики:
- Создание компетентного центра DV (DV Competency Center) и древовидной структуры управления проектами.
- Введение архитектурного совета (ARB) для контроля соответствия архитектурным стандартам, безопасностям и качеству.
- Разработка единого набора методик моделирования, стандартов именования и правил загрузки.
- Интеграция процессов управления данными и качества данных в рамках DevOps/DataOps, включая тестирование, мониторинг и обновление документации.
- Постепенное внедрение через MVP и итеративную разработку с постепенным расширением охвата источников и функциональности.
Применение этих практик снижает риск задержек, нестыковок между источниками и аналитическими требованиями, а также обеспечивает более понятную дорожную карту развития хранилища данных.
Организация процесса внедрения и роли
Успешное внедрение Data Vault требует выстраивания управляемого процесса и четко определенных ролей. Основные элементы организации:
- Архитектор данных (Data Architect) и DV-модельер (DV Modeler). Они отвечают за концептуальное и физическое проектирование хабов, связей и спутников, определение бизнес-ключей и правил интеграции.
- Инженеры ELT/ETL. Реализуют загрузку данных в слои DV, обеспечивая неразрушающее обновление, контроль качества и трассировку изменений.
- Data Steward и владелец домена. Контролируют бизнес-ключи, согласование атрибутов, логику терминологии и качество данных.
- QA-инженеры и тестировщики. Разрабатывают и выполняют тест-кейсы на соответствие требованиям к данным, целостности и истории.
- Analytiсs и BI-пользователи. Определяют сценарии использования, требования к представлениям и метрикам эффективности.
- DataOps и мониторинг. Обеспечивают автоматизацию развёртывания, CI/CD для моделей DV, тестируемость процессов и устойчивость к сбоям.
Процессы внедрения следует структурировать в последовательность фаз:
- Фаза подготовки: формирование бизнес-требований, анализ источников, выбор методологии и платформы, установление стандартов.
- Фаза моделирования: определение бизнес-ключей и границ хабов, проектирование связей и спутников, формирование базовых правил загрузки.
- Фаза реализации: построение MVP DV-модели, загрузка данных из ключевых источников, валидация и настройка мониторинга.
- Фаза эксплуатации: внедрение метаданных, управление качеством данных, расширение источников и версий моделей, поддержка регуляторных требований.
- Фаза эволюции: оптимизация производительности, добавление новых слоёв представления, модернизация инфраструктуры.
Важной частью является документирование и поддержка метаданных. Рекомендуется обеспечить единое хранилище метаданных, которое отражает источники, версии схем, траектории загрузок, сериализацию ключевых атрибутов и связи между элементами DV. Это упрощает аудит, соответствие требованиям регуляторов и ускоряет обучение новых сотрудников.
Этапы реализации и архитектурные решения
Этапы реализации можно суммировать в несколько логических шагов, ориентированных на быструю поставку MVP и дальнейшую эволюцию.
-
Постановка цели и сбор требований. Важна ясная формулировка бизнес-целей и определение минимального набора источников, критичных для начального MVP. В рамках методологии DV следует зафиксировать требования к аудированию, времени истории и качеству данных.
-
Анализ источников и бизнес-ключи. Проводится углубленная профилизация источников, выделение уникальных бизнес-ключей, согласование со стейкхолдерами и выделение приоритетных доменов. Этот шаг задаёт основу для хабов и связей.
-
Проектирование концептуального DV. Определяются наборы хабов, связи между ними и спутники, в том числе планирование их эволюции во времени. Важно обеспечить ясность правил именования, оговорить хранимые атрибуты и политики загрузки.
-
Преобразование в физическую модель и загрузка. Осуществляется построение физического DV-слоя, настройка hash-ключей и транзакционных схем, затем - реализация загрузок в staging и raw DV. В этот этап входят процедуры контроля целостности и качество данных.
-
Валидация и тестирование. Проводится верификация соответствия данным бизнес-правилам, тесты на регрессию и на консистентность между слоями DV и downstream-потребителями. Верификация включает сравнение данных с источниками и проверку истории изменений.
-
Расширение и переход к более широкому охвату источников. После успешной реализации MVP добавляются новые источники, хабы, связи и спутники, параллельная загрузка и тестирование - ключевые принципы масштабирования.
-
Поддержка и управление изменениями. Внедряются практики управления версиями, мониторинга производительности загрузок и качества данных, документация и обновления регламентов.
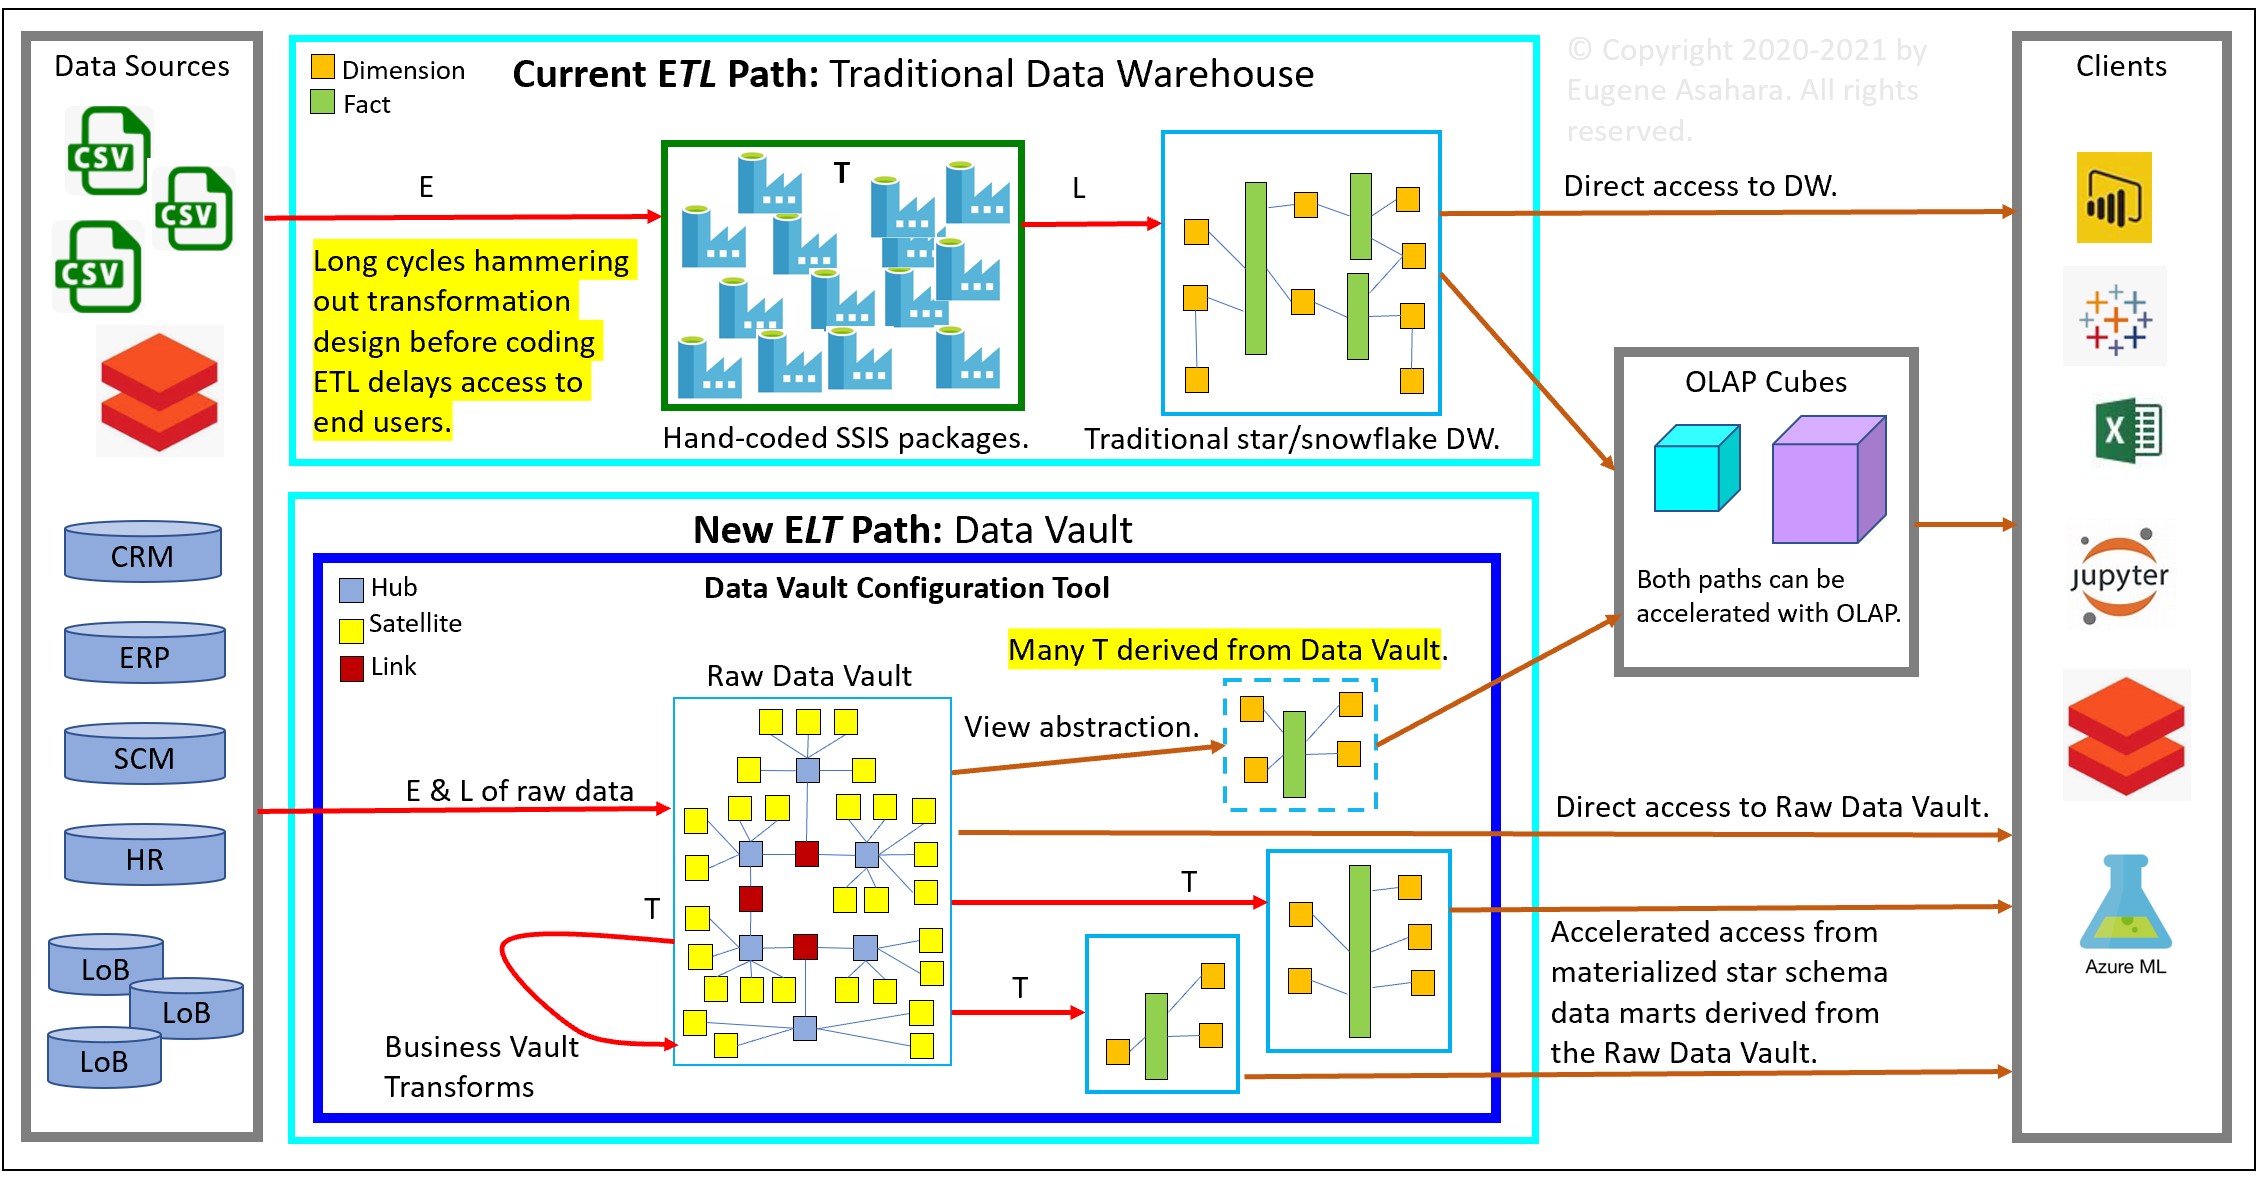
Архитектурно Data Vault может быть реализован как часть современного облачного Data Warehouse. На практике выбираются подходы, которые поддерживают многоисточниковость, параллелизм загрузок и эффективное масштабирование запросов. В контексте практической архитектуры следует учитывать параметры: требования к латентности, характер обновления источников, политики резервного копирования и геймификация прав доступа. В идеале следует строить DV-архитектуру в рамках слоев:
- Staging: первичная загрузка данных из источников без изменений, сохранение файлового/табличного формата и минимальные преобразования.
- Raw DV: неразрушающая загрузка бизнес-ключей, связей и спутников; хранение полной истории.
- Business DV: преобразование в представления и денормализации по требованиям аналитиков, создание временных и кросс-доменных представлений.
- Presentation/Analytics: набор готовых для BI визуализаций и аналитических приложений представлений.
Таким образом, архитектура DV обеспечивает последовательный путь от источника к аналитике, позволяя в дальнейшем расширять слой представления без изменения базовых паттернов моделирования.
Key takeaways
- Data Vault обеспечивает устойчивую архитектуру для интеграции множества источников и сохранения истории изменений.
- Основные элементы - хабы, связи и спутники - разделяют бизнес-ключи, отношения и контекст данных, упрощая эволюцию модели.
- Внедрение DV предполагает методологическую настройку процессов: требования, моделирование, загрузку, валидацию и управление изменениями.
- Управление метаданными и линейностью данных критично для аудита, регуляторного соответствия и доверия к данным.
- Готовность к масштабированию достигается за счет модульности слоёв и параллельной загрузки независимых источников.
- Организационные изменения включают создание DV-компетентного центра, архитектурного совета и внедрение DataOps-практик.
- Выбор платформы и инструментов должен учитывать требования к производительности, масштабу и интеграции с существующими процессами.
- MVP-подход и итеративная доставка позволяют быстро демонстрировать ценность и наращивать охват источников.
- Важна прозрачная документация и регламентированная архитектура, обеспечивающая повторяемость и качество данных.
FAQ
- Что такое Data Vault и чем он отличается от других подходов к моделированию хранилищ данных?
Data Vault - это методология, ориентированная на устойчивость к изменениям источников, сохранение полной истории и модульность. В отличие от традиционных схем «звезда» и «снежинка», где изменения источников требуют обновления конкретных слоёв, DV разделяет бизнес-ключи (хабы), отношения (связи) и контекст (спутники), что упрощает добавление новых источников и адаптацию к требованиям аудита. Основной принцип - неразрушающее обновление и явная история изменений.
- Какие бизнес-ключи и как их выбирать при построении хабов в DV?
Бизнес-ключи должны быть стабильными, уникальными и устойчевыми к изменению в источниках. Выбор ключа основывается на бизнес-доменной логике: например, клиент, поставщик, продукт. В DV практикуется использование хешированных ключей (hash keys) для обеспечения детерминированности и снижения зависимости от изменяющихся внешних идентификаторов. Релевантные требования включают устойчивость к дублированию и возможность повторной идентификации сущности по ключу.
- Как обеспечить аудит и lineage в DV-подходе?
Аудит и lineage достигаются через явное моделирование спутников, где каждая запись сопровождается временем начала и окончания, источником и версией. Метаданные должны фиксировать происхождение данных, трансформации и связи между элементами DV. Важно поддерживать регламентированное хранение истории и доступ к ней для аналитических и регуляторных целей.
- Какие сложности встречаются на старте внедрения DV и как их минимизировать?
Сложности чаще связаны с определением бизнес-ключей, согласованием стандартов именования, начальным профилированием источников и настройкой ETL/ELT-процессов. Преимущества достигаются за счет внедрения MVP, четкого определения ролей, документирования и автоматизации процессов. Рекомендуется начать с нескольких ключевых источников и постепенно расширять охват, чтобы снизить риск и проверить методологию на практике.
- В чем преимущество разделения слоев Staging, Raw DV и Business DV?
Разделение слоев обеспечивает изоляцию источников от бизнес-логики, упрощает управление качеством и ускоряет внедрение новых источников. Staging - прием данных, Raw DV - историческое хранение и структура без излишних трансформаций, Business DV - подготовка данных для аналитических потребителей, включая агрегации, денормализации и подготовку к presentations. Это обеспечивает гибкость для аналитиков и снижает риск внесения изменений в базовую историю.
- Какие практики управления изменениями следует внедрить в DV-проекте?
Рекомендуется создать архитектурный совет (ARB) и DV Competency Center, определить стандарты моделирования и правила загрузки, внедрить метаданные и мониторинг, а также автоматизацию CI/CD для моделей DV. Важно поддерживать регламент по тестированию, документации и управлению версиями, чтобы ускорить адаптацию к изменяющимся требованиям бизнеса и источников.
- Как выбрать платформу для реализации Data Vault?
Выбор платформы должен учитывать требования к производительности, объему данных, латентности и бюджету. Облачные решения (например, Snowflake, BigQuery, Redshift) часто обеспечивают гибкость, масштабируемость и интеграцию с современными инструментами данных. Однако совместимость с существующими инструментами ETL/ELT, требования к управлению стоимостью и доступ к данным также влияют на конечный выбор.
- Какие типичные риск-микропроцедуры стоит внедрить в DV-проекте?
Ключевые риски - потеря истории, несоответствие между источниками, деградация качества данных и задержки в поставке. Микропроцедуры включают автоматическую валидацию качества после загрузки, мониторинг задержек и ошибок, регламентированную проверку lineage и регламент по откату изменений. Регулярные ревью архитектуры и тестирования помогают снизить риски.
- Как измерять успех внедрения Data Vault?
Успех следует измерять через показатели скорости поставки данных, полноту охвата источников, качество истории и доступность для аналитиков. Важными метриками являются время цикла загрузки, доля ошибок, точность и согласованность между слоями DV, а также удовлетворенность бизнес-пользователей созданными представлениями и метаданными.
- Какие задачи стоит ставить перед командой после первого выпуска MVP?
После MVP следует расширить охват источников, доработать представления для бизнес-подразделений, усилить управление качеством и метаданными, автоматизировать тестирование и развёртывание, а также запланировать архитектурные улучшения для более сложной аналитики и регуляторной поддержки. Постепенная эволюция позволяет поддерживать скорость поставки и качество данных.


