

Эксплуатация и операционная модель DV: мониторинг и runbooks
В современных корпоративных хранилищах данных Data Vault (DV) эксплуатация занимает не менее важную роль, чем моделирование. Эффективная операционная модель обеспечивает устойчивость инфраструктуры, своевременный доступ к данным, соответствие требованиям качества и безопасности, а также возможность масштабирования по росту объёма данных и числа источников. В данной главе рассматриваются принципы организации мониторинга, выстраивания runbooks и поддержки оперативной деятельности DV-проекций: hubs, links и satellites, а также взаимодействия команд данных, ИТ-подразделений и бизнес-структур.
DV-архитектура на практике требует не только корректного моделирования, но и четкой операционной дисциплины: как поддерживать согласованность ключевых бизнес-единиц (hubs), как обеспечивать целостность зависимостей (links) и историчность значимых измерений в satellites, как быстро обнаруживать отклонения и как действовать в случаях инцидентов. Операционная модель должна быть основана на измеримой динамике процессов, автоматизированной телеметрии и документированной процедуре реагирования на события. Это позволяет сохранить баланс между гибкостью DV и необходимостью управляемости в условиях больших команд и многоканальных источников данных.
-
В данной главе будут разобраны структура эксплуатационной команды, архитектура мониторинга DV, принципы формирования и использования runbooks, подходы к управлению качеством данных и метаданными, а также аспекты безопасности и соответствия требованиям.
-
Основной фокус смещён на методологию: какие процессы внедрять, какие практики соблюдать, какие роли и ответственности назначать, какие артефакты поддерживать в living documentation. При этом будет рассмотрен практический набор инструментов и примерные шаблоны документов, которые можно адаптировать под конкретную организацию.
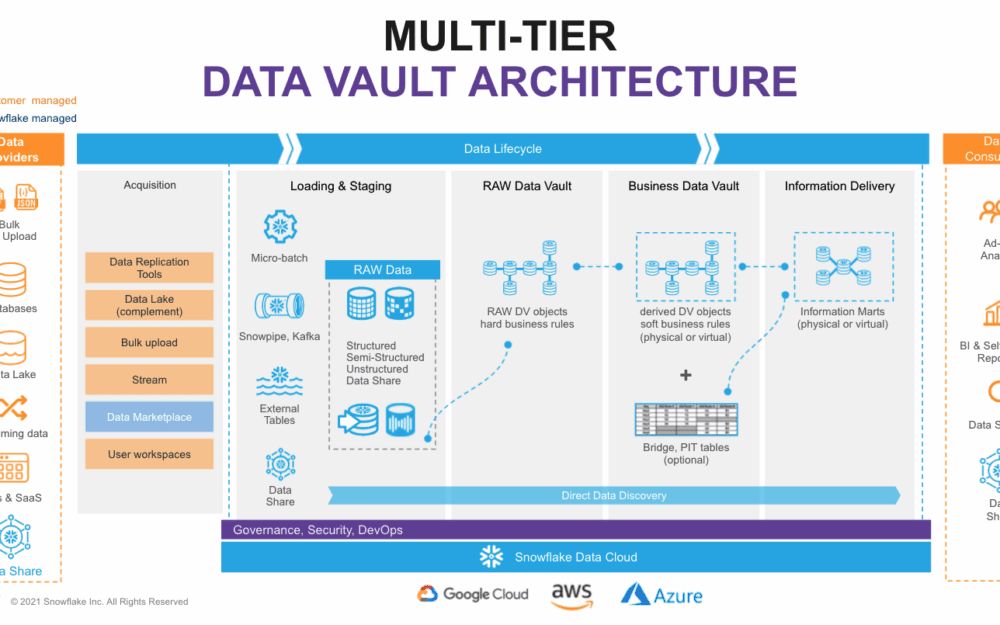
Краткое содержание главы
- Определение операционной модели DV: роли, процессы, артефакты и принципы эскалации.
- Мониторинг DV: архитектура телеметрии, ключевые метрики, данные для аналитики и сценарии реагирования.
- Runbooks DV: структура, жизненный цикл, типовые шаблоны и примеры инцидентов.
- Управление качеством, метаданными и безопасностью в операционной практике DV.
- Автоматизация операционных процессов и интеграция с DevOps/DevSecOps.
Организационная и операционная модель DV
Эксплуатационная часть DV требует выверенного разделения ответственностей и понятной эскалации с учётом специфики всех трёх компонентов DV: hubs, links и satellites. Только так достигается предсказуемость загрузок, прозрачность изменений и возможность быстрого реагирования на отклонения в данных и производительности.
- Роли и команды. В оперативной модели выделяют:
- Data Vault Operations Lead - ответственный за целостность операционной среды DV, координацию инцидентов и улучшение процессов.
- BI/DS инженеры и инженеры интеграции - реализуют загрузку, мониторинг и поддерживают рабочие нагрузки DV, обеспечивая соответствие проектной архитектуре.
- Data Quality и Stewardship - следят за качеством данных на уровне бизнес-правил, согласование словарей и правил в satellites.
- Архитектор DV и руководитель данных - обеспечивают соответствие модели, изменений и миграций архитектуры в рамках политики הנתמ.
- Безопасность и соответствие - реализуют требования по доступу, аудиту, маскированию и сохранности данных.
- Управление инцидентами. Основной принцип - инцидент управляется через регламентированные Runbooks и SLA по эскалации. В каждом случае необходима запись причин, последствий, принятых действий и итогов.
- Эволюция операционных артефактов. Все документы и шаблоны должны быть версионированы, тестируемы и доступны участникам команды через централизованный репозиторий. Важна непрерывная актуализация в связи с изменениями источников, схем DV и бизнес-правил.
- Управление изменениями. Любое изменение в модели (например, обновление ключевых атрибутов hub’а, корректировка структуры satellites или добавление нового link) сопровождается формальным проходом Change Advisory Board и тестированием в автономной среде перед переносом в продакшн.
Почему эти элементы критически важны для DV? DV строится на historical единстве ключевых бизнес-единиц и на сложной совокупности ETL/ELT-процессов. Без четкой операционной модели легко сбиваются сроки загрузок, нарушаются зависимости между hubs/links и satellites, снижается доверие к данным, возрастает риск потери исторической целостности. Выстраивание ясных ролей, регламентов и процессов - основа устойчивого развёртывания DV в масштабе.
Управление запасами и приоритизация задач
Операционная команда должна иметь прозрачную карту рабочей нагрузки: какие источники активны, какие загрузки выполняются с задержкой, какие участки схем DV требуют рефакторинга. Приоритизация строится на сочетании бизнес-ценности и риска. В рамках методологии DV целесообразно внедрять дисциплину backlog по следующим критериям: критичность источников, частота обновления, объём изменений в схеме, влияние на бизнес-процессы и требования к SLA.
Архитектура мониторинга в рамках DV
Мониторинг DV следует рассматривать как многослойную систему наблюдаемости:
- сигналы на уровне источников данных (поставщики, CDC-движки, журналы транзакций);
- сигналы на уровне ETL/ELT-процессов (партнёры, очереди, очередность загрузок, задержки);
- сигналы на уровне DV-архитектуры (включение и загрузка hubs, links, satellites; консистентность связей и историчность);
- сигналы на уровне доступности и сервиса (SLA/SLO для данных, доступность витрин BI).
Эти сигналы объединяются в единый контур телеметрии и хранятся в централизованном стенде метрик и логов. Важной частью является возможность в режиме реального времени обнаруживать аномалии и быстро переходить к регламентированным действиям.
Мониторинг и телеметрия DV
Мониторинг DV основывается на концепциях observability: что мы измеряем, как собираем данные и как используем результаты для принятия решений. В DV-модели критично важны следующие аспекты.
- Архитектура телеметрии. В типичной конфигурации телеметрия собирается из трёх слоёв: (1) источники данных и их протоколы (S3, RDBMS, Kafka, API), (2) оркестрация и загрузчики (ETL/ELT-инструменты, дата-интеграторы, контрольные задания), (3) DV-хранилище (hubs/links satellites) и витрины данных. Далее данные попадают в хранилище метрик и логов (Prometheus, OpenTelemetry, Elastic/OpenSearch), где происходят агрегации и построение дашбордов (Grafana, Kibana). В качестве хранилища исторических данных и больших массивов логов часто применяют ClickHouse или другие колоночные СУБД, оптимизированные под аналитические нагрузки.
- Метрики и сигналы. Разделяются на несколько уровней:
- Инфраструктурные метрики: доступность систем, пропускная способность сети, загрузка CPU/ПЗУ, задержки в очередях.
- Метрики загрузки DV: задержки между источником и загрузчиком, время окончания загрузки каждого hub/link/satellite, число записей за интервал, коэффициент повторной вставки и дубликатов, доля ошибок.
- Метрики качества данных: полнота, точность, согласованность между hubs и satellites, соответствие словарям и бизнес-правилам, временная непрерывность и полнота исторических рядов.
- Метрики достоверности витрин: соответствие данным в DV, согласование с источниками, уровень соответствия бизнес-правилам.
- Метрики операционного здоровья: время устранения инцидентов, среднее время восстановления (MTTR), частота повторяющихся ошибок, количество активных изменений.
- Инструменты и подходы. Рекомендуемая связка:
- сбор telemetry через OpenTelemetry или встроенные средства СУБД/инструментов загрузки;
анализ и хранение логов в Elastic/OpenSearch;
мониторинг и визуализация в Grafana;
метрики и алерты в Prometheus;
событийная обработка и потоковые данные через Kafka или аналог;
хранение "исторических" данных и аудита в DV-существенных хранилищах, например ClickHouse.
- сбор telemetry через OpenTelemetry или встроенные средства СУБД/инструментов загрузки;
- Метаданны и линия происхождения. В DV критично важно хранить не только данные, но и связанный с ними контекст: источник, время загрузки, версия модели, применённые бизнес-правила. Мета-слой должен позволять видеть влияние изменений на downstream-витрины и на бизнес-процессы.
Почему важна архитектура мониторинга именно для DV? DV-это историческое хранилище, где качество и целостность данных зависят от согласования между hubs, links и satellites и от корректности загрузок. Прозрачная телеметрия позволяет быстро восстановить ситуацию после инцидента, выяснить корень проблемы и минимизировать повторение ошибок. Эффективная мониторая система обеспечивает не только реакцию на сбои, но и предиктивные сигналы, которые позволяют планировать обслуживание и обновления без нарушения бизнес-операций.
Пример функциональной панели мониторинга DV
- Общее состояние пайплайна загрузки DV: статус источников, статус вакуумной очистки историй satellites, задержки, очереди.
- Хабы, ссылки и satellites: количество записей, скорость обновления, коэффициент ошибок, дельты по ключам.
- Качество данных: прогресс прохождения правил проверки, отклонения по бизнес-правилам, аномалии по временным меткам.
- Безопасность и доступ: аудит доступа к данным, попытки несанкционированного доступа, маскирование критичных полей.
- DR/резервирование: статус резервных копий, тесты восстановления, частота резервного копирования.
Если в организации присутствуют открытые источники данных и критически важны показатели скорости доступа к данным, можно использовать интеграцию с инструментами кеширования и аналитическими слоями, чтобы оперативно отвечать на вопросы бизнеса.
name: dv_monitoring_incident_run
version: 1.0
description: Шаблон инцидент-управления для DV пайплайна
steps:
  - **id**: 1
    name: Проверка состояния источников
    action: verify_sources_availability
    criteria: sources_up and last_update_within_5m
  - **id**: 2
    name: Анализ очередей и загрузки
    action: inspect_pipeline_queues
  - **id**: 3
    name: Перезапуск нестабильной задачи
    action: restart_pipeline_step
    criteria: сможет вернуть данные в целостное состояние
  - **id**: 4
    name: Верификация данных
    action: run_quality_checks
  - **id**: 5
    name: Эскалация
    action: escalate_if_needed
  - **id**: 6
    name: Пост-инцидентная проверка
    action: post_mortem_and_update_runbook
Runbooks: структура, шаблоны и практика
Runbooks представляют собой живую документацию, которая описывает действия в случае операций, инцидентов, изменений и восстановления после сбоев. В DV они являются основным механизмом обеспечения предсказуемости и повторяемости.
- Типы runbooks:
- Инцидентный runbook (incident response): регламентирует шаги для быстрого выявления и устранения проблем в загрузке hubs/links/satellites, после чего обеспечивается повторная загрузка данных и проверка качества.
- Изменённый/вариантный runbook (change/runbook): описывает процедуры внедрения изменений в DV-модель и связанные ETL/ELT-процессы.
- Резервный/DR-runbook (disaster recovery): регламентирует процедуры восстановления критических сервисов и источников в случае катастрофы.
- Плановый технический обслуживании (maintenance/runbook): расписание, задачи, проверки и критерии завершения.
- Структура типового runbook:
- Назначение и область применения
- Роль и ответственность исполнителей
- Предусловия и зависимые сервисы
- Поэтапное описание действий (с проверками на каждом шаге)
- Верификация результата и критерии завершения
- Риски и альтернативные сценарии
- Журнал изменений и версия
- Контактные данные и эскалация
- Жизненный цикл runbook:
- Создание и согласование
- Автоматизация и тестирование
- Эксплуатация и периодическая актуализация
- Ревизия после инцидента
- Шаблон структурированного runbook (пример):
- Цель: устранение инцидента с задержкой загрузки satellites
- Владелец: DV Operations Lead
- Шаги: проверить источники, перезапустить компонент, проверить логи, прогнать проверки качества, обновить запись в журнале инцидентов
- Критерии успеха: загрузка восстановлена, данные соответствуют правилам качества
- Откат: вернуть предыдущую конфигурацию и повторно запустить таргетированную загрузку
- Примеры типовых действий в runbook:
- Проверить статус источников данных и каналы передачи
- Перезапустить конкретную задачу в оркестраторе (например, Airflow) и убедиться в достижении устойчивого статуса
- Прогнать контрольные правила по качеству и сверить с эталонами
- В случае повторения ошибки - переключиться на резервный источник или альтернативный режим загрузки
- Зафиксировать инцидент и провести пост-мортем-обзор для обновления runbook
В DV-процессе критично синхронизировать runbooks с метаданными и правами доступа. Runbook должен содержать ссылки на соответствующие политики безопасности, требования к аутентификации и аудиту, а также регламентировать, как именно должны меняться данные в случае ошибок, чтобы не нарушить бизнес-процессы и соответствовать регуляторным требованиям.
Шаблоны и примеры структурирования runbooks
- Шаблон шаблонов выполняемой документации:
- Заголовок: Incident name / Change name
- Контекст: описание проблемы или изменения
- Владелец и команды
- Время начала и окончания
- Состояние до и после
- Шаги действий (с временными метками)
- Верификация и критерии завершения
- Риск и последствия
- Приложения: логи, графики, ссылки на операций
- Встраивание в методологию DV подразумевает создание единого репозитория runbooks и поддержание их в актуальном состоянии при любых изменениях в архитектуре, источниках и бизнес-правилах.
Пример инцидентного сценария DV
Пускай произошла задержка загрузки satellites после обновления источника. Инцидентный runbook должен включать:
- Проверку статуса источника и доступности CDC-процессов
- Анализ очередей загрузки и статусов задач в оркестраторе
- Перезапуск конкретной задачи и мониторинг последствий
- Проведение валидации и контрольных тестов по качеству данных
- Эскалацию в случае повторной ошибки
- Обновление журнала инцидентов, создание пост-инцидентного отчета и обновление runbook
Как обеспечить эффективную автоматизацию runbooks
- Делайте runbooks idempotent и повторяемыми. Любое повторение должно приводить к одинаковому результату.
- Инкорпорируйте автоматизированные тесты качества данных и согласования метаданных, чтобы на каждом шаге проверки можно автоматически подтверждать корректность.
- Используйте регистры изменений и контроль версий для всех артефактов runbook.
- Встраивайте в runbooks механизмы отката, чтобы в случае неудачи можно быстро вернуть систему к устойчивому состоянию.
Управление качеством данных, метаданными и безопасность в операционной практике DV
Управление качеством данных и метаданными становится неотъемлемой частью эксплуатации DV. Качественные данные - это первый фактор доверия к DWH, а метаданные - ключ к прослеживаемости изменений и влияний на аналитические результаты.
- Качество данных. В DV качество достигается за счёт:
- строгого соблюдения бизнес-правил на уровне satellites и их связь с hubs/links
- контроля полноты и точности, временной непрерывности и согласованности ключей
- регулярного сравнения с источниками и тестирования на репортажном слое
- Метаданные и линей происхождения. В условиях DV метаданные должны отражать:
- происхождение данных, версии схем, точку времени, где данные были извлечены
- правило обработки и трансформации, а также роль того или иного столбца в витрине
- связи между элементами DV и бизнес-объектами, линкование зависимостей
- Безопасность и соответствие. Необходимо обеспечить:
- принцип минимальных привилегий для доступа к данным и инструментам DV
- аудит доступа и изменений, регистрирование попыток несанкционированного доступа
- маскирование чувствительных данных в соответствии с регуляторами и внутренними политиками
- резервирование и восстановление данных в соответствии с RPO/RTO
Эти элементы должны быть встроены в операционные процессы и отражаться в runbooks и мониторинге. В DV контекст обеспечивает не только качество данных, но и устойчивость к изменениям в бизнес-процессах и источниках данных, что критично для больших корпоративных систем.
Автоматизация, изменения и DevOps для DV
Достижение устойчивого уровня эксплуатации DV требует сочетания методик DevOps/DevSecOps и специфики DV-модели. Основные принципы:
- Контейнеризация и инфраструктура как код. Инфраструктурные ресурсы для DV-окружения описываются как код, чтобы обеспечить воспроизводимость и автоматизацию развёртывания.
- Версионность схем DV и процесс релизов. Все изменения в hubs/links/satellites и в ETL/ELT-процессах должны мигрировать через CI/CD-процессы, включая автоматизированные тесты и стадии проверки качества.
- Метаданные как источник правды. Все изменения в моделях, бизнес-правила и загрузках должны регистрироваться в метаданной реестре и быть доступны для аудита и анализа влияния.
- Idempotent loads и повторная обработка. В DV-архитектуре данные должны загружаться без побочных эффектов при повторном выполнении, что существенно повышает надёжность операций.
- Тестирование на стейджинг-средах. В DV необходимо тестировать изменения на приближённых к продакшн условиях стейджинг-средах, включая тестирование на полноту и корректность данных, а также проверку времени выполнения загрузок.
- Автоматические сценарии восстановления. В runbooks должны быть описаны конкретные сценарии восстановления после сбоев, которые можно запустить автоматически или с минимальным участием оператора.
Применение этих подходов создаёт устойчивую операционную среду DV и минимизирует риск ошибок при масштабировании хранилища и усложнении интеграций.
Безопасность и соответствие
Безопасность и комплаенс занимают центральное место в операционной модели DV. В рамках эксплуатации следует соблюдать:
- Принцип наименьших привилегий: доступ к источникам, загрузчикам и витринам ограничен соответствующими ролями.
- Аудит и журналирование: каждая операция и доступ записываются с временными метками, пользователями и контекстом.
- Маскирование и защита чувствительных данных: применяются правила маскирования, шифрования и сегментации по уровням доступа.
- Резервирование и восстановление: стратегии DR должны быть прописаны на уровне runbooks и тестироваться регулярно.
- Регуляторные требования: соответствие хранению данных, ретенциям, доступу и передачам в рамках региональных норм.
Эти аспекты должны быть встроены в процессы эксплуатации и детально отражаться в документах и runbooks, чтобы обеспечивать прозрачность и надёжность в рамках бизнес-операций.
Key takeaways
- Эксплуатационная модель DV требует чёткого разделения ролей, регламентов и управляемой эскалации инцидентов.
- Мониторинг DV должен охватывать источники, загрузчики, DV-архитектуру и витрины, сочетая данные о доступности, задержках и качестве данных.
- Runbooks являются базисом устойчивой операционной деятельности: их структура, жизненный цикл и шаблоны должны быть унифицированы и версионированы.
- Управление качеством данных и метаданными в DV обеспечивает прослеживаемость, доверие и соответствие бизнес-правилам.
- Автоматизация, DevOps-практики и безопасная архитектура создают условия для масштабируемости и надёжности корпоративного DWH на базе Data Vault.
FAQ
- Что такое операционная модель DV и зачем она нужна?
Операционная модель DV описывает роли, процессы, артефакты и регламенты для эксплуатации хранилища на базе hubs, links и satellites. Она нужна для обеспечения предсказуемости загрузок, устойчивости к сбоям, прослеживаемости изменений и соответствия требованиям бизнеса и регуляторов.
- Какие ключевые роли необходимы в DV-операционной команде?
Ключевые роли включают Data Vault Operations Lead, BI/DS инженеры, инженеры интеграции, Data Quality Stewardship, Архитектора DV, специалистов по безопасности и соответствию. В рамках команды важна концепция RACI и четкая эскалация.
- Какие метрики следует включить в мониторинг DV?
Необходимо охватить сигналы инфраструктурной доступности, загрузки и задержек, качество данных (полнота, точность, согласованность), а также операционные показатели (MTTR, частота инцидентов). В DV дополнительно полезны сигналы по долговечности связей hubs/links и историчности satellites.
- Как строить runbooks для DV?
Runbooks должны быть структурированы как living документы: цель, область применения, роли, шаги действий, критерии завершения, риск-профили и регистр изменений. Для каждого инцидента рекомендуется использовать типовые шаги с возможностью автоматизации и откатов.
- В чем преимущество автоматизации в DV?
Автоматизация снижает риск человеческой ошибки, ускоряет реакцию на инциденты, обеспечивает повторяемость процессов и упрощает масштабирование. Idempotent loads и регламенты CI/CD снижают риск рассогласований между версиями моделей и данными.
- Какие инструменты чаще всего применяют для мониторинга DV?
Чаще всего применяют Prometheus и Grafana для метрик, Elastic/OpenSearch для логов, OpenTelemetry для трассировки, Apache Kafka как очередь событий, и ClickHouse как аналитическое хранилище. В качестве оркестратора - Apache Airflow или аналог.
- Как обеспечить безопасность в DV-эксплуатации?
Необходимо внедрять принцип наименьших привилегий, аудиты доступа, маскирование чувствительных данных, резервирование и проверку соответствия регламентам. Все операции должны быть отражены в журналах и доступ к данным осуществляться через управляемые роли.
- Как связать монитοринг DV с бизнес-результатами?
Через влияние на качество данных, доступность и своевременность отчетности. Метрики должны конвертироваться в KPI для бизнес-подразделений: своевременный доступ к аналитике, точность бизнес-словарей и согласованность между витринами.
- Какие подходы к тестированию изменений в DV вы рекомендуете?
Рекомендуется тестировать изменения на стейдж-окружении с близкими объёмами данных, проводить регрессионные тесты качества и согласования, а также автоматизировать проверки линейности и совместимости между hubs, links и satellites.
- Как работать с изменениями в DV-модели без риска потери данных?
Используйте версионирование модулей DV, миграционные сценарии в CI/CD, тестирование на демо-окружении и поэтапный rollout. Внесение изменений должно сопровождаться обновлениями runbooks и документированием влияния на витрины и бизнес-процессы.


