

Архитектура пайплайнов для аналитики: Data Lake, Data Warehouse, Data Marts
Операционная база данных продолжает давать поток изменений в режиме реального времени, а аналитика требует устойчивой и управляемой архитектуры, способной перерабатывать эти изменения в полезные бизнес-инсайты. В условиях Debezium и Kafka архитектура пайплайнов для аналитики должна соединять точность передачи изменений, консистентность данных и скорость обработки с требованиями к данным, доступности и управляемости. Эта глава посвящена проектированию такой архитектуры с фокусом на три уровня аналитического стека: Data Lake, Data Warehouse и Data Marts. Рассматриваются принципы построения потоков изменений, схемы их обработки и принципы взаимодействия между слоями, а также практики мониторинга, управления схемами и обеспечения качества данных.
Архитектура публикованных изменений требует системного подхода: каждое изменение в операционной системе преобразуется в поток событии, который затем маршрутизируется, обогащается и сохраняется в слое аналитики. В контексте Debezium это означает конечную цель - надежную запись изменений в Kafka, последующую трансформацию и сохранение в Data Lake, а затем в Data Warehouse и Data Marts. В данной главе сочетание архитектурной проработки, продуктовых решений и организационных практик позволяет не только достигнуть технической реализуемости, но и обеспечить устойчивость pipelines при эволюции источников данных, регулятивных требованиях и изменениях бизнес-логики.
Краткое содержание главы
- Архитектурные принципы CDC-пайплайнов: обработка изменений, маршрутизация и гарантии консистентности на уровне потоков.
- Data Lake как основа аналитического стека: Bronze-Silver-Gold, форматы Parquet/ORC и роль lakehouse через таблицы с поддержкой ACID.
- Интеграция Data Lake и Data Warehouse: ELT-процессы, микро- и нано-буферы, модели данных и сценарии миграции.
- Data Marts и семантический слой: бизнес-оринтированные представления, скорость поставки и управление качеством на уровне потребителей.
- Операционная практика: мониторинг, управление схемами, безопасность, governance и CI/CD для CDC-пайплайнов.
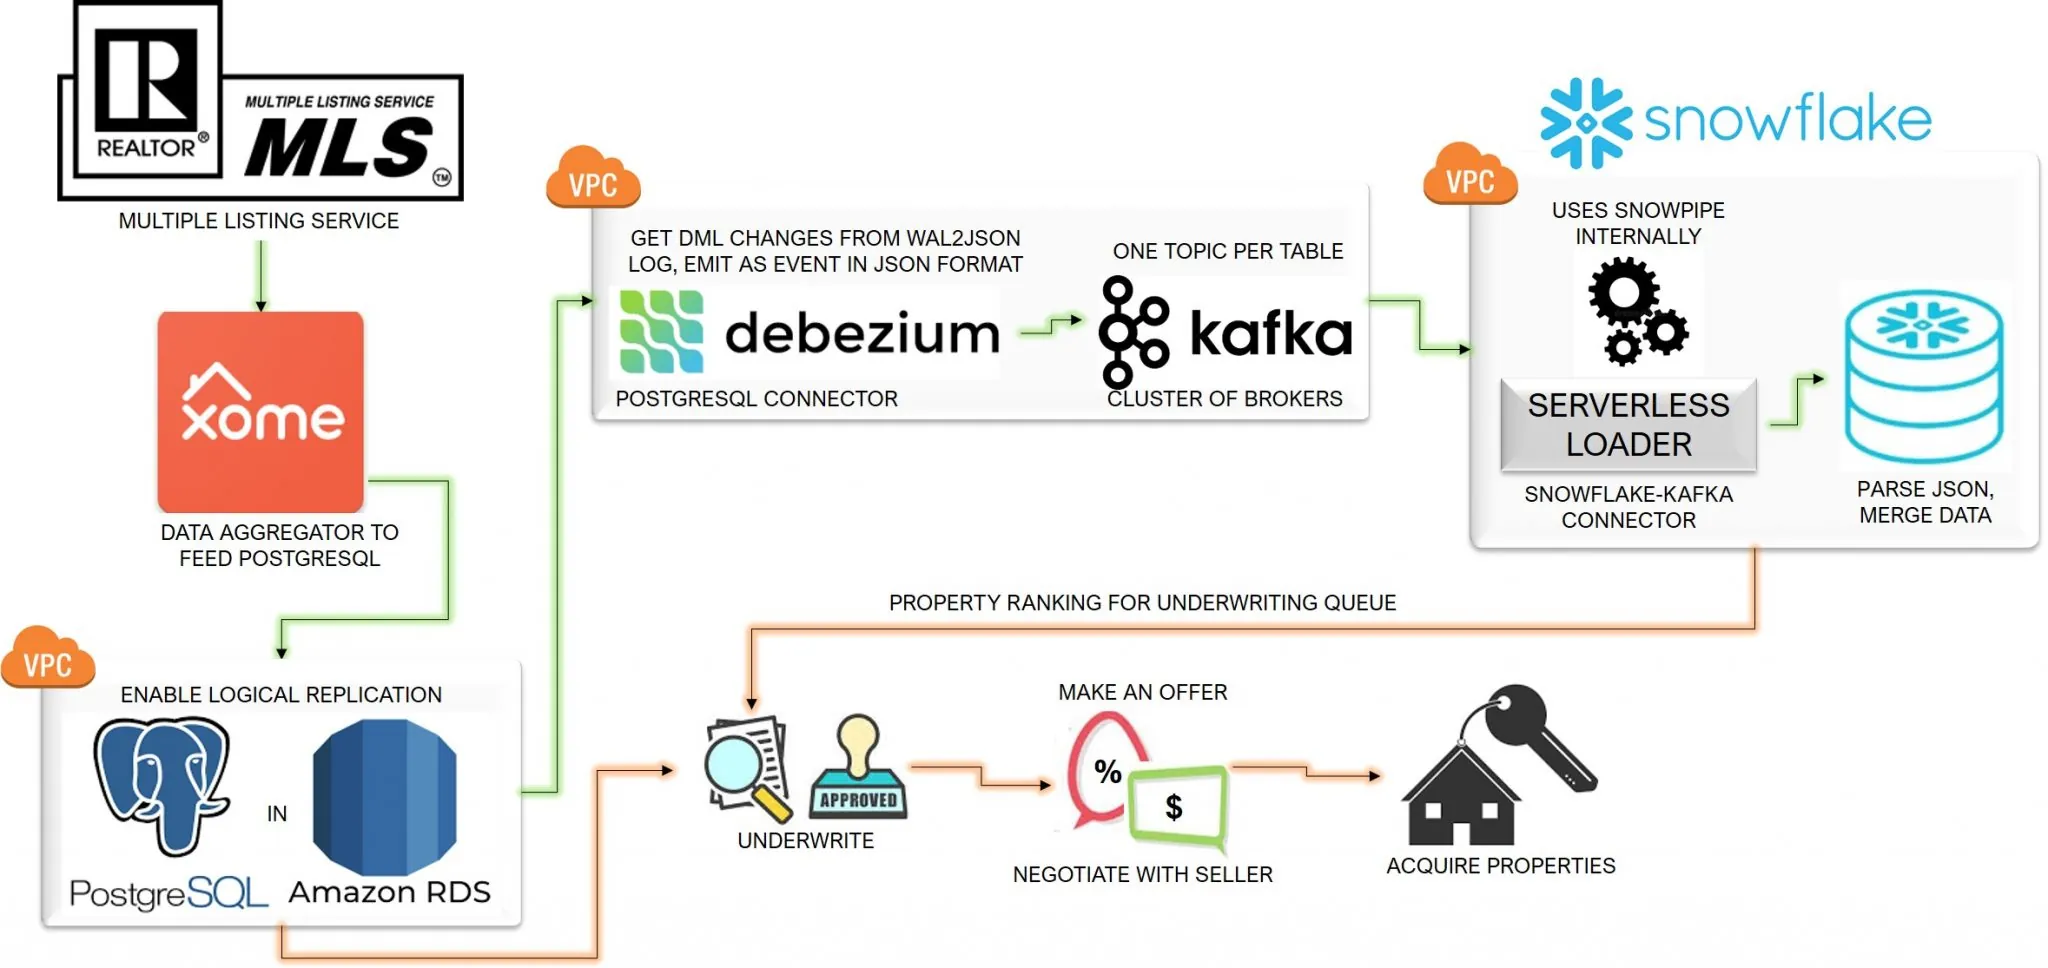
Архитектура CDC пайплайнов: принципы, протоколы и интеграции
Извлечение изменений из операционных систем начинается с точной передачи событий в потоковую инфраструктуру. Debezium предоставляет изменение данных в формате событий, которые несут ключевые характеристики: операция (insert/update/delete), текущие и предыдыщие значения (before/after), временные параметры и идентификаторы транзакций. Основная задача архитектуры - превратить эти события в устойчивый поток, который можно безопасно разрушать и восстанавливать позднее, не теряя консистентности.
Ключевые принципы:
- Гарантии целостности: получение изменений должно быть воспроизводимо и детерминировано. Это достигается за счет использования ключа записи (primary key) как уникального идентификатора и хранения изменений в упорядоченном потоке. В связке с Kafka это подразумевает аккуратное управление активацией сжатия, компакцией и обработкой совокупных транзакций.
- Маршрутизация на уровне потоков: стратегия именования и разделения тем должна отражать доменную логику. Обычно применяются темы per database и per table, с дополнительными префиксами для категории данных (raw, enriched, aggregated). Это позволяет гибко управлять уровнем абстракции и степенью обработки на downstream.
- Управление схемами: эволюция схемы неизбежна. Использование схем-реестра (Schema Registry) позволяет отслеживать изменения структуры сообщений без деградации существующих консьюмеров. В сочетании с безопасной миграцией схем это снижает риск несогласованности между продюсерами и консьюмерами.
- Интеграция с транзакционной моделью: концепция «точно один раз» на уровне конвейера достигается через транзакционные продюсеры Kafka, обработку в рамках одной транзакции и поддерживаемые Debezium/Connect механизмы. В противном случае остается риск дублирования или пропуска изменений.
- Расширяемость и отказоустойчивость: паттерны «путь мелких конвейеров» и «путь больших конвейеров» позволяют разворачивать независимые фрагменты: CDC в Kafka, обработку в Flink/ksqlDB, загрузку в Data Lake и далее в хранилище. Такой подход облегчает масштабирование и локализацию ошибок.
Поскольку Debezium соответствует принципам CDC на уровне баз данных, важным аспектом является выбор стратегий конфигурации и маршрутизации. В реальных сценариях часто применяют как минимум две парадигмы: (1) переработку событий на уровне потоков в режиме конвейера с минимальной задержкой, (2) накопление и агрегацию изменений для последующей пакетной загрузки в Data Warehouse. Второй подход особенно полезен, когда требуется согласованность между несколькими источниками, а время актуальности данных может быть менее критичным, чем точность и полнота.
В контексте интеграции с Kafka применимы следующие практики:
- Выбор между темами с высокой грануляцией (per table) и темами с меньшей гранулярностью (группировка нескольких таблиц) зависит от требований к латентности и управляемости. Чем выше грануляция, тем проще локализовать ошибки, но тем выше число консьюмеров и сложность обработки.
- Использование компактированных тем гарантирует, что удаление устаревших ключей не заполняет ленту и сохраняет историю изменений в виде ключ-значение, пригодного для детектирования изменений.
- Эволюция схем и совместимость: при добавлении новых полей можно постепенно применить «backward-compatible» изменения, сохранив старые консьюмеры работоспособными. Это особенно важно для Data Lake и стейджинга в Bronze слое.
- Безопасность и соответствие: шифрование данных в покое и в передаче, контроль доступа к темам и таблицам, аудит изменений и хранение журнала изменений для соответствия регулятивным требованиям.
Практическая навигация по паттерну: в реальном проекте часто применяется архитектура, в которой Debezium публикует события в набор компактированных тем. Затем Flink или Spark Streaming потребляет эти события, обогащает их бизнес-логикой, выполняет коррекцию ошибок и отправляет в Data Lake. На этапе Data Lake данные подвергаются дальнейшей обработке и нормализации, создавая Silver и Gold слои. Такой подход обеспечивает прозрачную трассируемость источников и мощную основу для последующих бизнес-подразделений.
Data Lake архитектура: Bronze-Silver-Gold, lakehouse и управление схемами
Data Lake становится центральным хранилищем для всего оперативного потока изменений. Он нужен не столько как архив, сколько как платформа для трансформаций, ускоряющих анализ и эксплуатацию отчетности в реальном времени. В контексте Debezium и CDC Data Lake организуется в несколько слоев, каждый из которых имеет специфические требования к формату данных, метаданным и качеству.
- Bronze слой. Здесь сохраняются «сырые» Change Data Capture события. Формат чаще всего - Parquet или ORC с минимальной степенью нормализации и значительным уровнем денормализации, чтобы сохранить контекст источника и схему событий. В этом слое важна неизменяемость и возможность трассировки изменений до источника. Хранение в этом слое обеспечивает полное аудирование и помогает в регулятивных проверках.
- Silver слой. В этом слое выполняются обогащения, валидирования и нормализация. Здесь приводятся к единой модели бизнес-объектов (например, пользователи, заказы, товары) и удаляются избыточности. Обращения к Silver слою обычно служат входом для аналитических запросов и для построения служебных конвейеров, которые формируют агрегаты и информационные витрины.
- Gold слой. Это бизнес-ориентированные, готовые к потреблению наборы данных: агрегаты, показатели эффективности, подготовленные к созданию дашбордов и отчетности. Здесь часто применяются тесные связи с Data Marts: специализированные, ориентированные на подразделения наборы таблиц, оптимизированные под конкретные consulta и SLA.
Ключевые аспекты Data Lake в контексте CDC:
- Форматы и хранение: Parquet/ORC обеспечивают эффективную компрессию и ускоряют аналитическую обработку. Принято использовать колонко-ориентированные форматы для ускорения скана столбцов, необходимых бизнес-аналитикам.
- Lakehouse и управление версиями: интеграция с Iceberg (или аналогами, например Delta Lake) обеспечивает транзакционные гарантии и поддержку схемной эволюции. Это критично для тех случаев, когда изменения в схемах источников происходят часто и требуется точная временная трассировка версий.
- Эволюция схем: сценарии изменений вроде добавления полей, изменение типов или удаления столбцов должны правильно согласовываться с downstream-слоями. В идеале каждая версия схемы должна быть доступна для временного перемещения и ретроактивной адаптации консумеров без принудительной перезагрузки всей инфраструктуры.
- Контроль качества и управление данными: в Bronze слой вносятся проверки на полноту, валидность и отсутствие критических ошибок; затем в Silver - более строгие правила. Gold - контроль качества на уровне бизнес-метрик и целевых KPI.
Интеграция Debezium и Kafka в Data Lake:
- Debezium публикует события в Kafka, а затем их адаптеры (например, Flink или Spark Structured Streaming) конвертируют поток в табличную модель и записывают в Bronze. Этот этап должен поддерживать idempotentность и корректное повторное применение изменений.
- На этапе Silver осуществляется нормализация и связывание с существующими бизнес-объектами (например, сопоставление клиентов и заказов к единой витрине). В этом месте часто применяются операции с оконными или агрегатными функциями, чтобы подготовить данные для Gold.
- В Gold слой данные уже на уровне бизнеса: готовые к анализу наборы, часто ориентированные на ключевые показатели по направлениям (маркетинг, продажи, финансы).
Data Lake как основа для последующей загрузки в Data Warehouse поддерживает тесную связь между реальным временем изменений и бизнес-логикой. Для этого применяются паттерны ELT: данные из Bronze/Silver попадают в staging-объекты внутри Data Warehouse, затем выполняются трансформации и создаются финальные таблицы. В современной архитектуре lakehouse эта граница становится гибкой: Iceberg обеспечивает базовую транзакционность и временную путешественность (time travel), что упрощает синхронизацию с хранилищем.
Практически важны решения по управлению схемами и совместимости. При работе с Iceberg или Delta Lake следует планировать стратегии миграции схем: использовать добавление новых полей как совместимое изменение (backward-compatible), избегать радикальных изменений без уведомления downstream систем и без тестирования на пайплайнах. Это снижает риски прерывания поставок в Silver и Gold слои.
Data Warehouse: интеграция, ELT-процессы и оперативная доставка
Data Warehouse представляет собой контейнер для интегрированной, структурированной и высоко оптимизированной аналитической модели. В контексте CDC и Debezium он чаще всего строится как «мост» между lakehouse и бизнес-потребителями, обеспечивая стабильные, управляемые и хорошо документированные представления данных. В современных реалиях практикуются как облачные хранилища (Snowflake, Redshift), так и открытые решения (ClickHouse, PostgreSQL-based хранилища). В рамках данного раздела рассмотрим принципы интеграции и методы загрузки.
- ELT как основной паттерн: данные из Data Lake переносятся в Data Warehouse для дальнейшей обработки и анализа. В отличие от классического ETL, ELT переносит базовую подготовку в наружный слой, позволяя использовать вычислительную мощность хранилища для трансформаций. Это обеспечивает большую гибкость, упрощает управление версиями и ускоряет доставку данных.
- Реальное время против близкой к реальному времени загрузки: CDC-потоки позволяют обновлять хранилище в реальном времени или в near real-time. В зависимости от потребностей бизнеса выбирают режим микробатчей (микро-пакеты) или непрерывной доставки обновлений. В Snowflake для этого применяются конвейеры через Snowpipe и механизмы Streams и Tasks, что обеспечивает автоматические обновления при появлении изменений.
- Модели данных: для Data Warehouse применяют многомерную или гибридную модель. Часто выбирают звездную схему для оперативной аналитики и скорости запроса, а также потенциально внедряют стратегии SCD (Slowly Changing Dimensions) для управления изменениями в размерностях. В контексте CDC важно обеспечить согласованность между фактами и измерениями, чтобы обновления в источниках корректно отражались в моделях.
- Способ связи с Data Lake: интеграция через каналы, которые поддерживают транзакционные обновления, версионирование и консистентность. В идеале - единая система для отслеживания изменений и их восстановления, чтобы не создавать дубликаты или расхождения между слоями.
Практические сценарии миграции и загрузки:
- Прямой загрузкой (from Kafka): конвейеры потребляют события и обновляют соответствующие таблицы в Data Warehouse. В качестве практики применяют idempotentные режимы загрузки и контроль уникальности записей.
- ELT через staging: данные сначала попадают в staging-области, где выполняются первичные трансформации и валидации. Затем выполняются целевые таблицы фактов и измерений. Этот подход упрощает отладку и тестирование, а также обеспечивает уверенность в точности изменений.
- Модульность и независимость: разделение на микро-конвейеры для отдельных доменов (финансы, продажи, клиентская аналитика) позволяет уменьшить влияние изменений из одной области на другие и ускоряет масштабирование.
Ключевые технологические детали:
- Управление схемами: использование схемного реестра и версий схем упрощает миграции и обеспечивает совместимость между источниками и потребителями. Это особенно важно, когда источники добавляют новые поля или меняют структуры событий.
- Роли и ответственность: Data Engineering отвечает за CDC, транзакционную корректность и транспортировку изменений. Data Analytics и BI команды - за структурирование данных, создание витрин и соблюдение бизнес-логики. Важно обеспечить четкое согласование между этими ролями и наличие документированной картины потоков данных.
- Безопасность и соответствие: в рамках Data Warehouse должны быть реализованы требования к безопасности на уровне столбцов (маскирование), аудит доступа и соответствие регулятивным требованиям.
Data Marts и семантический слой
Data Marts выступают как бизнес-ориентированные подмножества аналитики, предоставляющие готовые к потреблению наборы данных для конкретных подразделений: продажи, маркетинг, финансы, операционный анализ. Они строятся на основе Data Warehouse и часто используют уже существующие модели звездной схемы. В рамках Debezium и CDC задача Data Marts - обеспечить быструю доставку бизнес-метрик и минимизировать задержку между событием и доступностью аналитического вывода.
- Семантический слой: создание общих бизнес-объектов и их бизнес-правил, которые служат единым словарем для BI-инструментов. Семантический слой упрощает переработку данных, улучшает повторное использование витрин и повышает понятность бизнес-пользователям.
- Микро-агрегаты и витрины по доменам: для каждого направления создаются агрегаты на уровне временных окон (например, продажи за текущий день, месяц, год) и целевые метаданные (показатели, KPI). Это снижает нагрузку на потребителей и ускоряет отклик BI-инструментов.
- Управление качеством в контексте потребителей: Data Marts должны поддерживать SLA по времени доставки и точности агрегатов. Для этого применяются проверки согласованности, сверка с исходными данными и средства мониторинга задержек.
- Модели доступа: обеспечение безопасного и удобного доступа к витринам через BI-инструменты, API или Virtualization-сервисы. В некоторых случаях применяют слой виртуализации данных - он обеспечивает единый интерфейс к данным, скрывая сложность подлежащих слоев.
Преимущества такого подхода заключаются в ускоренном времени принятия решений и в более точном управлении ожиданиями бизнес-подразделений. Data Marts позволяют бизнесу работать с данными, не входящими в объем общего Data Warehouse, но все же сохраняющими единообразие моделирования и контроль качества.
Операционная практика: мониторинг, управление схемами, безопасность и CI/CD
Успех CDC-пайплайнов зависит не только от архитектурнойков, но и от операционных практик. Мониторинг и observability должны покрывать все слои: от источников изменений до витрин в Data Marts. Важно иметь единый панель мониторинга, которая отслеживает задержку, пропуски изменений, hit-rate и статус коннекторов Debezium, а также состояние конвейеров обработки (Flink, Spark, ksqlDB) и загрузок в Data Lake и Data Warehouse.
Ключевые аспекты операционной практики:
- Непрерывность и отказоустойчивость: режимы репликации, автоматическое переключение на резервные копии, повторная попытка обработки и ретрансляции изменений в случае сбоев. Важно иметь детальный журнал событий, чтобы можно было воспроизвести или откатить операции.
- Безопасность и соответствие: разделение доступа к данным по ролям, маскирование чувствительных полей, аудит доступа и защиту данных в покое и в передаче (шифрование, ключи, безопасное хранение секретов). Это критично для соблюдения регуляторных требований.
- Governance и каталогизация: активное управление метаданными, версионирование витрин, автоматизированная схема-эволюция и документирование источников изменений. Это упрощает поддержку и аудит.
- CI/CD для CDC-пайплайнов: инфраструктура как код, тестирование конвейеров на тестовых средах, контроль версий конфигураций коннекторов и трансформаций. Включение тестов на полноту данных, регрессионное тестирование трансформаций и сравнение результатов между версиями позволяют снижать риски.
- Управление качеством данных: набор методик QA для CDC: валидации схем, согласование данных между слоями, тесты на дубликаты и пропуски, контроль соответствия бизнес-логике.
Современная экосистема поддерживает инструменты мониторинга и алертинга, которые помогают быстро выявлять узкие места: задержки между источником и витриной, пропуски изменений, некорректные трансформации. В рамках архитектурного подхода следует внедрять регулярные ревизии и улучшения процессов, чтобы адаптироваться к новым источникам и требованиям бизнеса.
Key takeaways
- Debezium и Kafka образуют основу CDC-пайплайна: аккуратно спроектированные потоки и маршрутизация тем позволяют управлять изменениями от источника к аналитике.
- Data Lake с Bronze-Silver-Gold слоистостью и использование lakehouse-таблиц (Iceberg) обеспечивают масштабируемость, транзакционность и эволюцию схем без потери аудита.
- ELT-подход к Data Warehouse обеспечивает гибкость трансформаций и быстрый доступ к бизнес-аналитике. Моделирование звездной схемы и управление SCD поддерживают качество анализа.
- Data Marts служат для бизнес-экосистем, предоставляя готовые витрины, семантический слой и быстрый доступ к ключевым метрикам.
- Операционная дисциплина: мониторинг, governance, безопасность и CI/CD обеспечивают устойчивость пайплайнов и соответствие регулятивным требованиям.
FAQ
- Какие главные архитектурные различия между Data Lake и Data Warehouse в контексте Debezium?
- Data Lake служит как универсальный буфер изменений и место для быстрой агрегации и нормализации. Он хранит сырые и трансформированные данные в формате Parquet/ORC и поддерживает транзакционность на уровне слоев через lakehouse-технологии. Data Warehouse, напротив, ориентирован на структурированную аналитическую модель, поддерживает высокую скорость запросов и строгие схемы, а загрузка из Lake производится через ELT-процессы с целью быстро оформить нужные бизнес-словарь и витрины.
- Как выбрать между per-table и per-database темами в Kafka?
- Per-table темы обеспечивают большую гибкость и локализацию проблем, но увеличивают число топиков и сложность обработки. Per-database топики уменьшают количество топиков, упрощают мониторинг, но требуют аккуратной обработки ситуации, когда изменения происходят в нескольких таблицах. Выбор зависит от требований к латентности, сложности обработки и управляемости: для крупных организаций чаще применяют гибридный подход, где критические таблицы публикуются в отдельных темах, а менее критичные - в агрегированных.
- Как обеспечить консистентность изменений между слоями Data Lake и Data Warehouse?
- Ключевые принципы: (1) использовать единый идентификатор бизнес-объекта (первичный ключ) и согласованные схемы; (2) применять транзакционные операции на уровне конвейера (в рамках возможностей Kafka и sink-технологий); (3) реализовать согласование между слоями через контроль версий схем и валидацию на каждом этапе (Bronze → Silver → Gold); (4) обеспечить возможность повторной обработки и восстановления в случае сбоев без потери данных.
- Что такое «lakehouse» и зачем он нужен в контексте CDC?
- Lakehouse - это объединение преимуществ Data Lake и Data Warehouse. Он обеспечивает хранение больших объемов данных в дешевой и гибкой среде Data Lake с транзакционной поддержкой, версионированием и схемной эволюцией, что позволяет безопасно и эффективно обрабатывать CDC-события. В рамках Debezium это позволяет не терять аудита и соответствовать требованиям к консистентности, сохраняя данные в единообразной среде.
- Какие паттерны загрузки применяют для Data Warehouse при CDC?
- Наиболее распространены два паттерна: (a) прямой конвейер из Kafka в таблицы фактов/измерений с минимальными трансформациями; (b) ELT-подход через staging-площадки, где сначала выполняются проверки и нормализация, затем загружаются целевые витрины. В реальных условиях часто применяют гибриды, где критичные витрины обновляются в реальном времени, а менее критичные - через микро-батчи.
- Как управлять схемами и их эволюцией без срывов пайплайнов?
- Важна версия схемы и совместимость: внедрять совместимые изменения (добавление полей без удаления существующих), поддерживать обратную совместимость, и иметь Strategy для отката. Использование Schema Registry позволяет централизованно управлять схемами и предупреждать несовместимости. Регулярные тесты трансформаций на тестовых средах и тестовые прогонки с источниками помогут обнаружить несовместимости до применения в продакшене.
- Какие меры эксплуатации критичны для CDC-пайплайнов?
- Мониторинг задержек и throughput по каждому этапу; автоматизация алертинга при отклонениях; обеспечение устойчивости через резервирование и автоматическое восстановление. Важно также управлять безопасностью: доступ к данным и топикам, маскирование чувствительной информации, аудит изменений и соответствие регулятивным требованиям.
- Какие инструменты чаще всего применяют в связке Debezium-Kafka-Flint/Spark?
- Debezium выступает как источник изменений, Kafka - как транспорт и брокер потоков, Spark или Flink - как движок обработки потоков, выполняющий обогащение и преобразование, а Snowflake/кластеры облачных warehouse - как место хранения и доступа к витринам. Schema Registry используется для управления схемами, а инструменты мониторинга - для отслеживания латентности и качества данных.
- Что делать при резком изменении бизнес-логики и требований к данным?
- Необходимо предусмотреть гибкую архитектуру: иметь слой семантики и витрины, которые можно адаптировать без изменения источников; внедрить версионирование схем и держать текущие версии доступными. Важно обеспечить коммуникацию между командами данных и бизнес-единицами, чтобы новые требования быстро вошли в архитектуру через обновления витрин и правил трансформаций.
- Какие преимущества дает сочетание Data Lake, Data Warehouse и Data Marts в рамках CDC?
- Совокупная архитектура обеспечивает: (а) высокую гибкость в источниках данных и скорости их обновления, (б) управляемую и масштабируемую аналитическую модель, (в) бизнес-ориентированные витрины и семантический слой, которые сокращают время принятия решений и улучшают качество данных. Такой подход позволяет бизнесу использовать свежие данные, не ограничиваясь старым архивом или устаревшей схемой, и одновременно соблюдать требования к качеству и управлению данными.
Концептуально и практическo данная глава нацелена на то, чтобы дать методологически обоснованные принципы проектирования архитектуры CDC пайплайнов и их реализации в контексте аналитических стэков. В реальном проекте сопоставление архитектурных решений с организационными требованиями и регулятивными ограничениями обеспечивает не только техническую выполнимость, но и бизнес-ценность от внедрения CDC, которая проявляется в оперативной аналитике, ускорении процессов принятия решений и устойчивой устойчивости инфраструктуры к изменениям источников данных.


