

Управление представлениями: views и materialized views в DuckDB
Логика представлений в DuckDB строится вокруг двуединого механизма: динамические представления (views), которые пересчитываются на каждый запрос, и материализованные представления (materialized views), которые сохраняют результат подзапроса и требуют явного обновления. В контексте Data Engineering эти два механизма позволяют управлять вычислительной нагрузкой, задержкой и сложностью пайплайнов, облегчая повторное использование логики и упрощая источники данных. Выбор между ними зависит от частоты обновления исходных данных, требований к задержке и критичности актуальности результатов. В данной главе рассматриваются архитектурные основы DuckDB, принципы планирования запросов с участием представлений, практические сценарии внедрения, а также практики мониторинга и интеграции с Python и аналитическими инструментами.
Краткое содержание главы
- Понимание различий между views и materialized views, их влияние на актуальность данных и нагрузку на систему.
- Архитектура DuckDB вокруг представлений: как запросы пишутся, развертываются и кэшируются.
- Практические сценарии: когда выбирать views, а когда - materialized views, и как спроектировать пайплайны.
- Реализация и управление: создание, обновление, мониторинг и тестирование представлений.
- Интеграция с Python и аналитическими инструментами: сценарии использования и примерные паттерны внедрения.
- Рекомендации по паттернам и управлению в реальных проектах.
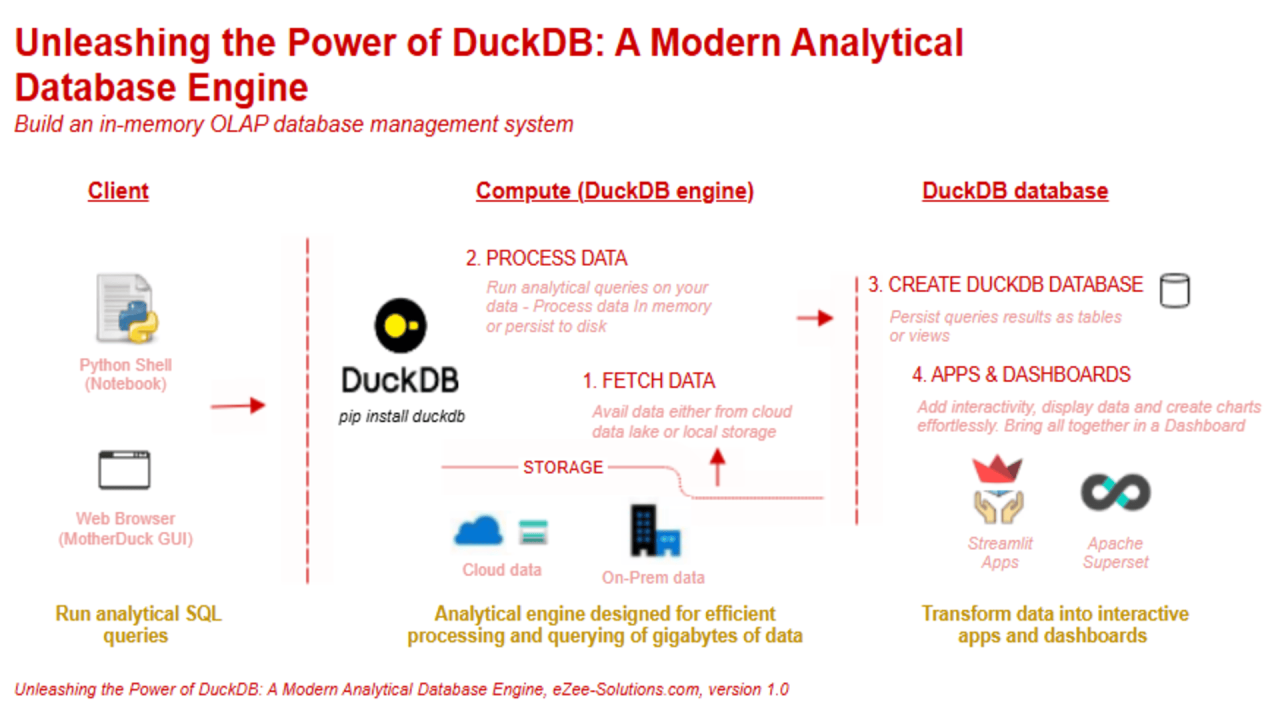
Контекст и концепции
Представления в DuckDB реализуют логику запроса как абстракцию над исходными данными. Обычные (dynamic) views не хранят результат; каждый вызов читается заново и пересчитывается на основе актуальных данных. Это обеспечивает всегда актуальные данные, особенно в динамичных пайплайнах, где данные часто обновляются. Однако такая актуализация может быть дорогостоящей при больших объемах данных и сложной агрегационной логике.
Материализованные представления сохраняют результат подзапроса в виде физической таблицы, что позволяет выдавать ответ быстрее за счет чтения уже вычисленного набора данных. В DuckDB материализованные представления требуют явного обновления - вызов REFRESH MATERIALIZED VIEW или аналогичной команды. Это позволяет рассчитаться с задержкой между загрузкой данных и их доступностью для аналитики, но требует стратегии обновления, чтобы не потерять согласованность в пайплайнах.
Архитектурно DuckDB исследует возможность использования представлений на этапе планирования запросов, где логика определения представления включается в синтаксическое дерево, а затем оптимизируется вместе с основным запросом. С точки зрения исполнителя: обычные views реализуют ленивую стратегию, при которой план запроса включает подзапрос к определённой таблице или другому представлению; материализованные представления поддерживают хранение результатов и могут быть выборочно обновлены после изменений в базовых таблицах. Важной концепцией становится зависимость между представлениями и источниками данных - DuckDB строит граф зависимостей и отслеживает влияние изменений на валидность кэшированных результатов.
С точки зрения протоколов взаимодействия и интеграций важна поддержка контекстов транзакций и атомарности обновления MV. В большинстве сценариев MV обновляется через отдельную транзакцию, чтобы сохранить консистентность и избежать попадания частично обновлённых данных в аналитические запросы. Это критично для пайплайнов, где данные попадают в BI-слой или используют downstream-работы, чувствительные к задержкам и аномалиям.
Архитектура и реализация
DuckDB реализует представления как часть плана выполнения запроса. При выполнении запроса, который ссылается на view, движок планирования разворачивает представление в соответствующий подзапрос и затем применяет оптимизации на уровне всего запроса. Для materialized views DuckDB хранит результат в виде физической таблицы с регистрацией зависимостей на базовые таблицы. При выполнении запроса, который обращается к MV, система может выбрать использование кэшированного результата или пересчитать данные при необходимости, в зависимости от политики обновления и актуальности данных.
Ключевые моменты архитектуры:
- Разрешение зависимостей: DuckDB строит граф зависимостей между представлениями и базовыми таблицами, чтобы понять, какие данные требуют перерасчета при загрузке новых данных.
- Оптимизация и ребайп: планировщик применяет стандартные техники оптимизации (predicate pushdown, проекции, сортировку и агрегации) к развёрнутым выражениям. В случае MV часть вычислений может быть вынесена в загрузочный этап, что уменьшает стоимость повторной обработки.
- Поддержка составных представлений: view может ссылаться на другие views и MV, что позволяет строить сложные, модульные пайплайны. DuckDB аккуратно разворачивает такие зависимости и обеспечивает консистентность на момент обращения.
- Транзакционность и согласованность: обновление MV выполняется как атомарная операция, чтобы гарантировать, что внешние запросы видят либо старый, либо новый, консистентный набор данных. При необходимости поддерживаются сценарии прерывания и повторной попытки обновления.
Репертуар операторов и их влияние:
- CREATE VIEW и DROP VIEW: управляют виртуальными представлениями, которые пересчитываются на запрос.
- CREATE MATERIALIZED VIEW и REFRESH MATERIALIZED VIEW: создают и поддерживают кэшированную копию подзапроса, требуют явного обновления.
- EXPLAIN и EXPLAIN VERBOSE: позволяют понять, как DuckDB планирует использование представления в конкретном запросе, и оценить, будут ли применяться MV-данные или пересчитать запрос заново.
-- Пример обычного представления
## CREATE VIEW high_value_customers AS
SELECT customer_id, SUM(amount) AS total_spent
FROM sales
GROUP BY customer_id;

-- Пример обращения к обычному представлению
SELECT * FROM high_value_customers WHERE total_spent > 10000;

-- Пример материализованного представления
## CREATE MATERIALIZED VIEW mv_top_products AS
SELECT product_id, SUM(quantity) AS total_qty
FROM orders
GROUP BY product_id;

-- Обновление MV
REFRESH MATERIALIZED VIEW mv_top_products;
Ключевые различия в подходах к планированию и исполнению становятся определяющими в архитектуре аналитических пайплайнов:
- Если данные обновляются редко, а скорость запроса критична, MV может дать существенный выигрыш за счёт кэширования результатов.
- Если данные обновляются часто и требуется актуальность, лучше ограничиться обычными views или реализовать частые принудительные обновления MV по расписанию.
Выбор между views и materialized views: сценарии и принципы
Понимание того, когда использовать каждый тип представления, критично для проектирования пайплайнов и планирования нагрузки в системе. Рассмотрим типовые сценарии и соответствующие паттерны.
-
Высокая частота обновления исходников, критична свежесть данных.
- Предпочтение обычным views. Они обеспечивают актуальные данные без необходимости периодического обновления кэшированных результатов.
- В случае необходимости повышения скорости можно комбинировать с предварительной агрегацией в промежуточной таблице и использовать обычное представление поверх неё.
-
Необходимость быстрого отклика в BI и аналитике на больших объемах данных.
- Включение materialized views на ключевых агрегациях или группировках, чьи результаты часто запрашиваются.
- Важна стратегия обновления MV: например, обновление после загрузки батча данных или по расписанию, с учётом SLA по задержке.
-
Композиционные пайплайны с зависимостями и повторным использованием логики.
- Использование комбинаций views и MV: сложные вычисления могут быть вынесены в MV, а более динамические части - в обычные views.
- Необходимо внимательно управлять зависимостями, чтобы изменение базовых таблиц не повлекло непредсказуемое поведение в MV.
-
Практика мониторинга и контроля качества.
- Независимо от выбора стратегии, важно включать тесты на корректность результатов представлений, а также контроль сроков обновления MV и согласованности данных между слоями пайплайна.
- Независимо от выбора стратегии, важно включать тесты на корректность результатов представлений, а также контроль сроков обновления MV и согласованности данных между слоями пайплайна.
Создание, хранение и обновление
Практическая часть предполагает четкое структурирование работы с представлениями: именование, документация, политика обновления и тестирование. В DuckDB поддержка базовых операций схожа с другими СУБД, однако особое внимание следует уделять обновлению MV и обработке зависимостей.
-
Создание и документирование:
- Название представления должно отражать роль в пайплайне и область данных.
- В целом стоит отделять логику бизнес-агрегаций от представления конкретной бизнес-логики, чтобы повысить повторное использование.
-
Обновление:
- MATERIALIZED VIEW требует явного обновления через REFRESH MATERIALIZED VIEW mv_name.
- Частота обновления зависит от задержки, допустимой для аналитических сценариев, и от объема изменений, которые вносятся в базовые таблицы.
- В рамках ETL-процессов MV можно обновлять по окончании пакетной загрузки данных, чтобы минимизировать влияние на время отклика.
-
Управление зависимостями:
- DuckDB отслеживает зависимости между представлениями и таблицами; при изменении структуры базовых таблиц может потребоваться пересоздание зависимых MV или представлений.
- В сложных пайплайнах полезно поддерживать карту зависимостей и тестовые наборы данных, чтобы ранний обнаружить несовместимости.
-- Создание представления
CREATE VIEW monthly_sales_summary AS
SELECT
  to_char(order_date, 'YYYY-MM') AS month,
  region,
  SUM(total_amount) AS revenue,
  COUNT(*) AS orders
FROM orders
GROUP BY 1, 2;

-- Создание MV
CREATE MATERIALIZED VIEW mv_region_monthly AS
SELECT
  region,
  DATE_TRUNC('month', order_date) AS month,
  SUM(total_amount) AS revenue
FROM orders
GROUP BY 1, 2;

-- Обновление MV
REFRESH MATERIALIZED VIEW mv_region_monthly;
Рекомендации по паттернам:
-
Разделяйте логику агрегации на слои: в MV держите часть вычислений, которая устойчива к изменениям источников, а динамическую логику - в обычных представлениях.
-
Внедряйте мониторы обновления MV: регистрируйте задержку между загрузкой данных и доступностью MV, собирайте метрики времени обновления и объема перерасчета.
-
Автоматизируйте тестирование представлений: тестируйте результат MV на тестовых поднаборах данных и сравнивайте с «чистой» агрегацией, чтобы своевременно выявлять расхождения.
Планирование производительности и диагностика
Эффективное использование представлений требует осознанного подхода к планированию выполнения и мониторингу ресурсов. Основные практики:
-
Анализ плана выполнения:
- При обращении к представлениям используйте EXPLAIN, чтобы увидеть как DuckDB трактует запрос: разворачивает ли он подзапросы, применяет ли оптимизации, задействует ли MV.
- Проверяйте, применяются ли элементы ленивой или кэшированной загрузки. В случае MV план может показывать чтение из кэша или перерасчет.
-
Оценка задержек и пропускной способности:
- Измеряйте время выполнения запросов через обычные views против аналогичных запросов к MV. Разница может быть значительной на больших объемах данных.
- Учитывайте overhead обновления MV: по расписанию обновления занимают ресурсы, но после обновления запросы становятся намного быстрее.
-
Валидация данных:
- Регулярно сравнивайте результаты MV с «чистым» вычислением через обычные запросы, чтобы ловить расхождения.
- В тестовом окружении повторно выполняйте обновления MV и проверяйте консистентность итогов.
-
Оптимизация использования индексов и компрессий:
- DuckDB использует колонно-ориентированную архитектуру и эффективные схемы сжатия. В контексте MV полезно просмотреть, какие колонки используются в группировке и фильтрах, чтобы выбрать подходящие схемы хранения и ускорить вычисления.
- DuckDB использует колонно-ориентированную архитектуру и эффективные схемы сжатия. В контексте MV полезно просмотреть, какие колонки используются в группировке и фильтрах, чтобы выбрать подходящие схемы хранения и ускорить вычисления.
Интеграция с Python и аналитическими инструментами
Инженеры по данным часто используют DuckDB вместе с Python и инструментами аналитики. Представления в DuckDB легко интегрируются через официальный пакет duckdb для Python, который позволяет выполнять SQL-запросы и получать результаты в формате pandas DataFrame, NumPy массивов и т. д.
-
Подключение и выполнение запросов:
- Через Python можно подключаться к встроенному DuckDB-экземпляру и работать с теми же представлениями, что и в SQL-окружении.
- Рекомендуется держать соединение в рамках одного контекста обработки пайплайна, чтобы минимизировать накладные расходы на повторные подключения.
-
Взаимодействие с pandas:
- fetchdf() возвращает данные в виде DataFrame, что упрощает последующее подключение к визуализации, моделированию и экспорту.
- Можно напрямую передать результаты MV в модельный пайплайн, используя чтение из MV как источник данных.
-
Реальные паттерны интеграции:
- Использование MV для ускорения предиктивной аналитики: свежие данные подгружаются во фрейм, затем производится обучение или предсказание.
- В BI-потоке MV может выступать как источник данных для дашбордов, где задержка обновления допустима, но отклика должен быть быстрым.
import duckdb
import pandas as pd

## Создание соединения
con = duckdb.connect(database=':memory:')

## Использование MV через SQL
df = con.execute("SELECT region, month, revenue FROM mv_region_monthly WHERE revenue > 1e6").fetchdf()

## Интеграция с pandas
summary = df.groupby('region')['revenue'].sum().reset_index()
print(summary)
Особенности интеграции:
-
DuckDB как движок может служить как единый источник для ETL-обработки и аналитического слоя, где MV ускоряют кэшированное извлечение.
-
При больших пайплайнах стоит организовать последовательности вызовов так, чтобы обновления MV выполнялись в моменты минимальной нагрузки и после загрузки больших партий данных.
Применение, тестирование и управление в реальных проектах
-
Стандарты именования и документации:
- Введите единый стиль именования представлений: например, view_пользователь_аналитика, mv_region_monthly. Это упрощает поиск и управление зависимостями.
- Документируйте назначение каждого представления и ожидаемую частоту обновлений MV.
-
Тестирование и CI:
- Включите тестирование представлений в CI: сравнение результатов MV и соответствующих вычислений через обычные запросы на тестовых данных.
- Протестируйте сценарии обновления MV: последовательность загрузки данных, вызов REFRESH MATERIALIZED VIEW и повторная проверка согласованности.
-
Паттерны развёртывания:
- Разделяйте окружения: тестовое, стейджинг и продакшн. MV могут иметь разные политики обновления в зависимости от среды.
- Включайте мониторинг задержек обновления MV и работу по их коррекции в процессе эксплуатации.
-
Ограничения и риски:
- MV не избегают затрат на первичную сборку и последующее обновление, особенно на больших объемах данных. Необходимо планировать расписание обновления так, чтобы не блокировать критично важные запросы.
- В некоторых сценариях вложенные MV или сложные цепочки зависимостей могут приводить к повышенной сложности плана выполнения и необходимостью дополнительной диагностики.
Интеллектуальные примечания и архитектурные выводы
- Выбор между views и MV - это не только вопрос скорости, но и управляемости пайплайнами и согласованности данных. В динамичных системах без задержек актуальности чаще выбирают обычные views; там, где задержка допустима и выигрыша в скорости достаточно - MV оправдают себя.
- Архитектура DuckDB обеспечивает прозрачное разворачивание логики представлений в план выполнения. Это упрощает отладку и мониторинг, потому что разработчик видит, как именно разворачивается запрос и откуда приходят данные.
- Интеграция с Python позволяет гибко сочетать быстрый доступ к материализованным данным и сложную логику обработки через код на Python, сохраняя преимущества DuckDB как аналитической базы данных.
Key takeaways
- Views обеспечивают актуальные данные без явного обновления, Materialized views ускоряют повторные запросы за счет кэширования, но требуют периодического REFRESH.
- DuckDB строит граф зависимостей между представлениями и таблицами, что обеспечивает корректное обновление и согласованность результатов.
- Выбор механизма зависит от частоты обновления исходников, SLA по задержке и требований к производительности.
- Планирование производительности и диагностика требуют использования EXPLAIN и мониторинга времени обновления MV.
- Интеграция с Python упрощает доступ к результатам MV и их использование в аналитических и ML-пайплайнах.
- Практическая дисциплина: документирование, тестирование и CI-подходы критичны для устойчивого использования представлений в реальных проектах.
- Паттерны: разделение бизнес-логики между MV и обычными представлениями, автоматизация обновления и мониторинг качества данных.
FAQ
- Что такое обычные представления и чем они отличаются от MV?
- Обычные представления (views) - это динамические абстракции над запросами. Каждый вызов запроса к view пересчитывает результат на основании текущих данных. MV же сохраняют результат подзапроса и требуют явного обновления через REFRESH для поддержания актуальности.
- Когда стоит использовать MV, а когда - обычные views?**
- MV целесообразны, когда есть часто запрашиваемые агрегации или фильтрованные наборы данных, и задержки обновления допустимы в рамках SLA. Обычные views подходят для часто обновляющихся источников, где требуется мгновенная актуальность.
- Как DuckDB обрабатывает зависимость MV от базовых таблиц?
- DuckDB строит граф зависимостей и знает, какие MV зависят от каких таблиц. После изменений в базовых данных нужно выполнить REFRESH MV, чтобы обновить кэшированные результаты и синхронизировать их с источниками.
- Какие ограничения существуют для MV в DuckDB?
- MV требует явного обновления, и частота обновления влияет на время отклика запросов. Сложные цепочки зависимостей могут увеличить сложность планирования. Непродвинутые сценарии обновления могут привести к временным расхождениям между MV и исходными данными.
- Какую роль играет EXPLAIN в работе с представлениями?
- EXPLAIN позволяет увидеть, как DuckDB планирует использование представления: разворачивает ли логика view в подзапрос и применяет ли оптимизации. Это помогает понять, будет ли MV использоваться читающим запросом или пересчитываться.
- Как начать работу с представлениями в DuckDB через Python?
- Через пакет duckdb можно подключаться к локальному или удаленному экземпляру DuckDB, выполнять CREATE VIEW / CREATE MATERIALIZED VIEW, REFRESH MV и затем fetchdf() для передачи результатов в pandas-рабочий процесс. Это упрощает интеграцию в ETL и ML пайплайны.
- Какие практики стоит внедрить в команду для управления представлениями?
- Внедрять единый стиль именования и документации, тестирование представлений в CI, мониторинг задержек обновления MV и согласованности данных. Включать паттерны для разделения логики между MV и обычными views и планировать обновление MV в окна минимизации нагрузки.
- Можно ли использовать MV для многопользовательской среды и больших параллельных нагрузок?
- В большинстве случаев MV поддерживает параллельную обработку запросов и читается из кэша. Однако при интенсивном обновлении источников может потребоваться продуманная стратегия обновления и мониторинг, чтобы избежать конфликтов и задержек в разных потоках.
- Что делать, если MV перестал давать выигрыш в производительности?
- Необходимо проверить актуальность данных, порядок обновления MV, наличие лишних зависимостей, а также внимательно сравнить план выполнения запросов с и без MV. Возможно потребуется переработать логику представления или скорректировать стратегию обновления.
- Какие лучшие практики по тестированию представлений?
- Сравнивайте результаты MV с «чистыми» вычислениями на тестовых данных, регистрируйте время обновления и тестируйте сценарии с одновременным обновлением источников. Включайте регрессионное тестирование на каждый релиз изменений в схемах или логике пайплайна.


