

DuckDB для Data Engineer
Этот курс показывает, как использовать DuckDB в роли инструмента для построения аналитических пайплайнов и обработки больших объёмов данных. Он раскрывает подходы к интеграции DuckDB в data stack — от локальных ETL-задач до работы с Data Lake и промежуточными слоями обработки.
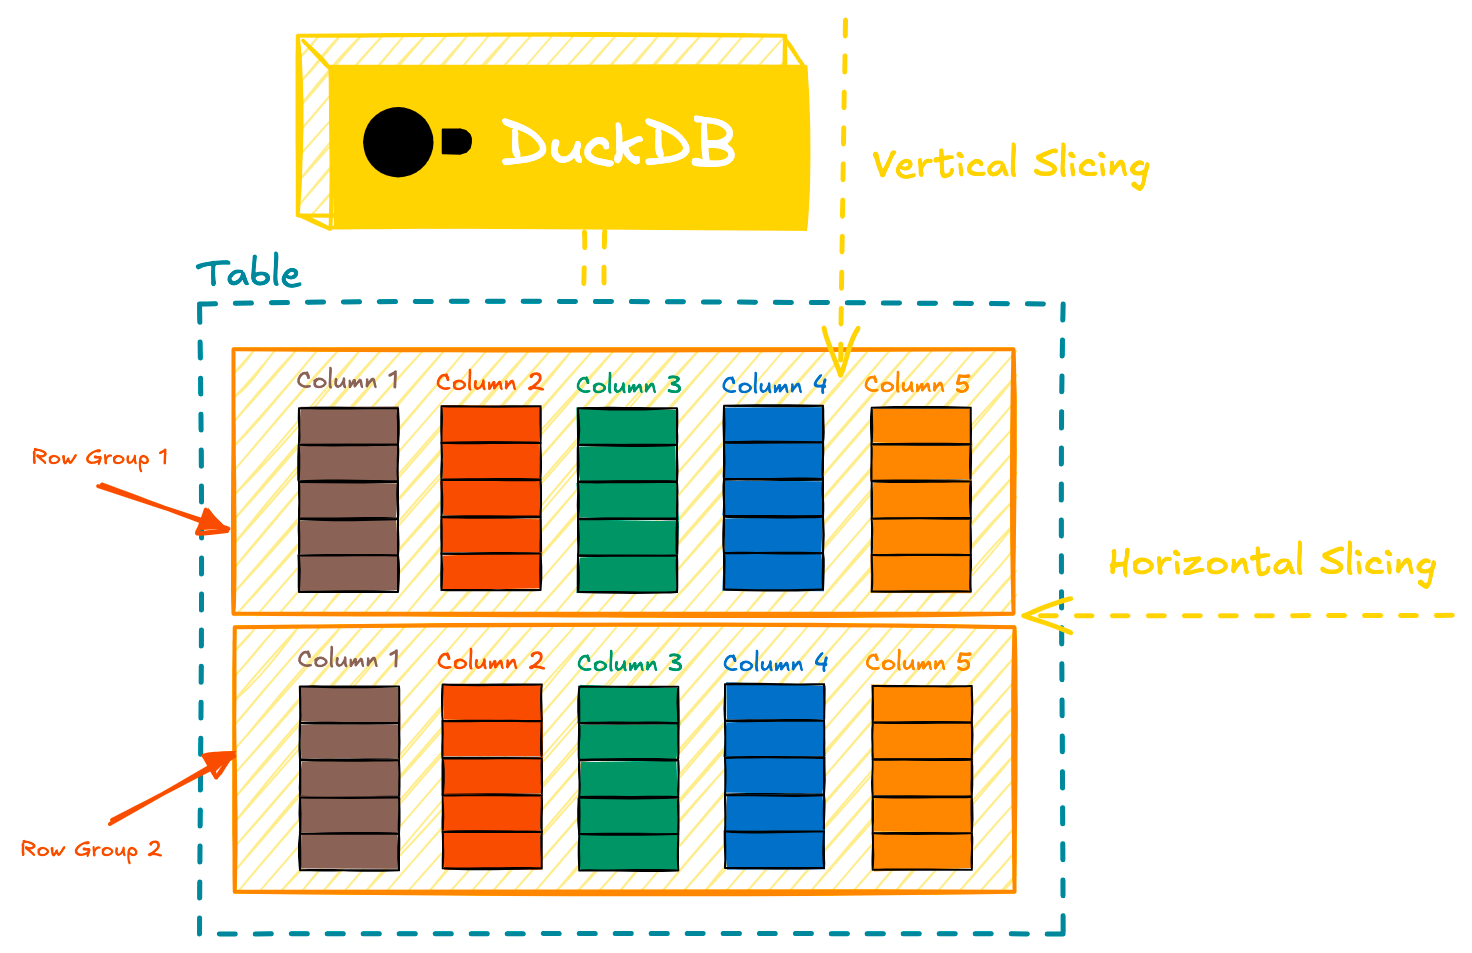
Внутри курса — архитектура движка, работа с Parquet и Arrow, интеграции с Python и BI-инструментами, а также оптимизация SQL и управление ресурсами. Особый акцент сделан на производительности и использовании DuckDB как быстрого аналитического слоя.
В результате вы сможете применять DuckDB как универсальный инструмент для data engineering задач — от прототипирования до production-пайплайнов.
- DuckDB: концепция, роль и ценности для корпоративной аналитики
- Термины и базовые понятия DuckDB
- Архитектура DuckDB: ядро, планировщик и движок выполнения
- Хранение данных и модель колонночной организации
- Форматы данных и источники: Parquet, CSV, JSON, Arrow
- Типы данных, схемы и метаданные в DuckDB
- Векторизованный движок, исполнение и кодогенерация
- Транзакции и консистентность: ACID и MVCC
- Параллелизм, планирование ресурсов и масштабируемость
- Расширения и расширяемость: UDF, агрегаты, GIS
- Интеграции с Python: duckdb-py, обмен DataFrames
- Интеграции с Pandas и NumPy: конвертация и производительность
- Интеграции через Apache Arrow: совместное использование памяти
- Интеграции с R и другими языками данных
- Интеграции с BI и инструментами SQL: ODBC, JDBC и драйверы
- Интеграции в конвейеры данных: ETL, ELT, инкрементальная загрузка
- Архитектурные паттерны: встроенный аналитический движок и сервисная роль
- Архитектура пайплайнов: DuckDB в data lake, data warehouse и промежуточные слои
- Управление представлениями: views и materialized views в DuckDB
- Управление качеством данных: проверки, валидация и тесты
- Оптимизация запросов: сбор статистики, ANALYZE, план выполнения
- Работа с большими данными: партиционирование, внешние таблицы и разделение данных
- Мониторинг, профилирование и операционная observability в DuckDB-пайплайнах
- Безопасность и соответствие: доступ, аудит и безопасное взаимодействие с файловой системой
- Риски, ограничения и типичные ошибки при внедрении DuckDB в Data Engineer пайплайны
- Практические кейсы: аналитика пайплайнов на DuckDB в реальных индустриях
- Миграции и эволюция инфраструктуры: планы перехода и миграционные стратегии
- Масштабирование и зрелость архитектуры: этапы роста DuckDB-подхода
- Этапы внедрения: MVP, развёртывание и устойчивое обслуживание
- Будущее DuckDB: направления развития и новые возможности


