

Оптимизация запросов: сбор статистики, ANALYZE, план выполнения
Современные аналитические пайплайны требуют предсказуемо высокого качества планирования выполнения запросов, особенно на больших датасетах. В DuckDB ключевым инструментом является сбор статистики и последующая экономика выполнения через планировщик, который опирается на эти данные. Глава рассматривает архитектуру статистики и планировщика DuckDB, механизмы сбора статистики, синтаксис ANALYZE, чтение планов выполнения через EXPLAIN и EXPLAIN ANALYZE, а также практические методики внедрения в репроекты и интеграцию с Python и аналитическими инструментами.
Стратегическое значение статистики состоит в том, что она позволяет планировщику DuckDB оценивать стоимость операторов и выбирать оптимальные стратегии выполнения запросов. При больших датасетах даже незначительные изменения в распределении значений могут приводить к заметному ухудшению планов, если эти изменения не отражаются в статистике. В этой главе предложен системный подход: от архитектурного понимания до операционных практик в ETL и встраивании в пайплайны, где сбор статистики становится обычной частью цикла обновления данных.
- В этой главе акцент делается на архитектуре, алгоритмах и интеграциях: как устроена статистика, как работает планировщик, какие данные собираются, какие параметры контролируют сбор, и как это использовать на практике в рамках Python-интеграций и аналитических инструментов.
- В качестве примеров приводятся только те решения и команды, которые действительно помогают управлять производительностью. В тексте избегаются чрезмерные списки и ограничиваются теми инструментами, которые реально улучшают качество планирования.
Краткое содержание главы
- Архитектура статистики и планировщика DuckDB: как данные о распределении пользователей и дат, таблиц и столбцов попадают в модель стоимости и влияют на выбор планов.
- Механизм сбора статистики: что собирается, как обновляются данные и как это отражается на точности оценки стоимости операций.
- Команда ANALYZE: синтаксис и принципы параллельной сборки статистики, влияние на оптимизатор и режимы обновления статистик.
- Анализ плана выполнения: как интерпретировать EXPLAIN и EXPLAIN ANALYZE, как выявлять узкие места и проверять эффект изменений.
- Практические подходы к сбору статистики в больших данных: частота обновления, частичная аналитика по частям датасета, работа с внешними источниками.
- Интеграция с Python и аналитическими инструментами: как встроить сбор статистики в ETL, как использовать планы в ноутбуках и сервисах.
- Оптимизация пайплайнов: стратегии внедрения, контроль качества статистики, мониторинг и автоматизация.
Архитектура статистики и планировщика DuckDB
DuckDB реализует полнофункциональную систему планирования и исполнения, в составе которой статистика столбцов служит основным источником информации для_COST-ориентированного анализа запросов. Центральные элементы включают:
- каталог статистики, содержащий агрегированные сведения о столбцах, такие как количество ненулевых значений, кардинальность, доля NULL, а также гистограммы или приблизительные распределения для числовых типов;
- оптимизатор на основе стоимости (cost-based optimizer, CBO), который использует собранные статистики для оценки планов и выбора порядка соединений, применения фильтров и методов доступа;
- генератор плана и исполнительный движок с векторизованной обработкой данных, где оценки стоимости напрямую влияют на выбор конкретных операторов и стратегий выполнения;
- модуль обновления статистики, который отвечает за вызов ANALYZE и обновление соответствующих структур данных;
- инфраструктура мониторинга планов: EXPLAIN и EXPLAIN ANALYZE позволяют увидеть как план оценивается и как он реально выполнялся.
Эта архитектура диктует общую методологию: чем точнее и свежее статистики, тем более качественный план может выбрать оптимизатор. При больших датасетах особенно важно понимать, какие данные попадают в статистику и как она обновляется в контексте непрерывной загрузки данных и частых изменений в распределении значений.
С точки зрения архитектуры происходит взаимодействие между этапами: входной SQL-процессор парсит запрос, анализатор строит логическое распределение операций, планировщик начинает конструировать физический план на основе статистики, а исполнительный движок запускает план векторизованно на ленточном или столбчатом формате. Важной частью является разделение ответственности: статистики собираются отдельно и обновляются как часть ETL-процесса, а планировщик обращается к ним без необходимости повторного сканирования всех данных.
Механизм сбора статистики: что собирается и зачем
Статистика в DuckDB призвана давать оценку стоимости выполнения операций и помогать планировщику принимать решения, особенно в условиях фильтрации, агрегаций и соединений. Основные типы статистики включают:
- базовые кардинальности и уникальности для столбцов: количество разных значений и доля NULL, что влияет на выбор стратегий фильтрации и джойнов;
- минимальные и максимальные значения, диапазоны, которые помогают оптимизатору отсеивать диапазоны данных на ранних этапах;
- гистограммы распределения значений по столбцам, особенно для числовых и временных типов; они улучшают оценки selectivity фильтров и предикатов;
- статистики распределения несмешанных типов, например для строковых столбцов: распределение длин строк и частотность повторяющихся префиксов;
- оценка NDV (число различных значений) и распределение по диапазонам, что особенно полезно для планирования группировок и агрегатных операций.
Очень важно помнить: статистика - приближенная и зависит от стратегии сбора, объема выборки и геометрии данных. В DuckDB сбор статистики может происходить для всей таблицы или частично, включая внешний источник (Parquet, CSV, другие источники) посредством сквозной интеграции. Для больших датасетов целесообразна гибридная стратегия: обновление статистики локально на разделах (если данные разделены по дате или другим признакам), а обобщенная статистика поддерживается для глобальных планов. Это позволяет снизить стоимость повторной аналитики и снизить накладные расходы на обновление статистики.
Поддержка точности и производительности достигается за счет умелого использования стратегии выборки: сбор статистики может осуществляться на подвыборке данных или в рамках инкрементного обновления статистик после загрузки новых партий. В практических пайплайнах рекомендуется сочетать полную статистику после крупных загрузок и локальные обновления между ними, чтобы не допускать устаревания планов.
Команда ANALYZE: синтаксис, параллелизм и влияние на оптимизатор
ANALYZE - ключевая команда для поддержания актуальности статистики. В DuckDB ANALYZE выполняет сканирование данных и вычисляет обновленные статистики для столбцов. В контексте больших датасетов целесообразно рассмотреть параллельную природу анализа и влияние на планировщик.
- Общий подход: запускается сканирование данных с подсчетом статистик и записью их в системный каталог. Затем оптимизатор начинает использовать эти обновления при формировании планов.
- Параллелизм: анализ может выполняться параллельно по частям датасета или по нескольким таблицам параллельно, что существенно снижает время обновления статистики и позволяет поддерживать планировщик в актуальном состоянии в условиях частых изменений данных.
- Индивидуальные и глобальные обновления: в зависимости от объема данных можно обновлять статистику всей таблицы целиком или фрагментами, если поддерживается такая функциональность. Для внешних источников статистика может формироваться на основе сборок данных в момент подключения.
Синтаксис ANALYZE в DuckDB чаще всего предполагает простые варианты, например:
ANALYZE;
## ANALYZE orders;
ANALYZE orders (order_date, customer_id);
Важно: конкретный синтаксис и возможности по выборочным столбцам могут зависеть от версии DuckDB и режима работы. В практике рекомендуется использовать ANALYZE после существенных загрузок данных или изменений в распределении значений, а также в рамках расписания ETL-процессов.
Ниже приводятся принципы при работе с ANALYZE в реальной среде:
- Частота обновления: для активной таблицы с частыми изменениями целесообразны частые обновления статистики, но с учетом затрат на сканирование. Встраивание ANALYZE в ETL-пайплайн после загрузки партии данных часто оправдано.
- Выборочные обновления: если поддерживается, обновление статистики по критическим столбцам, которые существенно влияют на план выполнения, может дать существенный выигрыш при минимальном расходе ресурсов.
- Влияние на планировщик: после обновления статистики планировщик может пересчитать планы для последующих запросов, что может повлечь резкое улучшение качества планов и сокращение времени выполнения.
- Мониторинг эффективности: внедрите контрольные точки, где сравниваются планы до и после ANALYZE. Это позволяет оценивать влияние обновлений на реальную производительность и своевременно корректировать частоту обновления.
Ключевой момент: ANALYZE не изменяет данные; он обновляет статистику, которая используется планировщиком. Эффект от обновления оценивается не мгновенно на каждом запросе, а через повторную генерацию планов, которые учитывают новые статистики.
-- Примерный сценарий в пайплайне
-- после загрузки новой пачки данных
ANALYZE;
-- затем запуск сложного запроса с фильтром
SELECT ...
В дополнение к простым примерам можно применить инструментальные подходы для проверки влияния на планы:
EXPLAIN SELECT COUNT(*) FROM orders WHERE order_date >= '2024-01-01';
EXPLAIN ANALYZE SELECT COUNT(*) FROM orders WHERE order_date >= '2024-01-01';
Различие между двумя командами показывает, как планировщик оценивает стоимость до выполнения и как фактически выполнялся план в рамках текущей статистики. Результаты EXPLAIN ANALYZE позволяют непосредственно увидеть, где именно возникают дорогостоящие операции и насколько эффективно применяется фильтрация и агрегации.
Анализ плана выполнения: EXPLAIN и EXPLAIN ANALYZE
Понимание плана выполнения - критически важный навык для инженера данных. EXPLAIN позволяет увидеть логическую и физическую структуру плана, включая типы операторов, порядок их выполнения и предполагаемую стоимость. EXPLAIN ANALYZE добавляет в этот контекст реальные статистические данные об исполнении: количество обработанных строк, фактические затраты времени и ресурсное использование.
Ключевые аспекты чтения плана:
- Типы операторов: сканирование таблицы или внешнего источника, фильтрация, проекция, агрегация, сортировка, соединение. Их сочетание и порядок расскажут, как DuckDB реализует запрос.
- Оценка selectivity: насколько предположение о selectivity предиката совпало с реальностью. Значимое расхождение может означать устаревшую статистику или необходимость перераспределения данных.
- Косты и время: в EXPLAIN ANALYZE можно увидеть, какие операторы занимали большую часть времени. Это подскажет, где фокусировать усилия по оптимизации.
- Партирование и параллелизм: если план показывает параллельное выполнение, это знак того, что DuckDB применяет многоядерную обработку; при проблемах с узкими местами можно рассмотреть настройку параллелизма и ресурсов.
Пример использования:
EXPLAIN SELECT COUNT(*) FROM orders WHERE order_date >= '2024-01-01';
EXPLAIN ANALYZE SELECT COUNT(*) FROM orders WHERE order_date >= '2024-01-01';
Рассмотрим характеристики двух режимов:
- EXPLAIN: обеспечивает статическую картину того, как план планируется выполнить. Это полезно для построения общего понимания архитектуры запроса.
- EXPLAIN ANALYZE: возвращает реальные данные о выполнении, включая количество прочитанных строк и реальное время выполнения. Это основной инструмент для диагностики производительности и проверки корректности предположений плана.
Лучшие практики по работе с EXPLAIN:
- Регулярно сравнивайте планы до и после обновления статистики. Это позволяет оценивать влияние ANALYZE на качество планирования.
- Используйте EXPLAIN ANALYZE как часть регрессионного тестирования производительности в ETL-проектах.
- В репозитории кода и ноутбуках сохраняйте образцы планов для типовых запросов, чтобы быстро идентифицировать регрессии после изменений в данных или конфигурации.
Практические подходы к сбору статистики в больших данных
Большие датасеты требуют стратегического подхода к сбору статистики, чтобы обеспечить баланс между точностью оценок и затратами на сканирование. Ниже приведены практики, которые проверены в реальных проектах.
- Планируйте регулярность обновления статистики в зависимости от скорости лояльных изменений распределения языков данных. При бурном росте данных целесообразна более частая перерасчет статистики, в то время как в стабильных системах можно ограничиться инкрементным обновлением после ключевых загрузок.
- Используйте частичное и целевое обновление статистики для столбцов, которые наиболее влияют на запросы. Это достигается путем фокусирования на критических столбцах или на столбцах с высоким влиянием на фильтрацию и джойны.
- Интегрируйте ANALYZE в ETL-пайплайн: после загрузки новой пачки данных запускайте ANALYZE, чтобы подготовить планировщик к ожидаемым паттернам запросов. Это позволяет избежать запасных затрат на перерасчет в момент пикового использования.
- Стратегия разделов и внешних источников: если данные разделены по дате или другим критериям, логично собирать статистику по каждому разделу отдельно или поддерживать «локальную» статистику для крупных разделов. Для Parquet и других внешних форматов DuckDB может использовать инкрементальный подход к статистике, обслуживая запросы и обновления по требованию.
- Валидация статистики через план исполнения: после обновления статистикой полезно запускать EXPLAIN ANALYZE на типичных запросах и сравнивать планы до и после обновления. Это позволяет оперативно подтверждать, что обновления действительно улучшают планирование.
- Мониторинг и аудит: регистрируйте изменения статистики и их влияние на планы и время выполнения. В условиях производства это помогает в последующей отладки и оптимизации пайплайнов.
Интеграция с Python и аналитическими инструментами
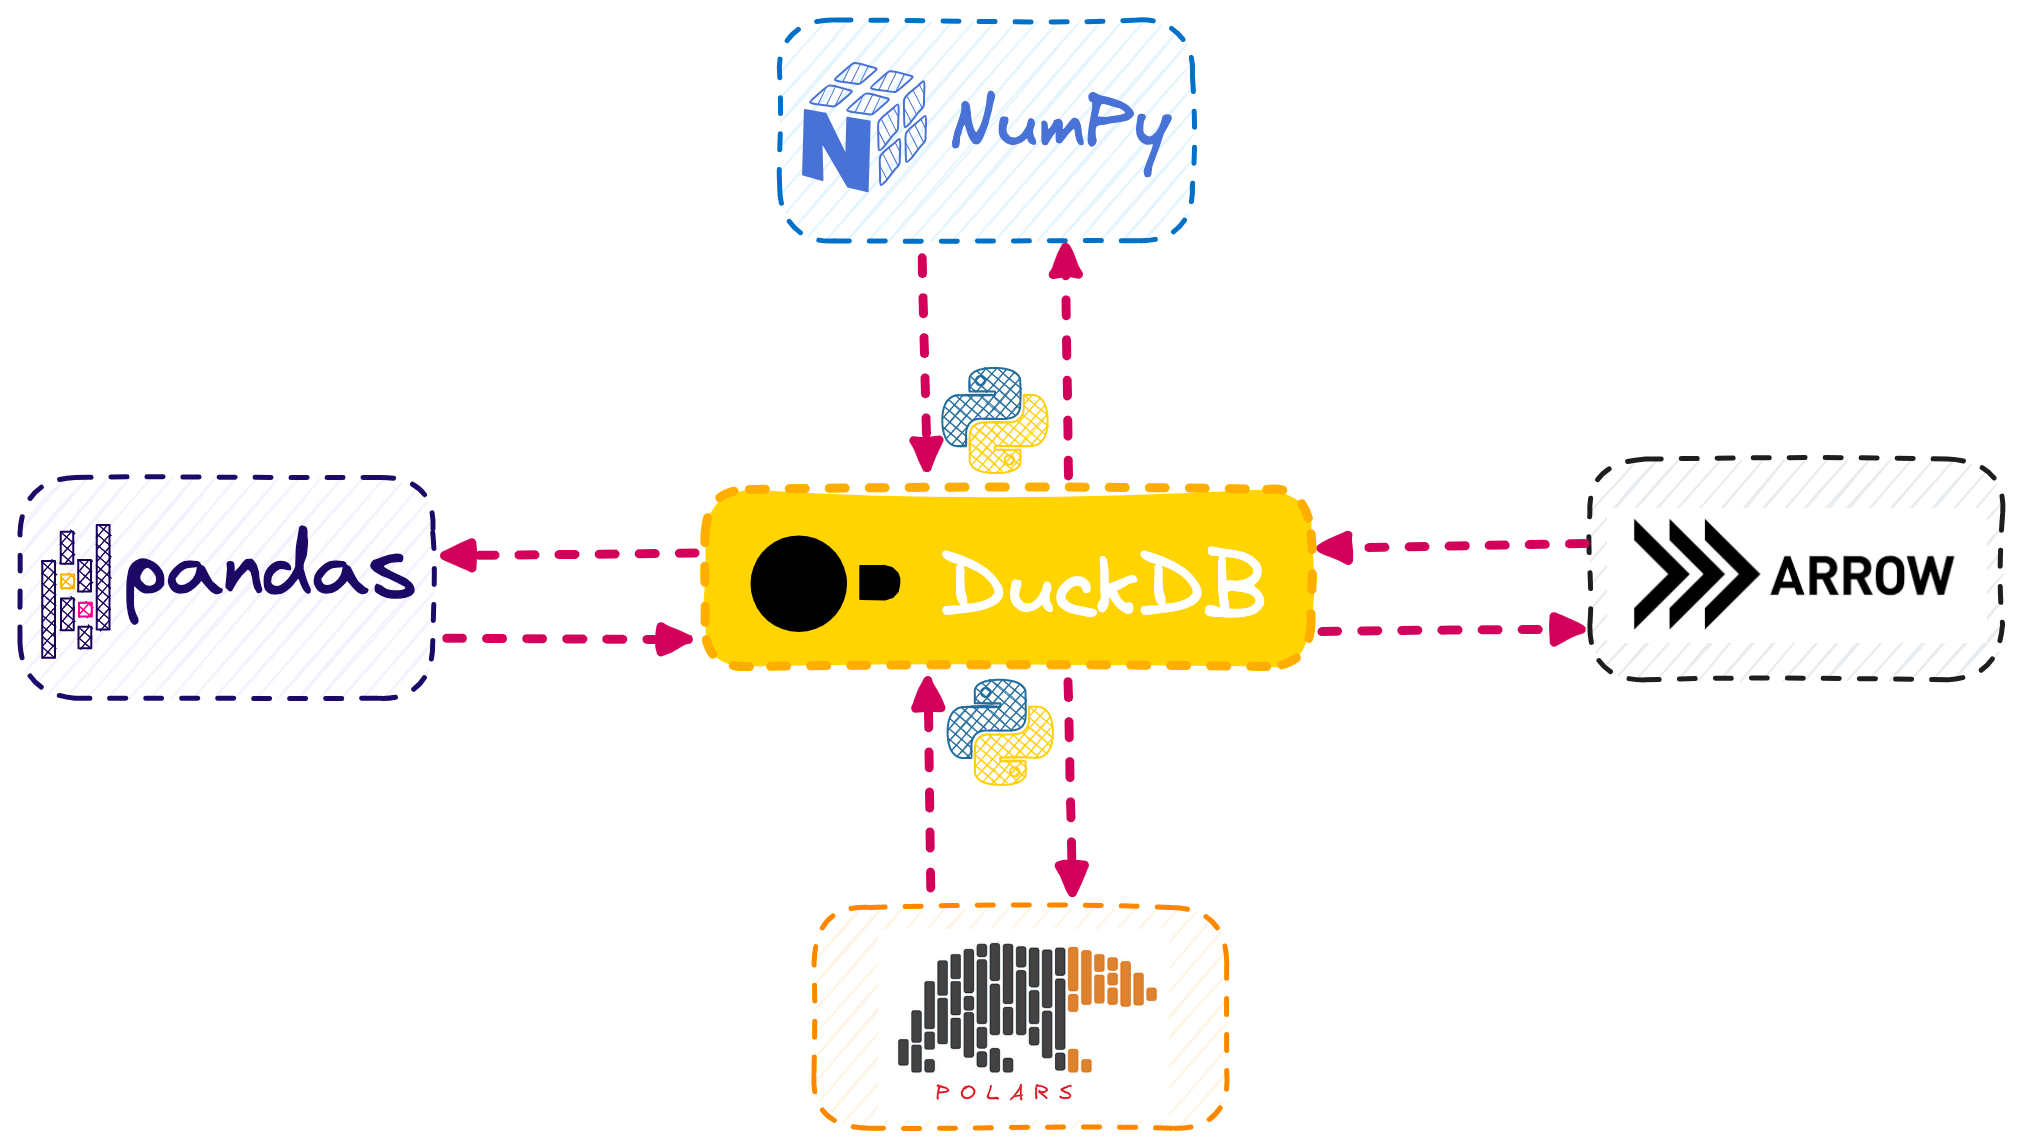
Интеграция DuckDB с Python и другими аналитическими инструментами делает процесс оптимизации неотъемлемой частью пайплайнов. В сценариях, где данные обновляются и затем запрашиваются аналитическими инструментами, важно автоматизировать сбор статистики и анализ планов.
- Python API DuckDB позволяет вызывать ANALYZE в рамках скриптов ETL и ноутбуков. Это упрощает автоматизацию и обеспечивает, что статистика поддерживается на актуальном уровне.
- Распространенная практика: после загрузки партии данных выполняется ANALYZE, затем выполняются тестовые запросы с EXPLAIN ANALYZE для проверки качества планов, и итоговые запросы запускаются на продуктивной фазе.
- Для интеграции с Pandas и другими инструментами целесообразно экспортировать результаты анализа плана в удобный формат и сверять с базовыми эталонами по времени выполнения.
Пример кода на Python (используя DuckDB Python API):
import duckdb

## Установка соединения
con = duckdb.connect()

## Пример загрузки данных
con.execute("CREATE TABLE IF NOT EXISTS orders (order_id INTEGER, customer_id INTEGER, order_date DATE, amount DECIMAL(10,2));")

## Обновление статистики для всех таблиц
con.execute("ANALYZE;")

## Разбор плана выполнения с использованием EXPLAIN ANALYZE
plan_text = con.execute("EXPLAIN ANALYZE SELECT COUNT(*) FROM orders WHERE order_date >= DATE '2024-01-01';").fetchall()
print(plan_text)

## Выполнение реального запроса
result = con.execute("SELECT COUNT(*) FROM orders WHERE order_date >= DATE '2024-01-01';").fetchdf()
print(result)
Дополнительно можно рассмотреть сценарии интеграции с ноутбуками, где часто обновляются источники данных и требуется оперативно проверять влияние изменений на план выполнения.
- В связке с Jupyter/Databricks можно автоматизировать сбор статистики, логировать планы и результаты EXPLAIN ANALYZE в отдельных таблицах для аудита и регрессии.
- С использованием инструментов визуализации можно строить дашборды по метрикам планирования: доля времени, проведенная на сканирование, эффективность фильтрации, среднее число прочитанных строк на операцию и т. п.
Оптимизация пайплайнов: стратегии и кейсы
На практике ключевые задачи - поддерживать актуальные планы выполнения при больших объемах данных и частой загрузке новых данных. Ниже приведены типовые кейсы и решения.
Кейс 1: Большая факт-таблица с диапазонной фильтрацией по дате
- Проблема: запросы часто фильтруются по дате и требуют точной оценки selectivity.
- Решение: после загрузки партий данных выполняйте ANALYZE на соответствующих столбцах, возможно, с учётом локальных разделов. Затем проверяйте EXPLAIN ANALYZE на типичных запросах и корректируйте план.
- Результат: улучшение точности оценок selectivity, уменьшение времени выполнения за счет более эффективного выбора операторов и сортировок.
Кейс 2: Соединения между факт-таблицами и измерениями
- Проблема: джойн-стоимость часто зависит от кардинальности ключей и распределения значений.
- Решение: собирать статистику для ключевых столбцов, где джойн чаще всего выполняется, и периодически обновлять статистику после обновления данных. Это позволяет планировщику выбрать оптимальный порядок соединений и типы джойнов.
- Результат: сокращение числа строк, проходящих через дорогостоящие этапы, и более предсказуемые времена выполнения.
Кейс 3: Внешние источники данных (Parquet)
- Проблема: данные могут быть объемными и распределены по файлам; статистика требуется для эффективной фильтрации и чтения.
- Решение: DuckDB может использовать встроенные статистики по столбцам, получаемые во время анализа партиций. Для больших наборов данных можно проводить эффективное сканирование по разделам и обновлять статистику по ключевым столбцам.
- Результат: уменьшение объема чтения и ускорение фильтрации на раннем этапе выполнения.
Кейс 4: Инкрементальная аналитика и большой поток данных
- Проблема: полный пересчет статистик после каждого изменения недоступен.
- Решение: настройка инкрементной аналитики по разделам, планирование периоду обновления и использование целевых обновлений статистики для наиболее влиятельных столбцов.
- Результат: баланс между точностью планирования и стоимостью обновления статистики.
Кейс 5: Мониторинг и регрессионный тест
- Проблема: план может постепенно деградировать без явной ошибки.
- Решение: сохранять образцы планов для типичных запросов и сравнивать их с предыдущими версиями. Регулярно выполнять EXPLAIN ANALYZE и фиксировать различия во времени выполнения.
- Результат: раннее выявление регресий и оперативное возвращение к эффективным конфигурациям.
Key takeaways
- Статистика в DuckDB является критическим элементом планирования; обновление статистики напрямую влияет на выбор плана выполнения.
- ANALYZE - не модификация данных, а обновление статистик, которые используются оптимизатором для оценки стоимости операций.
- EXPLAIN и EXPLAIN ANALYZE являются основными инструментами диагностики производительности и позволяют отличать теоретическую оценку стоимости от фактического выполнения.
- Практические стратегии по сбору статистики включают частичное и инкрементальное обновление, планирование обновлений после загрузки данных и интеграцию ANALYZE в ETL-процессы.
- Интеграция с Python позволяет автоматизировать сбор статистики, анализ планов и регрессионное тестирование в ноутбуках и пайплайнах.
- В больших пайплайнах полезно сочетать глобальные обновления статистики и локальные обновления по разделам, а также проверять влияние изменений через EXPLAIN ANALYZE на типичных запросах.
- Постоянное наблюдение за планами и временем выполнения - залог устойчивой производительности: хранение образцов планов, сравнение планов до/после обновления статистики, мониторинг эффективности фильтрации и джойн.
FAQ
- Что такое ANALYZE в DuckDB и зачем он нужен?
ANALYZE обновляет статистику столбцов и таблиц, которые используются планировщиком для оценки стоимости выполнения запросов. Без актуальной статистики план может быть неоптимальным, что приводит к более долгим временам выполнения. Аналогия: статистика - это карта распределения данных, по которой планировщик прокладывает маршрут.
- Как понять, что статистика устарела и требует обновления?
Если данные после загрузки существенно изменились или распределение значений в столбцах изменилось (например, появились новые диапазоны дат, резко возросла доля NULL), следует выполнить ANALYZE. Мониторинг эффективности запросов и чтение EXPLAIN ANALYZE помогут выявить, что план стал менее эффективен по сравнению с ранее зафиксированными образцами.
- Какой синтаксис ANALYZE в DuckDB использовать в реальной среде?
Общий подход: запуск ANALYZE после загрузки данных. В некоторых версиях доступны формы: ANALYZE; ANALYZE table; ANALYZE table (columns) в зависимости от версии. Всегда обращайте внимание на документацию версии DuckDB, которую вы используете, чтобы подобрать корректный синтаксис и опции.
- Как EXPLAIN и EXPLAIN ANALYZE помогают в оптимизации?
EXPLAIN показывает план на бумаге, а EXPLAIN ANALYZE показывает фактическое исполнение, включая время и количество обработанных строк. Используйте их, чтобы выявлять узкие места и проверять влияние обновления статистики на планы.
- Какие практики применяются для больших датасетов?
Рекомендуется инкрементальная и частичная аналитика по критическим разделам или столбцам, а также регулярное обновление статистики после крупных загрузок. Для внешних источников полезно анализировать данные по разделам и использовать скрипты ETL, чтобы запускать ANALYZE в разумные окна.
- Как автоматизировать сбор статистики в Python-пайплайне?
Используйте DuckDB Python API: выполнять ANALYZE после загрузки данных, затем запускать EXPLAIN ANALYZE для проверки планов и, при необходимости, выполнять сам запрос. Автоматизируйте эти шаги в рамках ETL-скриптов или ноутбуков.
- Как читать планы выполнения эффективнее?
Chose EXPLAIN ANALYZE и внимательно изучите время на каждом операторе, количество обработанных строк и распределение затрат. Ищите узкие места в фильтрации и соединениях, а затем аргументируйте повторное выполнение с обновленной статистикой или изменениями в запросе.
- Какие рекомендации по интеграции с внешними источниками?
Для Parquet и других внешних форматов важно обновлять статистику по ключевым столбцам, которые участвуют в фильтрации и соединениях. DuckDB может читать статистику по столбцам без необходимости полного сканирования данных в каждый раз, что снижает расходы на сбор статистики.
- Как сочетать обновление статистики и производительность пайплайна?
Идея состоит в балансировании: обновляйте статистику после крупных загрузок, а между ними применяйте частичные обновления статистики для наиболее влиятельных столбцов. Это позволяет поддерживать разумную точность планов без чрезмерной стоимости обновления.
- Какие типичные ошибки возникают при работе со статистикой?
- Обновление статистики слишком редко и получение устаревших планов.
- Игнорирование влияния статистики на фильтрацию и джойн-выборы.
- Пренебрежение проверкой планов через EXPLAIN ANALYZE после изменений в данных.
- Неправильная интерпретация результатов EXPLAIN ANALYZE как единственно верного индикатора: распределения и контекст запроса также важны.
Эта глава охватывает ключевые концепции и практики для оптимизации запросов в DuckDB через сбор статистики, анализ планов и интеграцию в аналитические пайплайны. Применение описанных подходов позволяет Data Engineer строить устойчивые пайплайны с предсказуемой производительностью, даже при работе с огромными и постоянно изменяющимися наборами данных.


