

Практические кейсы: аналитика пайплайнов на DuckDB в реальных индустриях
DuckDB как встроенный аналитический движок стал опорой для современных пайплайнов данных в условиях ограничений по ресурсам и требований к быстрой итеративной аналитике. В реальных проектах он применяется как ядро ETL/ELT-слоя, как обработчик временных и больших наборов данных, а также как мост между Python-экосистемой, BI-инструментами и хранилищами данных. Глава посвящена практическим кейсам из разных отраслей, архитектурным решениям и паттернам внедрения, которые позволяют за минимальные издержки получить воспроизводимую аналитику на больших датасетах. В каждой истории подчеркиваются причины выбора DuckDB, архитектурные решения, подходы к качеству данных и интеграции с существующим стеком инструментов.
Прежде чем перейти к кейсам, зафиксируем базовые принципы: DuckDB работает встраиваемо в процесс исполнения, поддерживает чтение Parquet и других форматов напрямую, применяет векторизованный исполнение и эффективное управление памятью. Эти особенности определяют паттерны проектирования пайплайнов: что держать в памяти в момент расчета, какие данные «сворачивать» во временные представления, где материализовать промежуточные результаты и как выносить итоговую агрегацию в долговременное хранилище. В условиях реальных индустриальных проектов важно сочетать силу DuckDB в SQL‑аналитике с гибкостью Python‑инструментов и потребностями в управлении данными на уровне организации.
- Архитектура DuckDB в аналитических пайплайнах: паттерны взаимодействия
- Кейс 1: E-commerce** - аналитика спроса, сегментация и ценообразование
- Кейс 2: Финансы** - обработка больших журналов транзакций и риск-аналитика
- Кейс 3: Производство и IoT** - предиктивная техническая аналитика и оптимизация процессов
- Интеграции с Python и BI-инструментами
Архитектура DuckDB в аналитических пайплайнах: паттерны взаимодействия
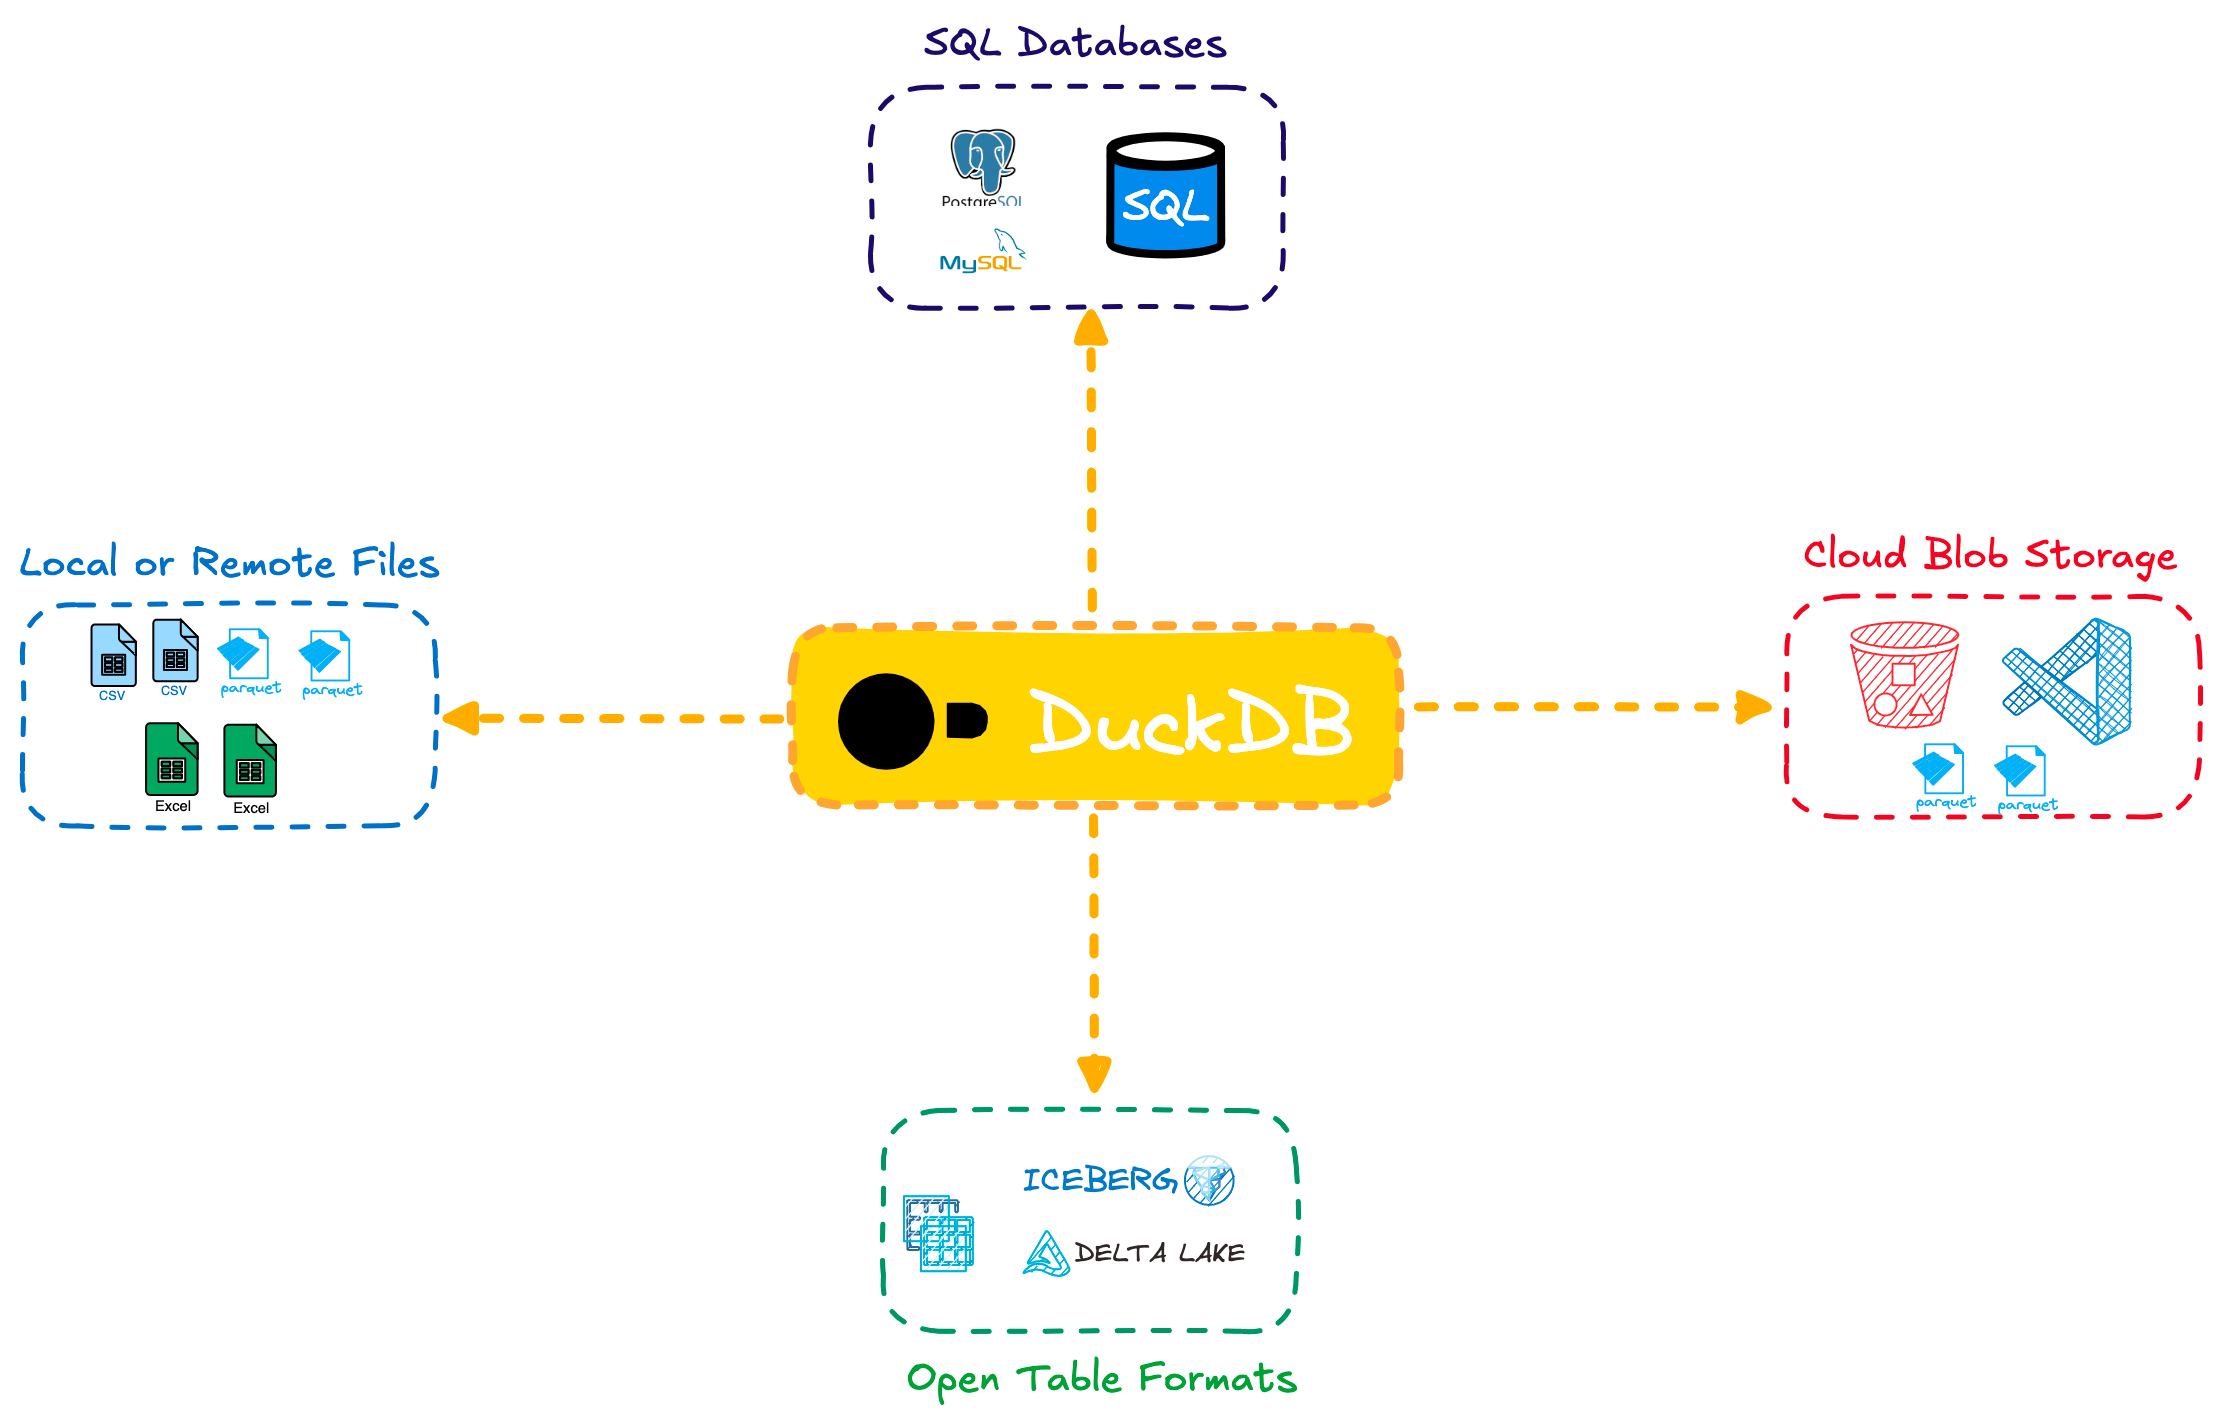
Одной из ключевых возможностей DuckDB является его встроенность в рабочий процесс анализа. Архитектура движка основана на колоннорном хранении данных и векторизованном исполнении, что обеспечивает высокую пропускную способность для больших наборов данных без необходимости разворачивать полноценный кластер. Это значит, что дата-инженеру достаточно иметь ограниченную инфраструктуру, чтобы выполнять сложные SQL-вычисления на дыхании больших файлов Parquet или CSV, не прибегая к промежуточным копиям в дорогостоящие хранилища.
Паттерны взаимодействия в пайплайнах можно условно разделить на три слоя:
- Интеграционный слой. DuckDB подключается к исходникам данных (Parquet, CSV, Arrow‑гиперфайлы, базы данных через внешние таблицы) и выполняет чтение без избыточной репликации данных. Это упрощает обработку больших датасетов непосредственно в рамках Python‑скриптов или оркестраторов.
- Трансформационный слой. В SQL задаются преобразования: фильтрации, агрегации, оконные функции, объединения. Результаты могут быть материализованы в виде временных представлений (VIEW) или материализованных представлений (MATERIALIZED VIEW) для повторного использования без повторной переработки.
- Выходной слой. Итоги сохраняются в Parquet/ORC или отправляются в BI‑инструменты через коннекторы, после чего возможно повторное загрузочное соблюдение схемы и версионирование. DuckDB поддерживает экспорт в Parquet и другие форматы, что облегчает интеграцию с ленточными хранилищами данных и аналитикой.
Важно учитывать компромиссы. DuckDB - это процесс-приложение, поэтому конкуренцию по скорости часто обеспечивает локальная память и CPU. Это делает DuckDB идеальным для интерактивной аналитики, предварительной подготовки данных и повторяемых ETL-циклов в рамках одного сервера или ноутбука. Для truly распределенного вычисления требуются дополнительные решения (например, комбинации DuckDB‑инстансов в рамках orchestration) или альтернативные технологии. В реальных пайплайнах DuckDB часто выступает как оптимизированный узел для «быстрого» слоя трансформаций, который затем выгружает результаты в долговременное хранилище или в аналитическую витрину.
- Преимущества: высокая скорость разработки, быстрая настройка окружения, поддержка Parquet/Arrow, простота встраивания в Python‑профили.
- Ограничения: ограниченная естественная горизонтальная масштабируемость без дополнительных инструментов, ограничение памяти в рамках одного процесса.
- Практические выводы: выбирайте DuckDB для этапов подготовки данных и интерактивной аналитики над данными, которые уже лежат в формате колоночного хранения; для больших потоков и реального времени рассматривайте архитектуры, где DuckDB выступает как мощный преобразователь в составе более широкой экосистемы.
Важной частью проектирования является выбор форматов хранения. Parquet позволяет DuckDB быстро сжимать и считывать данные, поддерживает схемы и столбцовую фильтрацию. В связке с Python это дает возможность быстро загружать подмножества данных в DataFrame и возвращать результаты обратно в Parquet для дальнейшего использования. В качестве примера, часто применяются следующие практики:
-
держать «сырые» данные в Data Lake в Parquet, чтобы DuckDB мог читать их без лишних преобразований;
-
использовать SQL‑уровни DuckDB для агрегаций и фильтраций, избегая лишних ETL-слоев;
-
материализовать часто повторяемые результаты в MV или в таблицы, чтобы ускорить повторные запуски.
import duckdb
con = duckdb.connect()

## Загрузка исходных данных
con.execute("CREATE TABLE orders AS SELECT * FROM read_parquet('data/orders.parquet')")
con.execute("CREATE TABLE items AS SELECT * FROM read_parquet('data/order_items.parquet')")
con.execute("CREATE TABLE products AS SELECT * FROM read_parquet('data/products.parquet')")

## Пример агрегации и материализации
con.execute("""
## CREATE MATERIALIZED VIEW daily_sales AS
SELECT o.order_date, p.category, SUM(oi.quantity) AS total_units,
       SUM(oi.quantity * oi.unit_price) AS revenue
## FROM orders o
JOIN items oi ON oi.order_id = o.order_id
JOIN products p ON p.product_id = oi.product_id
GROUP BY o.order_date, p.category
""")

## Пример извлечения результата
df = con.execute("SELECT * FROM daily_sales LIMIT 100").fetchdf()
Оптимизация памяти и план выполнения также часто требует внимания к параметрам параллелизма, настройке кеширования и выбору режимов чтения (например, чтение только нужных столбцов), что влияет на скорость прохождения больших наборов данных через DuckDB. В реальных пайплайнах целесообразно сочетать DuckDB с системой оркестрации, такой как Airflow или Dagster, чтобы обеспечить повторяемость, версионирование и мониторинг цикла преобразований.
-
Архитектура DuckDB в пайплайнах: паттерны взаимодействия
-
Пример кода на DuckDB в Python для схемы ETL
-
Паттерны повышения повторяемости и качества данных
-
Обеспечение воспроизводимости: управление версиями схем и данных
Кейс 1: E-commerce - аналитика спроса, сегментация и ценообразование
Электронная коммерция генерирует массив взаимосвязанных данные: заказы, позиции в заказах, каталоги продуктов и атрибуты клиентов. В реальном проекте DuckDB применяется для быстрой агрегации по дням, категориям и сегментам, а затем экспорта результатов в витрину BI или модельному пайплайну для последующего моделирования ценовых стратегий.
Ключевые шаги кейса:
- Ингестинг: данные о заказах, деталях заказов, продуктах и клиентах загружаются из Parquet (или SQL‑баз) и приводятся к согласованной схеме внутри DuckDB.
- Трансформация: вычисление дневной выручки и объема продаж по категориям, построение топ‑N продуктов, анализ сезонности.
- Интеграции: результаты интегрируются в витрину BI и загружаются в пакетные хранилища для дальнейшего ML‑потребления.
- Контроль качества: базовые проверки полноты данных, дубликаты заказов, корректность цен и валидность дат.
Преимущества подхода:
- быстрая настройка и итеративная аналитика над актуальными данными;
- возможность сквозной аналитики на одном стеке без сложной миграции в кластер;
- простая повторяемость пайплайна благодаря SQL‑логике и материализованным представлениям.
Реализация на практике может выглядеть так:
import duckdb
con = duckdb.connect()

con.execute("CREATE TABLE orders AS SELECT * FROM read_parquet('data/orders.parquet')")
con.execute("CREATE TABLE items AS SELECT * FROM read_parquet('data/order_items.parquet')")
con.execute("CREATE TABLE products AS SELECT * FROM read_parquet('data/products.parquet')")

con.execute("""
## CREATE MATERIALIZED VIEW daily_sales AS
SELECT o.order_date, p.category, SUM(oi.quantity) AS total_units,
       SUM(oi.quantity * oi.unit_price) AS revenue
## FROM orders o
JOIN items oi ON oi.order_id = o.order_id
JOIN products p ON p.product_id = oi.product_id
GROUP BY o.order_date, p.category
""")

df = con.execute("SELECT * FROM daily_sales ORDER BY order_date LIMIT 200").fetchdf()
Аналитики часто дополняют DuckDB данными клиента и маркетинговыми метриками, чтобы построить набор признаков для последующей ML‑модели. Пример интеграции с Python‑пакетом pandas демонстрирует, как результаты DuckDB передаются в DataFrame для дальнейшей обработки или визуализации.
import pandas as pd
df_top_categories = con.execute("""
SELECT category, SUM(total_units) AS units, SUM(revenue) AS rev
FROM daily_sales
GROUP BY category
ORDER BY rev DESC
LIMIT 10
""").fetchdf()
## дальнейшая обработка в pandas/ seaborn или scikit-learn
Эта история иллюстрирует, как DuckDB может служить «мягким» слоем агрегаций и расчета ключевых бизнес‑метрик, освободив команду от сложной настройки распределенного вычисления и тем самым ускорив цикл анализа и принятия решений по ценовым стратегиям и ассортименту.
- Кейс 1: E-commerce** - аналитика спроса, сегментация и ценообразование
- Интеграции с Python и BI-инструментами
Кейс 2: Финансы - обработка больших журналов транзакций и риск-аналитика
Финансовые домены представляют огромные журналы транзакций и клиринговых операций, где важна как полнота данных, так и скорость получения контрольных показателей. DuckDB применяется для обработки «больших» датасетов внутри одного процесса, что позволяет быстро строить аналитические витрины, ROC/AUC‑показатели для ранжирования риска и детальные профили клиентов.
Ключевые задачи кейса:
- агрегации и фильтрации по временным окнам: обработка транзакций за последние 30-90 дней, расчеты скользящих средних по сумме и количеству транзакций;
- квалификация риска: вычисление скоринговых показателей на уровне пользователя и сегментов;
- сверка и контрольной аудит: качество данных, детектирование дубликатов, согласование с реестрами.
Пример архитектурного решения:
- данные хранятся в Parquet/ORC в дата‑lake;
- DuckDB читает и агрегирует данные в batch‑режиме, формируя набор признаков для модели;
- результаты выгружаются обратно в Parquet и загружаются в хранилище для регуляторной отчетности.
Ниже приведен упрощенный фрагмент кода, иллюстрирующий создание представления рискового профиля по пользователям на основе транзакций:
con.execute("""
CREATE TABLE transactions AS SELECT * FROM read_parquet('data/transactions.parquet')
""")

con.execute("""
CREATE VIEW user_risk AS
SELECT user_id,
       SUM(amount) AS total_spent,
       COUNT(*) AS tx_count,
       AVG(amount) AS avg_tx,
       MAX(timestamp) AS last_tx
FROM transactions
GROUP BY user_id
""")
df = con.execute("SELECT * FROM user_risk WHERE total_spent > 1000").fetchdf()
Для расширения анализа можно добавить вычисление приблизительного количества уникальных клиентов (approx_count_distinct) и индикаторы сезонности по времени суток, что помогает обнаруживать аномалии и нерегулярности в потоках.
- Кейс 2: Финансы** - обработка больших журналов транзакций и риск-аналитика
- Интеграции с Python и BI-инструментами
Кейс 3: Производство и IoT - предиктивная техническая аналитика и оптимизация процессов
Промышленность и IoT создают огромные массивы временных рядов: температуры, давление, вибрации, параметры оборудования. DuckDB в таких случаях выступает как слой предиктивной аналитики, обеспечивая быстрое вычисление агрегатных статистик, корреляций, оконных функций и сезонных паттернов для сотен устройств на больших датасетах.
Ключевые направления кейса:
- сбор данных: исторические логи с датчиками сохранены в Parquet/CSV и подгружаются в DuckDB;
- агрегации и окна: расчет скользящих средних, стандартных отклонений по устройствам и по линиям;
- предупреждения и визуализация: выявление аномалий, которые уходят за пределы нормального диапазона, и экспорт результатов в витрину мониторинга.
Пример SQL‑кода для вычисления скользящего среднего по устройствам:
## SELECT device_id, ts,
       AVG(temperature) OVER (PARTITION BY device_id
## ORDER BY ts
                            ROWS BETWEEN 24 PRECEDING AND CURRENT ROW) AS temp_ma24,
       AVG(vibration) OVER (PARTITION BY device_id
## ORDER BY ts
                            ROWS BETWEEN 24 PRECEDING AND CURRENT ROW) AS vib_ma24
FROM sensor_readings
WHERE ts >= DATE '2025-01-01'
Такой подход позволяет оценивать динамику параметров в реальном времени, однако стоит помнить, что DuckDB работает в рамках одного процесса, поэтому для онлайн‑потоков и реального времени обычно применяются дополнительные очереди и конвейеры данных, а DuckDB выступает в роли аналитического слоя в пакетной обработке или периодическом обновлении витрины.
Еще один важный момент - сочетание DuckDB с внешними инструментами мониторинга и управления данными. Например, табличные представления и MV‑модели могут использоваться для повторной генерации предупреждений, которые затем передаются в систему оповещений и дашборды операционного контроля. В контексте промышленной эксплуатации легко интегрировать DuckDB с pipeline‑менеджерами (Airflow, Dagster) для расписания периодических расчетов и ретрансляции результатов в систему визуализации и учета.
- Кейс 3: Производство и IoT** - предиктивная техническая аналитика и оптимизация процессов
- Интеграции с Python и BI-инструментами
Интеграции с Python, Pandas, Airflow и BI‑инструментами
Эффективная архитектура аналитических пайплайнов требует тесной интеграции DuckDB с языками и инструментами, которыми пользуются команда Data Engineering и Data Science. В этом разделе рассмотрены паттерны интеграции и примеры, которые помогут скоординировать этапы загрузки, трансформации и распространения данных.
-
Python и Pandas. DuckDB предоставляет Python‑API, через которое можно регистрировать DataFrame как временную таблицу или напрямую читать Parquet и выполнять SQL‑операции. Результаты можно конвертировать обратно в Pandas DataFrame для последующей ML‑обработки или визуализации.
-
Оркестрация. Airflow, Dagster, Prefect - инструменты, которые позволяют планировать и контролировать пайплайны. Взаимодействие с DuckDB может происходить через Python‑операторы и хуки, а также через вызовы SQL‑скриптов, встроенные в задачи.
-
BI и коннекторы. Результаты DuckDB обычно экспортируются в Parquet или статические таблицы, откуда BI‑инструменты (Tableau, Power BI, Looker и пр.) могут читать данные напрямую или через коннекторы к Parquet/CSV. DuckDB также поддерживает ODBC/JDBC интерфейсы, что обеспечивает гибкость подключения к внешним витринам.
Пример интеграции DuckDB с Python и Pandas:
import duckdb
import pandas as pd

## Соединение и подготовка данных
con = duckdb.connect()

con.execute("CREATE TABLE orders AS SELECT * FROM read_parquet('data/orders.parquet')")
con.execute("CREATE TABLE products AS SELECT * FROM read_parquet('data/products.parquet')")

## Выполнение SQL‑перекрестной агрегации
con.execute("""
## CREATE MATERIALIZED VIEW daily_sales AS
SELECT o.order_date, p.category, SUM(oi.quantity) AS total_units,
       SUM(oi.quantity * oi.unit_price) AS revenue
## FROM orders o
JOIN items oi ON oi.order_id = o.order_id
JOIN products p ON p.product_id = oi.product_id
GROUP BY o.order_date, p.category
""")

## Извлечение данных для науки о данных
df = con.execute("SELECT * FROM daily_sales LIMIT 100").fetchdf()
## Передача в Pandas для ML/визуализации
Инструменты оркестрации можно использовать так, чтобы держать DuckDB как часть конвейера:
- Airflow: запуск Python‑функций, которыми управляется DuckDB, либо выполнение SQL‑скриптов через PythonOperator.
- Dagster: создание активностей, которые инициализируют соединение, выполняют запросы и передают данные между шагами конвейера.
Более того, DuckDB поддерживает экспорт данных в Parquet, что позволяет строить витрину данных и обмениваться данными между командами без лишних копий.
Таблица некоторых интеграционных паттернов:
| Инструмент | Роль | Преимущества использования DuckDB |
|---|---|---|
| Python (duckdb‑python) | Исполнение SQL в рамках Python‑скриптов | Быстрая интеграция с pandas, гибкость тестирования и прототипирования |
| Airflow/Dagster | Оркестрация пайплайнов | Надежность запуска, повторяемость и мониторинг |
| BI‑инструменты (Tableau/Power BI) | Визуализация и аналитика | Прямой доступ к агрегированным данным, экспорт в Parquet/CSV |
- Интеграции с Python, Pandas, Airflow и BI‑инструментами
- FAQ
Key takeaways
- DuckDB — встроенный аналитический движок, который позволяет выполнять сложную SQL‑аналитику на больших наборах данных непосредственно внутри процесса исполнения.
- Архитектура в пайплайнах строится вокруг трех слоев: интеграционный, трансформационный и выходной. Важно выбрать правильные точки материализации промежуточных результатов.
- DuckDB хорошо подходит для этапов подготовки данных, интерактивной аналитики и ускоренных циклов разработки благодаря поддержке Parquet и векторизованному исполнению.
- Практические кейсы показывают, как DuckDB может использоваться в E‑commerce, финансах и производстве для ускорения анализа, сокращения затрат и повышения воспроизводимости.
- Интеграции с Python и BI‑инструментами позволяют связать DuckDB с текущим стеком данных: от загрузки данных до визуализации и ML‑проектов.
FAQ
- Что именно DuckDB приносит в пайплайн как ядро аналитики?
- DuckDB обеспечивает высокую производительность SQL‑аналитики на больших датасетах без необходимости разворачивать кластер. Это позволяет быстро prototyping и итерации по бизнес‑задачам, в то время как данные остаются недалеко от источника (например, в Parquet на Data Lake). Взаимодействие с Python упрощает подготовку данных, ML‑инструменты и визуализацию, а поддержка MV/VIEW позволяет повторно использовать результаты в разных сценариях.
- Какие сценарии оптимальны для DuckDB в реальных проектах?
- Преобразования и агрегации больших наборов данных на стадии ETL/ELT, интерактивная аналитика, подготовка фич для моделей и создание витрин. DuckDB хорошо подходит для случаев, когда данные лежат в формате колонно‑ориентированных файлов (Parquet) и требуется быстрый доступ к агрегированным метрикам без развертывания распределенной инфраструктуры.
- Как выбрать между DuckDB и распределенными решениями?
- Выбирайте DuckDB для интерактивной аналитики, прототипирования и средних по размеру датасетов, когда бюджет ограничен или важна скорость внедрения. Для truly больших потоков, стриминга и распределенной обработки лучше использовать комбинацию DuckDB как локального слоя анализа в рамках пайплайна с внешними системами для хранения и обработки в масштабе.
- Как обеспечить качество данных при использовании DuckDB?
- Внедрите проверки на уровне SQL: контроль полноты, согласование схем, дедупликацию, а также верификацию агрегаций и соответствие бизнес‑правилам. Используйте MV/VIEW для регламентного повторного расчета, фиксируйте версии схем и данных, чтобы можно было вернуть пайплайн к устойчивому состоянию.
- Какие ограничения у DuckDB в контексте реального времени?
- DuckDB работает в рамках одного процесса и оптимизирован для пакетной/интерактивной аналитики, а не для непрерывной потоковой обработки. В реальном времени DuckDB часто применяется как слой переработки после поступления данных в виде порций, с последующей отправкой результатов в оперативное хранилище или витрину. Для нативного стриминга чаще используют сочетание с системами очередей и потоковой обработки.
- Какие форматы данных предпочтительны для DuckDB в промышленной среде?
- Parquet и Arrow являются предпочтительными форматами, поскольку они поддерживают колоночную речь, схему и эффективную фильтрацию. Parquet особенно подходит для Data Lake‑архитектур, где DuckDB читает данные без необходимости дополнительной конвертации.
- Как организовать интеграцию DuckDB с BI‑инструментами?
- Экспортируйте результаты в Parquet/CSV или используйте ODBC/JDBC коннекторы, чтобы BI‑инструменты могли подключаться напрямую к данным DuckDB. В большинстве случаев DuckDB выступает как точка агрегации перед данными BI, где данные уже агрегированы и структурированы для дашбордов.
- Насколько важна материализация представлений?
- Materialized views позволяют сохранить промежуточные результаты и повторно использовать их без повторных вычислений, что особенно ценно в регулярных пайплайнах. Однако требуется контроль за обновлениями MV и стратегией инвалидации данных.
- Какие практики обеспечить для воспроизводимости пайплайнов?
- Версионирование схем, хранение SQL‑скриптов в репозитории, фиксация версий данных, а также автоматизация тестирования на небольших подмножествах данных. Использование MV/VIEW и сохранение внешних зависимостей обеспечивает детерминированность и повторяемость в разных окружениях.
- Какие примеры открытых инструментов можно применить в связке с DuckDB?
- DuckDB — открытый проект, который хорошо комбинируется с Parquet, Arrow и Python‑экосистемой. В рамках российской или мировой экосистемы можно привести примеры рабочих сценариев с открытым стеком анализа, где DuckDB выполняет роль эффективного аналитического слоя. В качестве альтернативы для распределенного хранения и потоковой обработки можно рассмотреть совместное использование инструментов для оркестрации и витрин. Важно не перегружать архитектуру лишними компонентами и использовать DuckDB там, где его архитектурные преимущества наиболее ощутимы.


