

Архитектурные паттерны разворачивания DuckDB: embedded, server mode
DuckDB выступает как гибкий аналитический движок, который ощутимо упрощает построение современных аналитических платформ за счет поддержки как встроенного (embedded) режима, так и серверного (server mode) разворачивания. Встроенный режим обеспечивает минимальные задержки и тесную интеграцию с приложением, в то время как серверный режим позволяет централизовать вычисления, обеспечить многоклиентскую многопользовательскую среду и масштабируемость в больших корпоративных ландшафтах. Выбор паттерна влияет на архитектуру стэков, требования к ресурсам, аспекты безопасности и жизненного цикла разворачивания. В главе представлены принципы архитектуры, характерные паттерны разворачивания и практические рекомендации по внедрению в современные data stack.
В современных аналитических платформах DuckDB выступает как ядро вычислений, которое может работать внутри приложения или как отдельный сервис. Оба подхода основаны на одной и той же реализации ядра обработки запросов с симметричным использованием столбцового формата хранения и векторизованного выполнения. Однако они различаются в аспектах управления ресурсами, изоляции, масштабирования и взаимодействия с остальными компонентами data stack. Рассматривая архитектурные паттерны, важно помнить: выбор не является ответом «один размер подходит всем» - оптимальная конфигурация зависит от профиля нагрузки, требований к латентности, степени изоляции между пользователями и организационных условий.
Краткое содержание главы
- Архитектура DuckDB: чем отличается embedded режим от server mode и как это влияет на архитектуру приложения
- Управление памятью, планирование запросов и параллелизм в разных режимах
- Интеграция в современный data stack: хранение данных, источники данных, безопасный доступ и мониторинг
- Масштабирование, многопользовательский доступ и DevOps: безопасность, изоляция, мониторинг
- Практические сценарии развертывания и критерии выбора между паттернами
Встроенный режим (embedded)
Встроенный режим предполагает, что движок DuckDB интегрирован в процесс приложения. База данных существует как часть процесса (или как единица в контейнере), и все вычисления выполняются внутри этого процесса. Такой подход приносит минимальные задержки из-за отсутствия сетевых вызовов между клиентом и базой данных и позволяет эффективно делиться памятью между приложением и аналитическим движком. Встроенный режим особенно эффективен, когда задача аналитики тесно связана с операционными транзакциями или когда аналитика должна идти «на месте» в рамках сервиса, не требующего отдельного сервера.
Архитектура и принципы работы
Архитектура embedded DuckDB строится вокруг одного процесса, который содержит планировщик запросов, оптимизатор, исполнители и механизмы доступа к данным. Движок работает с колонным форматом хранения, применяя векторизованное исполнение и конвейерную обработку операторов. Это обеспечивает высокую пропускную способность на аналитических рабочих нагрузках и экономию времени на загрузку данных, поскольку данные могут читаться напрямую из файловой системы или уже находиться в памяти приложения.
Ключевые преимущества embedded-режима включают:
- минимальная задержка на путь from request до выполнения запроса за счет отсутствия сетевого протокола между клиентом и движком;
- тесную интеграцию с бизнес-логикой приложения: можно использовать одну кэш-слой и один набор метаданных;
- упрощённое развертывание в контейнере или на стороне клиентского сервиса, потому что не требуется управлять отдельным сервером.
Недостатки включают:
- ограниченная изоляция ресурсов: конкурирующие задачи внутри одного процесса могут влиять на латентность и Throughput аналитической части;
- сложность масштабирования горизонтально: для больших параллельных рабочих нагрузок может потребоваться несколько экземпляров, однако синхронизация и консистентность между ними усложняются;
- безопасность и multi-tenant из-за совместного процесса с приложением.
Управление памятью и планирование запросов
В embedded-режиме DuckDB отдаёт управление памятью приложению. Важным аспектом является размер пула памяти для выполнения векторизированных операторов, размер буферных кешей и настройки параллелизма. Планировщик запросов оптимизирует исполнение на уровне операционной плоскости: распараллеливание сканирования столбцов, фильтрации и соединений, а также конвейерная передача результатов между операторами. Эффективности достигаются за счёт столбцового формата хранения и минимизации копирования данных между операциями.
Хранилище данных и обработка столбцов
Встроенный DuckDB может работать с данными, хранящимися локально в файловой системе приложения (например, Parquet, CSV), а также в памяти. Обработка столбцов и словари кодирования позволяют снизить требования к памяти на больших наборах данных. В этом режиме особенно важно эффективно управлять загрузкой данных: детерминированная загрузка частичных наборов (части таблиц) и предикаты над столбцами позволяют ускорить вычисления для аналитических запросов.
Интеграция в приложение и сценарии использования
Embedded-режим хорошо подходит для микро-сервисов и приложений с внутренней аналитикой: финансовые или операционные панели, встроенный BI-слой, предобработки для машинного обучения. Также он удобен для эпохи «data apps» - когда аналитика требуется «вшитой» в интерфейс, без явного сервера аналитики.
Мониторинг, безопасность и жизненный цикл
Мониторинг включает метрики задержек выполнения, объём обработанных данных и загрузку CPU. Логирование запросов и ошибок помогает в трассировке проблем. Безопасность базируется на уровне приложения: контроль доступа может осуществляться на уровне контекста выполнения, а чтение/запись к данным управляется файловой системой и правами доступа. Жизненный цикл внедрения встраиваемого DuckDB зависит от CI/CD и инфраструктурного контроля: обновления движка в составе приложения, миграции схем и совместимости форматов данных.
Примеры сценариев внедрения
- встроенный аналитический модуль в сервисе электронной коммерции для оценки поведения пользователя в реальном времени;
- предобработка и агрегации на edge-устройства, где данные обрабатываются локально и периодически синхронизируются с централизованной системой;
- детальная аналитика на уровне отдельной бизнес-ячейки, где требования к задержкам критичны.
Серверный режим (server mode)
Серверный режим предполагает запуск DuckDB как отдельного сервиса, доступного через сетевой интерфейс. Такой подход обеспечивает централизованную обработку, многоклиентский доступ и изоляцию между запросами. Сервисы и BI-инструменты обращаются к DuckDB Server через установленный протокол, что упрощает организацию политик доступа, мониторинга и масштабирования.
Архитектура сервера: клиенты, воркеры, координация
DuckDB Server - это отдельный процесс/сервис, который обслуживает входящие SQL-запросы. Клиенты устанавливают соединение, отправляют текст SQL или используют сформированные выражения через клиентские библиотеки, получают результат. В серверном режиме возможна горизонтальная масштабированность за счёт множества воркеров и, в некоторых конфигурациях, перегруппировки запросов между серверами. Такую схему часто применяют в больших организациях, где требуется централизовать вычисления, обеспечить консистентность окружения и упростить управление доступом.
Основные преимущества server mode:
- улучшенная изоляция: каждый клиентский запрос обрабатывается в рамках ограниченного набора ресурсов сервера;
- упрощённое масштабирование: выделение вычислительных ресурсов в контейнерах или виртуальных машиах, динамическое добавление воркеров;
- облегчённая поддержка многопользовательской среды и аудита: централизованный доступ, политики безопасности и мониторинга на уровне сервера.
Недостатки включают:
- дополнительные сетевые задержки по сравнению с встроенным режимом;
- необходимость управления сетевой инфраструктурой, а также оркестрацией контейнеров/виртуальных машин;
- требования к устойчивости к отказам сервиса и координации между узлами.
Масштабирование и изоляция ресурсов
Для серверного режима критично обеспечить качественную изоляцию ресурсов между клиентами и конкурентными запросами. Обычно применяют контейнеризацию (Docker, Kubernetes) и ограничение ресурсов на уровне контейнеров или cgroups. Это позволяет выделить CPU, память и I/O для каждого пула воркеров и снизить влияние «смежных» процессов на аналитическую часть. В больших кластерах возможно использование нескольких экземпляров DuckDB Server за прокси-слоем (load balancer) с маршрутизацией по сессиям и данным.
Управление данными и доступом
Серверный режим упрощает управление доступом и аудитом за счёт единой политики аутентификации и авторизации. Встроенные решения часто сочетаются с корпоративной идентификацией (SSO, LDAP/OAuth) и централизованными секретами. Также реализуется политика доступа к данным на уровне базы, привязка к ролям, управление правами чтения и записи, а не на уровне каждого клиента. Хранение данных может быть реализовано на локальных файловых системах узла, на распределённых хранилищах или через совместную точку монтирования, что облегчает резервное копирование и миграции.
Интеграция с data stack
Серверный DuckDB часто выступает в роли центрального вычислительного узла внутри data stack: ETL-пайплайны, BI-инструменты, аналитические сервисы и дашборды подключаются к серверу для единообразной аналитики. Такой подход упрощает кэширование результатов, повторное использование вычислительных мощностей и обеспечивает единый источник истины для аналитических запросов. DuckDB Server может работать как часть контейнеризированной архитектуры в Kubernetes, где каждый сервис взаимодействует через единый сетевой интерфейс.
Мониторинг, observability и DevOps
Для серверного режима критично наличие комплексной observability: latency/throughput по каждому классу запросов, распределение времени выполнения на воркеры, загрузка CPU и памяти, мониторинг очередей и статистика ошибок. Логирование и трассировка позволяют детектировать «узкие места» в планировании и исполнении. В DevOps-практике важны стратегии отката, управление конфигурациями (параметры пула воркеров, лимиты на ресурсы, политики обновления сервера) и подписка на оповещения об аномалиях.
Безопасность и соответствие требованиям
Безопасность в серверном режиме строится на уровне сети и аутентификации. Вентиляционными механизмами могут выступать TLS, VPN, firewall, а также политики ролевого доступа и журналирование доступа к данным. Важно обеспечивать изоляцию между tenant’ами, если DuckDB Server обслуживает несколько организаций или подразделений. Полезно внедрять годовую/полугодовую процедуру аудита и миграции схем, чтобы обеспечить совместимость версий и безопасное обновление.
Миграции и совместимость
При миграциях между режимами или обновлениях DuckDB важно планировать совместимость форматов хранения, схем и функций. В серверном режиме это особенно значимо, поскольку клиенты полагаются на стабильность протоколов взаимодействия и поведение оптимизатора. Практически рекомендуется выпускать миграционные версии, проводить тестовые обновления в staging-окружениях и предусматривать откатные механизмы.
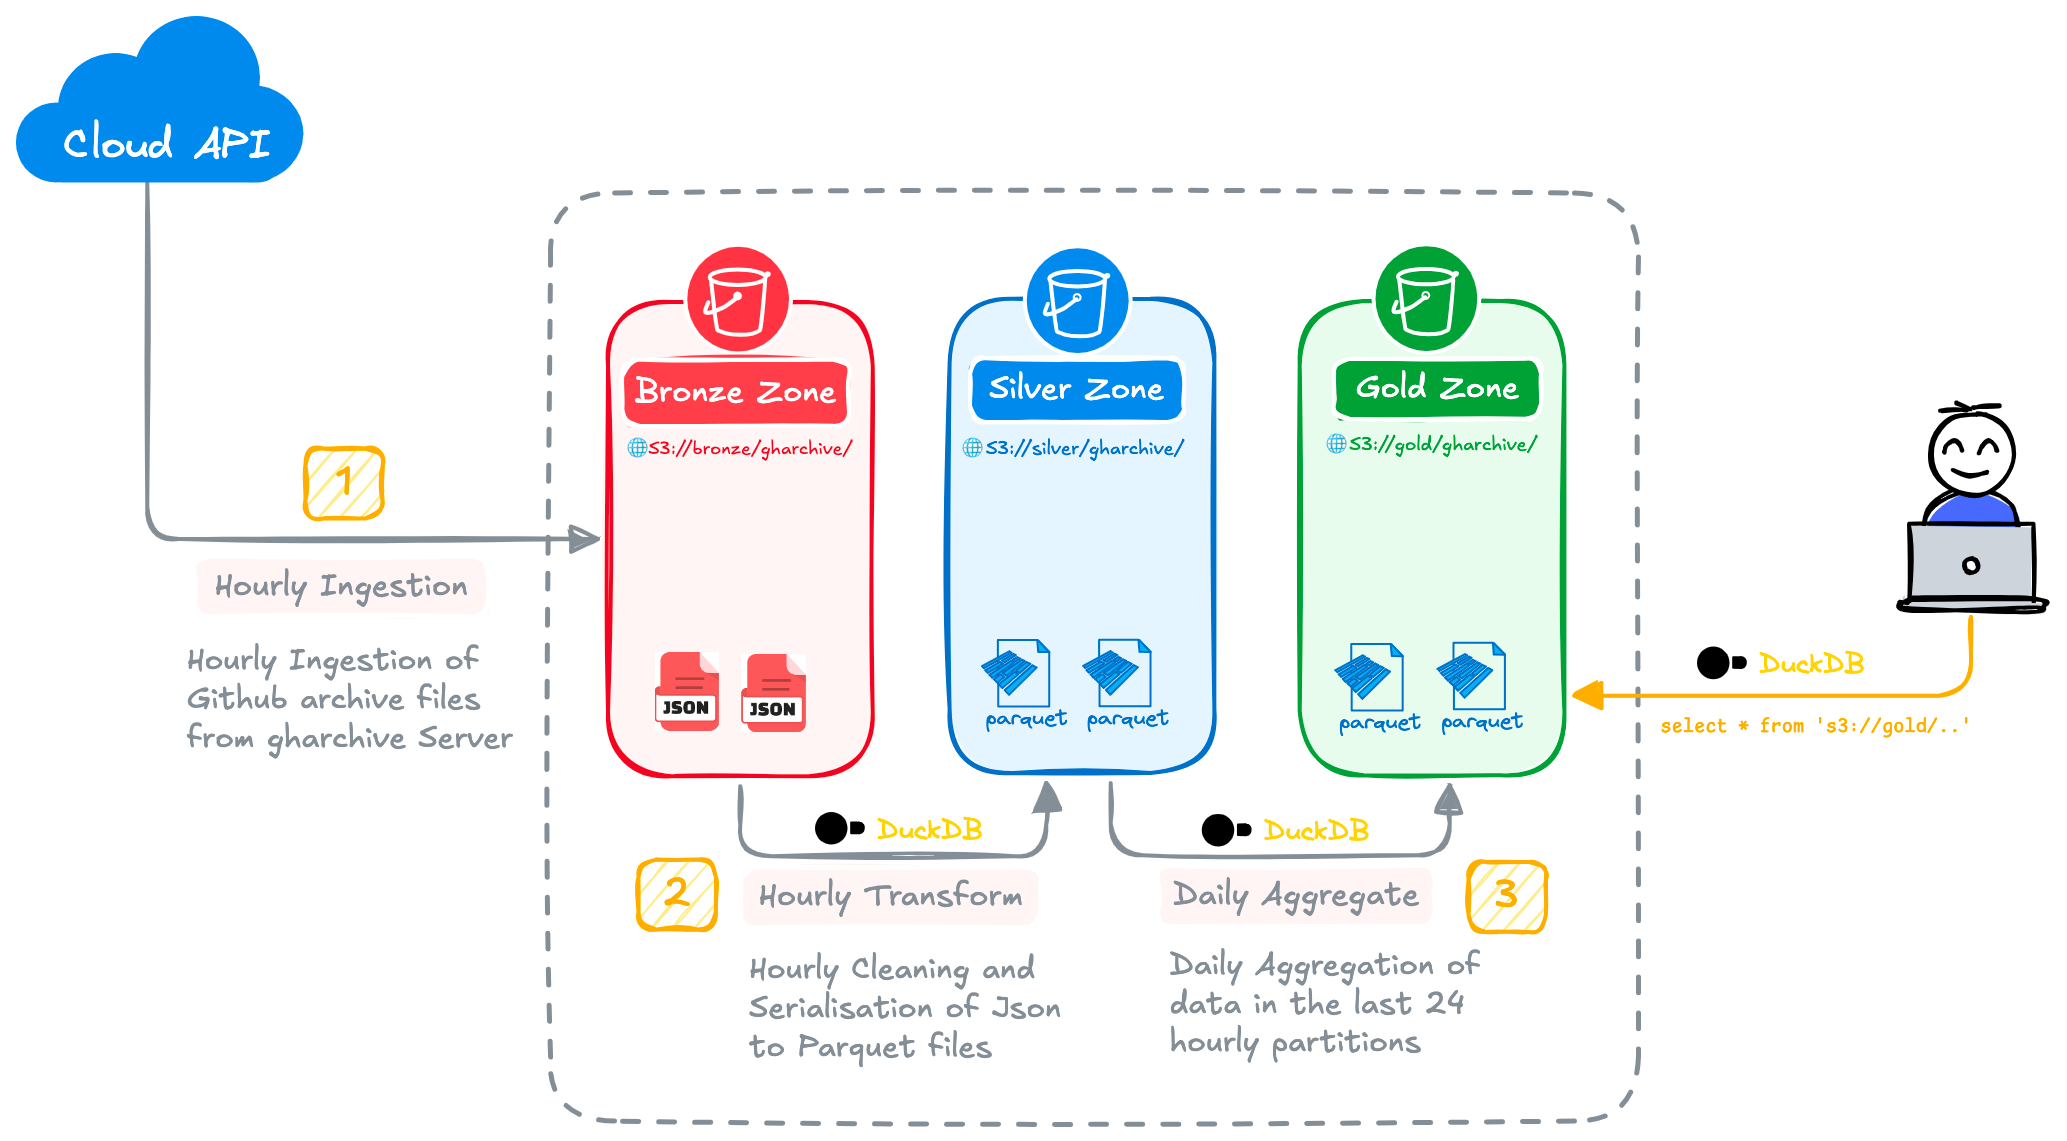
Интеграционные паттерны и гибридные сценарии
Современная data платформа часто реализует гибридные конфигурации: часть аналитических задач выполняется в встроенном режиме, часть - через сервер, в зависимости от потребностей в латентности, масштабе и изоляции. Гибридные паттерны позволяют сочетать уникальные преимущества каждого режима и минимизировать компромиссы.
Паттерны разворачивания
- Embedded-вмещение для низкой задержки: аналитика прямо в сервисах и микросервисах, периоды пиковых нагрузок - локальные кэшированные данные.
- Серверный режим для централизованной аналитики: единая платформа BI/ETL и персонализированная аналитика для множества клиентов в рамках политики безопасности и контроля доступа.
- Гибрид: локальные аналитические сервисы с быстрым доступом к данным и централизованный слой агрегаций и мониторинга на DuckDB Server. Такой подход хорошо подходит для корпоративных сценариев, где критична как задержка, так и управляемость.
Взаимодействие между режимами
Разграничение контекстов выполнения играет важную роль: некоторый анализ выполняется внутри приложения, а дополнительные агрегации и сложные дашборды - на сервере. В такой схеме возможно использовать общий источник данных (постоянное хранилище или колоночные файлы) и сегрегировать окружения через политики безопасности, маршрутизацию запросов и кэширование.
Примеры основных архитектурных схем
- Архитектура «встроенная аналитика плюс централизованный сервиса»: приложение содержит DuckDB в embedded-режиме для локальных задач; рядом развёрнут DuckDB Server для объединённых запросов BI и кросс-доменных сценариев.
- Архитектура «единый сервис для аналитики» на основе DuckDB Server с тонким клиентским слоем, где данные читаются из централизованного хранилища и обрабатываются на сервере.
- Архитектура «edge + центр» для распределённых сценариев: на периферии используются встроенные инстансы DuckDB для локальной подготовки данных, а в центральном сервисе выполняются крупномасштабные аналитические запросы.
Взаимосвязь с современным data stack
DuckDB в обоих режимах лучше всего работает в составе современного data stack благодаря поддержке колонного формата, эффективной обработке больших наборов данных и способности читать данные из Parquet, JSON и других форматов без сложной загрузки в промежуточные хранилища. Встраиваемый режим упрощает интеграцию в приложения и управление данными «на месте», тогда как серверный режим обеспечивает единый сервис аналитики и возможности многоарендной среды. В любом случае важна совместимость форматов, поддержка источников данных и возможность использовать DuckDB как «универсальный движок» для разнообразных задач: ETL, подготовка данных, быстрые аналитические вычисления и дашбординг.
Практические соображения по конфигурации
- Определите профиль нагрузки: если латентность критична и аналитика тесно связана с операционными сервисами - рассмотрите embedded-режим; если требуется многопользовательский доступ и масштабирование, отдайте предпочтение серверному режиму.
- Оцените требования к изоляции и безопасности: для многопользовательской среды чаще выбирают серверный режим с централизованной политикой доступа.
- Планируйте интеграцию в data lake/warehouse: способность DuckDB читать Parquet и другие форматы упрощает создание слоев агрегаций и ускоряет развитие аналитических пайплайнов.
- Разработайте стратегию мониторинга: инструментирование ЛКМ, трассировка запросов, SLA-метрики по латентности и throughput.
Пример конфигурации для гибридной архитектуры может включать:
- локальные встроенные экземпляры DuckDB в микросервисах для быстрых локальных расчётов;
- центральный DuckDB Server для агрегированных запросов BI и кросс-сервисной аналитики;
- общий источник данных (Parquet/ORC) и единый каталог схем;
- политика безопасности и доступности на уровне сервиса.
Key takeaways
- DuckDB поддерживает два основных паттерна разворачивания - embedded и server mode - каждый из которых оптимален для разных сценариев нагрузки и архитектурных ограничений.
- Встроенный режим обеспечивает минимальные задержки и тесную интеграцию с приложением, но требует грамотного управления ресурсами внутри одного процесса.
- Серверный режим обеспечивает масштабируемость, многоклиентский доступ и централизованный контроль, но добавляет сетевые задержки и инфраструктурные требования.
- Архитектура и конфигурация должны учитывать требования к изоляции, безопасности, мониторингу и жизненному циклу обновлений.
- Гибридные подходы позволяют сочетать преимущества обоих режимов в рамках единого data stack, обеспечивая баланс между латентностью и масштабируемостью.
- Эффективная интеграция DuckDB в data stack требует поддержки форматов данных (Parquet, Arrow), совместного доступа к источникам и продуманной стратегии резервного копирования и миграций.
- Наблюдаемость и управляемость должны стать неотъемлемой частью развёртывания: метрики производительности, журналирование запросов и аудита доступа позволяют добиваться стабильной и предсказуемой аналитики.
FAQ
- В каких сценариях целесообразнее выбирать embedded режим по сравнению с server mode?
- Embedded режим целесообразен, когда аналитика тесно связана с операционными сервисами, нужна минимальная латентность и отсутствие сетевой инфраструктуры между клиентом и движком. Он хорошо подходит для микросервисной архитектуры, локальной обработке данных на краю и задач, где данные обрабатываются «на месте» без большого требования к горизонтальному масштабированию.
- Какие риски связаны с многопоточностью и изоляцией в embedded режиме?
- В embedded режиме ресурсы разделяются внутри одного процесса, что требует аккуратного управления планировщиком, пулом потоков и памятью. Неправильная настройка может привести к задержкам и перегреву и конкуренции между аналитикой и операционными задачами. Рекомендуется использовать детерминированные лимиты памяти и CPU, а также тестировать под реальными пиковыми нагрузками.
- Как обеспечить безопасный многопользовательский доступ в server mode?
- В серверном режиме безопасности уделяется внимание аутентификации, авторизации и управлению доступом на уровне базы. Важно внедрить SSO или LDAP/OAuth, роли и политики доступа, журналирование и мониторинг попыток входа и выполнения операций, а также изоляцию tenant’ов через политики сетевого доступа и конфигурацию контейнеров.
- Какие данные DuckDB поддерживает обрабатывать эффективно в обоих режимах?
- DuckDB хорошо работает с Parquet, CSV, JSON и другими колоночными источниками. Он способен читать данные напрямую без полной загрузки в память, использовать столбцовый формат хранения и векторизованное выполнение. В серверном режиме добавляется возможность кэширования и общих источников данных для нескольких клиентов, что упрощает агрегирование и повторное использование вычислений.
- Каковы принципы интеграции DuckDB с BI-инструментами и ETL-пайплайнами?
- DuckDB может выступать zentralным аналитическим движком для BI-инструментов и ETL-процессов, обеспечивая единый источник истины и повторное использование вычислительных ресурсов. Важно обеспечить совместимость форматов данных, стабильную сетевую инфраструктуру и согласование схем между источниками и целями.
- Какие паттерны монитории и observability рекомендуются для DuckDB Server?
- Рекомендуется собирать задержки выполнения, throughput, распределение времени выполнения по операторов, загрузку CPU и памяти, а также метрики очередей и ошибок. Логирование запросов и трассировка помогаю выявлять узкие места и обеспечивают воспроизводимость инцидентов.
- Как обустроить миграцию между embedded и server mode?
- Миграция предполагает плановую миграцию данных и схем, а также тестирование совместимости протоколов доступа и форматов. Важно предусмотреть откатные механизмы, staging-окружения и, если возможно, синхронизацию изменений между режимами на ранних стадиях внедрения.
- Какие ограничения по масштабированию в server mode?
- Масштабирование зависит от инфраструктуры: количество воркеров, использование контейнеров, сетевые задержки и балансировка нагрузки. В крупных конфигурациях целесообразна архитектура с несколькими DuckDB Server-инстансами и прокси-сервисом, который маршрутизирует запросы и координирует данные.
- Какие практики DevOps способствуют устойчивости развёртывания DuckDB?
- Рекомендованы практики конфигурационного как кода, CI/CD для обновлений движка, автоматизированные тесты на регрессию и совместимость форматов, мониторинг и оповещение, резервное копирование данных и план аварийного восстановления.
- Можно ли мигрировать существующий проект между embedded и server mode без больших изменений?
- Частично возможно, если между режимами существует единый слой доступа к данным и единая логика трансформаций. В реальности миграция требует переработки частей архитектуры: изменение точки входа запросов, настройка сетевого взаимодействия (для server mode) и перераспределение задач между локальной аналитикой и централизованной обработкой. Подготовка архитектурной дорожной карты и пилотный проект помогут минимизировать риски.
Глава охватывает архитектурные основы двух паттернов разворачивания DuckDB, их влияние на построение аналитических платформ и практические сценарии интеграции в современные data stack. Продуманная комбинация embedded и server mode в рамках гибридной архитектуры позволяет реализовать требования к низкой задержке и масштабируемости, обеспечивая при этом единое и контролируемое аналитическое окружение.


