

Практические лабораторные задачи: проекты и лаборатории
DuckDB предоставляет встроенную аналитическую платформу, сфокусированную на локальной обработке данных в формате Parquet и поддержке полноценных SQL-анализов. В данной главе представлены практические лабораторные задачи и лабораторные проекты, цель которых - перейти от понимания архитектуры к эффективной реализации аналитики на локальных данных. Особое внимание уделяется архитектурному обоснованию решения, механизмам оптимизации запросов и интеграциям с прикладными окружениями, которые на практике встречаются в проектах цифровой трансформации.
Кратко о содержании главы
- Архитектура DuckDB и алгоритмы выполнения в контексте лабораторных проектов: встроенный движок, векторизация и маршрутизация данных.
- Работа с Parquet и локальные сценарии аналитики: чтение, фильтрация и агрегации на больших локальных наборах данных.
- Интеграции и сценарии внедрения: Python, Jupyter, конфигурация окружения и типичные паттерны использования.
- Практические лабораторные проекты: задачи, пошаговые планы, ожидаемые результаты и критерии оценки.
- Валидация и производительность: измерения, профилирование, оптимизации и принципы устойчивого использования ресурсов.
Архитектура DuckDB и алгоритмы выполнения
DuckDB реализован как встраиваемая аналитическая база данных, ориентированная на одиночные процессы и локальное выполнение запросов. Архитектура строится вокруг нескольких ключевых компонентов, которые определяют поведение на этапе лабораторных проектов:
- Встроенный движок без сервера. Отсутствие внешнего сервера упрощает конфигурацию и обеспечивает минимальные задержки между загрузкой данных и обработкой. Взаимодействие с данными происходит внутри процесса, что упрощает развертывание на рабочих станциях и ноутбуках.
- Хранилище столбцов и векторизированное выполнение. DuckDB оперирует столбцовыми структурами данных и применяет векторизацию операторов на блоках данных, что повышает пропускную способность при обработке больших объемов колонок и снижает накладные расходы на доступ к памяти. Это особенно важно при работе с Parquet, где выборка только нужных столбцов может существенно уменьшать объем считываемых страниц.
- Каталог и планировщик запросов. Логическая оболочка запроса преобразуется в физические планы, где применяются правила оптимизации и выбор реализаций операторов. В лабораторном контексте это позволяет демонстрировать различия между планами выполнения и видеть влияние фильтрации, сортировки и агрегаций на итоговый набор данных.
- Интеграция с Parquet. DuckDB включает нативный Parquet-reader с поддержкой predicate pushdown, column pruning и эффективной загрузкой данных. Это критически важно для лабораторной работы: можно начинать с компактных наборов Parquet и постепенно переходить к полноразмерным файлам.
- Оптимизация и генерация кода. В рамках проекта можно рассмотреть генерацию кода операторов и параллельную обработку, что позволяет объяснить принципы ускорения выполнения и влияние параметров конфигурации на производительность.
Почему это важно для лабораторных задач? От моделирования архитектуры до анализа конкретных планов выполнения и поведения системы - все это формирует практическую грамотность: как проектировать аналитические задачи на локальных данных, как выбирать формат хранения и какие параметры конфигурации помогают достигать поставленных целей в рамках доступных ресурсов.
На уровне практики полезно продемонстрировать, как DuckDB обрабатывает характерные сценарии параллельной обработки, как организованы потоки чтения Parquet и как можно управлять памятью и многопоточностью во время лабораторных задач. В этом контексте особенно важны принципы предикатного пуш-дауна, прогона стобцов и минимизации I/O, чтобы лабораторные задачи соответствовали реалиям промышленных проектов.
Векторизация, планирование и исполнение
В лабораторной среде полезно подчеркнуть три аспекта: как именно данные проходят через векторизированный конвейер, как строится физический план и какие примеры операторов являются узкими местами. В DuckDB операции сканирования, фильтрации и агрегации реализованы через набор векторных операторов, которые обрабатывают данные пакетами фиксированной длины. Это позволяет получить линейное или близкое к линейному повышение производительности при росте объема данных, в сравнении с построчным подходом.
- В лаборатории можно продемонстрировать различия между сканированием по всем столбцам и выборочным чтением (column pruning), а также влияние выбора форматов и структуры Parquet на пропускную способность.
- Влияние агрегатных функций и оконных операций на план выполнения становится наглядным через использование EXPLAIN и EXPLAIN ANALYZE - это позволяет студентам видеть, как оптимизатор выбирает стратегии реализации и как распределяется работа между потоками.
-- Пример понятного запроса для лабораторной работы с Parquet
SELECT nation, COUNT(*) AS cnt
FROM 'data/ Parquet/sales.parquet'
WHERE sale_date >= DATE '2023-01-01'
GROUP BY nation
ORDER BY cnt DESC
LIMIT 100;
В этом примере демонстрируется базовая агрегация с фильтром по дате и ограничением результатов. В лабораторной задаче можно расширить его, применив EXPLAIN ANALYZE, чтобы рассмотреть план выполнения и выявить узкие места в зависимости от выбора столбцов и порядка операций.
Интеграция и конфигурация
Чтобы лабораторные задачи соответствовали реалиям производственной среды, следует рассмотреть практические сценарии интеграции DuckDB в прикладные окружения:
- Встраивание в Python через DuckDB API. Это наиболее распространенный сценарий в исследовательских и образовательных проектах, где требуется взаимодействие с Parquet и SQL-аналитикой в рамках ноутбуков или приложений.
- Работа в Jupyter и ноутбуках. DuckDB прекрасно сочетается с интерактивной средой разработки, что упрощает обучение и проведение лабораторных задач.
- Конфигурация параллелизма и памяти. В лабораторной среде полезно проверить поведение DuckDB при изменении числа потоков, лимитов памяти и политики буфера. Параметры конфигурации, такие как количество потоков и лимиты памяти, напрямую влияют на производительность анализа больших локальных наборов данных.
Работа с Parquet и локальными данными
Одно из ключевых преимуществ DuckDB - нативная поддержка Parquet как формата хранения локальных данных. Это позволяет выполнять первичную загрузку и последующий анализ без промежуточных конвертаций.
- Parquet обеспечивает эффективное хранение больших наборов столбцовых данных, что идеально сочетается с архитектурой DuckDB и его векторизованным исполнением. predicate pushdown позволяет DuckDB пропускать чтение неселективных столбцов и строк, экономя время и ресурсы.
- DuckDB читает схему Parquet напрямую и формирует соответствующий набор столбцов в памяти, что уменьшает потребность в переработке данных и облегчает агрегацию и сводную аналитику.
- В лабораторной работе это следует показывать через практические примеры: загрузку отдельных файлов Parquet, объединение нескольких файлов в одну таблицу и выполнение аналитики над объединенным набором.
Рассматривая Parquet, важно подчеркнуть, что выбор столбцов и фильтрация на уровне чтения имеют прямое влияние на производительность. В лабораторных задачах это демонстрируется через сценарии, где часть столбцов не используется в запросе, и DuckDB применяет prune на уровне чтения файлов. Кроме того, работа с большими наборами Parquet-файлов позволяет сравнить влияние последовательного и параллельного чтения, а также роль кэширования файловой системы.
Пример взаимодействия с Parquet через DuckDB
-- Python-подход через DuckDB Python API
import duckdb
con = duckdb.connect()
con.execute("CREATE TABLE sales AS SELECT * FROM read_parquet('data/parquet/sales/')")

## Быстрый быстрый анализ
con.execute("""
    SELECT region, SUM(amount) AS total_amount
    FROM sales
    WHERE order_date >= DATE '2023-01-01'
    GROUP BY region
    ORDER BY total_amount DESC
""").fetchall()
В этом примере показано создание представления на основе Parquet-данных и последующий анализ SQL. Реальная лабораторная задача может включать сравнение этой схемы с чтением всего набора данных без предварительной загрузки таблицы и анализ производительности.
Интеграции и ориентированные на разработчика сценарии внедрения
Для внедрения DuckDB в реальных проектах следует рассмотреть набор сценариев и компонентов продукта, которые наиболее часто применяются в аналитических задачах на локальных данных:
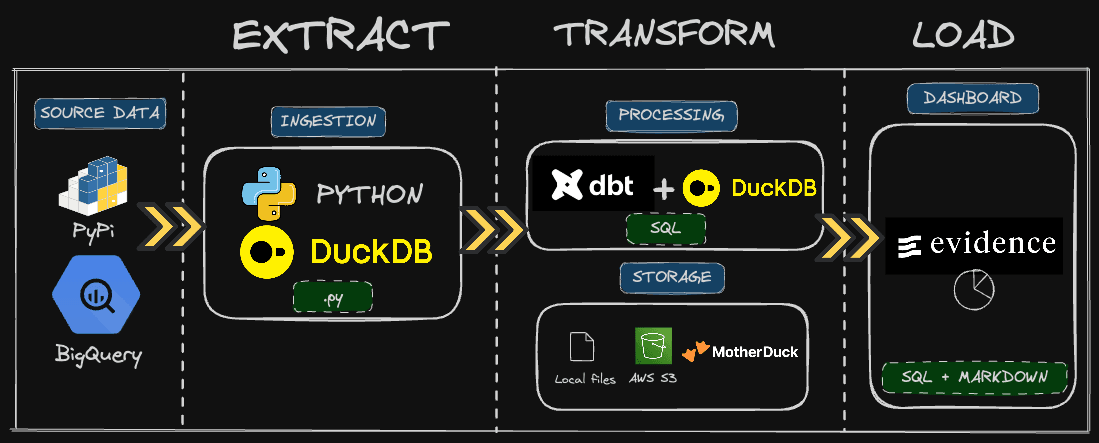
- Комбинация DuckDB и Python. Поддержка SQL-аналитики в интерактивной среде, обработка Parquet, ETL-процессы и быстрый цикл анализа.
- Встраиваемые сценарии в приложения. DuckDB может быть встраиваемой аналитической службой внутри приложения, что упрощает миграцию аналитических функций на локальные данные без дополнительных серверов.
- Конфигурация и управление ресурсами. Параметры, связанные с потоками, памятью и планированием, позволяют адаптировать DuckDB под конкретные условия и требования к производительности.
- Безопасность и качество данных. В лабораторной среде важно рассмотреть аспекты контроля за доступом к данным и валидность транзакционных операций, особенно при обработке локальных данных в рамках проекта цифровой трансформации.
Python и Jupyter: практический сценарий
Интеграцию с Python можно рассмотреть как единый лабораторный конструкт: импортировать DuckDB, подключиться к локальной среде и выполнять SQL-запросы над Parquet. Это позволяет построить повторяемый и документируемый процесс аналитики, где каждый шаг соответствует этапам проекта: загрузка данных, фильтрация, агрегации, визуализация результатов.
- Приведение одного или нескольких Parquet-файлов в виде таблицы DuckDB упрощает дальнейший SQL-аналитический анализ.
- Включение EXPLAIN ANALYZE позволяет студентам увидеть реальный план выполнения и понять влияние архитектуры на производительность.
Практические лабораторные проекты
Данная секция содержит набор лабораторных проектов, направленных на освоение ключевых концепций DuckDB, работу с Parquet и построение аналитики на локальных данных. Каждый проект включает цель, входные данные, пошаговую инструкцию и ожидаемые результаты.
Лаборатория 1. Быстрый старт с Parquet и базовой аналитикой
Цель проекта - освоить базовый цикл загрузки Parquet-данных, создание представления и выполнение первых аналитических запросов. Это позволяет закрепить базовые навыки работы с DuckDB и Parquet.
- Подготовка данных: на диске размещаются несколько Parquet-файлов, образующих набор продаж, заказов или аналогичный набор для OLAP-аналитики.
- Шаги:
- Подключение к DuckDB и создание таблицы из Parquet:
SELECT * FROM read_parquet('data/parquet/sales/');
- Подключение к DuckDB и создание таблицы из Parquet:
-
Создание представления и базовая агрегация:
CREATE VIEW daily_sales AS SELECT order_date, SUM(amount) AS total_amount FROM read_parquet('data/parquet/sales/') ## GROUP BY order_date; -
Выполнение запроса по дням и регионам:
SELECT region, SUM(total_amount) FROM daily_sales GROUP BY region ORDER BY SUM(total_amount) DESC;
- Ожидаемый результат: конкурентная производительность на локальном наборе данных, корректные агрегаты и представление для дальнейшей визуализации.
Лаборатория 2. Аналитика: EXPLAIN и EXPLAIN ANALYZE
Цель проекта - научиться анализировать планы выполнения и понимать влияние архитектурных решений на производительность.
- Шаги:
- Выполнить EXPLAIN над базовым запросом агрегации:
EXPLAIN SELECT region, SUM(amount) FROM daily_sales GROUP BY region;
- Выполнить EXPLAIN над базовым запросом агрегации:
- Выполнить EXPLAIN ANALYZE того же запроса и интерпретировать вывод: какие шаги планирования и драиверы используются, где возникают задержки.
- Применить оптимизации: выбрать нужные столбцы, применить фильтрацию до агрегации и сравнить результаты.
- Ожидаемый результат: понимание разных планов выполнения и способность выбирать оптимизацию на уровне запроса и схемы хранения.
Лаборатория 3. Векторизация и большие наборы данных
Цель проекта - исследовать влияние размера набора и количества столбцов на производительность благодаря векторизованному исполнению DuckDB.
- Шаги:
- Увеличить объём анализа, добавив дополнительные столбцы и более продолжительную временную шкалу.
- Выполнить серию запросов, двух - с использованием фильтра по дате и без фильтрации, и сравнить время выполнения.
- Изучить влияние столбцового чтения и фильтрации на время подготовки данных.
- Ожидаемый результат: демонстрация преимуществ векторизации и столбцового чтения в сценариях с большим объемом данных.
Лаборатория 4. Интеграция с Python и Notebook: ETL и аналитика
Цель проекта - освоение интеграции DuckDB в реальном окружении разработки и демонстрация практики анализа данных в ноутбуке.
- Шаги:
- ПодключениеDuckDB через Python и загрузка Parquet-данных в таблицу DuckDB.
- Выполнение ETL-процессов: очистка и переработка данных, создание денормализованных представлений.
- Реализация аналитики и визуализации результатов через Python-библиотеки (например, matplotlib или seaborn) на основе SQL-вычислений.
- Ожидаемый результат: повторяемый ноутбук с демонстрацией ETL и аналитики на локальных данных.
Лаборатория 5. Управление ресурсами и производительностью
Цель проекта - понять, как конфигурация DuckDB влияет на производительность и какие практики управления ресурсами применимы в реальных проектах.
- Шаги:
- Эксперименты с количеством потоков и ограничением памяти:
PRAGMA threads=4; PRAGMA memory_limit='4GB';
- Эксперименты с количеством потоков и ограничением памяти:
- Анализ поведения при ограниченной памяти и подпроцессорной памяти: наблюдать частично выгрузку результатов, использование временных файлов.
- Сравнение производительности до и после изменения конфигурации и рекомендации по выбору параметров.
- Ожидаемый результат: набор рекомендаций по конфигурации DuckDB под конкретные условия проекта и аппаратного обеспечения.
Подробности лабораторной реализации и практические примеры
Данный раздел содержит ориентиры по реализации лабораторных задач, включая конкретные SQL-запросы, подходы к настройке окружения и типовые паттерны анализа. Важно уделять внимание не только тому, что делает запрос, но и почему именно такой план выполнения выбирается планировщиком DuckDB. Понимание архитектуры способствует более эффективной постановке задач и диагностике проблем в реальных проектах.
- Фазы подготовки: загрузка данных в Parquet, создание индексов (в DuckDB индексы не создаются так же, как в традиционных РСУБД, но применяются методы оптимизации и планировщик), выбор формата хранения и настройка окружения.
- Фазы анализа: выбор запросов и использование EXPLAIN/EXPLAIN ANALYZE для верификации планов, оптимизация запросов путем выбора нужных столбцов и фильтрации данных.
- Фазы внедрения: переход в реальное приложение или ноутбук, создание повторяемых рабочих процессов, документирование шагов.
-- Пример последовательности, демонстрирующей лабораторный подход
-- 1) Загрузка данных и создание представления
## CREATE VIEW v_sales AS
SELECT region, order_date, SUM(amount) AS total_amount
FROM read_parquet('data/parquet/sales/')
GROUP BY region, order_date;

-- 2) Аналитика по регионам
SELECT region, SUM(total_amount) AS region_total
FROM v_sales
GROUP BY region
ORDER BY region_total DESC
LIMIT 10;

-- 3) Инспекция плана выполнения
## EXPLAIN ANALYZE
SELECT region, SUM(total_amount) AS region_total
FROM v_sales
GROUP BY region
ORDER BY region_total DESC
LIMIT 10;
Валидация и производительность: принципы и практики
Эффективная лабораторная работа предусматривает не только получение корректных результатов, но и оценку производительности. В рамках главы следует подчеркнуть:
- Верификация корректности. Для каждого лабораторного проекта важно документировать ожидаемые результаты и сравнивать их с фактическими данными. Это включает проверку агрегаций, группировок и оконных функций на тестовом наборе данных.
- Производительность и масштабируемость. Измерение времени выполнения, потребления памяти и количества затронутых столбцов. В лабораторной среде полезно варьировать размер данных, количество параллельных потоков и лимиты памяти, чтобы понять, как эти факторы влияют на результаты.
- Диагностика. EXPLAIN и EXPLAIN ANALYZE служат основными инструментами для диагностики. Умение читать вывод плана выполнения позволяет выявлять узкие места и подсказывать варианты оптимизации.
- Надежность и повторяемость. Рекомендуется закреплять лабораторные задачи в виде ноутбуков или скриптов, чтобы участники могли повторно воспроизводить результаты и проверять изменения между версиями DuckDB или между различными окружениями.
Key takeaways
- DuckDB - это встраиваемая аналитическая база данных, которая отлично подходит для локальной аналитики и работы с Parquet без необходимости выделенного сервера.
- Архитектура DuckDB сочетает векторизированное выполнение, столбцовое хранилище и нативную интеграцию Parquet, что обеспечивает высокую производительность на локальных наборах данных.
- Предикатный пушдаун и столбцовая выборка в Parquet позволяют существенно снизить I/O и ускорить анализ больших наборов данных.
- Лабораторные проекты дают практическое понимание архитектуры: от анализа планов выполнения до интеграции с Python и ноутбуками.
- Внедрение DuckDB в прикладные сценарии требует внимания к ресурсам (потоки, память) и конфигурации окружения.
- EXPLAIN и EXPLAIN ANALYZE - ключевые инструменты для понимания плана выполнения и для стратегий оптимизации запросов.
- Эффективная работа с Parquet в DuckDB достигается через выбор столбцов, фильтры на уровне чтения и правильную компоновку запросов.
FAQ
- Что такое DuckDB и чем она отличается от классических СУБД?
DuckDB - это встроенная аналитическая база данных, оптимизированная для локальной обработки больших объемов данных в столбцовом формате. Она не требует отдельного сервера и выполняется в рамках одного процесса, что упрощает развёртывание и интеграцию в аналитическую цепочку. Основное отличие - ориентированность на OLAP-аналитику на локальных данных с поддержкой Parquet, векторизированного исполнения и высокой пропускной способности при чтении столбцов.
- Как начать работу с Parquet в DuckDB?
Чтобы работать с Parquet, достаточно указать путь к файлам Parquet в запросах DuckDB. DuckDB читает Parquet «на лету», применяет фильтры и выбирает необходимые столбцы, используя predicate pushdown и column pruning. Это позволяет выполнять аналитические запросы без предварительной конвертации данных и с эффективной загрузкой.
- Как использовать DuckDB из Python или Jupyter?
DuckDB предоставляет Python API, который позволяет подключаться к локальной инстанции и выполнять SQL-запросы над Parquet-файлами или уже загруженными данными. В ноутбуках это позволяет комбинировать SQL-аналитику и визуализацию в одном окружении, а также строить повторяемые аналитические пайплайны.
- Что такое EXPLAIN и EXPLAIN ANALYZE в DuckDB и зачем они нужны?
EXPLAIN показывает план выполнения запроса, включая используемые физические операторы и порядок их применения. EXPLAIN ANALYZE выполняет запрос и предоставляет фактические метрики исполнения, что позволяет сравнивать теоретический план и реальное поведение. Это важнейшие инструменты для оптимизации запросов в лабораторной среде.
- Какие ограничения по ресурсам у DuckDB?
DuckDB позволяет настраивать количество потоков и память, используя PRAGMA команды. В лабораторной и продакшн-среде эти параметры следует подбирать под объем данных и доступную аппаратную платформу, чтобы обеспечить баланс между временем выполнения и потреблением ресурсов.
- Как выбрать стратегию чтения Parquet: полностью против выборочно?**
Выбор зависит от целей: если запросы затрагивают только небольшое число столбцов, столбцовый подход и pruning дают существенную экономию I/O. При необходимости чтения большого числа столбцов или сложной агрегации может быть целесообразно загрузить данные в виде представления и выполнять вычисления в памяти DuckDB.
- Можно ли использовать DuckDB вместе с другими инструментами аналитики?
Да. DuckDB хорошо сочетается с Python, R и Jupyter, а также может служить источником данных для BI-инструментов через SQL-подключения внутри приложения. Это делает DuckDB удобным компонентом в стеке цифровой трансформации на локальном уровне.
- Как проверить корректность аналитики после изменений в конфигурации?
Используйте те же наборы тестовых запросов и сравните результаты с ожидаемыми значениями. Кроме того, применяйте EXPLAIN ANALYZE, чтобы увидеть влияние внесённых изменений на план выполнения и время выполнения.
- Какие сценарии внедрения типично применяются в корпоративных проектах?
Типичные сценарии включают локальную аналитическую обработку больших Parquet-данных, внедрение DuckDB в пайплайны ETL и notebooks для исследовательской аналитики, а также интеграцию в прикладные сервисы, где требуется быстрый доступ к локальным данным без развёртывания полноценного сервера БД.
- Что делать, если данные слишком велики для локальной памяти?
DuckDB поддерживает чтение данных по частям и эффективное управление памятью. При работе с очень крупными наборами данных следует применить фильтры до агрегации и, при необходимости, использовать последовательное чтение файлов Parquet вместе с режимами потоков и лимитами памяти, чтобы предотвратить переполнение.
- Можно ли сравнить DuckDB с другими инструментами OLAP?
DuckDB ориентирован на локальную аналитику и встраиваемость, что делает его уникальным среди подобных инструментов. В лабораторной практике можно сравнивать производительность между DuckDB и альтернативами в контексте чтения Parquet, агрегаций и использования оконных функций, но основное преимущество DuckDB - простота развёртывания и минимальные зависимости для локального анализа.
- Как документировать лабораторные проекты и делиться результатами?
Рекомендуется сохранять ноутбуки, скрипты и результаты в репозитории, соотнося шаги экспериментов с конкретными вопросами исследования. В конце главы можно приводить короткие отчеты по каждому лабораторному проекту, включая планы выполнения, конфигурацию окружения, ключевые результаты и ссылки на примеры кода.


