

Выборочное удаление столбцов для повышения эффективности хранения в озерах данных (Apache Parquet)
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Сивцов Данил @svtDanny
Введение
По мере роста Uber объем обрабатываемых данных и количество обращений к ним многократно возросли. Такое быстрое увеличение объема привело к росту затрат на хранение и вычислительные ресурсы. В результате мы столкнулись с различными проблемами, такими как повышенные требования к железу, увеличившееся потребление ресурсов, а также проблемами с производительностью из-за ошибок наподобие OOM (out-of-memory) и длительных пауз на сборку мусора.
Для решения проблем было реализовано несколько инициатив, такие как: внедрение TTL (Time to Live) политик для партиций, внедрение многослойного хранилища с стратегиями для перераспределения данных из “hot”/”warm” до “cold” уровней хранения, а также оптимизации форматов хранения данных. В данной статье фокус будет на последней оптимизации - как сократить размер данных в рамках формата Apache Parquet за счет удаления не использующихся колонок большого размера.
Создавая новые таблицы, разработчики могут самостоятельно определять схему данных и колонки без строгого контроля. Однако часто случается, что некоторые столбцы матриц не используются, что приводит к избыточному размещению значительного объема данных. Благодаря тщательному анализу, мы смогли сэкономить существенный объем хранилища на большом масштабе просто удалив неиспользуемые столбцы из некоторых таблиц.
Введение в Apache Parquet
Apache Parquet является нашим основным форматом данных для хранения в data lake, поэтому функционал удаления неиспользуемых колонок реализован для него
Apache Parquet - колоночный формат данных, поэтому данные в рамках таблицы, принадлежащие одному столбцу, храняться вместе в рамках чанка колонки. Следующая диаграмма иллюстрирует сравнение между строчными и колоночными форматами. В исходной таблице 4 колонки, каждая их которых содержит 4 записи.
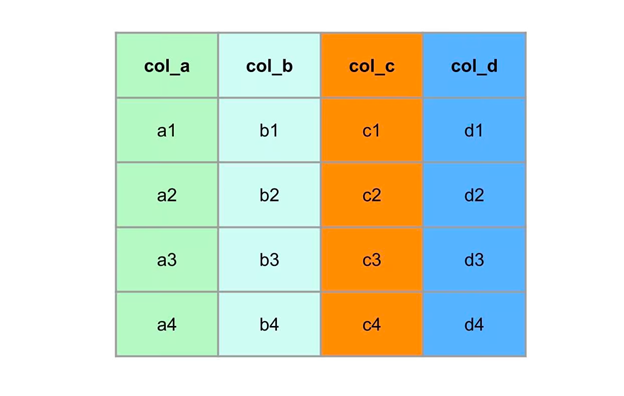
Логическое представление таблицы
В строчных базах данных таблица хранится строка за строкой
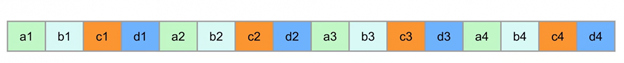
Строчное представление на диске или при передачи по сети
В колоночных базах данных каждый столбец хранится целиком

Колоночное представление на диске или при передачи по сети
Внутри Apache Parquet данные собираются в группы строк. Каждая группа содержит один или несколько колоночных чанков, каждый из которых сопоставлен одному столбцу в наборе данных. Данные в каждом чанке хранятся в виде страниц. Блок состоит из страниц и представляет собой наименьший юнит чтения для доступа до одной записи. В рамках каждой страницы (только если не используется dictionary encoding) к каждому полю добавляется его значение, уровень повторения и уровень определения.
Следующая картинка изображает структуру Parquet файла. Более подробно - в официальной документации формата файла Parquet.
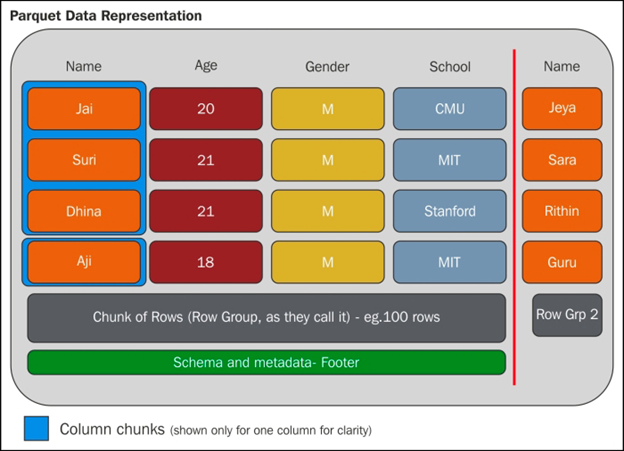
Схема устройства Parquet файла
Возможное решение
Чтобы удалить выбранные столбцы из существующей таблицы данных можно использовать Spark: считать данные, удалить колонки, записать обратно модифицированный набор. Рассмотрим, однако, как происходит изменение Parquet файла, предполагая, что мы не производим перемешивание данных между файлами, так как эта операция дорога из-за требований к дополнительным ресурсам.
Шаги для изменения Parquet файла включают в себя расшифровку, распаковку, декодирование и парсинг записи на этапе чтения. Данные операции необходимы для доступа и обработки данных в рамках файла. Аналогично, в рамках записи в хранилище стадии включают в себя сборку записи, кодирование, сжатие и шифрование для подготовки данных к хранению. Важно отметить, что эти шаги вычислительно затратны и значительно увеличивают время, необходимое для чтения и записи Parquet файлов. Ресурсоемкость данных операций может повлиять на общую производительность и эффективность, что приводит к необходимости иметь более эффективное решение для удаления колонок в обход данных шагов.
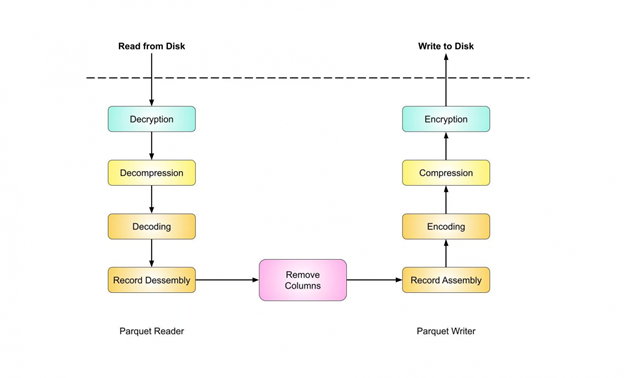
Процесс преобразования файла Parquet для удаления колонки с расписанными фазами чтения и записи
Для оптимизации процесса необходимо найти метод, минимизирующий использование дорогостоящих шагов чтения и записи, упомянутых выше. Таким образом, мы могли бы сократить вычислительные издержки и улучшить общую производительность удаления колонок в Parquet файлах. Эта оптимизация стала бы еще полезнее при работе с большими наборами данных, где влияние издержек кратно возрастает. Поиск оптимизированного подхода для выборочного удаления столбцов мог бы значительно увеличить эффективность и скорость обработки.
Cелективное удаление колонок
Поскольку Parquet представляет собой столбчатый формат файла и данные в одном столбце хранятся вместе, вместо выполнения дорогостоящих шагов, описанных выше, мы можем просто скопировать исходные данные для определенного столбца и сохранить их обратно на диск, минуя эти шаги. Столбцы, которые необходимо удалить, при таком подходе можно просто пропустить, и перейти к следующему, не требующему удаления, столбцу. В конце данной операции мы изменим смещения чанков, поэтому необходимо обновить метаданные и записать туда новые, актуальные смещения. При таком подходе вообще отсутствует перемешивание данных. Данные исходного файла будут скопированы в новый кроме данных в столбцах, подлежащих удалению.
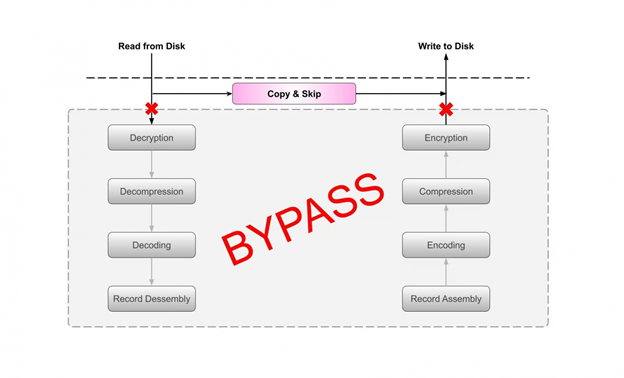
Оптимизированный процесс удаления колонок
Рассмотрим “Copy & Skip” процесс на примере. Предположим, необходимо удалить колонки “col_b” и “col_c”. Гибридный читатель/писатель начинает с копирования ”col_a” и минует дорогие стадии шифрования, сжатия, кодирования и так далее. Вместо это мы напрямую побайтово копируем данные. При обработке “col_b” и “col_c” мы просто их минуем. Далее переходим колонке “col_d” и копируем ее. В конце новый файл содержит данные двух столбцов ”col_a” и “col_d” и исключает столбцы “col_b” и “col_c”.
Из приведенного выше “Copy & Skip” процесса мы видим значительное улучшение за счет обхода дорогостоящих этапов. Стоит отметить, что перемешивать данные не потребуется, что может стать еще одним существенным улучшением, поскольку данная операция также очень дорогостоящая.
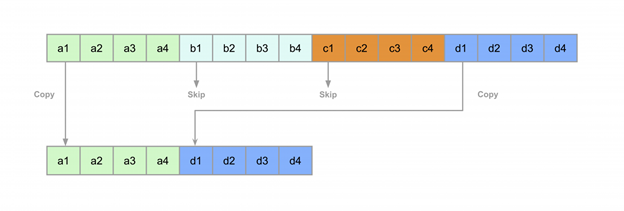
Визуализация работы Copy & Skip
Бенчмаркинг
У нас есть замеры производительности с локальным сервером для чтения данных с размерами 1Gb, 100Mb и 1Mb. Для сравнения мы используем обработку через Apache Spark в качестве бейзлайна. Из приведенной ниже диаграммы видно, что наш селективный прунер в ~27 раз быстрее при размере файла ~1Gb и в ~9 раз быстрее при размере файла 1Mb.
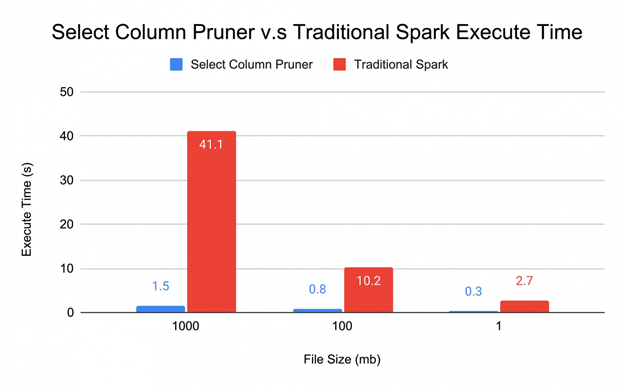
Сравнение оптимизированного алгоритма с Spark
Распределение вычислений
До сих пор мы обсуждали оптимизацию обработки одного файла, которая является основой для сокращения количества столбцов в наборе данных. В реальности, датасет организован в виде набора таблиц и иногда далее разделен на партиции, которые обычно имеют несколько файлов. Нам нужен механизм выполнения для распараллеливания удаления столбцов. Apache Spark - широко используемый движок для распределенного выполнения задач. Немного может сбивать с толку, что ранее мы использовали Spark для удаления колонок напрямую. Здесь мы просто используем ядро Spark для распараллеливания вычислений, вместо полагания на работу с коннекторами данных.
Пример кода:
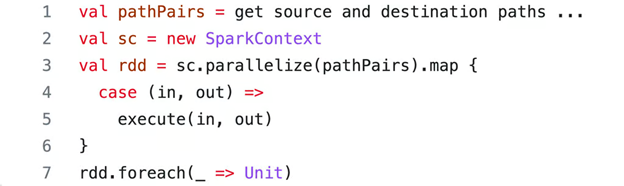
Во время выполнения мы, как правило, имеем дело с набором данных как единицей обработки. Для каждого набора данных мы обходим все разделы, если это партиционированная таблица, и в рамках каждой партиции обходим все ее файлы, назначая каждому файлу задачу по удалению столбцов с помощью алгоритма, который мы обсуждали выше. Снимок набора данных можно описать следующим образом:
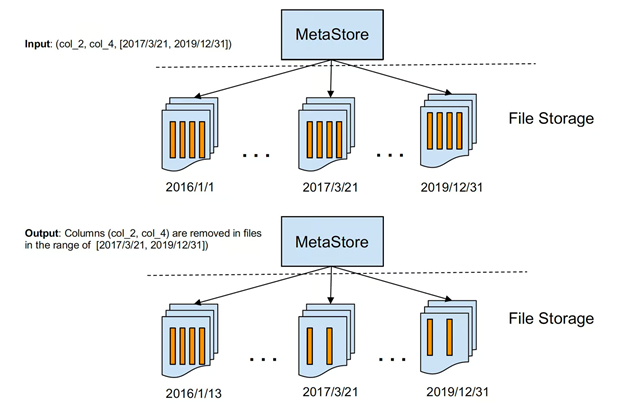
Визуализция набора данных до/после работы алгоритма
Заключение
Таким образом, наш подход к селективному удалению столбцов в файловом формате Parquet показал себя высокоэффективным решением для оптимизации хранения данных. Устраняя неиспользуемые столбцы, мы можем снизить затраты на их хранение, свести к минимуму потребление ресурсов и повысить общую производительность системы. Поскольку Uber продолжает развиваться, мы по прежнему стремимся изучать инновационные способы улучшения методов управления данными и максимизации ценности наших информационных активов при минимизации затрат на инфраструктуру.
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Сивцов Данил @svtDanny


