

Data Mesh: топологии и гранулярность домена
Прошедший год в Microsoft был, мягко говоря, интересным! Я принял участие в огромном количестве встреч с клиентами, семинарах и сессиях по проектированию архитектуры данных. Самой «жаркой» темой была data mesh.
Итак, data mesh - тема относительно новая. По сути, это концепция, которая должна формироваться с учетом требований компаний к вопросам владения, организации и безопасности данных, а также учитывать передовые технологии и стратегии по управлению затратами. Сбалансировать все эти потребности нелегко, поэтому компании выбирают общую архитектуру, удовлетворяющую большую часть запросов.
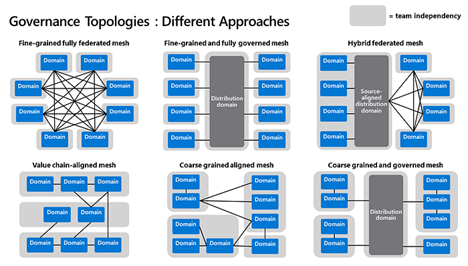
В этой статье я хотел бы поговорить с Вами о различных архитектурных паттернах и соображениях, которые необходимо учитывать при выборе каждого из них. Я объясню Вам, что именно движет компаниями при выборе того или иного паттерна.
Сценарий 1: мелкозернистая, полностью федеративная data-mesh
Первый паттерн проектирования - это то, как Жамак Дахгани описывает data mesh в ее изначальной теоретической форме. Она является мелкомасштабной, высокофедеративной и использует множество небольших и независимых развертываемых компонентов. На рисунке ниже показан абстрактный пример такой архитектуры.
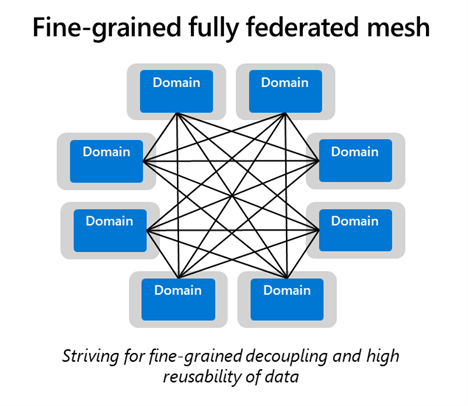
В приведенной выше модели распределение данных происходит по принципу "равный-равному", а все метаданные, связанные с управлением, логически централизованы. Данные в этой топологии принадлежат каждому отдельному домену, управляются им и используются совместно. Домены остаются гибкими и не зависят от центральной команды в вопросах координации и распределения данных.
В мелкозернистой и полностью федеративной топологии каждый продукт данных рассматривается как архитектурный квант. Проще говоря, это означает, что Вы можете создавать множество различных архитектур небольших продуктов данных для обслуживания и передачи данных между доменами. Изображение того, как это работает, Вы найдете ниже.
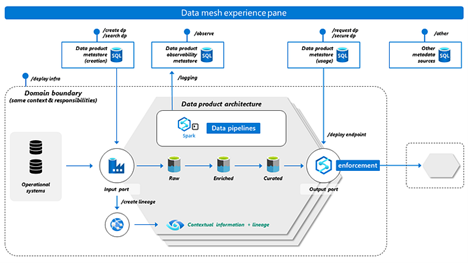
Мелкомасштабная и полностью федеративная сетка обеспечивает узкую специализацию доменов. Она обеспечивает организационную гибкость и меньшее количество зависимостей, поскольку взаимодействие происходит по принципу "многие-ко-многим". Наконец, она способствует интенсивному повторному использованию данных. Каждый продукт данных становится архитектурным квантом.
Хотя подобная топология на первый взгляд и выглядит идеально, при более глубоком рассмотрении у многих компаний небезосновательно возникают определенные опасения. Во-первых, топология требует согласования со всеми доменами в плане совместимости, метаданных, управления и стандартов безопасности. Процесс стандартизации по этим параметрам не происходит спонтанно. Это достаточно сложный процесс, требующий преодоления многочисленных границ. Он требует того, чтобы Ваша архитектура и способ организации работы прошли через различные этапы: предварительную концептуализацию, концептуализацию, обсуждение, написание и внедрение. Кроме того, Вам необходимо заручиться поддержкой со стороны широкой аудитории.
Во-вторых, компании опасаются дублирования возможностей и чрезмерно интенсивного использования сети. Многие архитектуры продуктов данных требуют большого количества ресурсов инфраструктуры, что может сделать Вашу архитектуру слишком дорогостоящей. Гранулярность архитектур продуктов данных также становится проблематичной при интенсивном выполнении междоменного поиска данных и проверке их качества. Притяжение данных и децентрализация, к сожалению, не идут рука об руку.
Мелкозернистая полностью федеративная сетка - выбор отличный, но труднодостижимый. Я часто вижу такую топологию в компаниях, которые «родились» в облаке, работают сразу с несколькими облаками, относительно молоды и имеют в своем распоряжении много высококвалифицированных инженеров-программистов.
Сценарий 2: Мелкозернистая и полностью управляемая сетка
Чтобы нивелировать проблемы федеративной сетки, многие компании корректируют предыдущую топологию, добавляя центральный уровень распространения. Хотя эта топология и не реализует архитектуру data mesh в полной мере, но все же она придерживается многих ее принципов: каждый домен имеет четкие границы и автономное право собственности на собственные приложения и продукты данных, однако эти продукты данных должны распространяться через центральную логическую структуру.
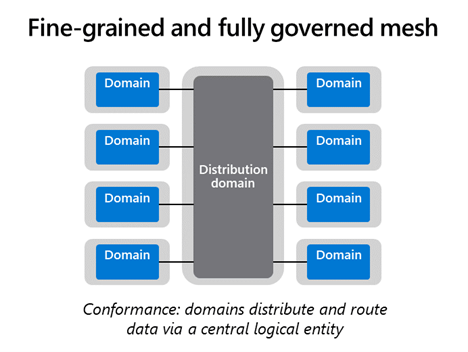
Топология, представленная выше, решает некоторые проблемы, наблюдаемые в мелкозернистой полностью федеративной сетке. В частности, она работает с трудностями распределения данных и гравитации. Доменам не нужно распределять большие исторические наборы данных, поскольку данные хранятся в более тесном контакте на общем уровне хранения.
Многие компании также считают, что подобная топология легче решает проблемы конформации. Например, можно заблокировать распространение или потребление данных, обеспечить доставку метаданных или настроить определенный способ работы. Схема с несколькими рабочими пространствами и общим озером - это лучшая из возможных практик. Домены управляют и создают продукты данных в своих собственных рабочих пространствах, но распространение среди других доменов происходит через центральный уровень хранения с использованием специфических для домена контейнеров.
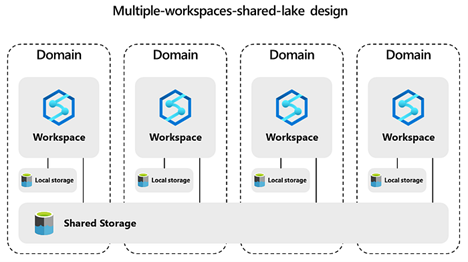
Помимо централизованного уровня хранения я также довольно часто встречаю централизованно управляемые вычислительные услуги. Например, преобразования, специфичные для каждого домена, применяются внутри домена с использованием выделенных вычислительных ресурсов, а обработка исторических данных выполняется централизованно с использованием общих пулов вычислительных ресурсов. Такой подход значительно снижает затраты.
Также помимо всего прочего следует принять во внимание и более сильную централизацию и конформацию данной топологии. А это неразрывно связано с увеличением времени выхода на рынок и усиление связи между доменами. Кроме того, я считаю, что эту топологию будет достаточно сложно реализовать в мультиоблачных средах, поскольку она требует разработки центрального и распределенного логического объекта, который будет беспрепятственно перемещать данные, соблюдая все стандарты управления. Реализовать это с помощью облачных стандартов довольно трудно, учитывая характер того, что сегодня предлагают поставщики облачных решений.
Тем не менее я вижу, что многие компании выбирают именно эту топологию. Как правило, это финансовые учреждения и государственные органы, а также другие компании, для которых качество данных и соответствие высоким стандартам намного важнее оперативности.
Сценарий 3: Гибридная федеративная data mesh
Далеко не все компании могут похвастаться наличием большого количества высококвалифицированных инженеров-программистов. Многие организации довольствуются устаревшими унаследованными системами, которые достаточно трудно поддерживать. Компании, относящиеся к этим категориям, часто внедряют data mesh подобную тому, что можно увидеть на рисунке ниже.
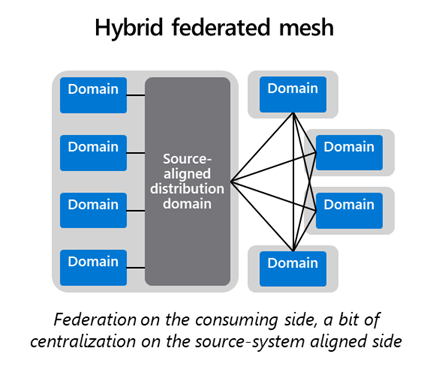
Что же отличает эту топологию от других топологий? Здесь меньше федерации и больше централизации. Существует менталитет управления продуктами данных, но есть центральный экземпляр платформы, на которой поддерживаются и создаются продукты данных. Иногда, в ситуациях, когда команда домена не обладает необходимыми навыками или ресурсами, ответственность за продукты данных берет на себя команда поддержки или платформы.
В случае с потребляемыми данными обычно наблюдается более высокая степень автономии и распределение по типу mesh. Разные команды могут работать над различными сценариями использования и нести ответственность за свои преобразованные данные и аналитические приложения. Готовые или вновь созданные продукты данных распространяются между пользователями или возвращаются в центральную платформу.
Для этой топологии характерна повышенная нагрузка на домены, связанные с исходными системами, поскольку их, скорее всего, будет обслуживать центральная команда. Организации, использующие эту архитектуру, скорее всего, будут «страдать» от использования различных операционных моделей и более сложных руководств и принципов. Кроме того, могут возникнуть противоречивые правила распределения данных, поскольку потребляющие домены часто становятся предоставляющими доменами.
Сценарий 4: Сетка, ориентированная на цепочку создания стоимости
Организации, специализирующиеся на управлении цепочками поставок, разработке продукции или транспортировке, фокусируются на эффективности цепочек создания стоимости. Что же характеризует все эти компании? А то, что всем им требуется гиперспециализация или выравнивание потоков для создания ценности для своих клиентов. Такие цепочки создания стоимости тесно взаимосвязаны. Кроме того, они, как правило, обрабатывают данные в прямом и обратном направлении: от операционных к аналитическим и обратно к операционным.
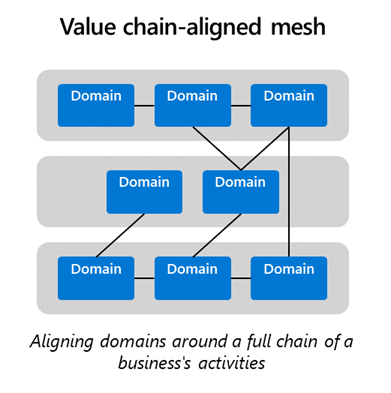
В этой структуре цепочка создания стоимости рассматривается как группа небольших доменов, тесно взаимодействующих друг с другом. Подобные цепочки создания ценности требуют более высокого уровня автономии и поэтому могут рассматриваться как более крупные домены. В такой топологии различают продукты данных внутри домена и продукты данных между доменами. Только при пересечении границ цепочки создания ценности соблюдаются центральные стандарты. Можно также разрешить или смешать различные типы моделей управления: строгое соблюдение стандартов в одном домене - ослабленный контроль в других доменах.
При использовании цепочек создания стоимости следует также учитывать и тот факт, что эта модель требует более четкого руководства со стороны архитекторов, поскольку границы могут быть не всегда явными.
Сценарий 5: Крупнозернистая выровненная data mesh
Некоторые организации добились успеха путем органического роста, слияний и поглощений. Такие организации, как правило, имеют сложные ландшафты с сотнями или тысячами приложений и систем. Внутри этих сложных структур существуют различные уровни управления, согласования и декомпозиции. Некоторые структуры могут быть самостоятельными и функционировать автономно, в то время как другие являются более интегрированными.
Структуры, наблюдаемые в подобных крупных организациях, как правило, довольно масштабные. Домены, как правило, содержат десятки или сотни приложений. Такая топология представляет собой то, что я считаю крупнозернистой выровненной сеткой.
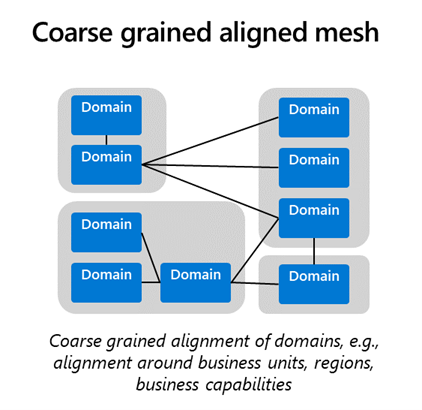
Основная сложность такой топологии заключается в том, что ее границы не всегда четко определены. Чаще всего границы доменов основываются на организационных или региональных аспектах, которые являются относительно крупными. Это может привести к политическим распрям по поводу того, кто именно контролирует данные и какой суверенитет им требуется.
Еще одна проблема, связанная с данной топологией, - это дублирование возможностей. Вполне вероятно, что каждый крупнозернистый домен использует собственную платформу данных для получения, преобразования и распространения данных. Такой подход к внедрению множества платформ для крупных доменов приводит к дублированию возможностей. Например, управление качеством данных и управление основными данными, скорее всего, необходимо в масштабах всего предприятия. Такой федеративный подход может привести к многочисленным реализациям вопроса управления качеством данных и основными данными на всех платформах данных. Для обеспечения последовательного внедрения этих служб на всех платформах требуется тесное сотрудничество и четкое руководство. Чем крупнее Ваша организация, тем сложнее это сделать.
Такой многоплатформенный подход часто порождает множество вопросов: Как откалибровать платформы данных и домены? Могут ли крупные домены совместно использовать платформу данных? Как справиться с перекрывающимися требованиями к данным, когда одни и те же данные требуются на разных платформах? Как эффективно распределить данные между этими большими доменами и экземплярами платформ? Хорошей отправной точкой в данном случае является правильная декомпозиция домена Вашей организации перед непосредственным внедрением data mesh. Продолжайте устанавливать права собственности на приложения и данные. Кроме того, продолжайте разрабатывать четкие рекомендации по созданию продуктов данных.
Данная топология характеризуется более высоким уровнем автономии и, следовательно, нуждается в более жесткой политике управления и широких возможностях платформы самообслуживания данных. Например, регистрация и обеспечение возможности обнаружения продукта данных может потребовать специальных указаний, основанных на технологиях и возможностях взаимодействия, выбранных доменами. В противном случае может ухудшиться видимость между платформами или возрасти затраты, связанные с распространением доменов.
Крупнозернистая автономия противоречит истинной реализации data mesh, что создает риск того, что данные будут объединены и интегрированы до того, как будут распространены продукты данных. Возникает риск создания слишком больших монолитов. Такие крупные монолиты создают дополнительные связи между системами и вносят путаницу в права собственности на данные, поскольку продукты данных распространяются с помощью систем-посредников, что значительно затрудняет определение фактического источника их происхождения. В целяж минимизации этих рисков следует внедрить такие принципы, как сбор исключительно уникальных данных или сбор данных непосредственно из источника с использованием его уникального доменного контекста.
Сценарий 6: Крупнозернистая и управляемая data mesh
Некоторые крупные организации стремятся преодолеть одноранговое распределение и отклонения в совместимости путем создания центрального уровня распределения.
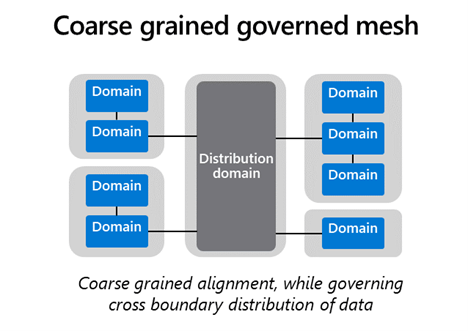
В этой топологии команды или организационные структуры договариваются о платформе распространения или рынке, через который можно публиковать и потреблять продукты данных. Данная топология обладает некоторыми характеристиками топологии управляемой сетки данных, такими как решение проблем, связанных с изменчивостью во времени и энергонезависимостью.
Все «крупнозернистые» подходы, как и предыдущий сценарий, требуют высокой зрелости команды платформы данных. Все компоненты должны быть самообслуживаемыми и хорошо интегрироваться между центральным уровнем распределения и доменными платформами. Управление метаданными, стандарты и политики управления имеют решающее значение
Заключение
Data mesh - это самый настоящий прорыв, который может полностью переосмыслить значение управления данными для организаций. Вместо того чтобы централизованно управлять всеми областями управления данными, Ваша центральная команда становится ответственной за определение того, что представляет собой эффективное управление данными и что является платформой самообслуживания данных.
При переходе к федерации компании идут на определенные компромиссы. Одни организации предпочитают высокую степень автономии, другие - качество данных. Некоторые организации имеют относительно простую структуру, в то время как другие - невероятно большие и сложные. Создать идеальную архитектуру данных совсем не просто, поэтому рекомендую Вам рассматривать data mesh как основу Вашей стратегии. Здесь нет правильного или неправильного варианта. Data mesh характеризуется определенными принципами работы - некоторые из них могут Вам понравиться, а другие - нет. Поэтому смело внедряйте то, что больше всего подходит именно Вам.


