

Размерное моделирование и витрины данных по Кимбаллу
Неужели размерное моделирование безнадежно устарело?
Прежде чем ответить на этот вопрос, предлагаю сделать шаг назад и посмотреть, что именно мы понимаем под моделированием размерных данных.
Зачем нужно моделировать данные?
Вопреки распространенному мнению, модели данных служат не только для того, чтобы служить ER-диаграммой для проектирования физической базы данных. Модели данных отражают всю сложность бизнес-процессов на предприятии. Они документируют важные бизнес-правила и концепции, а также помогают стандартизировать ключевую терминологию предприятия. Они обеспечивают ясность процессов и помогают выявить двусмысленность ключевых бизнес-процессов. Кроме того, модели данных можно использовать и для эффективного взаимодействия с другими заинтересованными сторонами. Вы не будете строить дом или мост без чертежа, не так ли? Так зачем Вам строить приложение для работы с данными, например хранилище данных, без четкого плана?
Для чего нужны размерные модели?
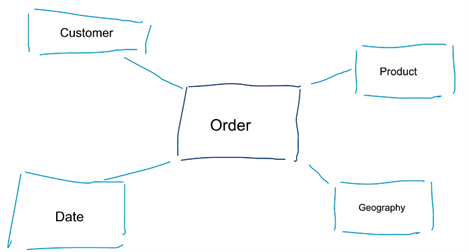
Размерное моделирование - это особый подход к моделированию данных. В качестве синонимов размерной модели мы также используем такие понятия, как витрина данных (data mart) или схема «звезда» (star schema, оптимизированная для аналитики данных. Взгляните на приведенную ниже размерную модель, она интуитивно понятна. Мы сразу видим, как можно «нарезать» данные о заказах по клиентам, продуктам или датам и оценить эффективность бизнес-процесса "Заказы", агрегируя и сравнивая ключевые метрики.
Одна из основных идей размерного моделирования заключается в определении самого низкого уровня детализации в транзакционном бизнес-процессе. Когда мы нарезаем данные на кусочки и углубляемся в них, это уровень листа, с которого мы не можем углубляться еще дальше. Другими словами, самый низкий уровень детализации в схеме «звезда» - это соединение факта со всеми таблицами измерений без каких-либо агрегаций.
Моделирование данных vs Размерное моделирование
При стандартном моделировании данных мы стремимся исключить повторение и избыточность данных. При изменении данных нам нужно изменить их только в одном месте. Это также способствует повышению качества данных. Взгляните на модель, представленную ниже. Она содержит различные таблицы, в которых представлены географические понятия. В нормализованной модели у нас есть отдельная таблица для каждой сущности. В размерной модели у нас только одна таблица: география. В этой таблице города будут повторяться несколько раз. По одному разу для каждого города. Если страна изменит свое название, нам придется обновлять ее во многих местах.
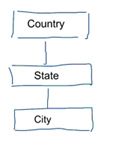
Примечание: Стандартное моделирование данных также называется 3NF-моделированием.
Стандартный подход к моделированию данных не подходит для задач бизнес-аналитики. Большое количество таблиц приводит к большому количеству соединений, замедляющих работу. В аналитике данных мы по возможности стараемся их избегать. В размерных моделях мы денормализуем несколько связанных таблиц в одну, например, несколько таблиц из нашего предыдущего примера могут быть предварительно объединены в одну таблицу: география.
Так почему же некоторые люди утверждают, что размерное моделирование умерло?
Думаю, Вы согласитесь, что моделирование данных в целом и размерное моделирование в частности - довольно полезное занятие. Так почему же некоторые люди утверждают, что размерное моделирование бесполезно в эпоху больших данных и Hadoop?
Как Вы понимаете, на это есть определенные причины.
Хранилища данных безнадежно устарели
Прежде всего, некоторые люди путают размерное моделирование с хранением данных. Они утверждают, что хранилища данных уже давно мертвы и, как следствие, размерное моделирование тоже можно отправить на свалку истории. Однако концепция хранилища данных не так уж и устарела. Нам всегда нужны интегрированные и надежные данные для наполнения наших BI-панелей.
Заблуждение, связанное со схемой на чтение (schema on read)
Второй аргумент, который я довольно часто слышу, звучит примерно так: "Мы придерживаемся подхода схемы на чтение, поэтому нам больше не нужно моделировать данные". На мой взгляд, концепция схемы на чтение - одно из самых больших заблуждений в аналитике данных. Я согласен с тем, что полезно хранить необработанные данные в дампе, который не содержит схем. Однако этот аргумент не должен использоваться как оправдание для полного отказа от моделирования данных. Подход с использованием схемы на чтение - это не что иное, как перекладывание ответственности на последующие процессы. Кто-то все равно должен будет определить типы данных. Каждый процесс, который обращается к дампу данных без схемы, должен самостоятельно разобраться в том, что происходит. Такая работа с течением времени накапливается и в результате превращается в «снежный ком», а ведь ее можно легко избежать, сразу определив типы данных и надлежащую схему.
Физические аспекты модели данных
Существуют ли веские аргументы в пользу того, чтобы объявить размерные модели окончательно устаревшими? На самом деле, есть и более веские аргументы, чем те два, которые я перечислил выше. Они требуют понимания физического моделирования данных и принципов работы Hadoop.
Ранее я вкратце упомянул одну из причин, по которой мы занимаемся моделированием наших данных. Это тесно связано с тем, как данные физически хранятся в нашем хранилище данных. При стандартном моделировании данных каждая сущность реального мира получает свою собственную таблицу. Мы делаем это для того, чтобы избежать избыточности данных и риска возникновения проблем с качеством данных. Чем больше таблиц, тем больше соединений нам нужно. В этом и заключается основной недостаток. Соединять таблицы дорого, особенно когда мы соединяем большое количество записей из наборов данных. Когда мы осуществляем размерное моделирование данных, мы объединяем сразу несколько таблиц в одну. Таким образом, у нас получается меньше таблиц, меньше соединений и, как следствие, меньше задержек - производительность запросов при этом гораздо выше.
Доведение денормализации до полного конца
Почему бы не довести денормализацию до полного конца - избавиться от всех объединений и прийти к одной единственной таблице? Действительно, такой вариант полностью устранит необходимость в каких-либо соединениях. Однако, у данного решения есть ряд серьезных «побочных эффектов». Прежде всего, это значительно увеличит объем т хранилища, так как нам нужно будет хранить много избыточных данных. С появлением колоночных форматов хранения для аналитики данных это уже не так актуально. Более серьезной проблемой полной денормализации является тот факт, что каждый раз при изменении значения одного из атрибутов нам нужно будет обновить его в нескольких местах - возможно, нам потребуется тысяча или даже миллионы обновлений. Один из способов решить эту проблему - полностью перезагружать наши модели каждую ночь, что гораздо быстрее и проще. Колоночные базы данных обычно используют следующий подход: сначала они хранят обновления данных в памяти и затем асинхронно записывают их на диск.
Распределение данных в распределенной реляционной базе данных (MPP)
При создании размерных моделей на Hadoop, например Hive, SparkSQL и т. д., нам необходимо хорошо разбираться в одной очень важной особенности технологии, которая отличает ее от распределенных реляционных баз данных, таких как Teradata. При распределении данных по узлам в MPP мы обладаем контролем над размещением записей. Основываясь на стратегии разбиения (например, хэш, список, диапазон и т. д.), мы можем разместить ключи отдельных записей в разных вкладках на одном узле. Благодаря гарантированной совместной локальности данных наши соединения будут выполняться очень быстро, поскольку нам не нужно передавать данные по сети. Взгляните на пример, представленный ниже. Записи с одинаковым ORDER_ID из таблиц ORDER и ORDER_ITEM окажутся на одном узле.
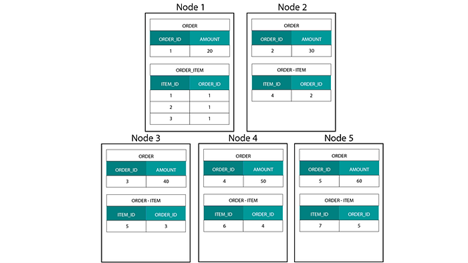
Распределение данных на Hadoop
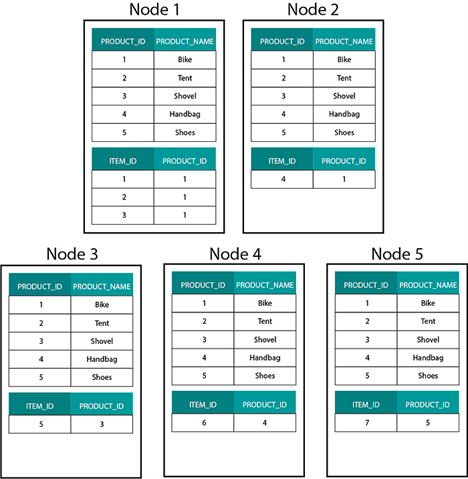
В этом состоит одно из ключевых отличий от систем на базе Hadoop, где мы разбиваем данные на большие «куски», распределяем и реплицируем их по узлам в распределенной файловой системе Hadoop (HDFS). При такой стратегии распределения данных мы не можем гарантировать их совместную локальность. Взгляните на пример ниже. Записи для ключа ORDER_ID - на разных узлах.
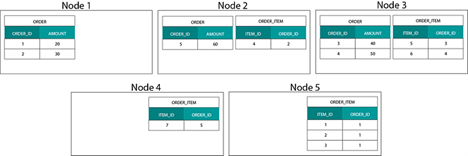
Для того, чтобы осуществить объединения, нам нужно будет отправить данные по сети, что неизбежно отразиться на производительности в целом.
Одна из стратегий решения этой проблемы заключается в репликации одной из таблиц объединения на все узлы кластера. Это называется широковещательным объединением, и мы используем эту же стратегию для MPP. Как Вы понимаете, она будет работать только для небольших таблиц поиска или измерений.
А что же делать, если у нас есть большая таблица фактов и большая таблица измерений, например, клиентов или продуктов? Или когда у нас есть две большие таблицы фактов?
Размерные модели в Hadoop
Как вариант, мы можем денормализовать большие таблицы размерностей в нашей таблице фактов, чтобы гарантировать совместное расположение данных, и затем транслировать таблицы меньшей размерности на все наши узлы.
Для объединения двух больших таблиц фактов мы можем вложить таблицу с меньшей степенью детализации в таблицу с большей степенью детализации, например, большую таблицу ORDER_ITEM вложить в таблицу ORDER. Современные движки запросов, такие как Impala или Drill, нам в помощь.
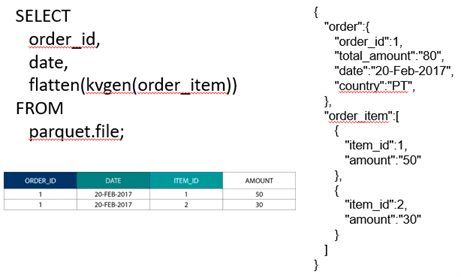
Эта стратегия вложения данных также полезна для сложных концепций Кимбалла, таких как связующие таблицы для представления отношений M:N в размерной модели.
Hadoop и медленно меняющиеся измерения
Хранение в файловой системе Hadoop является неизменяемым. Другими словами, Вы можете только вставлять и/или добавлять новые записи. Изменять данные нельзя. Если Вы работаете с реляционными хранилищами данных, то поначалу это может показаться немного странным. Однако, по большому счету, базы данных работают аналогичным образом: они хранят все изменения данных в неизменяемом журнале записей (известный в Oracle как redo log) до того, как процесс асинхронно обновит данные в файлах данных.
Какое влияние оказывает неизменяемость на наши размерные модели? Возможно, Вы помните концепцию медленно меняющихся измерений (SCDs) из курса моделирования размерностей. SCD по желанию сохраняют историю изменений атрибутов. Они позволяют нам составлять отчеты по метрикам на основе значения атрибута в определенный момент времени. Однако это не является функцией по умолчанию. По умолчанию мы обновляем таблицы измерений последними значениями. Так каковы же тогда наши возможности в Hadoop? Помните! Мы не можем обновлять данные. Мы можем просто сделать SCD процессом по умолчанию и проводить аудит любых изменений. Если мы хотим запускать отчеты по текущим значениям, мы можем создать представление поверх SCD, которое будет извлекать только последнее значение. Это можно легко сделать с помощью оконных функций. В качестве альтернативы можно запустить так называемую службу уплотнения, которая физически создает отдельную версию таблицы измерений только с последними значениями.
Эволюция хранения в Hadoop
Эти ограничения Hadoop не остались без внимания производителей платформ Hadoop. В Hive теперь есть ACID-транзакции и обновляемые таблицы. Но , похоже, эта функция до сих пор не работает должным образом . Компания Cloudera применила другой подход - с помощью Kudu они создали новый обновляемый формат хранения, который размещается не в HDFS, а в локальной файловой системе ОС. Он полностью очищен от ограничений Hadoop и больше похож на традиционный слой хранения в столбчатых MPP. Вообще, для любых BI и дашбордов лучше использовать MPP, например Impala + Kudu, чем Hadoop. При этом у MPP также есть свои ограничения, особенно когда речь идет об отказоустойчивости, параллелизме и масштабируемости. Как только Вы сталкиваетесь с этими аспектами, Hadoop и его близкий родственник Spark – к Вашим услугам. Мы подробно рассматриваем все эти ограничения в нашем учебном курсе «Big Data для профессионалов области хранения данных», где также даем подробные рекомендации по использованию СУБД или SQL в Hadoop/Spark.
Вердикт. Устарели ли размерные модели и схема «звезда»?
Мы все знаем, что Ральф Кимбалл давно ушел на пенсию. Но его основные идеи и концепции по-прежнему актуальны и продолжают жить. Нам приходится адаптировать их к новым технологиям и типам хранилищ, но они по-прежнему имеют свою ценность.


