

Описание файлов репозитория Superset версии 2.0.1
В этой статье будет кратко описано назначение директорий репозитория и также, приведено описание главных файлов в этом репозитории.
Обязательно советую прочитать статью Comprehensive Tutorial for Contributing Code to Apache Superset.
Обзор структуры репозитория Apache Superset
Архитектура репозитория Apache Superset имеет следующую структуру:
- docker: содержит файлы и скрипты, необходимые для развертывания Superset в контейнере Docker. В папке pythonpath_dev содержится файл superset_config.py, который позволяет настраивать параметры Superset вручную.
- helm: содержит файлы YAML и документацию для развертывания Superset на кластере Kubernetes (K8s) с помощью Helm, инструмента для управления пакетами приложений в Kubernetes.
- RELEASING: содержит инструкции для создания и выпуска новых версий Superset.
- requirements: содержит список зависимостей Python, сгенерированных с помощью инструмента pip-compile-multi.
- RESOURCES: содержит два файла: FEATURE_FLAGS.md, который описывает флаги, позволяющие активировать различные функции Superset, и INTHEWILD.md, который содержит список организаций, которые внесли свой вклад в развитие Superset путем создания запросов на объединение изменений (Pull Requests).
- scripts: содержит скрипты и утилиты, используемые для различных задач, таких как установка и настройка Superset, тестирование и сборка.
- superset: содержит основной код Superset, написанный на языке Python. Это ядро Superset, которое обрабатывает запросы, создает визуализации и управляет всеми аспектами приложения, включая подключения к базам данных и обработку запросов.
- superset-embedded-sdk: содержит функционал для встраивания аналитики в другие приложения.
- superset-frontend: содержит все, что связано с визуальной частью Superset, написанной на языке JavaScript и использующей фреймворк React. Этот раздел включает в себя плагины визуализации, инструменты для создания дашбордов и интеграционные тесты.
- superset-websocket: содержит сервер WebSocket, написанный на Node.js, который используется для отправки асинхронных данных внешнему интерфейсу веб-приложения Superset.
- tests: содержит тесты для различных компонентов приложения, включая интеграционные и модульные тесты.
- CONTRIBUTING.md и CODE_OF_CONDUCT.md: содержат инструкции для участников сообщества, которые хотят внести свой вклад в развитие Superset и кодекс поведения.

Полный репозиторий:
Apache Superset Repo v2.0.1
│
├── docker # Используется при развертывании с помощью Docker (содержит разные команды в .sh и параметры)
│ └── pythonpath_dev # содержит файл superset_config.py, используется для ручных настроек
├── helm # Нужно для работы с kubernetes (k8s). Примеры .yaml файлов и документация
│ └── superset
│ └── templates
│
├── RELEASING # ???
│
├── requirements # Зависимости Python, сгенерированные с помощью pip-compile-multi
├── RESOURCES # Два интересных файлика
│ ├── FEATURE_FLAGS.md # Перечень флагов, для активации фич через superset_config.py
│ └── INTHEWILD.md # Организации, создавшие PR (Контрибьютеры суперсета)
│
├── scripts # .sh и Python скрипты, которые используются для ???
│
├── superset # Ядро суперсета, написанное на Python
│ ├── advanced_data_type
│ ├── annotation_layers
│ ├── async_events
│ ├── cachekeys
│ ├── charts
│ ├── cli
│ ├── columns
│ ├── commands
│ ├── common
│ ├── connectors # содержит код для подключения к различным источникам данных
│ ├── css_templates
│ ├── dao
│ ├── dashboards
│ ├── databases
│ ├── datasets
│ ├── db_engines
│ ├── db_engine_specs
│ ├── embedded
│ ├── embedded_dashboard
│ ├── examples
│ ├── explore
│ ├── extensions
│ ├── importexport
│ ├── initialization
│ ├── key_value
│ ├── migrations
│ ├── models
│ ├── queries
│ ├── reports
│ ├── security
│ ├── sqllab
│ ├── sql_validators
│ ├── static
│ ├── tables
│ ├── tasks
│ ├── templates
│ ├── temporary_cache
│ ├── translations
│ ├── utils
│ └── views
│
├── superset-embedded-sdk # Функционал встраиваемой аналитики
│
├── superset-frontend # Все что связано с визуальной частью Superset и Node.js (в том числе плагины)
│ ├── cypress-base # Cypress используется для интеграционных тестов
│ ├── packages
│ ├── plugins # Плагины визуализации
│ ├── scripts
│ ├── spec
│ ├── src
│ └── tools
│
├── superset-websocket # Сервер Node.js WebSocket для отправки данных асинхронного события во внешний интерфейс веб-приложения Superset.
│ ├── spec
│ ├── src
│ └── utils
│
├── tests # содержит тесты для различных компонентов приложения
│ ├── common
│ ├── consts
│ ├── example_data
│ ├── fixtures
│ ├── integration_tests
│ └── unit_tests
│
├── CONTRIBUTING.md
└── CODE_OF_CONDUCT.md
Описание директорий ядра суперсета
Директория superset содержит ядро Superset, написанное на языке Python. Она содержит следующие поддиректории:
- advanced_data_type: содержит классы для расширенных типов данных, например, типы данных JSON и массивы;
- annotation_layers: содержит классы для работы с аннотациями, которые могут быть добавлены на графики;
- async_events: содержит код для обработки асинхронных событий, например, отправку электронной почты;
- cachekeys: содержит классы для генерации ключей кэширования;
- charts: содержит классы для различных типов графиков и связанный код;
- cli: содержит код для командной строки, в том числе, код для запуска приложения и управления базой данных;
- columns: содержит классы для управления колонками в таблицах базы данных;
- commands: содержит классы для различных команд, которые могут быть выполнены в приложении;
- common: содержит общий код для Superset, например, константы и утилиты;
- connectors: содержит код для подключения к различным источникам данных, например, базам данных и API;
- css_templates: содержит шаблоны CSS для различных компонентов визуализации;
- dao: содержит код для работы с объектами доступа к данным (DAO);
- dashboards: содержит классы для управления дашбордами и связанный код;
- databases: содержит классы для управления подключениями к базам данных и связанный код;
- datasets: содержит классы для управления наборами данных и связанный код;
- db_engines: содержит классы для управления различными типами баз данных, такими как PostgreSQL и MySQL;
- db_engine_specs: содержит классы для управления специфичными для каждой базы данных настройками;
- embedded: содержит классы для встраивания Superset в другие приложения;
- embedded_dashboard: содержит классы для создания встроенных дашбордов;
- examples: содержит примеры кода для различных компонентов Superset;
- explore: содержит классы для исследования данных в базах данных и связанный код;
- extensions: содержит код для расширения Superset с помощью плагинов и других расширений;
- importexport: содержит код для импорта и экспорта различных объектов Superset, таких как дашборды и таблицы;
- initialization: содержит код для инициализации приложения и связанных компонентов;
- key_value: содержит классы для работы с ключами и значениями в базе данных;
- migrations: содержит файлы миграции базы данных.
- models: содержит определения моделей базы данных и код для их взаимодействия с базой данных.
- queries: содержит код для выполнения и обработки запросов к базе данных.
- reports: содержит код для создания и обработки отчетов.
- security: содержит код для аутентификации и авторизации пользователей.
- sqllab: содержит код для выполнения SQL-запросов и визуализации результатов.
- sql_validators: содержит код для валидации SQL-запросов перед их выполнением.
- static: содержит статические файлы, такие как изображения, стили и скрипты.
- tables: содержит определения таблиц базы данных и код для их взаимодействия с базой данных.
- tasks: содержит код для запуска фоновых задач.
- templates: содержит HTML-шаблоны для отображения результатов запросов.
- temporary_cache: содержит временные кэшированные данные.
- translations: содержит файлы для локализации интерфейса.
- utils: содержит вспомогательный код, который используется в разных местах приложения.
- views: содержит определения представлений и код для обработки HTTP-запросов.
Описание директории superset-frontend
Директория superset-frontend содержит код, связанный с визуальной частью Superset, написанный на Node.js, а также плагины визуализации.
- cypress-base: содержит базовый код для интеграционных тестов, которые используют Cypress.
- packages: содержит различные пакеты Node.js, используемые в Superset.
- plugins: содержит код для различных плагинов визуализации, которые могут быть использованы в Superset.
- scripts: содержит различные скрипты, используемые в разработке и сборке Superset.
- spec: содержит тесты для кода в директории src.
- src: содержит основной код визуальной части Superset, написанный на Node.js и React.
- tools: содержит различные инструменты, используемые в разработке и сборке Superset.
Описание директории superset-websocket
Директория superset-websocket содержит сервер Node.js WebSocket, который используется для отправки данных асинхронных событий во внешний интерфейс веб-приложения Superset.
- spec: директория содержит юнит-тесты для кода, написанного в директории src.
- src: директория содержит исходный код сервера WebSocket.
- utils: директория содержит вспомогательные утилиты, используемые в src.
Вводные вопросы по архитектуре Apache Superset
Как работает webpack в apache superset?
Apache Superset использует webpack для сборки и управления статическими ресурсами, такими как JavaScript, CSS и изображения.
Webpack — это инструмент сборки JavaScript-приложений, который позволяет объединять различные модули JavaScript в один файл или несколько файлов для оптимизации производительности и управления зависимостями.
Webpack также позволяет использовать различные плагины и лоадеры для обработки различных типов файлов, например, Babel для транспиляции современного JavaScript в более старую версию, или Sass для преобразования файлов CSS в более удобный формат.
В целом, использование webpack в Apache Superset позволяет улучшить производительность приложения и облегчить управление статическими ресурсами.
Как между собой взаимодействуют компоненты apache superset?
Компоненты Apache Superset взаимодействуют между собой через API и базу данных.
Пользовательский интерфейс позволяет пользователям взаимодействовать с приложением и запрашивать данные, которые затем обрабатываются сервером. Для этого используется API, который позволяет обмениваться данными между клиентом и сервером.
Дашборды являются одним из ключевых компонентов Apache Superset, они позволяют пользователям создавать интерактивные отчеты и анализировать данные.
База данных является центральным хранилищем данных в Apache Superset. Она используется для хранения метаданных, таких как информация о таблицах и столбцах, а также для хранения данных, которые используются для построения дашбордов и отчетов.
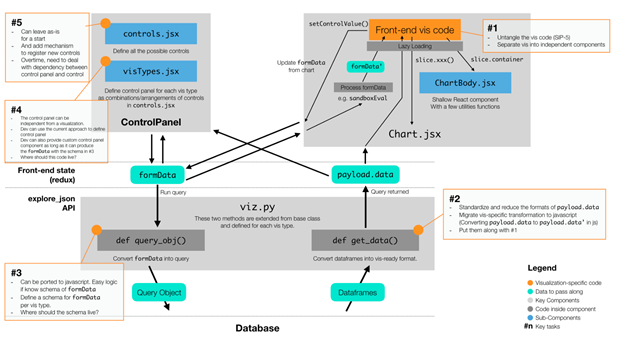
На картинке ниже показана примерная схема взаимодействия API и интерфейса (но эта схема местами устарела, но идею можно понять):
Какую роль играет websoket в apache superset?
WebSocket используется в Apache Superset для обеспечения реального времени взаимодействия между пользователем и приложением. Он позволяет обмениваться данными между клиентом и сервером без необходимости перезагрузки страницы или повторного запроса данных. WebSocket используется, например, для обновления дашбордов в режиме реального времени или для отображения уведомлений о новых данных.
Для чего используется lerna в apache superset?
Lerna используется в Apache Superset для управления множеством связанных проектов и пакетов. Это позволяет разработчикам управлять зависимостями между различными компонентами приложения, облегчает разработку и тестирование, а также упрощает процесс развертывания и обновления приложения. Lerna также обеспечивает автоматическое обновление зависимостей между различными проектами и пакетами, что упрощает поддержку приложения в целом.
Для чего используется babel в apache superset?
Babel используется в Apache Superset для транспиляции (преобразования) современного JavaScript кода в код, который может быть выполнен в браузерах и средах выполнения, не поддерживающих новые возможности языка. Это позволяет использовать последние версии языка и его фичи при разработке, не беспокоясь о совместимости с более старыми браузерами или средами выполнения. Babel также может использоваться для преобразования кода из других языков программирования, таких как TypeScript или JSX, в чистый JavaScript.
Как между собой взаимодействуют модули python и модули Javascript в apache superset?
Apache Superset использует Flask, который является фреймворком для создания веб-приложений на Python. Flask позволяет использовать модули Python для создания бэкэнда приложения, который взаимодействует с базой данных и обрабатывает запросы от клиента.
Модули JavaScript используются для создания фронтенда приложения. Они загружаются в браузере и отображают данные, полученные от сервера. В Apache Superset используется React, который является библиотекой JavaScript для создания пользовательских интерфейсов.
Взаимодействие между модулями Python и JavaScript происходит через API, которое предоставляет бэкэнд. Модули JavaScript отправляют запросы на сервер через API, а модули Python обрабатывают эти запросы и возвращают данные в формате JSON. Данные затем используются модулями JavaScript для отображения на странице.
Пример разборов приложений в стеке Python Flask + React
На базе какой технологии устроен worker в apache superset?
Worker в Apache Superset построен на технологии Celery. Celery — это асинхронная очередь задач, которая позволяет запускать задачи в фоновом режиме и масштабировать приложение. Celery используется для выполнения задач, которые могут занимать много времени, таких как отправка электронных писем, обработка данных и т.д.
На основе каких технологий работает dataset в apache superset?
Dataset в Apache Superset работает на основе технологий SQL и ORM (Object-Relational Mapping). ORM позволяет работать с базами данных через объекты и классы, а SQL используется для выполнения запросов к базам данных. Dataset в Apache Superset также поддерживает различные источники данных, такие как MySQL, PostgreSQL, Oracle и другие.
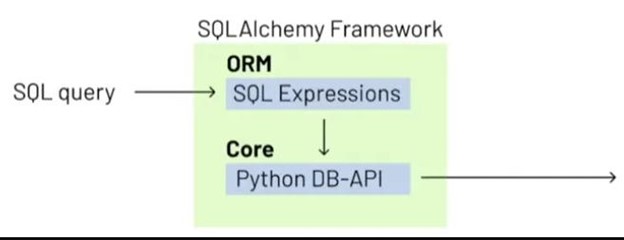
Для работы с большими объемами данных Superset использует SQLALchemy ORM, которая обеспечивает эффективный доступ к базам данных и быстрое выполнение запросов. Кроме того, Superset поддерживает кэширование результатов запросов, что позволяет ускорить работу с данными и снизить нагрузку на сервер.
Как работает sqllab в apache superset?
SQLLab в Apache Superset представляет собой интерактивный редактор SQL, который позволяет пользователям выполнять SQL-запросы непосредственно к их источникам данных. Пользователи могут создавать новые запросы, редактировать существующие и сохранять их для будущего использования. SQLLab поддерживает различные типы запросов, включая SELECT, INSERT, UPDATE и DELETE.
SQLLab использует SQLAlchemy ORM для создания и выполнения запросов к базам данных. Пользователи могут выбирать источник данных, указывать таблицы и поля, а также применять фильтры и условия для получения нужных результатов. SQLLab также поддерживает автодополнение кода SQL и подсветку синтаксиса, что упрощает написание запросов.
Кроме того, SQLLab позволяет пользователям просматривать результаты запросов в виде таблиц или графиков, что облегчает анализ данных. Результаты запросов могут быть сохранены в виде дашбордов или отчетов для дальнейшего использования.
SQLLab также поддерживает кэширование результатов запросов, что позволяет ускорить работу с данными и снизить нагрузку на сервер. Кэширование может быть настроено для каждого запроса отдельно или для всего SQLLab в целом.
Что такое redis и как он работает?
Redis — это быстрый и эффективный инструмент для хранения данных в памяти, который используется как кэш, база данных и брокер сообщений. Он работает в оперативной памяти и сохраняет данные на диск только в случае, если это необходимо для сохранения данных при перезагрузке системы. Redis поддерживает различные структуры данных, такие как строки, списки, множества, хеш-таблицы и другие, и обеспечивает высокую производительность и надежность благодаря своей архитектуре в памяти. Redis также поддерживает механизмы репликации и кластеризации для обеспечения масштабируемости и отказоустойчивости.
Основные строительные блоки Superset
Apache Superset написан на Python. Он использует модули Python (Pandas) для работы с данными в бэкэнде. В целом он состоит из следующих компонентов:
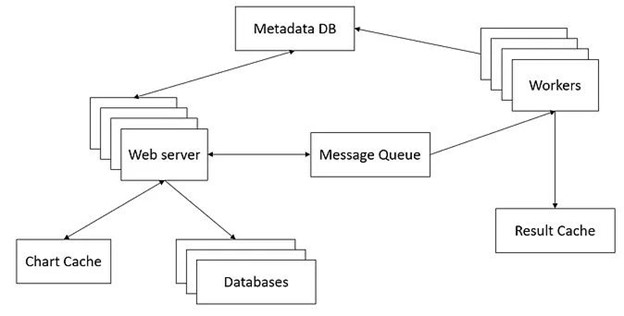
- Веб-сервер (Gunicorn, Nginx, Apache)
- Механизм базы данных метаданных (MySQL, Postgres, MariaDB)
- Очередь сообщений (Redis, RabbitMQ, SQS и т. д.)
- Уровень кэширования (Memcached, Redis и т. д.)
- Серверная часть результатов (S3, Redis, Memcached и т. д.)
Superset WebSocket Server Architecture
Примерная схема «Websockets via a sidecar application» из [SIP-39] Global Async Query Support:
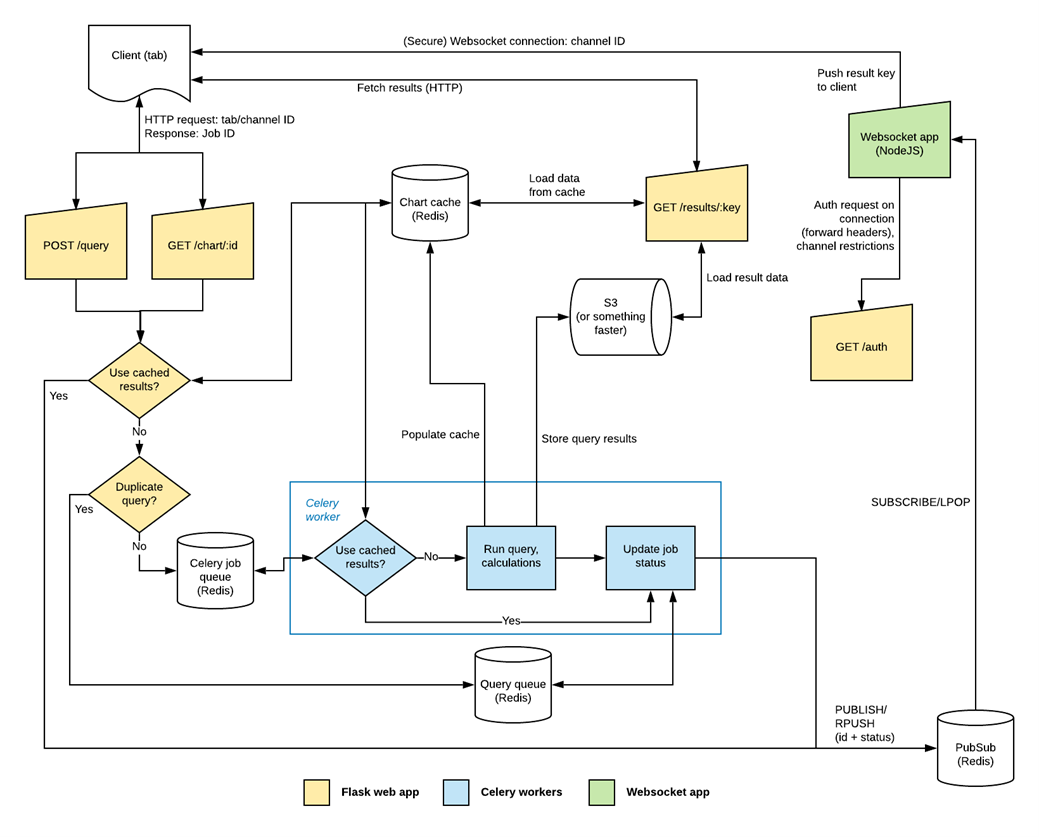
Как что взаимодействует — можно почитать в readme.md.
Как собирается интерфейс на react в apache superset?
Apache Superset использует React для создания пользовательского интерфейса. Внешний вид и функциональность интерфейса определяются с помощью компонентов React, которые объединяются в приложения и страницы. Код React компонентов написан на языке JavaScript и компилируется с помощью инструментов сборки, таких как Webpack или Babel. Интерфейс Apache Superset также использует другие технологии, такие как CSS и HTML, для оформления и разметки страниц. В целом, интерфейс Apache Superset представляет собой комбинацию различных технологий, которые работают вместе для обеспечения удобного и эффективного пользовательского опыта.
Как осуществляется работа веб интерфейса в apache superset ?
Веб-интерфейс в Apache Superset работает через Flask, который является микрофреймворком Python для веб-приложений. Flask обрабатывает запросы от пользователей и генерирует HTML-страницы, которые отображаются в браузере. Веб-интерфейс также использует JavaScript и CSS для создания интерактивных элементов на страницах. Когда пользователь выполняет действие, например, выбирает фильтр или запускает запрос, Superset отправляет запрос на сервер и получает результаты, которые затем отображаются на странице. Вся эта работа осуществляется асинхронно с помощью Celery workers, чтобы не блокировать основной поток выполнения приложения.
Что такое celery workers в apache superset?
Celery workers — это процессы, которые выполняют задачи фонового выполнения в Apache Superset. Эти задачи могут быть связаны с обновлением кэша, отправкой электронных писем, выполнением SQL-запросов и другими операциями, которые могут занимать длительное время. Использование Celery workers позволяет выполнять эти задачи асинхронно, не блокируя основной поток выполнения приложения. Это улучшает производительность и отзывчивость приложения для пользователей.
Как взаимодействуют apache superset и redis?
Apache Superset использует Redis в качестве backend для кэширования результатов запросов и кэширования метаданных. Redis позволяет ускорить процесс выполнения запросов и уменьшить нагрузку на базу данных. Superset также использует Redis для кэширования результатов выполнения SQL-запросов, что позволяет ускорить процесс отображения дашбордов и графиков. В целом, Redis является важным компонентом инфраструктуры Apache Superset, который помогает улучшить производительность и снизить нагрузку на базу данных.
Логические конструкции Superset
Sources — Источники информации
Dashboards — Набор срезов, которые дают историю данных
Slice — Единица выходной информации, такая как график, таблица, карта
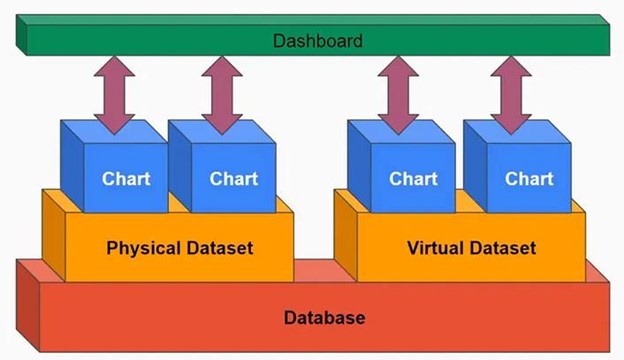
Источник: Блог superset-bi


