

Основы columnar processing: хранение и обработка по столбцам
columnar processing позволяет значительно ускорить аналитическую обработку за счет хранения данных по столбцам, векторизации операций и оптимизаций на этапе планирования запросов. В контексте Polars это становится основой архитектуры современного пайплайна: память модельно ставится под контроль разработчиками и инструментами, поддерживающими стандарты Apache Arrow, Parquet и интеграцию с экосистемой Python. Глубокое понимание принципов хранения по столбцам, их реализации в Polars и связанных технологиях даёт критическую базу для проектирования эффективных аналитических решений на больших данных.
Polars как инструмент для экспрессии columnar processing в Python сочетает низкоуровневые оптимизации с удобством интерфейсов. В этой главе рассмотрены ключевые концепции: как устроено хранение по столбцам, какие форматы лежат в основе передачи и сохранения данных, как работает lazy execution и какие протоколы взаимодействия позволяют интегрировать Polars в существующий стек данных. Особое внимание уделено архитектурным решениям, которые позволяют обрабатывать терабайты данных с эффективным использованием памяти и процессорного времени.
- Краткое содержание главы
- Архитектура хранения по столбцам и принципы векторизированной обработки, включая схемы памяти и кодирование.
- Форматы данных, совместимость с Apache Arrow, Parquet и протоколы взаимодействия в рамках экосистемы Python.
- Lazy execution: концепции планирования, реализации и примеры паттернов оптимизации запросов.
- Интеграции с существующими инструментами и практические сценарии внедрения в корпоративные пайплайны.
- Риски, ограничения и лучшие практики по эксплуатации columnar processing в больших данных.
Архитектура хранения по столбцам и принципы векторной обработки
Основной идеей columnar processing является хранение данных по колонкам, а не по строкам. Такая организация данных обеспечивает эффективную загрузку векторных операций, позволяет реализовать агрегации и фильтрации без необходимости считывать весь набор строк и уменьшает расход памяти за счет более плотного представления значений. В архитектуре Polars это достигается за счет нескольких ключевых элементов:
- Контейнеризация колонок и chunked-структур: данные разделяются на независимые блоки (chunks). Это обеспечивает гибкость управления памятью, позволяет частично обрабатывать большие датасеты, а также облегчает параллелизм и распараллеливание операций. Чанкование поддерживает локальность данных, упрощает векторизацию и минимизирует переходы между кэшами CPU.
- Векторизация и SIMD: операции над колонками выполняются пакетно над векторами значений. Это позволяет использовать аппаратную векторизацию и снижает накладные расходы на интерпретацию строковых операций, что критично для аналитических запросов с агрегатами и фильтрами.
- Кодирование столбцов: для экономии памяти применяются кодирования и компрессии колонок (например, dictionary encoding для категориальных столбцов, delta encoding для числовых последовательностей). Это уменьшает размер данных без потери точности запросов, особенно когда данные имеют повторяющиеся значения.
- Управление нулевыми значениями: структурированные представления нулей и индикаторы наличия значения в столбцах (masking) позволяют распараллеливание вычислений и ускорение фильтрации по условиям, не читавая лишние элементы.
- Совместимость со стандартами: хранение по столбцам и манипуляции в Polars опираются на совместимость с Apache Arrow. Это обеспечивает единообразную модель представления данных в памяти, упрощает интероперабельность между окнами памяти и внешними форматом хранения (Parquet, IPC).
Эти принципы обеспечивают высокую скорость сквозной аналитики: исключение лишних побочных копирований памяти, быстрое применение фильтров на ранних стадиях обработки, эффективную агрегацию над большими наборами значений. Архитектура columnar processing в Polars тесно связана с тем, как данные загружаются, какие операции применяются и как формируется итоговый план выполнения запроса.
- Важный нюанс архитектуры: хранение «по столбцам» не является абсолютной заменой «хранения по строкам» во всех сценариях. В реальных пайплайнах часто встречаются гибридные подходы: кэширования отдельных промежуточных результатов по столбцам, выборочная загрузка или сжатие данных на диске, где часть данных активно используется, а другая часть может оставаться в более компактном виде. Такой баланс обеспечивает эффективную работу как для больших датасетов, так и для рабочих нагрузок с интенсивной сегментацией.
## Пример концептуального поведения lazy-векторизации (без демонстрации полного кода).
## Приведенный фрагмент иллюстрирует идею: операции применяются к столбцам как единым векторам.
## Текстовый пример; реальная реализация зависит от конкретной версии Polars.
import polars as pl
df = pl.DataFrame({"a": [1, 2, 3], "b": [4, 5, 6]})
## Векторизированная операция над столбцами
result = df.select([pl.col("a") * 2, pl.col("b") + 1])
Форматы данных, совместимость и протоколы взаимодействия
Архитектура columnar processing требует согласованных форматов передачи и хранения данных. Полезной отправной точкой являются стандарты Apache Arrow, Parquet и IPC. В Polars эти форматы играют следующую роль:
-
In-memory представление через Arrow: данные хранятся в виде Arrow-таблиц внутри памяти. Это обеспечивает нулевые копирования между системами, совместимыми с Arrow, и упрощает обмен данными между различными языками (Python, Rust, C++, Java). Структура столбцов позволяет оперативно доставлять нужные части набора данных без чтения всей таблицы.
-
On-disk форматы: Parquet служит эффективной колонно-ориентированной схемой хранения для больших датасетов. Parquet поддерживает столбцовый хранение, сжатие и схему, ориентированную на произвольную схему типов. Polars может напрямую читать Parquet-файлы и писать их, обеспечивая быстрое чтение выборок за счёт фильтрации на уровне файлов и строк.
-
IPC и сериализация: Inter-Process Communication (IPC) форматы позволяют передавать данные между процессами без дорогостоящего маршалинга. Это важно для сценариев, где данные обмениваются между модульными компонентами пайплайна.
-
Совместимость и конверсия: Polars поддерживает конверсию между Pandas DataFrame и Polars DataFrame, а также конверсию в PyArrow Table. Это позволяет интегрировать Polars в существующие пайплайны, где ранее применялся Pandas или PyArrow как основная единица обмена данными.
## Пример конвертации между Pandas, PyArrow и Polars import polars as pl import pandas as pd import pyarrow as pa pd_df = pd.DataFrame({"id": [1, 2, 3], "val": [10, 20, 30]}) ## из pandas в Polars pl_df = pl.from_pandas(pd_df) ## из PyArrow в Polars arrow_table = pa.table({"id": [1, 2, 3], "val": [10, 20, 30]}) pl_df2 = pl.from_arrow(arrow_table) ## обратно в pandas pd_back = pl_df.to_pandas() -
Взаимодействие с экосистемой Python включает прямую интеграцию с PyArrow, Parquet и Pandas. Это снижает порог входа для команд, которые уже строят пайплайны вокруг Arrow и Pandas, и облегчает миграцию на Polars там, где необходима более высокая скорость и экономия памяти.
-
Прагматический взгляд на совместимость: выбор между хранением на диске по Parquet или обменом через Arrow IPC зависит от задачи. Для аналитических запросов с большими склотами данных Parquet выступает как эффективный буфер и место хранения, а Arrow - как быстрый механизм передачи между компонентами пайплайна.
Lazy execution: планирование, оптимизации и паттерны
Одной из главных инноваций Polars является ленивое выполнение (lazy execution). Архитектурно это реализовано через построение логического плана запроса (logical plan), который затем компилируется в физический план (physical plan) и, наконец, исполняется. Преимущества ленивости очевидны:
- Промежуточные результаты не вычисляются на этапе построения запроса. Это позволяет агрессивно оптимизировать цепочку операций и минимизировать чтение данных.
- Применение фильтров, проекций и агрегаций может происходить на ранних стадиях обработки, что уменьшает объем обрабатываемых данных и увеличивает пропускную способность.
- Фузия операторов обеспечивает отсутствие лишних проходов над памятью: объединение вычислений в единый проход снижает накладные расходы на обход памяти и пересборку результатов.
Основные направления оптимизации в ленивом выполнении:
-
Predicate pushdown: фильтры, применяемые к данным, должны быть сведены к минимально необходимому набору столбцов и применяться как можно раньше. Это особенно критично для больших датасетов с большим количеством столбцов.
-
Projection pushdown: выбор только необходимых столбцов до выполнения вычислений, чтобы снизить трафик памяти и ускорить вычисления.
-
Fusion и кэширование выражений: комплексные выражения компонуются в единую последовательность операций над колонками, что уменьшает число проходов по памяти и позволяет лучше распараллеливать работу.
-
Преобразование типов и оптимизация выражений: Polars может адаптировать вычисления под конкретные типы данных и использовать специализированные реализации для числовых операций, что снижает накладные расходы.
## Пример ленивого запроса в Polars import polars as pl df = pl.read_csv("events.csv") ## Ленивая цепочка: фильтрация, выбор столбцов и агрегация plan = ( df.lazy() .filter(pl.col("country") == "RU") # predicate pushdown .select(["user_id", "amount", "timestamp"]) # projection pushdown .groupby("user_id") .agg(pl.sum("amount").alias("total_amount")) ) ## Реальная сборка результата result = plan.collect() -
Важно помнить, что ленивость не означает отказ от немедленного выполнения. В случае необходимости можно вызвать collect() для принудительной оценки. В реальных системах выбор стратегии выполнения основывается на профилировании нагрузки, размере данных и доступных ресурсах.
Интеграции и эксплуатационные протоколы
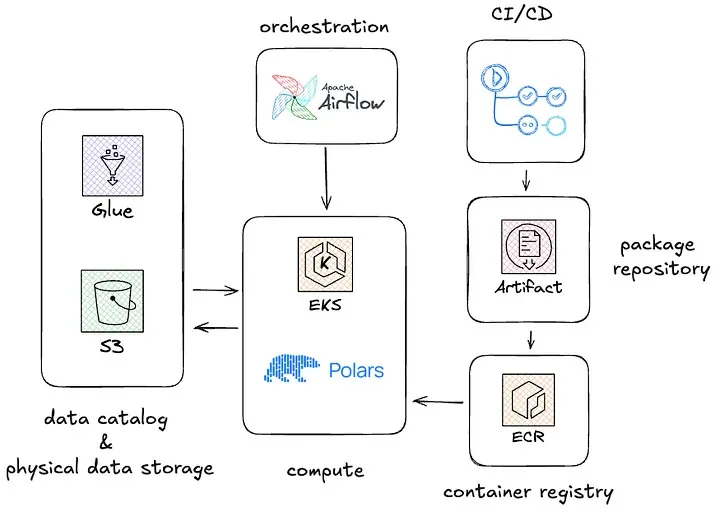
Эффективная работа columnar processing в рамках корпоративной инфраструктуры требует ясных правил интеграции и согласованных протоколов обмена данными. В центре внимания здесь стоят следующие аспекты:
-
Встраивание в ETL/ELT: использование Polars в качестве этапа преобразования данных на этапе загрузки или трансформации. Ленивые цепочки позволяют собирать только то, что нужно для следующего шага, снижая задержки в конвейерах.
-
Обмен данными между компонентами: перевод между Polars, Pandas и PyArrow обеспечивает гибкость в выборе инструментов для конкретной задачи. В свою очередь, Parquet-файлы и Arrow IPC помогают разнести данные по узлам и процессам без дорогостоящих копирований.
-
Взаимодействие с кластерными средами: для больших нагрузок Polars поддерживает эффективную параллельную обработку, что усиливается за счет chunked-структур и оптимизаций планирования. В кластерах можно сочетать Polars с другими системами через общие форматы данных (Parquet, Arrow) и через конверсию между DataFrame-структурами.
-
Категоризация ресурсов: мониторинг памяти и CPU становится необходимой частью эксплуатации. Основные метрики включают требования к памяти на столбец, коэффициент сжатия и эффективность фильтрации/агрегации.
-
Протоколы управления версиями и совместимость: когда внедряется Polars в существующую экосистему, важно обеспечить совместимость версий зависимостей (PyArrow, Parquet, Pandas). Это позволяет избежать неожиданных сбоев при миграциях и обновлениях.
## Пример интеграции Polars с Pandas и Arrow в рамках пайплайна import polars as pl import pandas as pd import pyarrow as pa ## Источник данных в Pandas pd_df = pd.read_csv("sensors.csv") ## Конвертация в Polars для ускоренной аналитики pl_df = pl.from_pandas(pd_df) ## Ленивая обработка и сборка result = pl_df.lazy().filter(pl.col("temperature") > 25).groupby("location").agg(pl.mean("temperature")).collect() ## Возвращение в Pandas после обработки out_pd = result.to_pandas() -
В дополнение к трансформации данных, интеграция с PyArrow позволяет эффективно обмениваться данными между процессами и системами. Это особенно важно в рамках больших пайплайнов и распределенных сред, где данные нужно перемещать без копирования в памяти.
Практические сценарии внедрения columnar processing
Для организации перехода на columnar processing в корпоративной среде целесообразно придерживаться последовательной дорожной карты:
- Шаг 1: оценка текущих рабочих нагрузок. Идентифицировать запросы с тяжелой агрегацией, фильтрацией и частым повторением чтения одних и тех же столбцов. Это даст ориентир для целевых преобразований.
- Шаг 2: пилотный проект на ограниченном наборе данных. Выбрать часть датасета и реализовать ленивые цепочки запросов, сравнивая производительность с существующими решениями.
- Шаг 3: переход к parquet и Arrow-обмену. Внедрить Parquet как формат хранения и использовать Arrow IPC для коммуникации между модулями.
- Шаг 4: мониторинг и оптимизация. Внедрить метрики потребления памяти, времени выполнения и пропускной способности, регулярно проводить профилирование запросов.
- Шаг 5: обучение команд и изменение процессов. Обеспечить распространение знаний об архитектуре columnar processing, правил планирования запросов и подходах к оптимизации.
Реализация на практике требует согласования между командами: инженерами данных, дата-сайентистами и операционными подразделениями. Внедрение должно сопровождаться документированной политикой памяти, стандартами именования столбцов и шаблонами ленивых цепочек, чтобы поддерживать повторяемость и предсказуемость в пайплайнах.
Риски и ограничения
- Совместимость форматов: при переходе на columnar processing возможны ограничения совместимости старых инструментов, особенно если они не поддерживают современные форматы Arrow или Parquet. Необходимо планировать миграции и тестирование на этапе внедрения.
- Потребность в профилировании: оптимизации требуют системного подхода к профилированию запросов. Без измерений риски включают выбор неэффективных планов и перегрузку памяти.
- Баланс между ленивостью и задержками: в некоторых сценариях слишком длинные ленивые цепочки могут задержать быстрое получение первых результатов. В таких случаях целесообразно рассмотреть частичные вычисления или альтернативы, которые дают ранние ответы.
- Ограничения памяти: хотя columnar processing экономит память за счет сжатия и эффективной загрузки, работу с очень большими датасетами нельзя рассматривать без управления памятью и пагинации данных.
- Стоимость миграции: переход на новые форматы и инструменты требует времени и координации между командами, поэтому необходима стратегическая дорожная карта и бюджет на обучение.
Key takeaways
- Columnar processing строится на хранении данных по столбцам, что обеспечивает лучшую кэшируемость и векторизованную обработку, особенно на больших датасетах.
- Форматы Apache Arrow и Parquet выступают опорными для памяти и диска, обеспечивая эффективную интеграцию между компонентами пайплайна.
- Ленивое выполнение (lazy execution) позволяет строить оптимизированный план запроса, применять предикат-пушдаун и проекцию-пушдаун, что приводит к значительному снижению объема данных, подлежащих обработке.
- Интеграции с Pandas, PyArrow и Parquet дают возможность плавно включать Polars в существующие пайплайны без больших переработок кода.
- Практическая миграция требует пилотирования, мониторинга и документирования правил работы с памятью и форматом данных.
- Архитектура и операции columnar processing должны быть задуманы как часть корпоративной стратегии управления данными: от источников до потребителей данных.
- Важно помнить о рисках совместимости форматов и затратах на адаптацию команд, поэтому планирование миграции и грамотное обучение являются ключевыми элементами.
FAQ
- Что такое columnar processing и почему он эффективен для аналитических запросов?
- Columnar processing - это подход к хранению и обработке данных по колонкам, а не по строкам. Он эффективен, потому что операции над столбцами распространяются на компактные последовательности значений, что улучшает кэш-локальность, уменьшает объем читаемой памяти и позволяет применять векторизацию и фильтрацию на ранних стадиях обработки. Это особенно полезно для агрегаций, группировок и фильтраций в больших датасетах.
- Какую роль играет Apache Arrow в архитектуре Polars?
- Apache Arrow обеспечивает единый и эффективный формат представления данных в памяти. Он поддерживает нулевые копирования между модулями, облегчает обмен данными между языками и системами, а также служит основой для взаимодействия Polars с другими форматами, такими как Parquet и IPC. Это обеспечивает совместимость и высокую производительность параллельной обработки.
- Зачем нужны lazy-цепочки в Polars и как они работают на практике?
- Lazy-цепочки позволяют строить логический план запроса без немедленного исполнения. Это даёт возможность агрегировать, распиливать и перестраивать операции в единый оптимизированный план, что минимизирует доступ к данным и ускоряет выполнение. В реальности это достигается через предикат-пушдаун, проекцию-пушдаун и операционную фузию, когда несколько выражений выполняются за один проход над колонками.
- Какие форматы данных и протоколы следует использовать в корпоративном пайплайне?
- В современных пайплайнах целесообразно использовать Parquet для хранения больших партий данных и Arrow IPC для обмена между компонентами. Polars совместим с PyArrow и Pandas, что позволяет выбрать удобную точку входа и перехода между инструментами без потери эффективности.
- Какие ограничения встречаются при переходе на columnar processing?
- Возможные ограничения включают несовместимости отдельных инструментов с Arrow/Parquet, потребность в профилировании для нахождения оптимальных схем доступа к памяти, риск задержек при слишком длинных ленивых цепочках и ограничения памяти при работе с очень большими датасетами. Выход - тщательное планирование миграции и поэтапное внедрение.
- Какой подход к миграции на Polars считают наиболее безопасным?
- Рекомендуется начать с пилотного проекта на ограниченном наборе данных, определить узкие места, затем постепенно расширять область использования. Важно обеспечить совместимость форматов и инструментов, внедрить мониторинг ресурсов и подготовить обучающий материал для команд.
- Какие примеры интеграции с Pandas и PyArrow наиболее типичны?
- Наиболее частые сценарии: конвертация между Pandas DataFrame и Polars DataFrame через pl.from_pandas и df.to_pandas, обмен данными через PyArrow Tables, чтение и запись Parquet-файлов через Polars. Эти операции позволяют плавно переносить задачи между Pandas-ориентированными пайплайнами и Polars без значительных переработок кода.
- Можно ли использовать Polars на кластерах вместе с Spark и Dask?
- Да, через единообразные форматы данных (Parquet, Arrow) можно создавать конвейеры, где Polars выполняет критичные вычисления и возвращает результаты в формате, совместимом с Spark или Dask. Такой подход позволяет сочетать преимущества Polars по скорости и гибкости с масштабируемостью распределённых систем.
- Как оценить эффективность columnar processing в конкретном проекте?
- Эффективность оценивается через метрики времени выполнения запросов, объема прочитанных данных и использования памяти. Вести профиль запросов, сравнивать ленивый план против eager-выполнения, анализировать долю данных, пропускаемых через фильтры, и измерять экономию CPU на критических участках конвейера.
- Какие практические рекомендации можно привести для повседневной работы с Polars?
- Рекомендации включают: начинать с ленивых цепочек для сложных запросов, минимизировать количество читаемых столбцов, внедрять предикат-пушдаун ранним образом, использовать Parquet как основную форму хранения, и поддерживать тесную интеграцию с Pandas и PyArrow для широкого охвата сценариев. Важно регулярно профилировать и документировать изменения в пайплайнах на предмет производительности и соответствия требованиям.
Задача этой главы - дать прочное понимание архитектуры columnar processing и показать, как эти принципы реализуются в Polars и взаимосвязанных технологиях. При правильном подходе к проектированию пайплайнов и к внедрению форматов данных можно добиться значимого увеличения пропускной способности и снижения затрат на вычисления даже при работе с терабайтами данных.


