

Администрирование Apache Spark
Курс охватывает эксплуатацию Apache Spark как платформы для обработки больших данных и аналитики. Он показывает, как управлять кластерами, оптимизировать вычисления и обеспечивать стабильную работу batch и streaming задач.
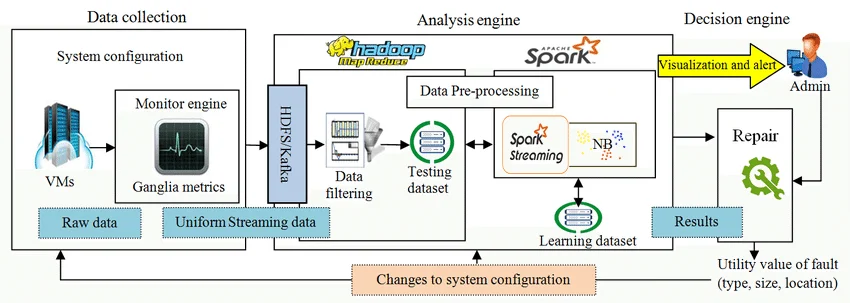
Рассматриваются архитектура Spark, управление ресурсами (executors, память, CPU), настройка производительности и оптимизация DAG. Особое внимание уделяется мониторингу, логированию, отказоустойчивости и интеграции с lakehouse-платформами.
Курс помогает выстроить эффективную Spark-инфраструктуру и снизить затраты на обработку данных при сохранении высокой производительности.
- Введение: термины, контекст и область применения Apache Spark
- Архитектура Apache Spark: ядро, драйвер, исполнители и кластеры
- Модель выполнения Spark: DAG, стадии, задачи и планировщик
- Spark SQL и ядро обработки данных: DataFrame, Dataset, Catalyst и Tungsten
- Хранение и обмен данными: HDFS, S3, Lakehouse, Delta Lake, Iceberg
- Архитектурные паттерны интеграции данных: пакетная обработка и Structured Streaming
- Режимы развёртывания кластера: Standalone, YARN, Mesos, Kubernetes
- Управление ресурсами кластера: executors, driver, cores, память
- Динамическое распределение ресурсов и авто-масштабирование
- Конфигурация Spark: spark-submit, spark-defaults.conf, параметры и рекомендации
- Память и управляемая JVM: Unified Memory, off-heap, memory fractions
- Производительность Spark: оптимизация shuffle, join-стратегии, broadcast, кеширование
- Методы оптимизации выполнения и паттерны планирования
- Мониторинг и наблюдаемость Spark: Spark UI, метрики, Prometheus, Grafana
- Логирование и трассировка: диагностика производительности и ошибок
- Безопасность и соответствие: Kerberos, TLS, ACL, Ranger/Sentry
- Совместимость версий: миграции, апгрейды, обратная совместимость
- Надёжность и отказоустойчивость: checkpointing, WAL, репликации
- Эксплуатационная модель Spark Platform: DevSecOps, CI/CD и Release management
- Операционные процессы: Change Management, инцидент-менеджмент, SRE подходы
- Архитектура интеракции с данными Lakehouse: управление версиями данных и схемами
- Архитектура потоковой обработки: микро-батчи vs непрерывная обработка
- Практические кейсы по отраслям: финансы, телеком, ритейл, производство
- Риски и ограничения внедрения Spark: типичные ошибки и способы их избежать
- Развитие и зрелость Spark Platform: maturity model, дорожная карта
- Обучение персонала и организационные аспекты администрирования Apache Spark
- Экономика эксплуатации Spark: затраты, производительность, TCO
- Инструменты и экосистема: notebooks, MLlib, Spark ML, BI-интеграции
- Практические лаборатории и задания: структурированные упражнения
- План внедрения Spark: пошаговый проект, чек-листы, критерии успеха
- Будущее Spark: тенденции, направления развития и нововведения
- Итоговый обзор, глоссарий и обзор архитектурных принципов


