

Надёжность и отказоустойчивость: checkpointing, WAL, репликации
В условиях крупных данных и непрерывной обработкиGuarantee (GA) Spark должен обеспечивать устойчивость к сбоям при минимальном влиянии на задержки обработки. Надёжность достигается за счёт сочетания механизмов долговременного сохранения состояния, журналирования входных данных и репликации данных на этапе хранения и вычислений. Эта глава рассматривает архитектурные принципы, алгоритмы и протоколы, лежащие в основе checkpointing, Write-Ahead Logging (WAL) и репликаций в Spark, а также практические подходы к проектированию устойчивых решений и их внедрению в корпоративную среду.
Checkpointing, WAL и репликации выступают опорой для обеспечения непрерывности работы обработок, восстановления после сбоев и сокращения риска потери данных. Проверка гипотез в реальном времени, повторная обработка и управление состоянием требуют тесной интеграции между хранением данных, механизмами восстановления и настройками кластера. В этой главе приводятся принципы, а также реальные архитектурные решения и практические рекомендации по внедрению в рамках современных кластеров Spark, использующих Hadoop-экосистему, облачные хранилища и контейнеризованные среды оркестрации.
- Краткое содержание главы
- Архитектурные основы надёжности Spark: lineage, устойчивость на уровне кластера и роль хранилищ.
- Checkpointing: принципы, места хранения, частота, стратегия для потоковой и пакетной обработки.
- Write-Ahead Logging (WAL): роль в Spark Streaming, ограничения и сценарии применения.
- Репликации и устойчивость к сбоям: репликация на уровне хранения, HA кластера, управление состоянием.
- Практическая реализация: конфигурации, мониторинг, тестирование устойчивости и сценарии эксплуатации.
Архитектурные основы надёжности Spark
Устойчивость Spark строится на двух взаимодополняющих механизмах: долговременном сохранении состояний и повторном воспроизведении вычислений. В классическом режиме Spark использует ленивую схему вычислений (RDD lineage). Если часть узлов выходит из строя, задача может быть перерассчитана на основе сохранённой истории преобразований. Этот принцип логического восстановления дополняется физическими механизмами: checkpointing и WAL, которые позволяют сократить время на повторную обработку или предотвратить потерю данных.
Роль хранения данных трудно переоценить. В распределённых системах данные остаются на поверхности хранения: HDFS/объектные хранилища (S3, ADLS) и локальные каталоги узлов. Репликация блоков (например, фактор репликации в HDFS) обеспечивает устойчивость к отказам узлов хранения. Однако вычислительная часть, включая shuffle и кеширование, требует корневой опоры: безопасное сохранение метаданных, конфигураций и состояния задач, чтобы при сбое можно было быстро вернуться к корректному состоянию без повторной загрузки и переработки всей информации.
Для отказоустойчивости Spark важны два направления: (1) точность и непрерывность обработки входных данных, особенно в потоковых сценариях, и (2) управляемая и повторяемая обработка вычислительного графа. В рамках архитектуры применяются стратегии отделения критичных данных от временных: хранение контрольных точек и журналов отдельно от данных, использование устойчивых хранилищ и поддержка режимов Exactly-Once там, где это возможно. Важно понимать, что уровень зрелости механизмов зависит от типа обработки: структурированная потоковая обработка (Structured Streaming) предоставляет более интегрированную модель резервирования, чем классические DStream-ориентированные подходы.
При проектировании решений надёжности следует учитывать лимиты кластера, сетевые задержки, требования к задержке обработки и размер состояния. Архитектура должна поддерживать возможность горизонтального масштабирования и удобство рестарта без потери согласованности данных. Важнейшая задача - обеспечить корректную работу в условиях частых сбоев оборудования, сетевых отклонений и неоднозначных нюансов источников данных (например, Kafka). В итоге ключевые принципы: минимизация потерь данных, приемлемые задержки, воспроизводимость вычислений и простота мониторинга.
Checkpointing: принципы и стратегия
Checkpointing является опорой для устойчивости вычислительных графов, включая состояние потокового анализа и крупномасштабных алгоритмов. Он записывает критические части линии обработки - метаданные о смещениях (offsets), состояние операторов и, при необходимости, и сами данные, чтобы повторная обработка могла начинаться не с начала, а с точной точки. Разделение между выбором нередуцируемой частоты и эксплуатационной стоимостью ввода-вывода определяет баланс между задержкой и надёжностью.
-
Что хранится в чекпойнтах: в контексте Structured Streaming чекпоинты содержат offsets источников, прогресс обработки и состояние операторов. В контексте RDD-чекпойнтов (checkpoint в DStream) сохраняется lineage и часть данных, чтобы ограничить длину цепочки зависимостей и ускорить восстановление. В обоих случаях чекпойнты должны храниться на долговременном и надёжном носителе, таком как HDFS или облачное хранилище.
-
Где размещать checkpoint: предпочтительно отдельно от данных, в надёжном долговременном хранилище. Разделение мест сохранения упрощает резервирование, ускорение восстановления и уменьшает риск одновременной потери данных и вычислительных графов. Объектные хранилища и распределённые файловые системы хорошо подходят для этой роли.
-
Частота и стратегия вращения: для потоковых задач частота checkpoint зависит от скорости потока и объёма состояния. Частые чекпойнты повышают надёжность, но увеличивают нагрузку на сеть и хранение. Для больших состояний применяются инкрементальные обновления и детерминированная чистка устаревших точек. В пакетной обработке чекпойнты могут использоваться реже, чтобы ограничить влияние на производительность, но всё равно должны сохраняться на случай повторного вычисления или восстановления узла.
-
Возврат к состоянию и согласованность: при сбое Spark восстанавливается из чекпойнтов и повторно вычисляет отсутствующие шаги. Важно, чтобы источники данных поддерживали детерминированные смещения и чтобы состояние операторов было устойчивым к повторному применению (например, через idempotent-операции). В Structured Streaming чекпойнты также участвуют в управлениях с состоянием (stateful operators), что обеспечивает устойчивость к сбоям и корректную отрисовку результатов после восстановления.
-
Практические рекомендации: разделите чекпойнты и данные, используйте надёжное хранилище, применяйте проверки целостности и политики хранения. Для потоковых задач обязательно задайте checkpointLocation в writeStream и соблюдайте правило минимального объёма состояния, чтобы снизить итоговую стоимость хранения и восстановления. При сомнениях - начинайте с более консервативной политики чекпойнтов, затем постепенно снижайте частоту по мере стабилизации системы.
## Пример: настройка чекпойнтов в Structured Streaming (Scala) val ds = spark.readStream.format("parquet").load("/data/input") ds.writeStream .format("console") .option("checkpointLocation", "/mnt/checkpoints/stream1") .start("/mnt/output/stream1") -
Важная связка с WAL: при использовании WAL в рамках потоковых источников (DStreams) журналирование входных данных перед обработкой позволяет снизить риск потери данных до окончательного подтверждения. В современных реалиях Structured Streaming WAL как отдельный слой чаще заменён механизмами состояния и правильно настроенным чекпойнтом, но концептуально WAL остаётся полезной опорой для понимания допущений о надёжности источников и рестарта.
-
Мониторинг чекпойнтов: отслеживайте размер и темп роста директорий чекпойнтов, скорость прогресса обработки, частоту восстановления и показатели использования диска. Чрезмерный рост чекпойнтов может свидетельствовать о неэффективной архитектуре состояния или об избыточном хранении.
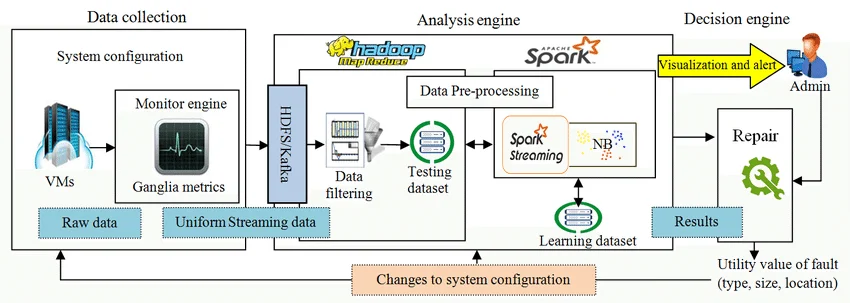
Write-Ahead Logging (WAL): роль в Spark Streaming и интеграции
WAL реализует принцип «запиши прежде - выполни позже», обеспечивая устойчивость к отказам за счёт записи входных данных до их обработки. В Spark Streaming WAL применялся в первую очередь в контексте DStream-архитектуры, где входные данные дублируются в журнале перед выполнением каждого микроблока. Это позволяет повторно воспроизвести данные в случае сбоя источника, а также снизить вероятность потери данных при сбояхэ.
-
Применимость к различным режимам: WAL более прямопоставим к DStream-ориентированным сценариям. В Structured Streaming роль журналирования входных данных перекрывается чекпойнтами и упором на устойчивый state store. Однако понимание концепций WAL остаётся полезным, особенно в интеграциях со старыми источниками и в случаях, когда критически важна гарантия доставки (exactly-once).
-
Архитектура WAL: журнал записей хранится в долговременном хранилище, обычно рядом с чекпойнтами. При сбоe Spark может повторно прочитать журнал для воспроизведения полученного потока данных и корректного восстановления прогресса, что особенно важно при потере узла или сети.
-
Риски и ограничения: рост WAL-логов может привести к высоким расходам на хранение и I/O. Требуется политика ротации и очистки журналов, а также понимание того, что WAL не снимает зависимости от источников данных: они по-прежнему должны поддерживать детерминированную доставку и не допускать дублирования.
-
Практические сценарии использования: WAL может применяться там, где требуется более высокая устойчивость к потере входных данных на входе, например, при обработке критически важных потоков через внешние источники. Но для большинства современных структурированных потоков предпочтение отдают чекпойнтам и устойчивым стратегиям агрегации состояния.
-
Рекомендации по внедрению: если планируется использование WAL, обеспечьте надёжное хранение журналов и чётко регламентируйте процесс очистки старых записей. В большинстве случаев для Structured Streaming WAL не нужен как отдельный слой, однако знание его концепции поможет в проектировании архитектуры с учётом требований к долговечности и репликации.
Репликации и устойчивость к сбоям: уровень кластера и хранения
Репликации в Spark затрагивают не только вычисления, но и хранение данных, а также режимы работы кластера. Репликация на уровне хранения (например, HDFS с фактором репликации) обеспечивает защиту от потери данных из-за выхода узла из строя и сетевых сбоев. В то же время Spark непосредственно полагается на повторное вычисление за счёт lineage, когда данные утрачиваются, либо на чекпойнты, чтобы восстановить прогресс.
-
Хранилище и репликация: HDFS и другие распределённые файловые системы реплицируют блоки данных на нескольких DataNodes. Репликация обеспечивает отказоустойчивость без необходимости немедленного обращения к источнику данных. Объектные хранилища (S3, ADLS) предлагают встроенную долговечность и географическую репликацию, однако требуют внимания к задержке доступа и согласованию версий.
-
Репликации в кластере: устойчивость к сбоям кластера строится на HA-режимах cluster managers (YARN, Kubernetes, MESOS). В YARN поддерживаются HA-компоненты (ResourceManager, namenode в Hadoop), что позволяет перезапускать управление ресурсами без потери состояния приложений. На Kubernetes Spark может запускать несколько реплик драйвера и исполнителей под контролем оператора, обеспечивая отказоустойчивость на уровне планирования и управления.
-
Управление состоянием и оффсетами: при стриминговой обработке состояние и оффсеты источников (например, Kafka) записываются в чекпойнты и внешние хранилища, что позволяет восстанавливать обработку после сбоев. В случае выходов узлов из строя, повторное чтение оффсетов должно быть детерминированным и согласованным между источником данных и обработкой Spark.
-
Репликация состояния: для_STATESTORE в Structured Streaming роль репликации заключается в сохранении состояния операторов в устойчивом хранилище (чекпойнты + state store). Это обеспечивает корректное восстановление состояния после сбоев и позволяет повторно применить обработку без потери вычислений.
-
Практические аспекты: при проектировании устойчивости следует учитывать требования к задержке, объёму состояния, географической локализации данных и стоимости хранения. Рекомендуется использовать совместные решения: устойчивое хранилище, конфигурации кластерного HA и аккуратное распределение ресурсов на уровне узлов и сетевых зон.
Практические сценарии внедрения: конфигурации, мониторинг и тестирование
Встроенные механизмы надёжности должны быть поддержаны на каждом этапе жизненного цикла проекта: от проектирования до эксплуатации и тестирования. Практические шаги включают:
-
Проектирование архитектуры устойчивости: определить, какие данные требуют высокоуровневой надёжности (чекпойнты, оффсеты, состояние операторов), и выбрать соответствующие хранилища и параметры кластера. Разделение ролей между данными и метаданными упрощает управление и резервирование.
-
Конфигурации хранения: для чекпойнтов и журналов выбрать надёжное хранилище (HDFS/ADLS/S3). Обеспечить достаточный запас по объёму и пропускной способности канала, а также настроить политику хранения (ретеншн, удаление устаревших файлов).
-
Конфигурации кластера: обеспечить HA-режим кластера через менеджеры ресурсов (YARN, Kubernetes) и режимы автоматического перезапуска. В случае Kubernetes использовать готовые операторы Spark, поддерживающие отказоустойчивость драйвера и управляемые конфигурации.
-
Мониторинг и телеметрия: внедрить мониторинг долголетности чекпойнтов, статистик WAL-проходов, состояния state store и прочих критических показателей. Включить алерты на превышение времени восстановления, рост чекпойнтов и частые повторные попытки исполнения задач.
-
Тестирование устойчивости: проводить хаос-инжиниринг с отключениями узлов, сбоев сети и задержек доступа к хранилищу. Проверять корректность восстановления, консистентность оффсетов и повторного воспроизведения состояния операторов.
-
Управление изменениями: внедрять политики миграций и обновлений, чтобы минимизировать риск потери данных. Включать тесты на совместимость версий среды, конфигураций чекпойнтов и WAL с новыми релизами.
-
Примеры сценариев:
- потоковые данные через Kafka с устойчивым чекпойнтом State Store и репликацией на уровне HDFS/ADLS.
- пакетная обработка с большим объёмом промежуточных данных и конфигурируемой частотой чекпойнтов для сокращения времени восстановления.
Key takeaways
- Надёжность Spark достигается за счёт сочетания checkpointing, WAL и репликаций на уровне хранения и кластера, что позволяет восстанавливаться после сбоев без потери данных и с контролируемой задержкой.
- Checkpointing - ключевой инструмент для восстановления прогресса и управления состоянием операторов, особенно в Structured Streaming. Разделение чекпойнтов и данных упрощает управление хранением и восстанавливанием.
- WAL полезен в контексте DStream-подхода и критических входных данных, однако в Structured Streaming роль журналирования чаще играет совместная архитектура чекпойнтов и state store.
- Репликация на уровне хранения и HA-кластера снижают риск потери данных и обеспечивают более плавное восстановление, но требуют грамотного планирования стратегий хранения и конфигураций кластера.
- Эффективная эксплуатация требует баланса между задержкой, объёмами хранения и стоимостью, а также активного мониторинга и тестирования устойчивости.
- В зависимости от источников данных и типа обработки следует выбирать соответствующий набор механизмов: чекпойнты для прогресса и состояния, WAL там, где требуется дополнительная устойчивость к потере входных данных, и надёжная репликация хранения.
- Практические внедрения выигрывают от четкой политики резервирования, разделения ролей хранения и регулярных хаос-инжинирингов для проверки реальной устойчивости системы.
FAQ
- Что именно входит в checkpoint в Spark и зачем он нужен?
Checkpoint в Spark хранит ключевые метаданные прогресса обработки и состояние операторов, а иногда и сами данные, что позволяет при сбое не пересчитывать работу с начала, а продолжить с точки остановки. Для Structured Streaming чекпойнты также сохраняют оффсеты источников и состояние состояний оператора. Это снижает время восстановления и обеспечивает повторяемость вычислений.
- В чем разница между checkpoint и WAL в контексте Spark?
Checkpoint - основное средство сохранения прогресса и состояния в долговременном хранилище, помогающее восстанавливаться после сбоев. WAL - журнал входных данных, применяемый ранее к DStream-подходам и служащий допуском к потере данных до обработки. В современных подходах к Structured Streaming чаще полагаются на checkpoint и state store, хотя принципы WAL остаются концептуально полезными.
- Где лучше хранить чекпойнты и почему это важно?
Локальная файловая система узла не подходит - она уязвима к сбоям отдельных узлов и ограничена доступностью. Лучше использовать долговременное хранилище: HDFS, ADLS, S3. Это обеспечивает устойчивость к отказам узлов, упрощает резервирование и ускоряет восстановление.
- Как выбирать частоту чекпойнтов и влияние на производительность?
Чем чаще чекпойнты, тем выше надёжность и скорость восстановления, но выше I/O и затраты на хранение. Для потоковых задач разумной стратегией является частота, согласующаяся с задержкой и размером состояния, а для пакетной обработки - консервативнее, чтобы не перегружать хранилище. Важно также настроить политику очистки старых чекпойнтов и отбрасывания устаревших состояний.
- Какие сценарии требуют WAL, а какие - нет?**
WAL полезен, когда требуется предельная устойчивость к потере входных данных и гарантия доставки перед обработкой, особенно в DStream-подходах. В Structured Streaming роль WAL часто заменяется чекпойнтами и надёжной хранением состояния. При наличии строгих требований к доставке данных WAL может быть частью архитектуры, но сложность и стоимость хранения возрастает.
- Какие риски связаны с репликацией и как их минимизировать?
Риски включают увеличение затрат на хранение, задержки доступа и сложность синхронизации между географически распределёнными зонами. Минимизировать можно за счёт использования устойчивых хранилищ, чёткой политики ретенции и тестирования сценарием отказов в разных зонах. Важно учитывать, что репликация не снимает необходимость в корректной обработке ошибок и повторной обработке в случае сбоев.
- Как мониторить устойчивость Spark в реальной эксплуатации?
Мониторинг должен охватывать прогресс обработки чекпойнтов, скорость восстановления, размер чекпойнтов, использование диска, состояние state store, увеличение числа повторных попыток задач и время тайм-аута на рестарт. Включение алертирования по ключевым метрикам, интеграция с системами наблюдения (Prometheus, Grafana) и регулярные проверки журналов помогают поддерживать готовность к отказам.
- Какой минимальный набор архитектурных решений необходим для устойчивого кластера?
Необходимы долговременное хранилище для чекпойнтов, конфигурации HA-кластера (HA ResourceManager в YARN или Spark Operator в Kubernetes), мониторинг и автоматическое восстановление, возможность повторного запуска задач на другом узле и изоляция зон доступности данных. Важно обеспечить согласованность оффсетов и состояния между источниками данных и обработкой.
- Как интегрировать надёжность Spark с облачными хранилищами?
Облачные хранилища обеспечивают долговечность и географическую репликацию, но могут добавлять задержку. Необходимо учитывать задержки доступа, консистентность версий и стоимость операций. Рекомендуется использовать такие хранилища как S3/ADLS для чекпойнтов и состояния, а также тщательно настраивать и тестировать политики доступа и каталоги для безопасного восстановления.
- Какие типовые ошибки возникают и как их диагностировать?
Типичные ошибки: разница версий библиотек и перерегистрации чекпойнтов, нехватка места на хранилище, несоответствие оффсетов между источником и обработкой, чрезмерная задержка из-за частых чекпойнтов. Диагностика основана на анализе логов драйвера и исполнителей, статусе Structured Streaming/ DStream и метриках кластера, а также на повторной проверке сценариев восстановления через хаос-инжиниринг.


