

Организуем High Availability PostgreSQL
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Григорий Тарасенко @gle4er
В этой статье расскажу про High Availability (HA) в PostgreSQL. Сначала мы выясним, что такое HA и зачем оно нужно, потом посмотрим, как можно построить отказоустойчивость без погружения в PostgreSQL. А затем покажу готовые решения для организации High Availability и расскажу, как это всё выглядит в Авито.
Основные понятия: HA, RTO, RPO
High Availability (HA) — свойство системы обеспечивать максимально продолжительную доступность даже при отказе компонентов из-за аварии. Когда происходит авария, бизнес хочет мгновенно восстановиться. Вопрос в том, сколько занимает это «мгновенно» — об этом говорит метрика RTO.
Recovery Time Objective (RTO) — это максимально допустимое время простоя или недоступности системы, после которого она должна восстановиться и снова работать. Чем меньше есть времени на восстановление, тем меньше данных мы можем восстановить. О том, какой объём данных мы готовы потерять, говорит метрика RPO.
Recovery Point Objective (RPO) — это максимально допустимая потеря данных или период времени, в течение которого система может быть восстановлена до последнего сохраненного состояния.
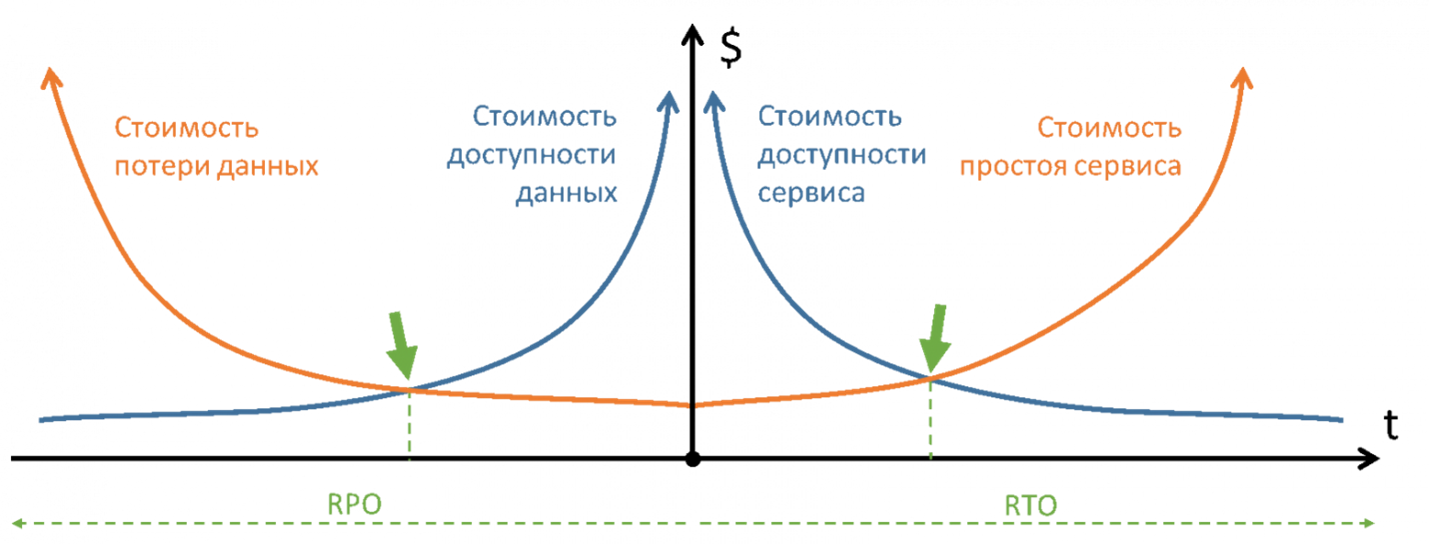
Чем меньшее время простоя сервиса обеспечивает решение по защите, тем дороже такая защита стоит. Источник (Хабр)
RTO и RPO обычно определяются как золотая середина между стоимостью потери данных или простоя и доступности сервиса. Чем меньшее время простоя сервиса обеспечивает защита, тем дороже она стоит.
Простой в 1 минуту из-за падения не будет стоить дорого для бизнеса. А вот чтобы восстановить БД за 1 минуту, нужны космические средства: поддержка инфраструктуры, планов восстановления, людей. Аналогично — с RPO.
Возможные решения для организации High Availability
Поговорим про 3 возможных решения по организации High Availability, которые первыми приходят в голову. Для них не нужно погружаться в PostgreSQL, но у них много минусов.
Виртуализация. Первое решение — настроить кластер виртуализации с общей СХД. Если сервер с виртуальной машиной базы откажет, ВМ перезапустится на другом сервере.
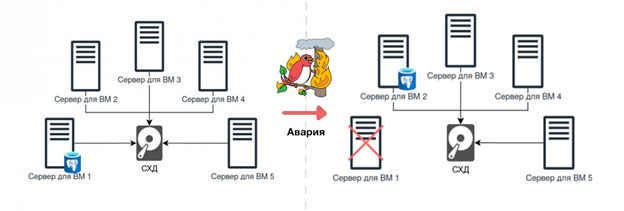
Происходит авария, отказывает сервер с ВМ базы. ВМ с БД перезапускается на другом сервере
Минусы такого решения:
- кто-то может утилизировать все IO СХД (эффект «шумного соседа»),
- не защитит при потере ДЦ,
- не страхует при ошибках ОС и БД,
- может быть дорогой: и по деньгам, и по вычислительным ресурсам.
Преднастроенная база. Другое решение — заранее купить и настроить сервера, чтобы база восстанавливалась по расписанию: например, два раза в день. Из плюсов — в среднем случае это позволит сэкономить RTO.
Из минусов:
- не подойдёт для больших баз с высокой активностью,
- в худшем случае — большее RPO, чем при виртуализации.
Множество копий базы. Третье решение, которое может прийти в голову, — писать сразу в несколько баз. Так мы получим Multi-Master, масштабирование по чтению и крайне низкие RTO/RPO — за счёт того, что все БД онлайн.
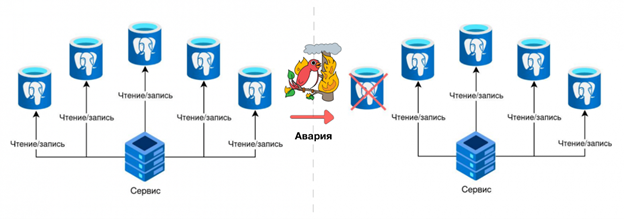
Происходит авария, одна копия БД отваливается. Сервис перестаёт обращаться к этой копии и забирает данные из других
Минусы этого решения:
- непонятно, что делать, если база перегружена, но не мертва;
- реализовать и администрировать собственное решение, чтобы согласовать не дошедшие изменения;
- плохо масштабируется при решении в лоб;
- трудно поддерживать консистентность.
High Availability в PostgreSQL с помощью WAL-репликации
Мы рассмотрели решения организации High Availability без погружения в особенности БД. Но лучше сделать отказоустойчивое решение на уровне базы. В PostgreSQL есть журнал предзаписи — Write-Ahead Log, мы можем попробовать этим воспользоваться.
Write-Ahead Logging (WAL) — это механизм последовательной фиксации изменений в данных. Журнал предварительной записи позволяет восстановить БД до последнего сохранённого состояния, если произойдёт сбой. При записи операции в БД она сначала записывается в WAL. Только после этого происходит фактическое выполнение операции. Поскольку WAL пишется последовательно, мы можем воспроизвести все операции, пройдясь по записям в журнале.
Подробнее про WAL в документации PostgreSQL
Статья WAL в PostgreSQL: Журнал предзаписи
В PostgreSQL 9.0+ есть механизм потоковой репликации WAL. Он позволяет не ждать создания целого WAL-файла со всеми изменениями, а применять изменения, как только они появляются. С потоковой репликацией WAL-записи отправляются с Primary-сервера на одну или несколько реплик.
Настройка потоковой репликации в PostgreSQL требует конфигурации параметров на обоих серверах — primary и реплике, при необходимости, дополнительной настройки слотов репликации. После настройки репликации primary будет непрерывно передавать WAL-записи на реплику, обеспечивая постоянную синхронизацию данных между системами.
Подробнее про потоковую WAL-репликацию
Готовые решения для High Availability в PostgreSQL
В PostgreSQL есть множество готовых решений для организации High Availability.
-
repmgr (Replication Manager for PostgreSQL) — пионер в High Availability для PostgreSQL. Написан на C как расширение и как внешняя программа. Поддерживает Witness-ноды.
repmgr на GitHub -
Patroni — внешний сервис на Python. Работает через DCS. Есть REST API и поддержка k8s. Можно настраивать PostgreSQL в одном месте.
Patroni на GitHub - Stolon — решение на Golang с поддержкой k8s. Состоит из нескольких компонентов:
- sentinel следит за состоянием кластера,
- keeper разворачивается рядом с PostgreSQL и выполняет настройку,
- proxy указывает, к кому подключаться для чтения/записи.
-
Corosync + Pacemaker. Шаблон HA для кластеризации любых ресурсов через написание своих скриптов.
Corosync на GitHub
Pacemaker на GitHub -
PAF (PostgreSQL Auto Failover). Готовые скрипты для Corosync + Pacemaker.
PAF на GitHub -
pg_auto_failover. Расширение и программа на C. По духу похож на repmgr.
pg_auto_failover на GitHub -
Bucardo. Perl-программа, которая обеспечивает логическую Multi-Master репликацию.
Bucardo на GitHub -
EDB (aka 2ndQuandrant BDR). Enterprise-решение, обещающее доступность 99,99%+ за кучу денег.
Официальный сайт EDB
High Availability в Авито: организация
Вот стек, который мы используем для организации High Availability:
- PostgreSQL 15 с асинхронной потоковой репликацией.
- Patroni для управления High Availability и конфигурацией кластера.
- Consul в качестве распределенного хранилища конфигурации (Distributed Configuration Store, DCS) для Patroni.
- Ceph в качестве хранилища резервных копий.
- WAL-G для работы с бэкапами.

Так выглядит наша High Availability
Дополнительно мы обеспечиваем отказоустойчивость на уровне железа. В Авито несколько БД и сетевых карт, кластер PostgreSQL распределён на нескольких датацентрах, а ещё мы используем RAID.
Для управления RTO и RPO мы используем следующие настройки:
- loop_wait = 10 секунд — для управления запросами в DCS;
- retry_timeout = 55 секунд — для управления запросами в DCS;
- ttl = 2 минуты — сколько живёт информация о текущем лидере;
- master_start_timeout = 2 минуты — сколько ждать лидера, если он не отзывается;
- maximum_lag_on_failover = 160 Мб — сколько данных разрешено потерять.
При такой организации High Availability гарантируются такие показатели:
- RTO в худшем случае: 2 минуты,
- RPO в худшем случае: 160 Мб.
Больше деталей про управление высокодоступными PostgreSQL-кластерами
Защита от Split Brain
Если участники High Availability заизолировались, то без должной обработки возникнет несколько лидеров: primary, которые выиграли гонку за ключ. Они не будут синхронизироваться и в каждого из них будут писаться разные данные. Это может случиться, например, если ляжет сеть. Такая проблема называется Split Brain, потому что мозг как бы поделился, и каждая часть знает только что-то своё.
Проблема Split Brain возникает, когда единый кластер разделяется на несколько изолированных частей, каждая из которых продолжает работу без синхронизации.
В случае Split Brain, система не может определить кто истинный лидер, поэтому одновременно появляется несколько лидеров. В таком случае в системе больше нет единого источника правды.
Для решения Split Brain мы используем Patroni в связке с Consul (в качестве DCS):
- пока в DCS TTL лидера обновляется, реплики не могут начать голосование, даже если они не получают WAL;
- если возникают проблемы с DCS, то и лидер, и реплика перестают обрабатывать запросы;
- если живых узлов Consul меньше половины, то он приостанавливает обслуживание (согласно алгоритму Raft).
Raft — это алгоритм консенсуса, который гарантирует согласованность данных в распределённой системе. Он позволяет однозначно и явно выбрать лидера и реплицировать данные в ненадежных условиях.
Добавление и удаление реплики
Добавление реплики происходит в три этапа:
- Patroni узнает о лидере при помощи единого источника правды — Consul.
- Реплика PostgreSQL создаётся из бэкапа в Ceph.
- Реплика PostgreSQL догоняет лидера при помощи бэкапов WAL.
Когда реплика догоняет лидера, включается потоковая репликация.
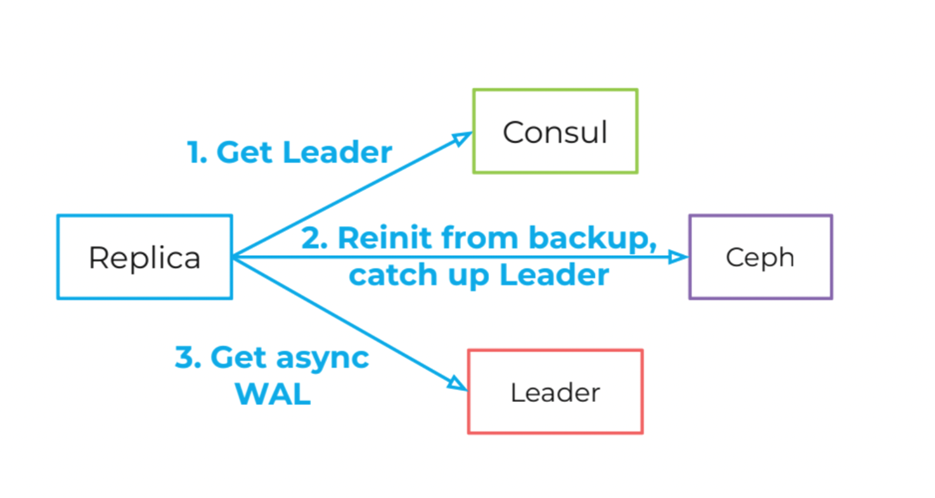
Так происходит добавление реплики в системе High Availability в Авито
Удаление реплики происходит сильно проще. Достаточно остановить сервис Patroni на реплике и выключить/удалить/забыть её.
Отказ лидера
Вот, как происходит смена лидера в случае его отказа в нашей High Availability инфраструктуре:
- Реплики опрашивают DCS с интервалом loop_wait (10 секунд), ожидая ответ в течение retry_timeout (55 секунд).
- Если лидер перестал отмечаться в Consul спустя ttl (2 минуты) или PostgreSQL не работает спустя master_start_timeout (2 минуты), мы считаем его недоступным.
- Если лидер не объявился, начинаются выборы с учётом maximum_lag_on_failover (160 Мб) и времени, на которое отстала физическая реплика (при прочих равных, выиграет та реплика, которая имеет наименьшее отставание).

Так происходит отказ от лидера в системе High Availability в Авито
Полезные ссылки
Материалы по теме
- Документация PostgreSQL. Репликация.
- Документация PostgreSQL. High Availability.
- Документация PostgreSQL. Write-Ahead Logging.
- Документация PostgreSQL Pro. Трансляция журналов на резервные серверы.
- Объяснение принципа работы протокола Raft с визуализацией.
- Туториал на Хабре: «Управление высокодоступными PostgreSQL кластерами с помощью Patron».
- Статья на Хабре про RTO и RPO.
Готовые решения для High Availability в PostgreSQL
- Replication Manager (repmgr) на GitHub.
- Patroni на GitHub.
- Stolon на GitHub.
- Corosync на GitHub.
- Pacemaker на GitHub.
- PostgreSQL Auto Failover (PAF) на GitHub.
- pg_auto_failover на GitHub.
- Bucardo на GitHub.
- Официальный сайт EDB.
Решения, которые мы используем в Авито для организации High Availability:
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Григорий Тарасенко @gle4er


