Разработка плагина Trino для пользовательского типа данных: архитектура, реализация, тестирование и внедрение
Введение: цель и контекст создания плагина Trino для пользовательского типа данных
Современная корпоративная аналитика часто сталкивается с необходимостью работать не только с встроенными типами данных SQL, но и с более сложными структурами. В таких случаях эффективное решение - расширение возможностей SQL-движка за счет поддержки пользовательских типов данных. В контексте Trino, распределенного движка обработки SQL-запросов, это расширение достигается через плагинную архитектуру, основанную на сервис-провайдерах (SPI, Service Provider Interface). Глубокое освоение архитектуры плагинов и практических паттернов реализации пользовательского типа позволяет не только снизить количество извне обложенных преобразований, но и обеспечить нативную интеграцию через механизм чтения, записи, конвертации и сопоставления значений с фреймворками JVM.
Целью данной статьи является подробное изложение концепций и практических шагов по созданию плагина, реализующего новый тип данных my_custom_type. В рамках подхода «от концепции к реализации» мы рассмотрим архитектурные принципы, специфику сигнатур типов, оформление классов и паттернов проектирования, а также вопросы тестирования, развёртывания и эксплуатации в реальном сервере Trino. В конце даются практические кейсы применения, анализ рисков и дорожная карта внедрения в рамках корпоративной экосистемы.
Разделы статьи строятся вокруг логики: сначала формулируются принципы и базовые понятия, затем - конкретная реализация и интеграционные детали, после чего - эксплуатация и кейсы применения. Такой подход обеспечивает не только теоретическую основательность, но и воспроизводимость решений в разных инфраструктурах и версиях Trino.
Теоретическая база: архитектура плагинов Trino и роль SPI в расширяемости
Архитектура плагинов в Trino опирается на модульность и инкапсуляцию изменений. Основная идея состоит в том, что базовый сервер способен подхватывать сторонние реализации через контрактные интерфейсы, не требуя изменения внутреннего ядра. В рамках этой архитектуры плагин предоставляет новые функции - например, новые типы данных, функции, источники данных и т. п. - и регистрирует их через механизм SPI. Это позволяет разворачивать функциональные расширения независимо от версии ядра, обеспечивая гибкость и устойчивость к прогрессу технологических стеков.
Ключевым понятием здесь является интерфейс Plugin, который служит точкой интеграции между плагином и сервером Trino. Реализация данного интерфейса обеспечивает доступ к регистрации материалов плагина (типы данных, функции, коннекторы и пр.) через единый контракт. Помимо этого, в контексте типов данных центральное место занимает абстракция Type и сигнатура типа (TypeSignature). Типы данных в Trino не являются абстрактной декларацией: каждый тип должен реализовать методы преобразования значений, сравнения, хеширования и конвертации между внутренними структурами блоков и внешними объектами Java.
Для расширяемости критически важно понимание того, как сигнатура типа описывает идентичность типа и его параметры. ТипSignature несет в себе имя типа и список параметров, если они присутствуют (например, VARCHAR(10) - параметр длины). Взаимодействие между типами и блоками данных реализуется через концепцию Block и BlockBuilder - контейнеры, которые Трино использует для обработки столбцов в партидах и разделах выполнения запроса. В этом контексте пользовательский тип интегрируется через соответствующую реализацию Type, которая знает, как «упаковывать» и «распаковывать» значения внутри блоков, как осуществлять копирование значений между блоками и как отображать значение в виде строки.
Таким образом, теоретическая база строится на трех столпах: (1) модульность и SPI-подход к расширяемости, (2) абстракции типов данных и их сигнатуры, (3) концепции блоков данных и конвертации значений внутри движка. Понимание этих элементов позволяет грамотно спроектировать плагин так, чтобы он не только работал в рамках текущей версии Trino, но и был устойчив к изменениям API и переосмыслению внутренних реализаций в будущих релизах.
Декомпозиция технических компонентов плагина: модули и их взаимодействие
Стратегия построения плагина предполагает модульное разделение по функциональным зонам. В типовом плагине для пользовательского типа данных можно выделить следующие модули и связи между ними:
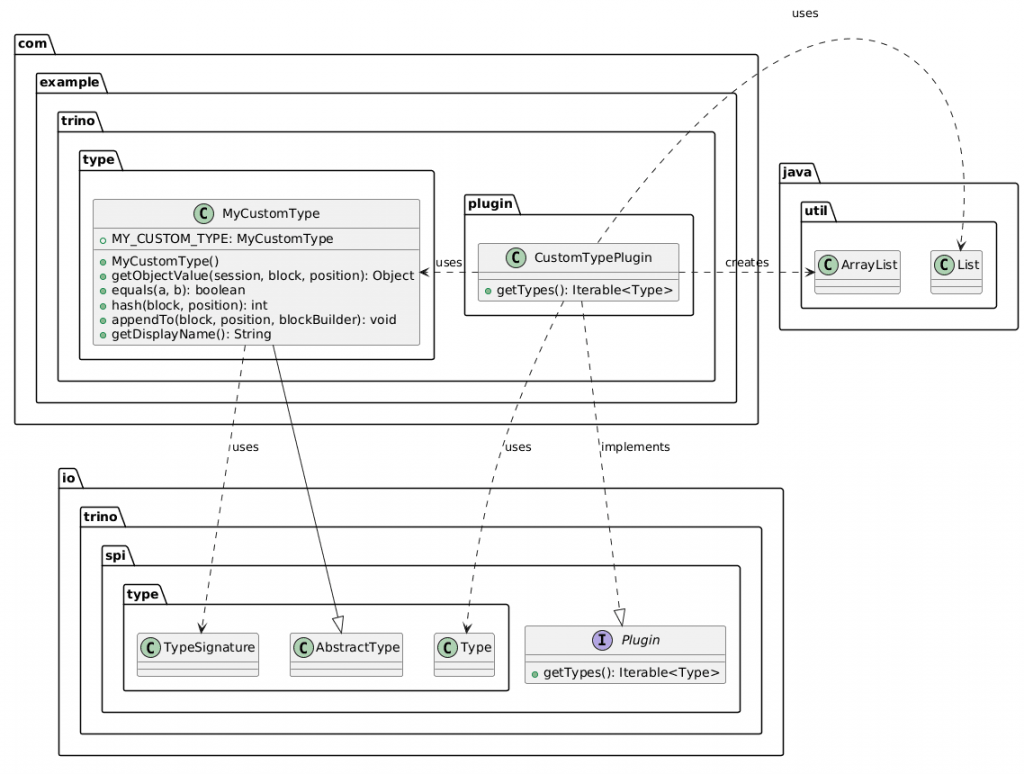
Тип данных (MyCustomType): реализация класса, наследующегося от базового типа (AbstractType) и определяющего специфику сигнатуры, кодирования и поведения операций. Этот модуль отвечает за инкапсуляцию логики преобразования между блоками и Java-объектами, сравнение значений и их маршалинг в блоки.
Плагин регистрации (CustomTypePlugin): реализация интерфейса Plugin, регистрирующая созданный тип в контексте сервера Trino и возвращающая коллекцию доступных типов. Этот модуль обеспечивает связь между конкретной реализацией типа и инфраструктурой плагина.
Конфигурация проекта (pom.xml): управление зависимостями, версиями Java, плагином компилятора и настройками сборки. Этот модуль задает базовую инфраструктуру для повторяемости сборок и совместимости со своими зависимостями.
Ресурсы и дескрипторы: файл plugin.properties, ресурсы и метаданные, которые помогают загрузке плагина на этапе инициализации. Эти артефакты должны быть доступны в итоговом артефакте инициализации сервера.
Тесты и качество кода: директория src/test/java, где размещаются модульные и интеграционные тесты. Этот модуль обеспечивает устойчивость к регрессиям и демонстрирует, что реализованные методы работают корректно в рамках типовых сценариев.
Деплой и эксплуатация: сценарий размещения JAR-файла в каталоге плагинов Trino и перезапуск сервера для регистрации новых объектов типа. Этот модуль описывает практику внедрения в реальном окружении.
Взаимодействие между этими модулями строится через DI (Dependency Injection) и сервис-локаторы, характерные для SPI. При инициализации сервера плагин регистрирует свой набор типов через метод getTypes(), который возвращает коллекцию объектов Type. Затем сервер Trino включает эти типы в реестр типов, чтобы они стали доступными для определения в DDL и SQL-операциях. Поскольку в большинстве современных версий Trino плагинная инфраструктура зависит от Maven и системы модульности, правильная настройка зависимостей и совместимости версий Java критически важна для корректной работы на разных инсталляциях.
Определение пользовательского типа: сигнатура, кодирование и сопоставление с Java
Определение пользовательского типа начинается с ясной сигнатуры, которая идентифицирует тип в рамках всего пространства типов Trino. Типовая сигнатура состоит из имени типа и, при наличии, списка параметров. Эти параметры могут включать размер VARCHAR, точность DECIMAL или другие характеристики, которые определяют семантику типа. Важной частью является сопоставление с Java: каждому типу соответствуют Java-объекты, которые будут использоваться в фазах выполнения запроса на стороне клиента, коннектора и пользовательского кода.
Ключевые принципы определения сигнатуры:
Идентичность типа: имя типа и параметры должны однозначно описывать тип в рамках всего окружения Trino. Любое изменение сигнатуры считается выпуском нового типа.
Управление кодированием: каждый тип несет собственную нативную кодировку значения в контейнере типа. Это кодировка определяет, как значение сериализуется в блоках данных и как его можно эффективным образом восстановить.
Связь с Java: тип должен уметь работать с Java-представлением значения через методы типа, такие как getObjectValue, equals, hash и другие операции, что обеспечивает взаимодействие между хранением данных в блоках и их использованием в Java-коде.
Для эффективной реализации пользовательского типа крайне важно заранее продумать план кодирования значений внутри блока. В некоторых случаях значение хранится напрямую в Java-объекте, в других - в виде буферизированной памяти (Slice) или в сочетании примитивов. Понимание нативной кодировки позволяет оптимизировать производительность запросов, минимизируя конверсии и копирования при выполнении агрегаций, фильтрации и сортировки.
Реализация пользовательского типа MyCustomType: структура класса и паттерн Singleton
Практическая реализация начинается с создания класса MyCustomType, который должен соответствовать контракту Type и обеспечивать корректное поведение в контексте Trino. В рамках примера мы используем класс, реализующий паттерн Singleton для единственного инстанса типа и избегания повторных создание объектов типа, что упрощает их использование в плагине.
Структура класса: MyCustomType наследуется от базового AbstractType, который реализует общие механизмы для всех пользовательских типов и позволяет определить сигнатуру через конструктор. В конструкторе задается TypeSignature, который фиксирует имя типа, например "my_custom_type", и сопоставляемый Java-класс (в примере - Object.class, что свидетельствует о необходимости детальной реализации преобразований в рамках конкретной задачи).
Singleton: объявление публичного статического финального экземпляра типа обеспечивает глобальную единицу доступа и упрощает ссылку на тип в других компонентах плагина. Это снижает накладные расходы на создание объектов и упрощает сравнение.
Методы, которые обязательно реализуются внутри MyCustomType:
getObjectValue: отвечает за преобразование значений из блока (Block) в Java-объект. Это критически важный шаг для обеспечения корректной интерпретации значений на стороне клиента и в пользовательском коде. В реальной реализации здесь выполняется разбор блока, извлечение данных на позиции и конвертация в понятную Java-структуру (например, в класс-обертку или примитив).
equals: обеспечивает корректное сравнение значений типа. В большинстве случаев реализация основывается на сравнение содержимого внутри блоков или полезной конфигурации типа.
hash: вычисляет хеш-код значения, что важно для использования в хеш-таблицах и операциях группировки.
appendTo: копирует значение из одной позиции блока в другой блокBuilder, что востребовано в операциях копирования, вставки и агрегации внутри выполнения запроса.
getDisplayName: возвращает человеко-читаемое имя типа, которое будет отображаться в метаданных и диагностических данных.
В дополнение к этим методам тип обеспечивает сигнатуру и идентичность. В рамках Singletonpattern и архитектурной дисциплины мы держим экземпляр типа в публичной константе, коей мог бы пользоваться плагин и другие компоненты процессора запросов. В результате получается чистый, повторно используемый и предсказуемый тип, который легко интегрировать в механизмы сериализации, конвертации и сравнения внутри Trino.
Развитие класса собственного типа требует вдумчивого проектирования: с одной стороны, он должен быть достаточно абстрактным, чтобы позволять гибкую кодировку значений, с другой - достаточно конкретным, чтобы поддерживать оптимизированные обходы и минимальные накладные расходы. Важным является соблюдение контрактов, установленных интерфейсами SPI, чтобы обеспечить предсказуемость поведения в рамках всего сервера.
Реализация основных операций типа: getObjectValue, equals, hash, appendTo и display name
Глубокая реализация основных операций типа начинается с определения того, как именно значения типа представлены внутри блоков данных и как они конвертируются в Java-объекты. В конкретной реализации MyCustomType:
getObjectValue: реализация должна извлекать данные из блока на заданной позиции и преобразовывать их в удобный для приложения Java-объект. Это может быть схема, где данные хранятся в форме Slice или примитивов, и требуется декодирование в желаемую структуру. Этап декодирования часто требует учета кодировки и конфигурации типа, что позволяет обеспечить корректную трансляцию в контекст приложения.
equals: сравнение значений требует аккуратной работы с нативной кодировкой. В большинстве случаев реализуют сравнение по содержимому «состава» значения внутри блока или по бинарному соответствию, если значения хранятся в Slice. Важна безошибочная идентичность двух значений, включая поддержание консистентности в рамках разных блоков и срезов.
hash: хеш-функция должна быть детерминированной и эффективной. Часто реализуется через арфметику хеширования содержимого блока на позиции и параметров типа. В случаях, когда значение хранится как сериализованный блок, можно применить существующие хеш-функции к представлению данных или вычислять специализированный хеш на основе древних структур.
appendTo: копирование значения между блоками реализуется через вызов методов BlockBuilder или через манипуляцию Slice. Важна корректная передача метаданных, сохранение целостности значения и соответствие правилам копирования, чтобы последующая обработка запросов не являлась источником ошибок.
display name: метод getDisplayName возвращает строку, которая в дальнейшем используется в описании типа и его представлениях в интерфейсах пользователя. Обычно это простое имя типа, например "my_custom_type", но может быть и более полезной формой, если требуется локализованное отображение.
Эти методы формируют основу поведения типа в Trino и непосредственно влияют на корректность выполнения запросов, особенно в контекстах сортировки, агрегации и объединения данных по пользовательскому типу. Важно тестировать их в рамках обычных сценариев - работа со столбцами, условия фильтрации и соединения таблиц с участием пользовательского типа.
Типовая сигнатура и идентичность: роль TypeSignature и параметры типа
Типовая сигнатура является способом идентифицировать тип внутри экосистемы Trino и кодировать его параметры, если они есть. В контексте нашего примера типовой сигнатурой служит объект TypeSignature с именем "my_custom_type" и, возможно, набором параметров. В простейшем случае параметры отсутствуют, однако в более сложных сценариях сигнатура может включать параметры, которые управляют поведенческими характеристиками типа (например, размер вектора, ограничение на длину, маску формата и т. п.).
Основные принципы:
Идентичность через сигнатуру: две реализации типа считаются одинаковыми, если их TypeSignature совпадают по имени и параметрам. Это критично для кэширования, сравнения и оптимизаций внутри планировщика.
Расширяемость: сигнатура должна позволять добавлять параметры в будущих версиях без нарушения совместимости - новый параметр потребует соответствующего обновления логики преобразований и хранения.
Отображение в SQL и логика чтения: сигнатура служит мостом между SQL-уровнем и Java-уровнем, позволяя генераторам SQL валидно конструировать выражения и отображать тип в метаданных результата.
Идентичность типа зависит не только от сигнатуры, но и от того, как он сопоставляется с Java-классом и как именно реализуется сериализация/десериализация значений. В практике это означает, что TypeSignature не просто текстовый идентификатор; он несет смысловую нагрузку и влияет на поведение во всех фазах выполнения запроса: планирование, выполнение и оптимизацию.
Регистрация типа в Trino через плагин: CustomTypePlugin и метод getTypes
Регистрация пользовательского типа в Trino осуществляется через плагин, реализующий интерфейс Plugin. В рамках плагина создается класс CustomTypePlugin, который возвращает коллекцию необходимых типов через переопределение метода getTypes(). Этот подход позволяет плагину добавлять новые типы в глобальный реестр серверного окружения.
Реализация CustomTypePlugin: класс реализует интерфейс Plugin и предоставляет метод getTypes(), в котором формируется список типов, актуальных для данного плагина. В примере мы добавляем в список наш тип MyCustomType.MY_CUSTOM_TYPE и возвращаем его в виде Iterable. Это обеспечивает прямую интеграцию типа в архитектуру Trino без изменений в ядре сервера.
Механизм регистрации: после загрузки плагина сервер Trino вызывает getTypes() и регистрирует возвращаемые типы в реестре типов. Далее тип становится доступным для использования в DDL-операциях (CREATE TABLE, DEFINE COLUMN, и т. п.), а также в SQL-запросах и планировании выполнения. Важно, чтобы плагин корректно обрабатывал жизненный цикл и регистрировал типы в момент загрузки.
С точки зрения проектирования архитектуры, модуль CustomTypePlugin изолирует ответственность за регистрацию типов от реализации самого типа. Это позволяет в дальнейшем заменять или дополнять набор типов без затрагивания бизнес-логики плагина и упрощает повторное использование в других проектах, где потребуются аналогичные пользовательские типы.
После регистрации тип становится доступным для используемой среды. В простом сценарии это означает, что SQL-запрос вида: CREATE TABLE example ( id INT, data my_custom_type ); будет корректно разобран и выполнен, поскольку сервер знает, как хранить, конвертировать и обрабатывать значения типа my_custom_type внутрь своих механизмов блоков и выполнения.
Взаимодействие типов с блоками данных: хранение, чтение и конвертация внутри Trino
Основная задача типа - корректно и эффективно взаимодействовать с блоками данных внутри Trino. Блоки являются упакованными структурами, которые хранят значения по столбцам и позициям. Взаимодействие включает:
Хранение: внутри блока данные типа my_custom_type кодируются в нативной форме (например, как Slice или иной интерфейс памяти) и сопоставляются с сигнатурой типа. Важна консистентность форматов и отсутствие потерь данных при копировании блока.
Чтение: операции чтения должны аккуратно извлекать значение на конкретной позиции и корректно преобразовывать его в Java-объект через getObjectValue. Это обеспечивает корректное использование значения в бизнес-логике и пользовательском коде.
Конвертация: конвертация между внутренней формой данных и внешним представлением (например, отображение в строку через getDisplayName или сериализация в формат, подходящий для вывода) - часть важной функциональности. Элементы, которые не были напрямую представлены в Java, требуют внимательного проектирования кода-декодера.
Операции над данными: тип должен корректно поддерживать операции сравнения (equals), копирования (appendTo) и хеширования (hash) в контексте блоков data. Это обеспечивает корректное выполнение группировок, агрегаций и ребалансировки памяти в процессе выполнения запроса.
Определение нативной кодировки значения типа - одна из критических стадий. Она влияет на производительность операций и способность масштабировации. В случаях архитектуры, где тип хранится как объект Java или в виде Slice, следует учитывать особенности маршалинга, копирования и совместимости между нативной формой данных и сериализацией. Правильное проектирование этого аспекта обеспечивает эффективный и предсказуемый процесс обработки данных.
Maven-проект и управление зависимостями: pom.xml, зависимые артефакты и Java 11+
Для разработки плагина Trino необходим Maven - популярный инструмент сборки и управления зависимостями в экосистеме Java. В контексте плагина для пользовательского типа данных Maven служит основой для организации кода, управления зависимостями и сборки артефактов. В простейшем случае проект содержит:
Файл pom.xml, где задаются:
groupId и artifactId, идентифицирующие проект в репозитории Maven;
version, фиксирующий версию артефакта;
properties, включая trino.version для указания совместимой версии Trino и параметры компилятора (указание Java 11+);
dependencies, где определяется зависимость на trino-plugin-base в рамках provided-сцены (плагин-основание, которое используется на этапе компиляции и сборке, но не входит в итоговый артефакт);
сборочные плагины, например maven-compiler-plugin, с настройками source и target на 11 или выше, что обеспечивает совместимость с Java 11+ и корректную компиляцию модулей.
Структура каталога:
src/main/java - исходники плагина;
src/main/resources - ресурсы, включая plugin.properties;
src/test/java - тесты плагина.
Такой подход гарантирует воспроизводимые сборки и совместимость с экосистемой Trino. В рамках проекта рекомендуется также фиксировать версии зависимостей и обеспечивать тестирование на конкретной версии Trino (например, 470.x, как приведено в примере). Это снижает риски несовместимостей при обновлениях и обеспечит предсказуемый процесс сборки в рамках CI/CD. Важной частью является конфигурация компилятора и цели Java - это обеспечивает корректную совместимость с требованиями целевой среды выполнения и систем безопасности.
Реализация плагина: реализация интерфейса Plugin и структура пакетов
Реализация плагина начинается с создания класса CustomTypePlugin, который реализует интерфейс io.trino.spi.Plugin. Этот интерфейс определяет набор контрактов, через которые плагин взаимодействует с движком Trino. В рамках реализации:
CustomTypePlugin реализует метод getTypes(), возвращающий iterable коллекцию объектов Type. Это позволяет инстанцировать зарегистрированные типы и включить их в реестр серверного контекста.
Пакетная структура плагина (например, com.example.trino.plugin) должна быть организована так, чтобы отделить логику регистрации типов от бизнес-логики самого типа (MyCustomType). Это облегчает повторное использование и тестирование, а также обеспечивает прозрачную интеграцию с другими плагинами.
Типовая реализация типа (MyCustomType) находится в отдельном модуле (com.example.trino.type), что соответствует принципу разделения ответственности и облегчает управление зависимостями.
Структура классов в реальном проекте может выглядеть следующим образом:
com.example.trino.type.MyCustomType - класс типа, реализующий AbstractType и обеспечивающий методы getObjectValue, equals, hash, appendTo, getDisplayName.
com.example.trino.plugin.CustomTypePlugin - плагин, реализующий Plugin, возвращающий MyCustomType.MY_CUSTOM_TYPE через getTypes.
Plugin-слой связывает эти две части, позволяя типу существовать независимо от кода плагина.
Такой дизайн способствует чистоте архитектуры и обеспечивает легкость поддержки. При изменении логики типа достаточно поменять реализацию внутри типа, не затрагивая механизм регистрации и регистрации плагина в целом.
Конфигурация сборки: Maven Compiler Plugin, параметры source/target и версии
Процесс сборки плагина требует аккуратного конфигурирования Maven. В pom.xml проекта указываются:
plugin-блоки для maven-compiler-plugin с настройками 11 и 11, чтобы обеспечить совместимость с Java 11 и выше. Это критично, поскольку Trino и экосистемы базируются на JVM, а новые версии языка часто требуют соответствующих настроек компилятора.
зависимости: например, io.trino: trino-plugin-base как предоставляемая зависимость (scope provided), что означает, что плагин будет собран с этой зависимостью, но она не включена в итоговый артефакт. Это обеспечивает совместимость версий с конкретной установкой Trino.
версии Trino в properties, например <trino.version>470</trino.version>, чтобы обеспечить совместимость с API плагинов в рамках конкретной ветви сервера.
конфигурация сборки и сигнатуры, чтобы артефакт корректно отображался в хранилищах и был доступен для загрузки в каталоге плагинов сервера.
Эти настройки гарантируют воспроизводимость сборки, предсказуемость зависимостей и безопасную интеграцию в существующую инфраструктуру. Также важно обеспечить совместимость с системами сборки CI/CD, которые будут выполнять тестирование и разворачивание плагина в тестовых или продовых средах.
Ресурсы и дескрипторы: plugin.properties, размещение ресурсов и артефакты сборки
Файлы ресурсов и дескрипторы обеспечивают загрузку и регистрацию плагина в рамках окружения Trino. В корне проекта обычно размещается файл plugin.properties в директории src/main/resources с содержанием:
Это описание позволяет движку плагинов находить главный класс и регистрировать плагин в процессе загрузки. Ресурсы и дескрипторы должны быть упакованы в итоговый JAR-артефакт и доступны в каталоге плагинов Trino. Правильная укладка ресурсов обеспечивает корректную загрузку и инициализацию плагина во время старта сервера. В рамках практики полезно также хранить вспомогательные файлы, такие как документация, тестовые данные и константы конфигураций, в resources, чтобы обеспечить доступность во время выполнения.
Стратегия размещения артефактов предполагает, что финальный JAR-плагин копируется в каталог плагинов Trino на целевой машине или в окружении, где запускается сервер. Это позволяет серверу подгрузить плагин на старте или при перезагрузке, после чего новый тип становится доступен для SQL-запросов и DDL.
Стратегия тестирования и качество кода
Стратегия тестирования включает несколько уровней:
Юнит-тесты: проверить базовую логику методов GetObjectValue, Equals, Hash, AppendTo и DisplayName. Тесты охватывают конвертации, корректность копирования и устойчивость к некорректным входным данным.
Интеграционные тесты: проверить взаимодействие плагина и сервера Trino в окружении, где плагин загружен, и выполняются реальные SQL-запросы, включающие пользовательский тип. В рамках таких тестов проверяется корректность регистрации типа, чтение и запись значений в блоках, и поведение при агрегациях и соединениях.
Тесты на совместимость: проверка корректной работы с разными версиями Trino и JVM, а также на совместимость с конфигурациями пула памяти и параметрами выполнения запроса.
Анализ кода и качество: внедрение статического анализа, проверок на стиль кода и обеспечение высокой читаемости кода, а также документирование каждой части реализации.
Эти шаги обеспечивают высокий уровень надёжности и предсказуемости поведения в рамках корпоративной инфраструктуры. Важной частью является поддержка CI/CD, которая автоматически запускает тесты при каждом изменении и гарантирует, что изменения не нарушают существующий функционал.
Развертывание и эксплуатация: размещение JAR в каталоге плагинов и перезапуск сервера
Развертывание плагина предполагает следующие этапы:
Сборка артефакта: выполнить команду mvn clean package, чтобы получить JAR-плагин в целевой директории target.
Размещение артефакта: скопировать полученный JAR в каталог плагинов Trino на целевой машине, например в каталог plugin.
Перезапуск сервера: после размещения JAR требуется перезапуск Trino или горячая перезагрузка плагинов, чтобы сервер регенерировал реестр типов и просто стал доступен новый пользовательский тип в SQL.
Проверка: выполнить тестовые SQL-запросы и DDL для верификации корректности регистрируемого типа, а также проверку, что тип корректно интегрирован в планировщик и обработку запросов.
Правильное развертывание требует учёта целей эксплуатации - от одного тестового узла до крупной распределенной инфраструктуры. В случае эксплуатации в продакшн среде, рекомендуется провести предварительное тестирование на обезличенных данных и в безопасной среде, чтобы минимизировать риски потери данных или задержек во время выполнения запросов.
Кейсы применения в реальных сценариях: SQL-запросы с пользовательским типом и миграции
В реальных сценариях плагин позволяет решать задачи, связанные с использованием более сложной структуры данных внутри SQL-запросов. Возможные сценарии:
SQL-операции: создание таблиц с колонкой типа my_custom_type и выполнение стандартных операций - выборки, фильтрация, агрегации и сортировка. В реальном контексте эти операции требуют корректной интерпретации значения внутри блока и эффективной конвертации в Java-объекты для последующей обработки в бизнес-логике.
Миграции: миграции схем, где необходимо преобразовывать существующие колонки в новый пользовательский тип и сохранять совместимость с существующими запросами. В некоторых случаях миграции могут требовать записи значений через appendTo и сохранения старых и новых форм значений.
Совместное использование: интеграция нового типа внутри представлений (VIEW) и функций, которые могут работать с пользовательскими типами, расширяя функциональность анализа данных в рамках корпоративной экосистемы.
Эти кейсы демонстрируют практическую ценность плагина и позволяют оценивать его влияние на продуктивность аналитических процессов, а также на консистентность данных и производительность планирования.
Интеграция технологических стеков: синергия плагина с Trino и экосистемой Java
Интеграция плагина с Trino и экосистемой Java требует определения четких точек взаимодействия. В контексте плагина пользовательского типа это означает:
Правильная работа с SPI: плагин активирует регистрации типов через интерфейс Plugin и метод getTypes(), что обеспечивает простую и предсказуемую интеграцию в сервер Trino.
Соответствие архитектуре Java: реализация типа и плагина следует стандартам Java и API Trino, чтобы минимизировать проблемы при обновлениях и обеспечить совместимость с различными версиями JDK.
Конфигурационная гибкость: плагин должен поддерживать стандартные способы конфигурации Maven и проекта, чтобы упрощать сборку и развёртывание в разных окружениях.
Инструменты разработки: использование современных средств тестирования, статического анализа и CI/CD позволяет повысить качество кода и устойчивость к изменениям.
Мониторинг и наблюдаемость: интеграция с существующими механизмами мониторинга указывает на устойчивость к нагрузкам и возможность трассировки операций над типом в условиях большого объема данных.
Эти аспекты подчеркивают важность комплексного подхода: архитектура плагина должна соответствовать корпоративным требованиям к надежности, совместимости и поддержке.
Анализ рисков, ограничений и метрик эффективности: производительность, устойчивость и мониторинг
Риски и ограничения при реализации плагина:
Производительность: добавление нового типа может повлиять на скорость обработки запросов, особенно если кодировка значений и конвертация происходят на уровне горячих путей выполнения. Важна оптимизация путей чтения и копирования значений внутри блоков.
Совместимость: изменения в API Trino или версии SPI могут потребовать адаптации плагина, что требует регулярного обновления и тестирования.
Безопасность: расширения, связанные с пользовательскими типами, должны соблюдать принципы безопасной сериализации и защиты конфиденциальных данных, чтобы предотвратить утечки или некорректную интерпретацию значений.
Обслуживание: необходимость поддержки в рамках корпоративной среды, включая обновления версий Java и зависимостей, а также совместимость с другими плагинами.
Метрики эффективности, на которые стоит опираться:
Производительность операций чтения-вычисления для значений типа my_custom_type в рамках разрезов и параллельной обработки.
Потребление памяти, в частности размер блоков и накладные расходы на копирования.
Скорость загрузки плагина и время регистрации типов при старте сервера.
Надежность и количество регрессий в тестах после изменений.
Мониторинг: включение метрик по обработке операций с типом, журнала ошибок и предупреждений, а также возможность трассировки запросов, связанных с типом.
Эти метрики помогут определить целевую производительность и ограничения, на которые следует ориентироваться при эксплуатации в реальных условиях.
Конкурентный анализ решений и дифференциация: сравнение с альтернативными подходами
Разработка собственного плагина для поддержки пользовательского типа в Trino может рассматриваться в контексте нескольких альтернативных подходов:
Встроенные типы и трансформации: некоторые задачи можно решить за счет сложных функций и представлений, без добавления нового типа. Но это приводит к неудобству, отсутствию нативной поддержки и ограниченным возможностям оптимизации.
Другие движки и плагины: в некоторых системах могут существовать аналогичные механизмы, однако глубина интеграции, поддержка в рамках Trino и экосистемы Java является уникальной для данного подхода.
Гибридные решения с временными преобразованиями: иногда применяются подходы, когда пользовательский тип реализуется как набор функций-оберток над существующими типами. Это обеспечивает быструю реализацию, но иногда приводит к потере нативной семантики типа и ухудшению производительности.
Преимущества дифференциации с использованием собственного плагина включают:
Полная нативная поддержка в рамках SQL-операций и планировщика.
Оптимизация памяти и обработки за счет правильной кодировки и конвертации значений внутри блока.
Гибкость и масштабируемость: можно добавлять новые типы и параметры, а также адаптировать существующие под требования бизнес-логики и регуляторные требования.
Ключевые различия и преимущества такого подхода заключаются в тесной интеграции с экосистемой JVM, согласованности сигнатур, гибкого управления зависимостями и прозрачной валидации в процессе разработки и эксплуатации.
Возможности применения в экономических секторах: финансы, телеком, здравоохранение и др.
Внедрение пользовательского типа через плагин Trino открывает множество возможностей для различных отраслей:
Финансы: использование структурированных и расширяемых типов данных может повысить точность моделирования финансовых инструментов, финконтроль за данными и сложные аналитические сценарии. Возможна реализация специализированных типов для финансовых инструментов и корреляций.
Телекоммуникации: обработка сложных форматов данных, сложных контрактов и соглашений, крупных наборов телеметрии и метрик может быть упрощена за счет интеграции собственных типов, которые лучше описывают домены телекомовских задач.
Здравоохранение: управление медицинскими данными и сложными структурированными данными требует точной кодировки и конвертации, особенно в контексте стандартов и регуляций. Собственные типы могут помочь в описании клинических данных или измерений.
Производство и энергосектор: анализ производственных данных, измерений и контролей может быть улучшен за счет специализированных типов, которые обеспечивают точную модель и семантику данных.
Расширение функциональности через плагин позволяет интегрировать отраслевые стандарты, требования к данным и регуляторные ограничения прямо в ядро аналитической платформы, обеспечивая предсказуемость и прозрачность операций на уровне SQL-запросов и аналитических рабочих процессов.
В заключение
Разработка плагина Trino для пользовательского типа данных - это многоступенчатый процесс, охватывающий теоретическую базу, архитектурные принципы, дизайн и реализацию конкретного типа и плагина, контроль качества, тестирование, развёртывание и эксплуатацию в реальных условиях. Такой подход обеспечивает глубокую интеграцию в экосистему Trino и Java, поддерживает корпоративную гибкость и позволяет адаптировать аналитическую среду под задачи бизнеса. Реализация MyCustomType демонстрирует принципы моделирования типов, сигнатур и взаимодействия с блоками данных, а также описывает практику регистрации типов через плагин CustomTypePlugin, конфигурацию Maven-проекта и маршруты развёртывания в каталоге плагинов сервера. В итоге достигается устойчивое и предсказуемое решение, которое можно масштабировать и адаптировать к различным сценариям использования в разных индустриальных сегментах.
Вопрос-Ответ:
Вопрос: Что обеспечивает архитектура плагинов Trino для расширения типа данных?
Ответ: Архитектура плагинов обеспечивает модульность, независимость ядра сервера и возможность регистрации новых типов через SPI, что позволяет добавлять новые семантики без изменений в базовом коде сервера.
Вопрос: Какова роль сигнатуры типа в контексте плагина?
Ответ: TypeSignature определяет идентичность типа и его параметры, что критично для валидности DDL, планирования, кэширования и совместимости между версиями.
Вопрос: Какие основные методы реализуют пользовательские типы в Trino?
Ответ: getObjectValue, equals, hash, appendTo и getDisplayName - они обеспечивают конвертацию, сравнение, копирование и отображение значений внутри блоков.
Вопрос: Что нужно учесть при конфигурации Maven-проекта?
Ответ: Важно указать совместимую версию Java (11+), зависимость от trino-plugin-base как provided, настроить компилятор и указать версию Trino для соответствия API.
Вопрос: Какие этапы необходимы для развёртывания плагина?
Ответ: Сборка артефакта, размещение JAR в каталоге плагинов Trino и перезапуск сервера для регистрации новых типов.
Вопрос: Какие сценарии применения наиболее эффективны для нового типа?
Ответ: SQL-запросы с использованием нового типа, миграции схем, представления и функций, работающих с пользовательским типом, и совместная работа с агрегатами и фильтрацией.
Вопрос: Какие риски сопровождают внедрение нового типа?
Ответ: Возможные проблемы с производительностью, совместимостью версии API, безопасностью сериализации и обслуживанием в рамках корпоративной инфраструктуры.
Вопрос: Какие отраслевые преимущества обеспечивает внедрение?
Ответ: Улучшение семантики данных и интеграция с отраслевыми стандартами в финансах, телекоммуникациях, здравоохранении и других секторах, повышение точности аналитики и ускорение миграций данных.
Этот материал призван быть практическим путеводителем для аналитиков, архитекторов, руководителей data-направлений и ИТ-директоров, демонстрируя как проектировать, реализовывать и внедрять собственный тип данных в Trino через плагин, с учётом архитектурных особенностей и практик разработки современных корпоративных систем.