

Переосмысление материализованных представлений для единого lakehouse: архитектура и практика StarRocks
Аннотация и цели исследования
Статья предлагает профессиональному сообществу аналитиков, архитекторов и руководителей data-направлений системный взгляд на то, как материализованные представления (Materialized Views, MV) в StarRocks переопределяют архитектуру единого lakehouse. Мы рассматриваем теоретические основы и инженерные практики, эволюцию возможностей MV от версии 2.4 к 3.5, а также методики проектирования, оркестрации, эксплуатации и измерения эффективности. Особый акцент сделан на прозрачном ускорении запросов к данным озера (Hive, Iceberg, Hudi), инкрементальной актуализации и снижении совокупной стоимости владения (Total Cost of Ownership, TCO) без роста технологической сложности.
Цели исследования:
- Обосновать место MV как ключевого конструкта lakehouse-подхода StarRocks, синтезирующего качества DWH и Data Lake.
- Показать, как MV снимают противоречие «производительность - актуальность - стоимость» за счет рефакторинга «цепочки» обработки в декларативную модель.
- Дать практикующим архитекторам методологию проектирования MV: выбор гранулярности, партиций, ключей агрегации, SLA свежести.
- Описать операционные аспекты: планирование, наблюдаемость, изоляцию ресурсов, надежность и масштабирование в условиях многоарендности.
- Сравнить подход StarRocks с альтернативами (Snowflake, BigQuery, ClickHouse, Trino) и выделить инженерную дифференциацию.
Введение: контекст единого lakehouse и мотивация переосмысления MV
Корпоративная аналитика сталкивается с двумя классами препятствий. Во‑первых, избыточной сложностью конвейера данных: множество систем и согласований между ними удлиняют путь от появления данных до получения ценности. Во‑вторых, конфликтом между тремя требованиями - высокой производительностью, актуальностью «почти в реальном времени» и низкой стоимостью. В изоляции их закрыть возможно, совместить - трудно.
Единый lakehouse StarRocks адресует обе проблемы. Он использует единый SQL‑движок для запросов по данным хранилища и озера, позволяет переносить существенную долю вычислений внутрь движка, минимизируя потребность в отдельных обработчиках (Spark/Hive). Материализованные представления становятся опорным механизмом: они устраняют повторные вычисления, стабилизируют стоимость, повышают скорость и контролируют свежесть, а также снижают технический и организационный барьер для введения моделирования данных.
Постановка проблем: сложность обработки, производительность, актуальность и стоимость
Классическая «цепочка» от сбора до аналитической витрины включает многократные этапы экстракции, очистки, дедеупликации, джойнов, агрегаций, обогащений, и все это - в разных СУБД и фреймворках. Результат - расходящиеся SLA, каскадные ошибки, дублирование логики, затрудненная трассировка происхождения данных и высокая цена изменений.
- Сложность. Разветвленная оркестрация, управление зависимостями и мониторинг требуют отдельных платформ и специалистов.
- Производительность. Повторные тяжелые запросы, широкие джойны и окна на «сырых» данных бьют по латентности и стоимости.
- Актуальность. Пакетные окна и слабо автоматизированные инкременты сдвигают аналитику «вчера к вечеру».
- Стоимость. Избыточные копии данных, неэффективная переработка и «зоопарк» инструментов повышают TCO.
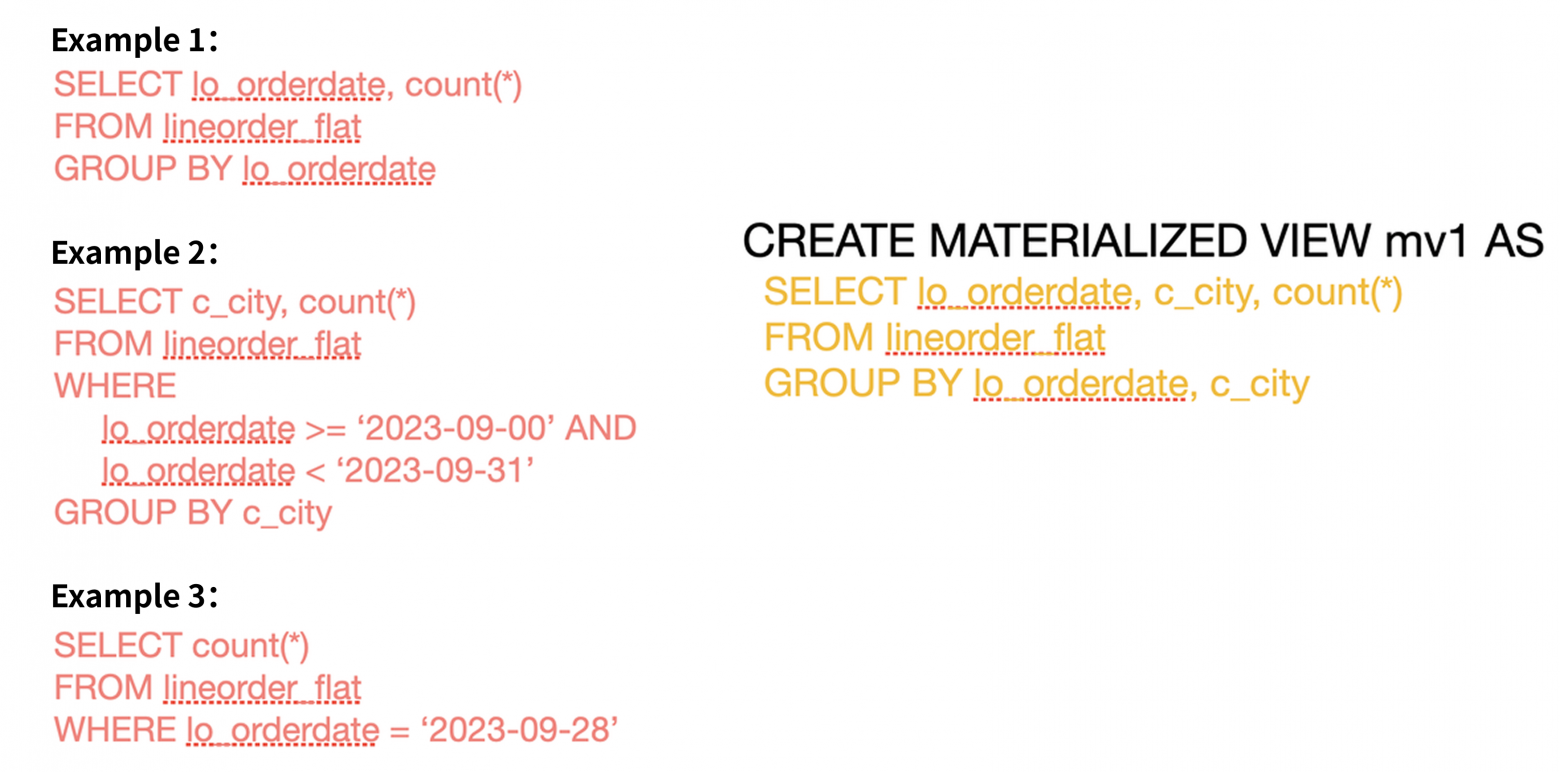
MV в StarRocks предлагают иную конструкцию: выразить вычисления декларативно один раз, материализовать результат по политике REFRESH и автоматически переиспользовать его через переписывание запросов. Это убирает повтор, локализует вычислительную ответственность и уменьшает глубину конвейера.
Теоретические основы: материализованные представления и архитектура lakehouse
Материализованное представление - это физическая таблица, поддерживаемая системой по правилу вычисления SQL. В отличие от логического VIEW, которое исполняется заново при каждом вызове, MV хранит результат и поддерживает его в актуальном состоянии согласно триггерам, расписанию или инкрементальному протоколу.
Архитектура lakehouse объединяет:
- Строгую модель данных DWH (качество, управляемость, предсказуемая производительность).
- Открытость и масштаб Data Lake (форматы колонок, дешевые объекты‑хранилища, гибкость схем).
В этой архитектуре MV выполняют функции предвычисления, кэширования семантики и опорной точки согласования batch/stream, превращая неоднородную «механику» обработки в управляемый, наблюдаемый слой.
Парадигма «единое хранение и единые запросы»: синтез преимуществ DWH и Data Lake
Единый lakehouse StarRocks реализует принцип «single engine for many modes»:
- Данные детальные, архивные и полуструктурированные хранятся в озере (Hive, Iceberg, Hudi), бизнес‑критичные агрегаты и витрины - в таблицах StarRocks.
- Один SQL‑движок запрашивает оба мира, делая выбор: читать «сырое» или использовать предвычисленное.
- Инженерные компромиссы становятся конфигурацией: выбор партиций, режимов REFRESH и политик хранения замещает выбор отдельных систем.
Так достигается баланс: гибкость хранения из Data Lake + управляемая производительность и реальное время из DWH.
Эволюция MV в StarRocks: от 2.4 к 3.5 и направления развития
- 2.4: фундамент MV, партиционное согласование, базовая материализация.
- 2.5: автоматическое переписывание запросов, больше SQL‑конструктов (CTE, WINDOW, UNION), внешние источники через JDBC и Hive.
- 3.0: многослойное моделирование (ODS-DWD-DWS-ADS), подписка на изменения Hive, улучшенная наблюдаемость и удобство эксплуатации.
- 3.5: расширение режимов REFRESH и сценариев инкрементальности, углубление правил переписывания и интеграции с озерными форматами (см. актуальную документацию к версии 3.5).
Вектор развития остается прежним: увеличить покрытие сценариев инкрементов и переписываний, упростить опыт «из коробки» и углубить связи с экосистемой озера.
Базовые возможности MV StarRocks: материализация, источники данных и поддерживаемые операторы SQL
Базовые свойства:
- Материализация: результат SELECT сохраняется как физическая таблица StarRocks; формат хранения соответствует таблицам движка.
- Partition BY: MV можно партиционировать (например, по дню/часу), что позволяет выполнять адресный REFRESH, задавать TTL и сопоставлять партиции с внешними источниками.
- REFRESH: поддерживаются автообновление, расписания, внешние триггеры и инкрементальные пересчеты там, где это возможно.
- Resource Group: изоляция обслуживания MV от пользовательских запросов, эластичное планирование.
- SQL‑покрытие: агрегации, JOIN, оконные функции, UNION/UNION ALL, CTE и другие часто используемые операции.
- Источники: внутренние таблицы StarRocks, lake‑внешние (Hive/Iceberg/Hudi) и JDBC‑внешние (например, MySQL, PostgreSQL). Зависимости вычисляются и отслеживаются автоматически.
Ключевая особенность - автоматическое переписывание запросов: оптимизатор сопоставляет исходный SQL с доступными MV и подставляет предвычисления без изменения текста запроса.
Архитектура StarRocks для единого lakehouse: обзор компонентов и потоков данных
Архитектурно StarRocks - MPP‑движок с разделением ролей:
- Frontend (FE): метаданные, планирование запросов, оптимизация, координация MV‑задач, управление каталогами и линейджем.
- Backend (BE): векторизированное исполнение, хранение сегментов, сканирование внешних источников, вычисление и материализация MV.
- Catalog/Connector слой: интеграция с Hive Metastore, табличными метаданными Iceberg/Hudi, JDBC‑коннекторами; ведет маппинг объектов и обнаружение изменений партиций.
- Workload Management (Resource Group): планирование и контроль QoS, конвейерное исполнение и изоляция.
Потоки данных включают ingestion (stream/batch), сканирование озерных таблиц, локальные вычисления MV, запись партиций и последующее переписывание запросов на чтение.
Декомпозиция подсистем MV и их взаимодействие
Подсистемы MV образуют связанный цикл: определение → планирование → вычисление → материализация → переписывание запросов → наблюдаемость и корректировка. Ниже - разбор каждой из них.
Подсистема материализации и формат хранения
Материализация выполняется на BE‑узлах в виде построения сегментов колонночного формата, совместимого с таблицами StarRocks. Это обеспечивает:
- Единый формат доступа и хранения для MV и таблиц.
- Использование всех оптимизаций движка: векторизации, сжатия, индексов и пропуска страниц.
- Нативную поддержку партиций и TTL.
При создании MV из внешних форматов (Hive/Iceberg/Hudi) система преобразует чтение в скан‑план со всеми доступными pushdown‑оптимизациями и строит локальные колоночные сегменты для результата.
Планировщик и режимы REFRESH (auto, schedule, trigger, incremental)
Политики REFRESH:
- auto: система самостоятельно инициирует обновление при изменении источников, используя метаданные каталога о модификации партиций/снимков.
- schedule: периодическая актуализация по cron‑подобному расписанию.
- trigger: внешние события** - загрузка батча, успешно завершенный DAG‑узел, ручной вызов API.
- incremental: пересчет только затронутых партиций или дельт; для озерных форматов используются механизмы обнаружения измененных файлов/снимков.
Планировщик учитывает приоритеты Resource Group, зависимости MV и текущие нагрузки, чтобы не нарушать SLA запросов.
Оптимизатор и правила переписывания SQL (AGG, JOIN, UNION, WINDOW)
Оптимизатор сравнивает логические планы:
- AGG‑переписывание: подстановка роллапов и супер‑агрегатов, возможность выполнять дополнительную агрегацию поверх более «грубого» MV.
- JOIN‑переписывание: использование MV с предъединением широких таблиц, в том числе с фильтрами и проекциями, совместимыми с исходным запросом.
- UNION‑переписывание: для временных серий и конкатенаций партиционных наборов.
- WINDOW‑частичные вычисления: предматериализация оконных метрик, которые допускают последующую доагрегацию или фильтрацию.
Переписывание подчиняется эквивалентностям алгебры реляционных выражений и условиям безопасности (семантическая эквивалентность, совместимость фильтров/группировок/проекций).
Партиционирование, сопоставление партиций и TTL
MV допускают:
- Согласование партиций: сопоставление ключей партиционирования MV и источников, включая внешние каталоги; это минимизирует пересчеты.
- Партиционный REFRESH: обновление только изменившихся партиций.
- TTL: политики жизненного цикла на уровне партиций MV для контроля объема и стоимости хранения (например, хранить N последних дней).
Для измерений возможен гибрид: полное пересечение свежего горизонта (например, 7-30 дней) и отложенное обслуживание старых партиций.
Изоляция ресурсов и планирование через Resource Group
Для предотвращения «конкуренции» между пользователями и обслуживанием MV применяется:
- Квотирование CPU/IO/памяти для групп.
- Приоритеты на уровне очередей и классов задач.
- Ограничение параллелизма REFRESH и эластичное заимствование при низкой нагрузке.
Так достигаются предсказуемые SLA для BI/ад‑hoc и стабильная стоимость обслуживания MV.
Метаданные, линейдж, наблюдаемость и операционная телеметрия
MV сопровождаются полными метаданными:
- Происхождение (lineage): связи с источниками, версии снимков/партиций, правила пересчета.
- Состояния задач: очередь, исполнение, успех/ошибка, длительность, объем обработанных данных.
- Метрики: лаг свежести (staleness), доля переписываний, hit‑ratio MV, стоимость обновлений, пропускная способность.
Телеметрия позволяет строить SLO: целевой лаг, процент переписанных запросов и целевая стоимость на запрос.
Моделирование данных по слоям (ODS-DWD-DWS-ADS): роли View и MV
Слои:
- ODS (Operational Data Store): слабо обработанные операционные данные, «как есть».
- DWD (Data Warehouse Detail): очищенные детальные факты и нормализованные измерения.
- DWS (Data Warehouse Summary): агрегаты по доменам и витрины тем.
- ADS (Application Data Services): узконаправленные представления под API/дашборды/отчёты.
Роли:
- View: логическая семантика и унификация запросов, особенно в быстро меняющейся бизнес‑логике.
- MV: физическое предвычисление тяжелых стадий (джойны, окна, агрегаты), снижение повторных затрат и стабилизация производительности.
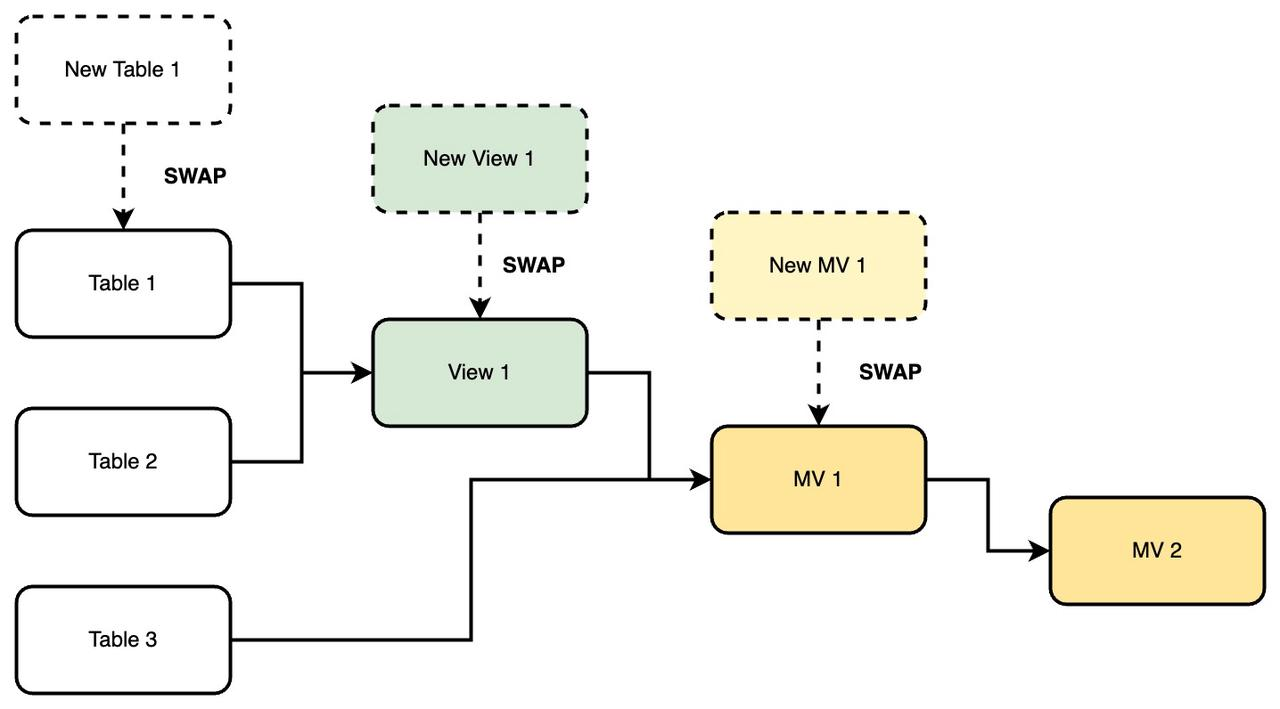
Гибкая комбинация View+MV позволяет эволюционно повышать зрелость модели без слома существующих сценариев.
Моделирование по партициям: факт, измерения, схемы «звезда» и «снежинка»
Схема «звезда» (денормализованная) и «снежинка» (нормализованная) диктуют разные решения по MV:
- Факт‑таблица партиционируется по дате события/заказа/логическому окну.
- Измерения могут быть медленно меняющимися (SCD) и нередко без партиций.
Практика StarRocks:
- Партиционное согласование MV с фактом: JOIN‑результаты материализуются в тех же партициях, что и факт, обеспечивая точечный REFRESH при поступлении новых фактов.
- Обслуживание измерений: либо игнорировать обновления «дальних» измерений, либо «скользящее окно» пересчета (например, последние 14 дней), либо отдельное MV для быстроменяющихся измерений с частым REFRESH.
TTL на MV позволяет удерживать рабочий горизонт при высоком QPS и контролируемой стоимости.
Инкрементальные вычисления: алгоритмы, границы корректности и SLA свежести
Инкрементальность снижает задержку и стоимость:
- Партиционный инкремент: пересчет только измененных партиций факта и связанных агрегатов.
- Файловая дельта (озеро): по метаданным Iceberg/Hudi/Hive выявляются добавленные/измененные файлы и пересчитывается их вклад.
- Лог изменений (лог CDC): для JDBC‑источников и стриминга возможны протоколы Merge‑Into/Upsert‑On‑Key в целевую MV.
Границы корректности:
- Идемпотентность: повторный REFRESH не должен продуцировать дубликаты.
- Обработка «поздних» событий: политика watermarks/late arrival и ретро‑пересчет окна.
- Детерминированность: MV‑запросы должны быть чистыми функциями от входов в целевом срезе.
SLA свежести описывает допустимый лаг (например, P95 ≤ 10 мин) и долю запросов, обслуженных MV (hit‑ratio ≥ 80%).
Интеграция с озёрными форматами и каталогами: Hive, Iceberg, Hudi
Подключение к data lake:
- Hive: чтение через Hive Metastore, партиционное обнаружение изменений, скан с predicate pushdown.
- Iceberg: снапшоты/манифесты определяют дельты; MV «подписывается» на новые снапшоты таблицы.
- Hudi: Copy‑On‑Write и Merge‑On‑Read сценарии; MV учитывает таймлайны коммитов.
Для всех форматов применяется согласование партиций и инкрементальность там, где это корректно и поддержано форматом.
Подключение внешних источников через JDBC: MySQL, PostgreSQL и др.
JDBC‑внешние таблицы позволяют:
- Быстро встроить референсные справочники и транзакционные таблицы.
- Создать MV с джойнами StarRocks↔JDBC, которые материализуют результат локально, устраняя медленные удаленные JOIN.
Политики REFRESH назначаются с учетом возможностей источника и приоритизируют «скользящее окно» чанков.
Прозрачное ускорение: паттерны роллапов, фильтраций и широких JOIN без изменения SQL
Оптимизатор подставляет MV, если выполняются условия эквивалентности. Типичные паттерны:
- Роллап‑агрегирование: исходный запрос требует SUM/COUNT по грубому ключу; MV содержит более детальную группировку. Срабатывает дополнительная агрегация «поверх MV».
- Фильтрация+агрегация: MV уже агрегировано по периоду/региону; исходный запрос добавляет WHERE и более крупный GROUP BY.
- Широкие JOIN: MV хранит результат соединения факта с измерениями; исходный запрос выполняет дополнительные фильтры и проекции.
- UNION временных серий: MV агрегируют поддиапазоны времени; исходный запрос конкатенирует периоды.
Таким образом достигается ускорение без переписывания пользовательского SQL и без обязательного предварительного моделирования.
Стратегии проектирования MV: выбор гранулярности, ключей агрегирования и партиций
Методика:
- Сегментировать запросы по «семействам» планов: одинаковые таблицы, условия и проекции.
- Выбрать «опорные» уровни агрегации (дата×регион, дата×канал, SKU×дата) как кандидатов MV, обеспечивающих максимальный охват переписываний.
- Назначить партиции по времени факта, учитывая шаблон доступа и SLA ретроспективы.
- Проверить селективность фильтров и кардинальность ключей: MV должны радикально сокращать объем, сохраняя переписываемость.
- Закрепить TTL и режим REFRESH, исходя из «горячей» зоны данных и требуемой свежести.
Избегайте гиперспециализированных MV «под один отчёт» без перекрытия с другими сценариями - они увеличивают стоимость сопровождения.
Оркестрация конвейера: триггеры, DAG‑зависимости, расписания и внешние оркестраторы
Оркестрация строится по слоям зависимостей:
- Триггеры: обновление факта завершает ingestion → запускается REFRESH целевых MV.
- Расписания: регулярный пересчет агрегатов в малонагруженные окна.
- DAG‑зависимости: MV верхнего уровня запускаются после успешной материализации нижнего (DWD→DWS→ADS).
- Внешние оркестраторы: Airflow, Argo, Dagster инициируют API‑вызовы REFRESH, контролируют SLA и ретраи.
Ключевой принцип - минимизировать «внеязыковую» логику: сам SQL MV и его политика REFRESH должны оставаться «источником правды».
Единый конвейер batch/stream: согласование real‑time, инкрементов и пакетной обработки
Сведение режимов:
- Stream ingestion (Kafka/CDC) → ODS View с максимально актуальными данными.
- MV «почти real‑time» на DWD/DWS: инкрементальные партиции с малым лагом.
- Batch дообогащения и консолидации: периодические плотные перерасчеты для исторических окон.
Практично использовать микробатчи и водяные знаки (watermarks) для детерминированного консенсуса между поздними событиями и SLA свежести.
Метрики эффективности и методология измерений: латентность, пропускная способность, стоимость
Система метрик:
- Латентность: P50/P95 времени ответа запросов до и после внедрения MV; лаг обновления MV.
- Пропускная способность: QPS и concurrency при целевых SLA, hit‑ratio переписываний.
- Стоимость: CPU‑часы/IO на REFRESH, объем хранения MV, $/запрос в BI‑нагрузке.
- Эффективность переписывания: доля запросов, использующих MV, и экономия сканируемых байтов.
Таблица примерной программы измерений:
| Метрика | До MV | После MV | Целевое улучшение |
|---|---|---|---|
| P95 latency (сек) | 12.4 | 1.6 | ≥7.5× |
| Hit-ratio MV (%) | 0 | 80 | ≥70 |
| Сканируемые данные (ГБ/зап) | 45 | 3.5 | ≥10× |
| Лаг свежести (мин) | 90 | 10 | ≤15 |
| Стоимость $/запрос | 1.00 | 0.18 | ≥5× |
Анализ рисков и ограничений: согласованность данных, дрейф схем, каскадные пересчёты, горячие партиции
Риски:
- Согласованность: частичные обновления источников могут привести к «разорванным» снимкам. Смягчение - атомарные маркеры готовности партиций и зависимость REFRESH от них.
- Дрейф схем: изменение типов/колонок в озере ломает MV. Смягчение - контракт схем и автоматические проверки совместимости.
- Каскадные пересчеты: большое число зависимых MV усиливает всплески нагрузки. Смягчение - планирование по DAG, лимиты параллелизма и приоритизация.
- Горячие партиции: частые апдейты в «сегодня/час» создают узкие места. Смягчение - более тонкие партиции, компакшн и щадящий режим апдейта.
Надёжность и качество данных: валидация MV, контроль дубликатов, обработка ошибок и восстановление
Практики:
- Контроль дубликатов: ключи агрегации и семантика upsert на этапе материализации; дедуп по бизнес‑ключам.
- Валидация: выборочные контрольные суммы/сэмплы между MV и эталонным запросом; канареечные сравнения.
- Обработка ошибок: ретраи с экспоненциальной задержкой, «мягкие» окна пересчета, карантин проблемных партиций.
- Восстановление: точечный REFRESH, пиннинг «золотого» снимка MV, сценарии полного перестроения вне пиков.
Масштабирование и многоарендность: SLA, QoS и управление конкурирующими нагрузками
В многоарендной среде:
- Resource Group делит кластеры на классы обслуживания (интерактив, бэкенд‑обслуживание MV, отчеты).
- Admission‑control ограничивает всплески и гарантирует минимальную долю ресурсов приоритетным потокам.
- Горизонтальное масштабирование BE‑узлов линейно увеличивает пропускную способность MV‑пересчетов.
SLA формулируются на уровне групп и типов запросов, а не «всего кластера».
Кейсы применения в реальных сценариях: BI‑ускорение, ad hoc‑аналитика, near real‑time дашборды, отчётность
- BI‑ускорение: витрины продаж/маржинальности собирают широкие JOIN и оконные метрики в MV; Tableau/Power BI выполняют легкие проекции с секундной латентностью.
- Ad‑hoc: аналитики запускают исследования поверх предагрегатов, избегая сканирования «сырых» петабайтных таблиц.
- Near real‑time дашборды: инкрементальные MV с лагом 5-10 минут объединяют стрим‑данные заказов и справочники клиентов.
- Регламентная отчетность: стабильные MV с жесткими TTL и контролем качества формируют «замороженные» срезы.
Отраслевые применения и экономические сектора: e‑commerce, финтех, телеком, логистика, медиа, IoT
- E‑commerce: когорты, LTV, конверсия воронок** - тяжелые оконные вычисления переносятся в MV.
- Финтех: антифрод‑показатели и скоринги на «горячем» окне; строгие SLA качества и актуальности.
- Телеком: агрегации CDR по ячейкам/сегментам, скользящие окна нагрузки сети.
- Логистика: SLA доставки и использование ресурсов по маршрутам, near real‑time сверка статусов.
- Медиа: пик‑нагрузки и эффективность кампаний, денормализация с рекламными метриками.
- IoT: таймсерии сенсоров, downsampling и агрегирование с семантикой окон.
Интеграция технологических стеков и синергия: SQL‑движок, каталоги, форматы данных и системы стриминга
Синергия достигается в узлах:
- Каталоги: Hive Metastore, каталоги Iceberg/Hudi обеспечивают сигнал о дельтах для REFRESH.
- Форматы: колонночные форматы и predicate pushdown повышают эффективность сканов озера.
- Стриминг: Kafka/CDC → ODS‑View → инкрементальные MV на DWD/DWS.
- BI/ML: единый SQL‑слой питает дашборды и фичесторы, используя те же MV.
Единый движок снижает интеграционные зазоры и издержки.
Руководство по внедрению и миграции: от классического ETL к MV‑центричной архитектуре
Пошаговая миграция:
- Инвентаризация запросов и построение карты «семейств планов».
- Идентификация «быстрых побед» - MV, дающих максимальную экономию сканов и латентности.
- Введение Resource Group и базовых SLO на hit‑ratio, лаг свежести и стоимость.
- Постепенное сворачивание внешних ETL‑агрегатов и перенос в MV.
- Стандартизация: шаблоны MV для типовых доменов, политика партиций и TTL, гайд по REFRESH.
- Автоматизация в оркестраторе: DAG‑зависимости, алертинг и ретраи.
Антипаттерны: 1‑MV‑на‑отчет, «вечные» полные пересчеты, отсутствие контроля схем, игнорирование горячих партиций.
Конкурентный анализ и дифференциация: Snowflake, BigQuery, ClickHouse, Trino и подход StarRocks
- Snowflake/BigQuery: сильная сторона - управляемость и серверлесс‑эластичность; MV и материализованные результаты поддерживаются, но переписывание и контроль инкрементов зависят от ограничений платформ. StarRocks делает ставку на плотную интеграцию с озером и детерминированный контроль REFRESH/Resource Group.
- ClickHouse: высока скорость сканов и агрегатов; материализация возможна через материализованные таблицы и projections, но прозрачность переписываний и единый lakehouse‑подход решаются иначе. StarRocks фокусируется на автоматическом MV‑rewrite и многослойном моделировании с каталогами озера.
- Trino: федеративный движок запросов без собственного хранилища. Strength - широта коннекторов, но устойчивые MV и их обслуживание требуют внешних механизмов. StarRocks предлагает единый контур вычисления и хранения результатов MV.
Дифференциация StarRocks - в сочетании векторизированного MPP‑ядра, автоматического переписывания и интеграции с озером для сценариев «ускорения без переписывания SQL».
Экономика и TCO: оценка затрат, оптимизация ресурсов и ROI от использования MV
Компоненты TCO:
- Вычисления: CPU/IO на запросы и REFRESH.
- Хранение: объем MV и их TTL, стоимость слоев данных.
- Операционные издержки: оркестрация, мониторинг, поддержка моделей и конвейеров.
- Риски: простои из‑за каскадных ошибок, дорогостоящие ретро‑пересчеты.
ROI‑модель:
- Экономия на запросах = (Скан до − Скан после) × Стоимость/ГБ × Количество запросов.
- Экономия на людях = снижение трудозатрат на поддержку разрозненных ETL и платформ.
- Выгода от свежести = повышение конверсии/снижение потерь благодаря near real‑time (оценивается доменно).
Оптимизации: агрессивный TTL «горячих» MV, повышение hit‑ratio за счет усредненных грануляций, ограничение параллелизма REFRESH в пиковые часы.
Практики эксплуатации: мониторинг, алертинг, capacity planning, регрессионное тестирование
Эксплуатационные практики:
- Мониторинг: лаг REFRESH по партициям, hit‑ratio, CPU/IO по Resource Group, «стоимость» MV (GB, $/день).
- Алертинг: SLO нарушены (свежесть, латентность), доля ошибок REFRESH, дрейф схем.
- Capacity planning: моделирование роста QPS и горизонта данных, стресс‑тесты «горячих» партиций и массовых обновлений измерений.
- Регрессионные тесты: бенчмарки планов до/после изменений, контроль переписываний, проверка корректности MV на сэмплах/контрольных наборах.
Выводы и перспективы развития MV в экосистеме StarRocks
Материализованные представления в StarRocks - это не просто «кэш результатов», а фундаментальный элемент архитектуры единого lakehouse. Они:
- Сводят сложность многосистемной обработки к декларативному описанию.
- Балансируют производительность, свежесть и стоимость за счет инкрементов, партиций и автоматического переписывания.
- Делают моделирование эволюционным: View** - для семантики, MV - для физики производительности.
- Укрепляют интеграцию с озером, повышая ценность уже накопленных данных.
По мере развития версий расширяется покрытие инкрементальных сценариев, источников и правил переписывания. Практикам следует выстраивать MV‑центричную методику проектирования и эксплуатации, основанную на измеримых SLO, прозрачных оркестрациях и строгом управлении метаданными и схемами.
В сочетании с дисциплиной SLA/QoS и продуманной экономикой MV формируют устойчивый, наблюдаемый и экономически выгодный «единый конвейер данных» для запросов интерактивной аналитики, BI и near real‑time.
Вопрос-Ответ:
-
Вопрос: В чем главное отличие MV от логических VIEW в StarRocks?
Ответ: VIEW повторно исполняет SQL при каждом запросе, а MV физически хранит предвычисленный результат и автоматически поддерживает его актуальность согласно политике REFRESH, что радикально снижает затраты исполнения. -
Вопрос: Как StarRocks обеспечивает «прозрачное ускорение» без изменения пользовательского SQL?
Ответ: Оптимизатор сопоставляет планы запросов с доступными MV и переписывает их на использование предвычислений (AGG/JOIN/UNION/WINDOW), сохраняя семантическую эквивалентность. -
Вопрос: Какие режимы REFRESH поддерживаются для MV?
Ответ: Доступны auto, schedule, trigger и incremental. Они позволяют обновлять MV автоматически при изменении источников, по расписанию, по внешним триггерам и инкрементально по дельтам/партициям. -
Вопрос: Как минимизировать стоимость обслуживания MV в озерных сценариях?
Ответ: Использовать партиционное согласование и инкрементальный REFRESH, задавать TTL на «горячие» партиции, проектировать MV с высокой долей переписываний и контролировать параллелизм через Resource Group. -
Вопрос: Как интегрируются MV с форматами Hive/Iceberg/Hudi?
Ответ: Через каталог/коннекторный слой StarRocks: система обнаруживает дельты партиций/снапшотов, применяет predicate pushdown при сканировании и материализует результат в нативный формат таблиц. -
Вопрос: Какие риски чаще всего встречаются при эксплуатации MV?
Ответ: Дрейф схем, частичные обновления источников (несогласованность), каскадные пересчеты при глубокой зависимости MV и перегрев «горячих» партиций. Смягчаются контрактами схем, DAG‑планированием и квотированием. -
Вопрос: Как измерить эффективность внедрения MV?
Ответ: Сравнить P95‑латентность, hit‑ratio переписываний, сканируемые байты на запрос, лаг свежести и стоимость $/запрос до и после. Установить целевые SLO и отслеживать их соблюдение. -
Вопрос: Какую роль играют View и MV в слоистой модели ODS-DWD-DWS-ADS?
Ответ: View выражают бизнес‑семантику и упрощают SQL, а MV берут на себя тяжелую физику вычислений (агрегаты, джойны, окна), стабилизируя производительность и снижая стоимость.