

dbt Core, Snowflake и GitHub Actions: пет-проект для дата-инженеров
Пет-проект для дата-инженеров: популярные инструменты современного стека данных - dbt Core, Snowflake, Fivetran и GitHub Actions.
Представляю Вашему вниманию достаточно простой и быстрый пет-проект для дата-инженеров, которые хотят поближе познакомиться с такими инструментами современного стека данных, как dbt Core, Snowflake, Fivetran и GitHub Actions. Этот наглядный пример позволит Вам разработать полный жизненный цикл данных, начиная с извлечения данных из Google Calendar и заканчивая их представлением в дашборде Snowflake. Кроме того, я поделюсь с Вами своими соображениями и рекомендациями по данному вопросу. Смотрите репозиторий Github
Технический обзор
Архитектура проекта представлена следующим образом:
Google Календарь-> Fivetran -> Snowflake -> dbt -> дашборд Snowflake при участии GitHub Actions, организующей развертывание.

Давайте рассмотрим наш проект в соответствии с этапами жизненного цикла данных, указанных в книге Джо Рейса "Основы инженерии данных" (Fundamentals of Data engineering):
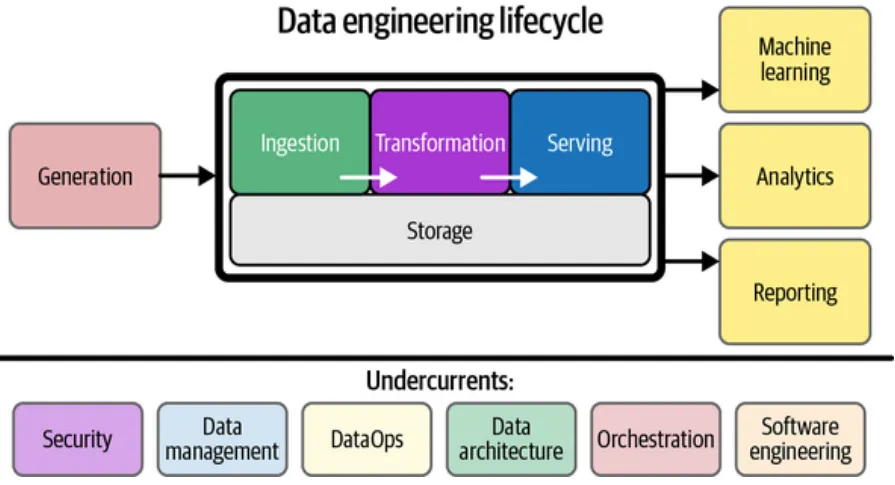
Генерирование данных — Google Календарь, Fivetran
Если Вы пользуетесь Google Календарем, то, скорее всего, накопили в нем огромное количество данных. Теперь Вы можете легко извлечь их, воспользовавшись "платформами перемещения данных", такими как Fivetran. Данный инструмент полностью автоматизирует процесс ELT (Extract, Load, Transform), интегрируя Ваши данные из исходной системы Google Календарь в хранилище данных Snowflake.
На данный момент Fivetran предлагает 14-дневную бесплатную пробную версию - ссылка. Процесс регистрации прост до невозможности.
Хранение данных — Snowflake
В качестве инструмента для хранения данных выберем Snowflake, облачное хранилище данных. Объем данных, с которыми мы будем иметь дело, сравнительно невелик, поэтому мы не будем задействовать расширенные возможностями Snowflake, обойдемся базовыми. Особое внимание уделим контролю доступа (он будет использоваться для доступа к dbt). Вам необходимо создать пробный аккаунт, который предоставляет возможность бесплатной работы с продуктом в течение 30 дней.
Поглощение данных — Fivetran
Поглощение данных может быть организовано как с помощью Fivetran, так и с помощью Snowflake благодаря функции Partner Connect. Выберите предпочтительный метод и настройте коннектор Google Календаря. После синхронизации Вы получите доступ к своим данным. Посетить веб-страницу коннектора и просмотреть схему можно здесь.
Специально для синхронизации с Fivetran будет создана новая БД, а также хранилище для выполнения рабочих нагрузок SQL. В целом, для разных рабочих нагрузок (ad-hoc, синхронизация, BI-аналитика) или разных сред (dev, prod) настоятельно рекомендую использовать разные хранилища данных.
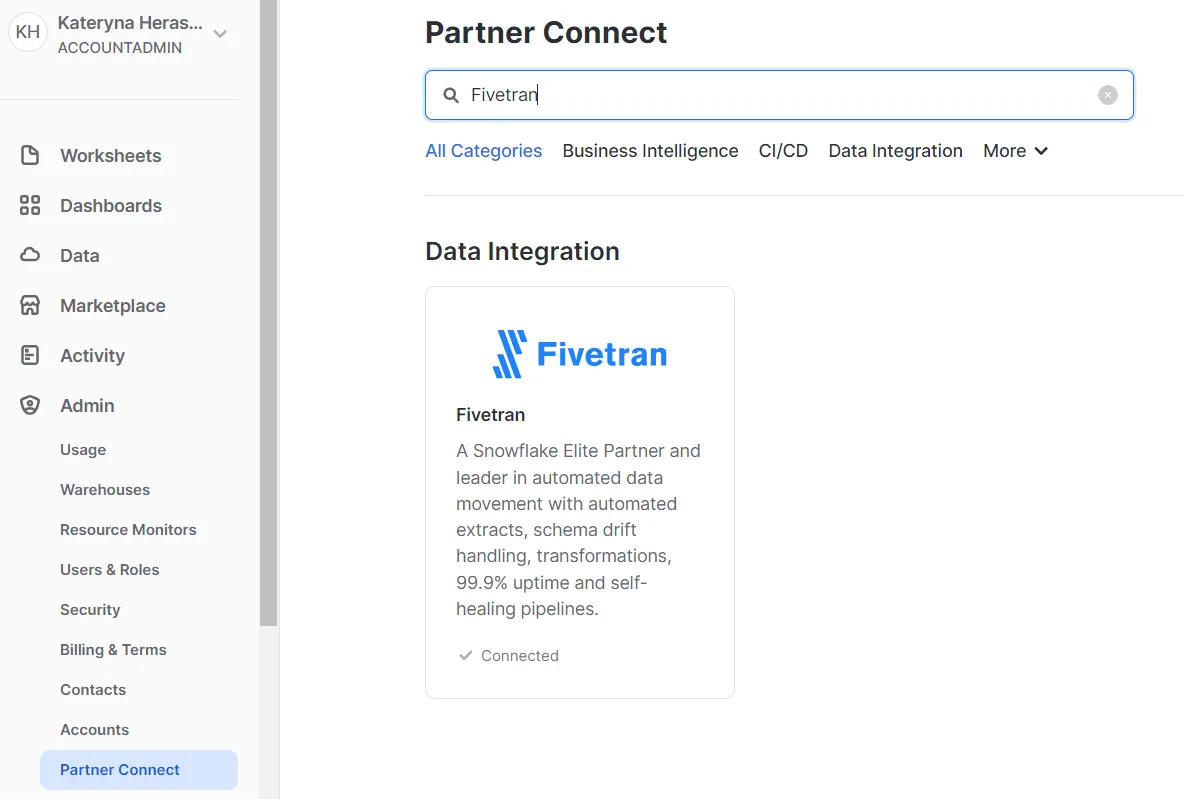
Для соединения с Fivetran используйте функцию Partner Connect
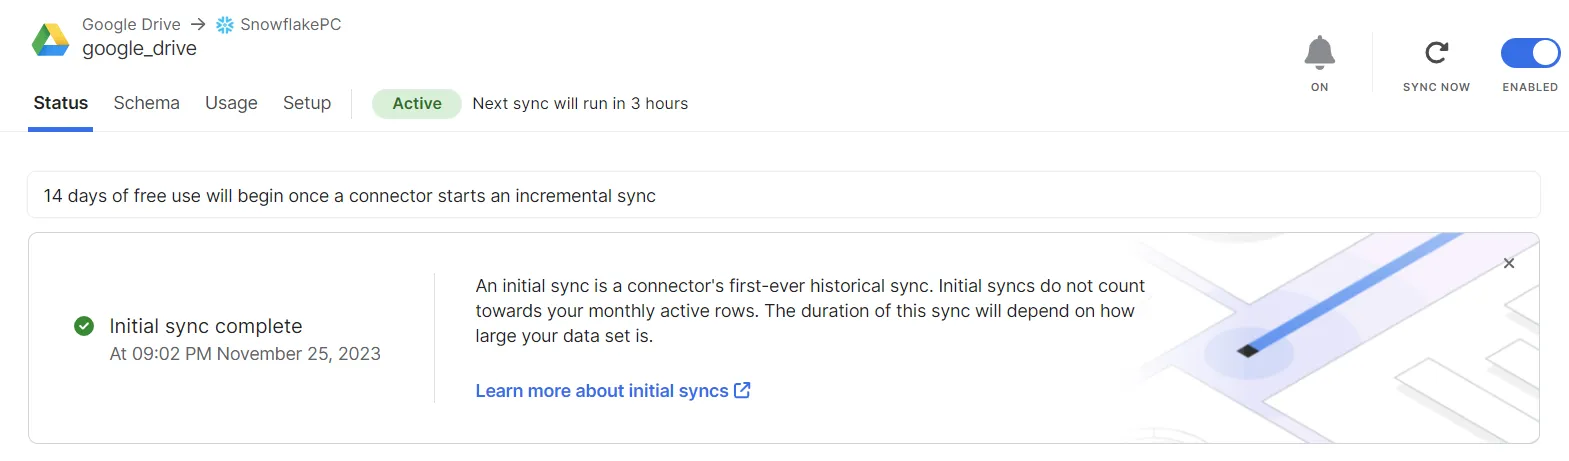
Настройте коннектор Google Календаря в Fivetran
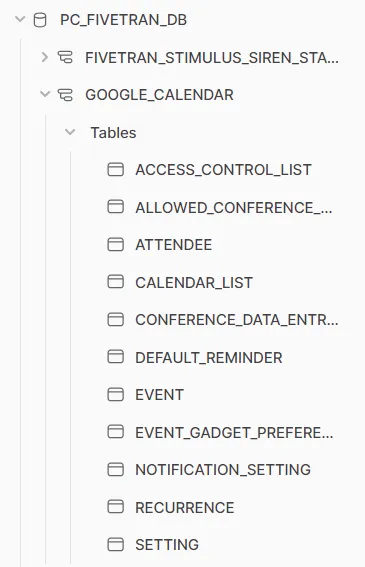
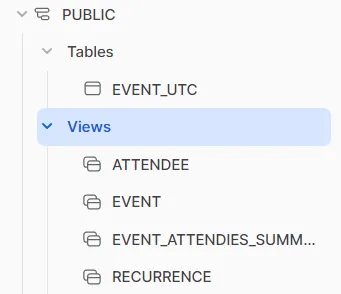
Синхронизированные данные отобразятся в Snowflake
Преобразование данных — dbt Core
Как только данные занесены в Snowflake (и по умолчанию автоматически синхронизируются каждые 6 часов), мы переходим к этапу трансформации с помощью dbt Core. dbt (инструмент для создания данных) значительно облегчает модулизацию SQL-запросов, позволяя повторно использовать и контролировать версии рабочих процессов SQL. Существует два способа получить доступ к dbt: dbt Cloud и dbt Core. dbt Cloud - это платная облачная версия сервиса, а dbt Core - это python-пакет, предоставляющий весь функционал продукта, который Вы можете использовать абсолютно бесплатно.
Установите dbt Core, инициализируйте проект с помощью команды "dbt init" в CLI и настройте подключение к Snowflake. Смотрите пример моего файла - profiles.yml file.
Для того, чтобы подключиться к Snowflake, нам потребуется выполнить несколько DCL команд (Data Control Language), найти их можно здесь. Следуя принципу наименьших привилегий, создадим отдельного пользователя для dbt и предоставим ему доступ только к исходной БД (куда Fivetran синхронизирует данные) и базам данных разработки и производства (куда мы будем сливать преобразованные данные).
Следуя лучшим практикам в области структурирования данных, создадим три папки, соответствующие staging, intermediate и marts уровням преобразования данных. Вы можете экспериментировать со своими собственными моделями или скопировать мои примеры из Google Календаря.
В репозитории Вы найдете файл "sources.yml", в котором перечислены все таблицы в схеме Google Календаря. Всего создано 3 модели staging (event.sql, attendee.sql, recurrence.sql), 1 модель преобразования (utc_event.sql) и 1 модель mart (event_attendee_summary.sql).
Важными особенностями dbt являются Jinja и макросы, которые можно добавить в SQL, повысив тем самым эффективность обработки запросов.
Выбор различных типов материализации моделей
Для обеспечения качества данных обозначьте требования к данным с помощью общих или единичных тестов в dbt. Некоторые правила качества данных размещены в файле "source.yml", а также в папке "/tests". Во время выполнения команды "dbt build" проверка качества данных будет выполняться вместе со сборкой моделей, чтобы предотвратить повреждение данных.

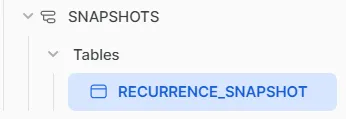
Для захвата данных об изменениях и медленно меняющихся измерений второго типа воспользуйтесь функцией Snapshot в dbt. В нашем примере мы фиксируем изменения в таблице "Повторяемость".
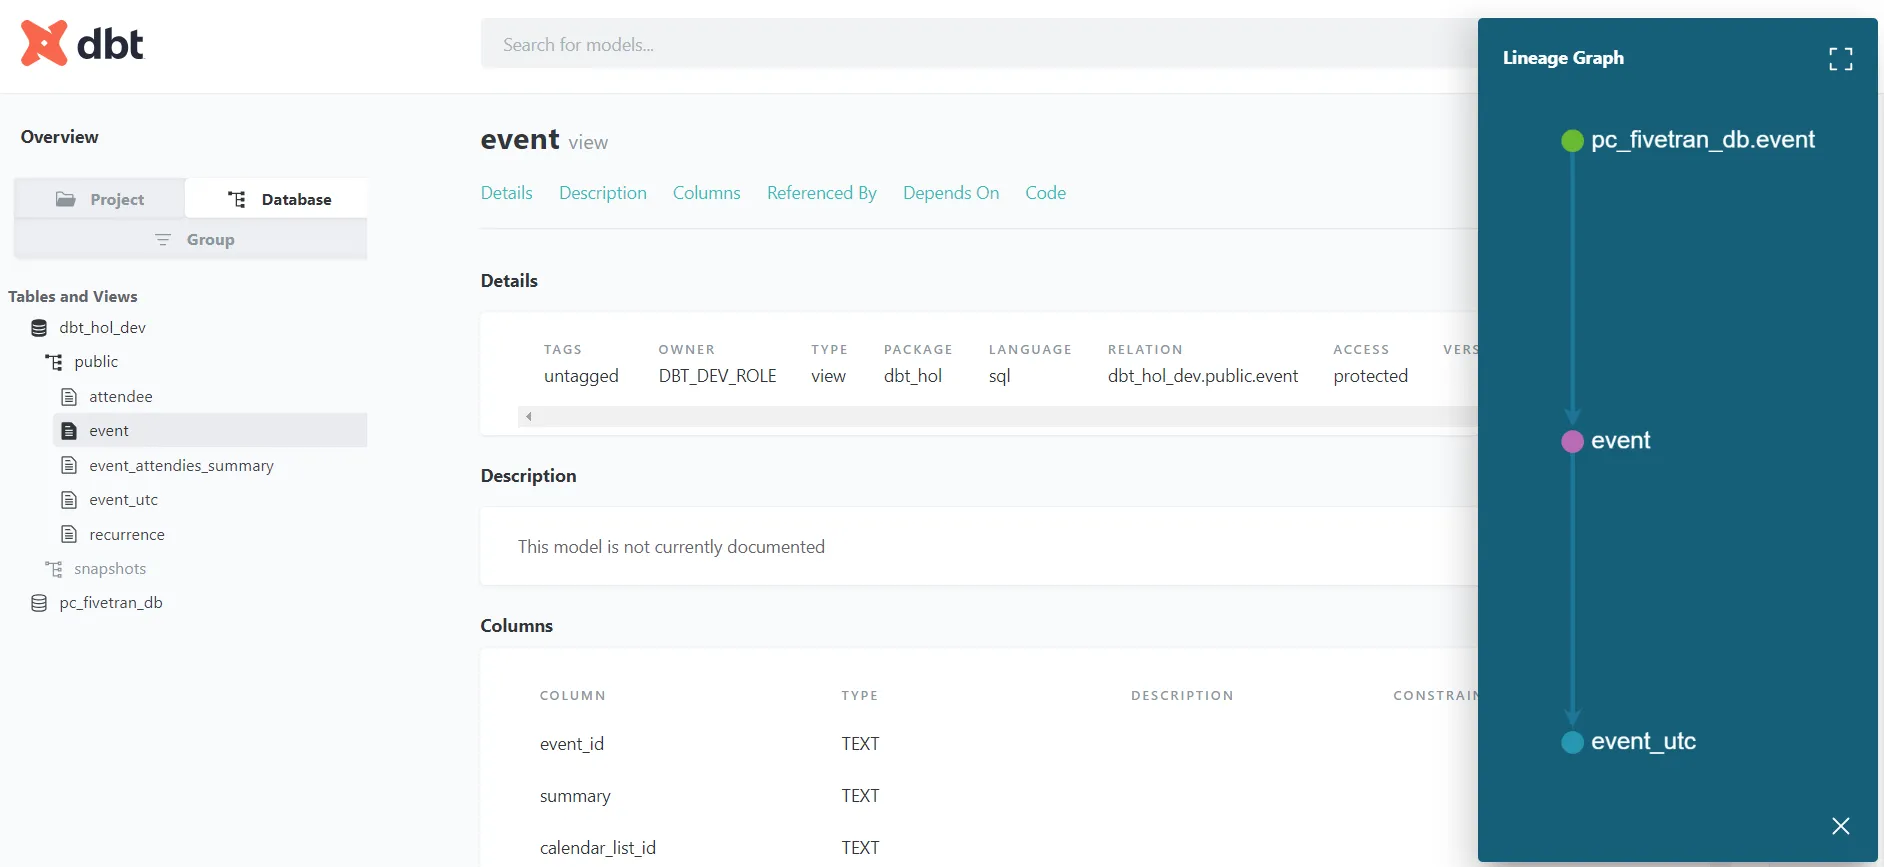
Потратьте время на создание документации dbt с помощью команды "dbt docs generate". Вы увидите граф data lineage и метаданные, которые автоматически создаются из Вашего проекта.
Хорошая документация обеспечивает лучшую обнаруживаемость данных, а также более эффективное управление данными.
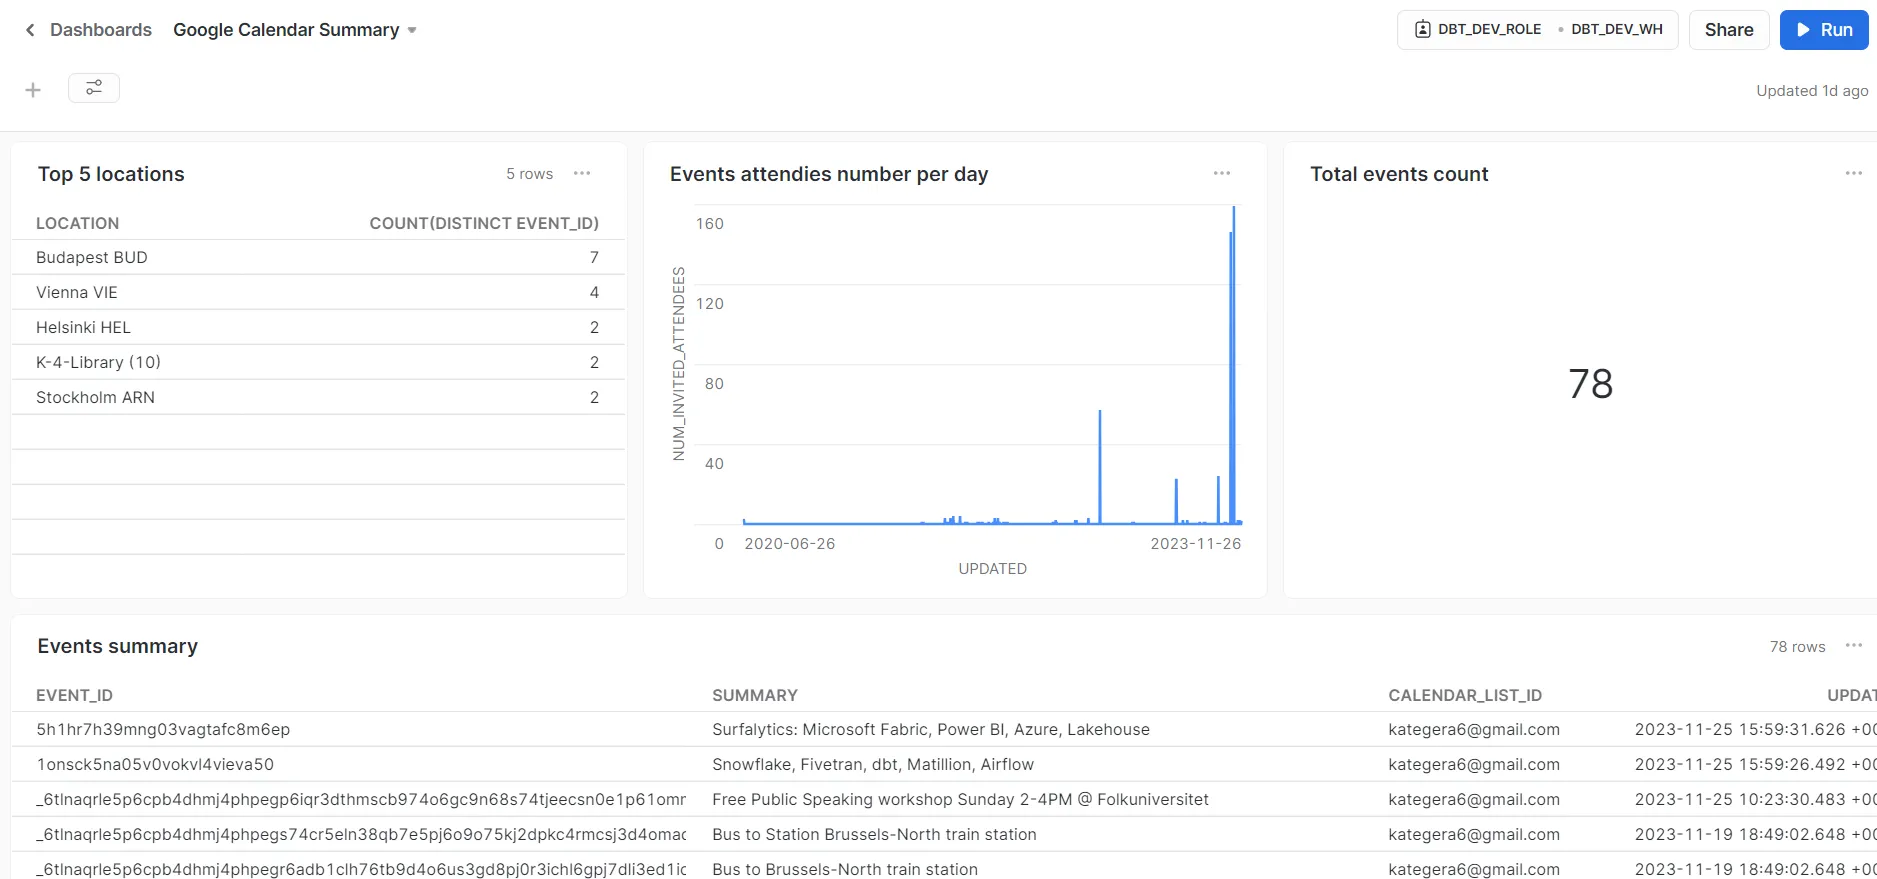
Предоставление данных — Snowflake Dashboard
И, наконец, визуализируйте преобразованные данные с помощью Snowflake Dashboards. Создайте свой дашборд и поэкспериментируйте с графиками на основе Ваших SQL -запросов.
Развертывание — GitHub Actions
Хотя dbt Cloud предлагает достаточно простой вариант развертывания, мы будем использовать GitHub Actions. Вам нужно создать файл .yml, который будет запускаться каждый раз, когда в репозиторий GitHub dbt будут загружаться изменения. В моем примере Вы можете увидеть двухэтапный процесс развертывания: сборка dbt для среды разработки и, в случае успеха, сборка dbt для производственной среды.
Примечание: замените секреты, такие как учетная запись и пароль Snowflake, на секреты GitHub. Для этого на веб-странице Вашего репозитория перейдите в раздел Settings -> Secrets and Variables -> Actions.
Каждый раз при обновлении ветки "master" Вы сможете увидеть рабочий процесс на вкладке Actions:

В данной статье мы всего лишь одним глазком взглянули на различные технологии современного стека данных. Это отличная отправная точка для более глубокого изучения вопроса. Благодарю за внимание и желаю успехов в собственных проектах!


