

Архитектура конвейера потоковых данных
В этой статье мы рассмотрим архитектуру и основные компоненты конвейера потоковых данных
Поглощение данных
Поглощение данных - это первый этап конвейера потокового данных. Он включает в себя захват данных из самых различных источников, таких как Kafka, MQTT, файлы журналов или API. К самым распространенным методам захвата данных относятся:
- Система очереди сообщений: для сбора и буферизации данных из различных источников используется брокер сообщений, например Apache Kafka;
- Прямой поток: данные поступают из исходной системы напрямую в конвейер данных. Для этого могут использоваться коннекторы, специфичные для исходной системы, например коннектор Kafka или интеграция API.
Обработка и трансформация данных
После получения данных их необходимо обработать и преобразовать в соответствии с определенными бизнес- требованиями. На этом этапе решаются различные задачи, в том числе:
- Валидация данных: проверка данных на предмет их соответствия установленным правилам схемы и требованиям в области качества;
- Нормализация данных: преобразование данных в нужный формат или схему, пригодную для последующей обработки;
- Обогащение: добавление дополнительных данных для конкретизации существующей информации. Например, обогащение данных о клиентах демографическими данными.
- Агрегация: объединение и обобщение данных, например, расчет общей выручки по региону.
Потоковая аналитика и Машинное обучение
Потоковая аналитика и машинное обучение - это расширенные возможности, которые можно применить к конвейеру потоковых данных:
- Аналитика в режиме реального времени: обработка SQL-запросов, фильтрация и сопоставление шаблонов;
- Модели машинного обучения: обучение и развертывание моделей машинного обучения в режиме реального времени для прогнозирования или классификации потоковых данных.
Хранение и постоянство данных
Для последующего анализа или долгосрочного хранения данных необходимо обеспечить хранение и постоянство данных. К наиболее распространенным вариантам хранения данных относятся:
- In-memory БД: высокопроизводительные базы данных, такие как Apache Cassandra или Redis, подходят для хранения скоротечных данных или случаев, требующих доступа с малой задержкой;
- Распределенные файловые системы: такие системы, как Apache Hadoop Distributed File System (HDFS) или Amazon S3, обеспечивают масштабируемое и долговременное хранение больших объемов данных;
- Хранилища данных: облачные хранилища данных, такие как Amazon Redshift или Google BigQuery, предоставляют мощные аналитические возможности и масштабируемое хранилище.
Data Delivery
После обработки данных их необходимо доставить в последующие системы. Это можно сделать с помощью:
- Конечных точек API: предоставление API для доступа и получения данных в режиме реального времени или в пакетном режиме;
- Pub/Sub: использование систем публикации/подписки сообщений, таких как Apache Kafka или Google Pub/Sub, для распространения данных среди различных подписчиков;
- Дашборды в режиме реального времени: визуализация потоковых данных в режиме реального времени с помощью таких инструментов, как Tableau или Grafana.
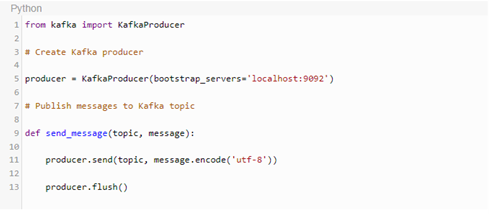
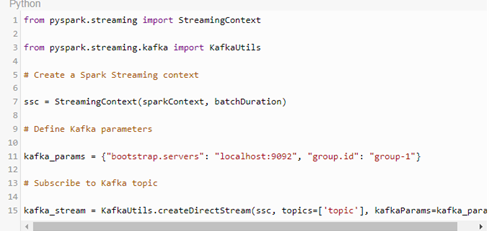
Вот примеры кода для конвейера потоковых данных с использованием Apache Kafka и Apache Spark:
Настройка Apache Kafka
Настройка Spark Streaming
Обработка потока сообщений
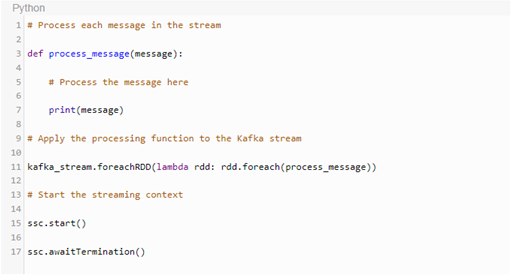
Этот код настраивает продюсера Kafka для публикации сообщений в Kafka. Затем он создает контекст Spark Streaming и подписывается на тему Kafka. Наконец, он обрабатывает каждое сообщение в потоке с помощью указанной функции.
Обязательно замените 'localhost:9092' на фактический адрес брокера Kafka, 'topic' - на тему, на которую Вы хотите подписаться, и укажите длину пакета.

Заключение
Создание конвейера потоковых данных требует тщательной проработки архитектуры и различных этапов всего процесса. Каждый этап - от приема данных до их обработки, хранения и доставки - вносит свой вклад в создание надежного конвейера данных, позволяющего получать информацию и аналитические данные в режиме реального времени. Следуя лучшим практикам и внедряя современные технологии, организации могут использовать всю мощь потоковых данных для принятия более эффективных решений и достижения поставленных целей.


