

Составление проектной документации для конвейеров данных
Обзор того, что именно, почему и как должно быть отражено в проектной документации для компонентов данных - и почему они важны.
За последние несколько лет активное внедрение лучших практик программной инженерии стало темой № 1 в области инженерии данных. Неограниченные возможности dbt, улучшенная наблюдаемость данных … - дата-инженеры все чаще и чаще пользуются инструментами и принципами инженеров-программистов.
Эта тенденция оказала значительное влияние на то, как мы стали проектировать и создавать конвейеры данных. Они стали гораздо надежнее (поскольку мы перешли от жестко закодированной бизнес-логики и сложных SQL-запросов к модульным dbt-моделям и макросам), а в Slack резко сократилось количество сообщений типа "Эй, Вы можете проверить эту таблицу?" (благодаря автоматизированному мониторингу качества данных и оповещениям).
Эти изменения помогли нам продвинуть индустрию в правильном направлении, но все же до сих пор есть области, в которых нам еще есть чему поучиться у наших коллег, занимающихся разработкой ПО.
Согласно последним данным, опубликованным dbt Labs, около 20 % проектов dbt имеют более 1 000 моделей (а 5 % - более 5 000 моделей). Эти цифры говорят о следующем - мы недостаточно тщательно подходим к вопросу разработки конвейеров данных. Слой за слоем мы формируем специальные модели и преобразования для каждого конкретного случая и в итоге получаем десять моделей, которые по сути представляют собой одну и ту же логическую сущность "с небольшими различиями".
В этой статье мы обсудим один «артефакт», который поможет нам спроектировать (и построить) надежный фундамент для наших платформ данных, а именно проектную документацию.
Что такое проектная документация?
В мире программной инженерии на этапе проектирования программного компонента, как правило, создаются два основных документа, которые в дальнейшем помогают инженерам организовать между собой эффективное сотрудничество и документировать принятые решения:
- Проектный документ или заявка на обсуждение (RFC) должна содержать всю необходимую информацию о текущем состоянии проекта, о том, почему необходимо что-то изменить, а также о возможных вариантах решений. Содержание документа формируется на основе отзывов и предложений от разных специалистов/команд до момента достижения консенсуса;
- Architecture decision record (ADR) фиксирует принятое решение. Этот документ представляет собой «письменный снимок», содержащий основные факторы, определившие техническое решение, а также различные аспекты самого решения/проекта.
Как правило, у компаний есть внутренний шаблон для обоих документов, который команды могут использовать для стандартизации процесса принятия технических решений. На данную тему есть отличный пост Гергели Ороша, дополненный множеством примеров. Кроме того, настоятельно рекомендую изучить обзор процесса разработки проектной документации в компании Google.
Зачем нужна проектная документация для конвейеров данных?
Одним из непредвиденных последствий подхода к построению конвейеров данных на основе dbt стало недостаточно внимательное отношение к вопросу добавлению новых узлов/моделей в граф. Вместо того, чтобы относиться к конвейерам данных как к сложному ПО, специалисты создают их, зачастую пропуская или недооценивая фазу проектирования, что приводит к появлению очень распространенного графа dbt lineage:

Основная проблема такого подхода заключается в том, что узлы добавляются в граф без особого присмотра. В результате возникает бесконечная спираль сложности, которая приводит к ненужным затратам и делает поиск подходящей таблицы практически невыполнимой задачей.
Поэтому очень важно относиться к конвейерам данных с той же тщательностью, с которой команды разработчиков ПО относятся к сложным программным компонентам. Это означает, что перед написанием моделей dbt необходимо определить (и согласовать) некоторые основополагающие блоки:
- Размер конвейера данных/активов данных;
- Изменения в слое потребления;
- Характеристики добавляемых активов;
- Проект самого конвейера данных
Как Вы уже могли догадаться, я предлагаю собрать всю эту информацию (и не только) в одном проектном документе, и, прежде чем приступать к реализации, убедиться в том, что все заинтересованные стороны с ним согласны.
Конвейер vs компонент
Прежде чем мы начнем обсуждать детали проектного документа, отмечу, что понятие масштаба, структуры платформы данных и организации команды (команд) инженеров в разных компаниях будет разным (в зависимости от множества факторов). Это означает, что концепции, представленные в данной статье, должны быть скорректированы в зависимости от Вашей платформы данных. Например, в Zendesk мы говорим о наших активах данных в контексте доменов данных, поэтому сферой применения проектной документации будет определенный именно домен данных.
То же самое относится и к определению "конвейера данных" - данный термин используется в этой статье, поскольку это общий логический компонент в пространстве инженерии данных, но более точным термином будет "компонент данных" (это может быть набор продуктов данных: конвейеры, таблицы или другие артефакты).
Как должна выглядеть моя проектная документация?
Теперь, когда мы убедились в том, что проектная документация имеет архиважное значение, следующий вопрос заключается в том, как адаптировать эту концепцию к конвейерам данных (или, точнее, компонентам данных) - какие основные разделы должны присутствовать в проектной документации компонента данных?
1. Проектные метаданные
Проектный документ - это прекрасная возможность объединить все необходимые метаданные для данного компонента. Эти метаданные могут включать следующее:
- Владение: У компонента должны быть разные владельцы (технические, бизнес и т. д.), которые отвечают за разработку и реализацию;
- Высокоуровневое описание: Важно составить очень краткое описание компонента, почему мы хотим его создать, и какие бизнес-проблемы он призван решить. Это позволит потенциальным участникам из разных команд ознакомиться с контекстом, необходимым для дальнейшей работы;
- Технические метаданные: Это зависит от Вашей платформы данных, но в любом случае важно указать дату начала (когда данные станут доступны) и предполагаемое наполнение истории (какая самая старая дата будет доступна?).
- Рецензенты и состояние рецензирования (необязательно): Эта информация может быть представлена отдельно от проектного документа (например, в отдельном документе ADR), но для упрощения и оптимизации процесса в этот раздел можно включить информацию о рецензентах (желательно, чтобы они входили в центральную команду, которая может оценить, как компонент вписывается в глобальный проект) и текущее состояние проекта (одобрен ли он или находится на промежуточном этапе).
В этом разделе не может быть "слишком много" метаданных. Если есть информация, которую стоит зафиксировать, то ей определенно найдется место здесь.
2. Имеющиеся ресурсы
В этом разделе собраны все ресурсы, относящиеся к компоненту данных. Они могут включать в себя документацию о существующем проекте или ссылки на проблемы, которые этот компонент будет решать.
Идея заключается в том, чтобы каждый, кто читает данную проектную документацию, получил доступ к полному контексту, связанному с этим компонентом данных, и ресурсам, относящимся к нему.
3. Основные показатели и примеры использования
Основная проблема «ситуативных» конвейеров данных заключается в том, что они создаются без четкой цели. Таблицы добавляются для решения спонтанных, плохо сформулированных задач, о которых затем быстро забывают.
Исходя из этого, я настоятельно рекомендую Вам сосредоточиться на метриках и последующих примерах использования еще до того, как Вы начнете думать о конвейерах. Данный раздел должен содержать подробную информацию по следующим пунктам:
- Каковы основные примеры использования для данного компонента данных?
- Какие основные показатели будут рассчитываться с помощью табличной части этого компонента?
4. Модель потребления
Теперь давайте определимся с тем, как должен выглядеть слой потребления.
После того, как мы перечислили основные метрики, этап моделирования данных становится намного проще, поскольку теперь он заключается в определении базовой модели данных, которая сможет обслуживать все последующие сценарии использования. В данном случае Вы можете использовать размерное моделирование данных или другие известные методы.
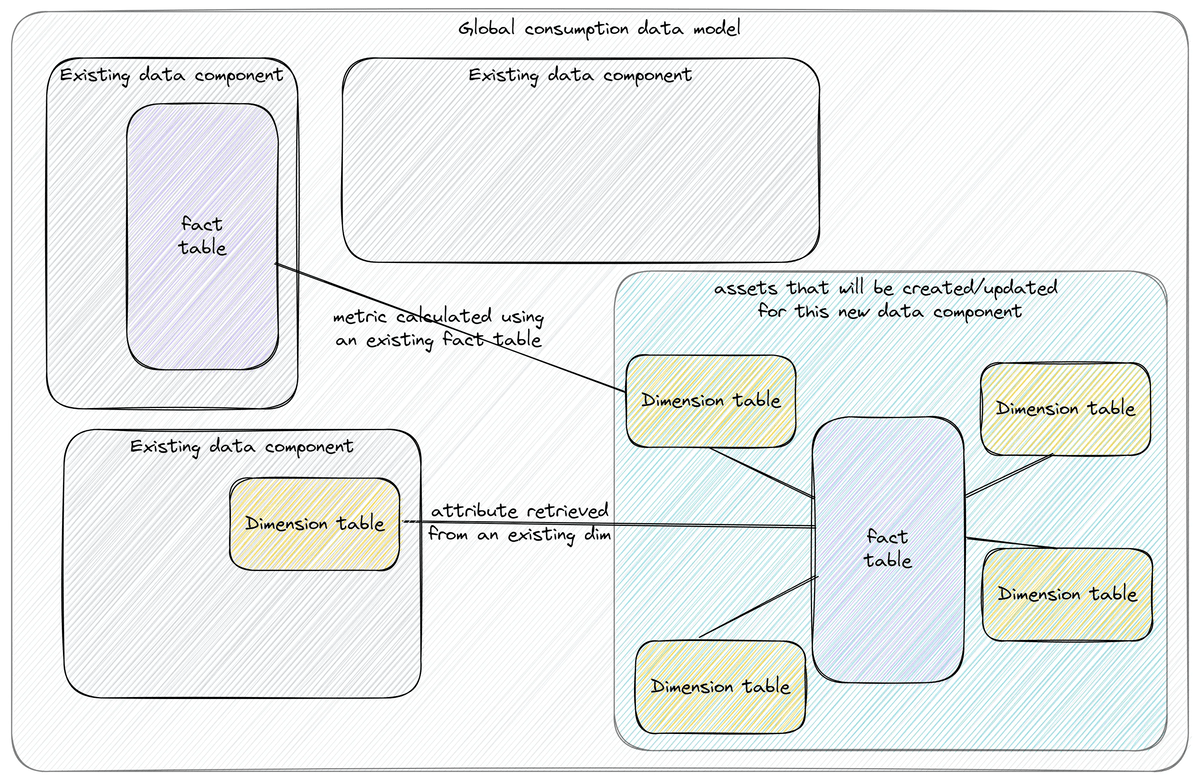
Заметьте, до сих пор мы ни разу не упомянули ни конвейеры данных ни модели dbt. Вместо этого мы сосредоточились на определении того, каким образом мы хотим представить активы данных, которые должны удовлетворить все наши потребности и метрики.
5. Метаданные на уровне таблиц (и столбцов)
После определения логической модели данных, в идеале, мы также должны предоставить контекст на разных уровнях относительно потребительских активов, которые будут созданы:
- Какую информацию будет содержать каждая таблица? (описание на уровне таблицы)
- Какие столбцы мы планируем предусмотреть для каждой таблицы? Какую информацию будет содержать каждый столбец? Берем ли мы на себя обязательства по качеству данных?
- Какова будет частота обновления данных для каждой таблицы? Берем ли мы на себя обязательства по каким-либо SLA?
- Какова будет смета расходов на первоначальное заполнение и каждое исполнение (для каждой таблицы)?
Наша цель состоит в том, чтобы убедиться, что все заинтересованные стороны согласны с тем, какие активы (таблицы) будут созданы, и какие обязательства придется на себя взять. В зависимости от Ваших стандартов разработки данных, этот раздел может включать и дополнительную информацию, например, касательно критичности каждой таблицы для бизнеса или ее сертификации.
6. Проект конвейера данных
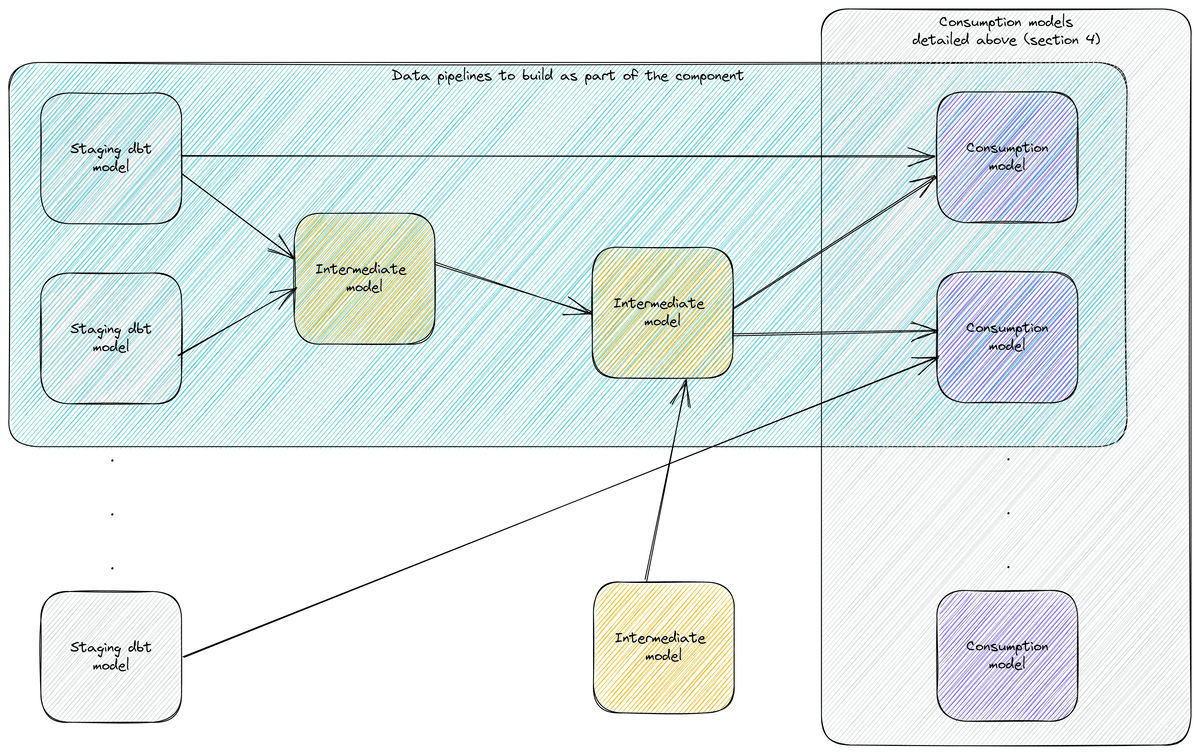
В последнем разделе я рекомендую сосредоточиться на конвейерах данных. Определив все метрики и ожидаемые обязательства, мы можем спроектировать то, как именно мы хотим получить желаемый результат.
Данный раздел будет содержать список всех исходных таблиц, которые мы хотим использовать как часть компонента данных (независимо от того, являются ли эти таблицы уже частью платформы данных или нам нужно будет предоставить данные с помощью Extract-Load процесса), а также модели dbt (или конвейеры данных), которые мы хотим построить.

Является ли данное решение масштабируемым?
Одной из первых реакций на подобный подход может быть предположение, что его будет слишком сложно масштабировать - это верно только в том случае, если у Вас искаженное понимание масштабируемости.
Масштабируемость не должна заключаться в том, чтобы ответить на тысячу сценариев использования с помощью тысячи моделей dbt. Напротив, масштабируемость, которую мы ищем, заключается в эффективном ответе на десять тысяч сценариев использования без попадания в бесконечный цикл сложности. В этом отношении данный подход (который фокусируется на создании надежной основы, настроенной на основные сценарии использования и учитывающей мнения всех заинтересованных сторон) определенно масштабируемый.
Заключение
В данной статье мы рассмотрели концепцию создания проектных документов, являющихся ценными артефактами, позволяющими нам проектировать и создавать надежные платформы данных и масштабируемые компоненты данных.
Ваша проектная документация может содержать не все разделы, упомянутые в данной статье. Самое главное, что всегда нужно помнить, - это то, что построение конвейеров данных и компонентов данных должно быть хорошо продумано и служить долгосрочным целям.


