
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс Современная архитектура хранилища данных » Архитектура конвейера потоковых данных

Архитектура конвейера потоковых данных

В этой статье мы рассмотрим архитектуру и основные компоненты конвейера потоковых данных


Поглощение данных

Поглощение данных - это первый этап конвейера потокового данных. Он включает в себя захват данных из самых различных источников, таких как Kafka, MQTT, файлы журналов или API. К самым распространенным методам захвата данных относятся:

  • Система очереди сообщений: для сбора и буферизации данных из различных источников используется брокер сообщений, например Apache Kafka;
  • Прямой поток: данные поступают из исходной системы напрямую в конвейер данных. Для этого могут использоваться коннекторы, специфичные для исходной системы, например коннектор Kafka или интеграция API.


Обработка и трансформация данных

После получения данных их необходимо обработать и преобразовать в соответствии с определенными бизнес- требованиями. На этом этапе решаются различные задачи, в том числе:

  • Валидация данных:  проверка данных на предмет их соответствия установленным правилам схемы и требованиям в области качества;
  • Нормализация данных: преобразование данных в нужный формат или схему, пригодную для последующей обработки;
  • Обогащение: добавление дополнительных данных для конкретизации существующей информации. Например, обогащение данных о клиентах демографическими данными.
  • Агрегация: объединение и обобщение данных, например, расчет общей выручки по региону.


Потоковая аналитика и Машинное обучение

Потоковая аналитика и машинное обучение - это расширенные возможности, которые можно применить к конвейеру потоковых данных:

  • Аналитика в режиме реального времени: обработка SQL-запросов, фильтрация и сопоставление шаблонов;
  • Модели машинного обучения: обучение и развертывание моделей машинного обучения в режиме реального времени для прогнозирования или классификации потоковых данных.


Хранение и постоянство данных

Для последующего анализа или долгосрочного хранения данных необходимо обеспечить хранение и постоянство данных. К наиболее распространенным вариантам хранения данных относятся:

  • In-memory БД: высокопроизводительные базы данных, такие как Apache Cassandra или Redis, подходят для хранения скоротечных данных или случаев, требующих доступа с малой задержкой;
  • Распределенные файловые системы: такие системы, как Apache Hadoop Distributed File System (HDFS)  или Amazon S3, обеспечивают масштабируемое и долговременное хранение больших объемов данных;
  • Хранилища данных: облачные хранилища данных, такие как Amazon Redshift или Google BigQuery, предоставляют мощные аналитические возможности и масштабируемое хранилище.


Data Delivery

После обработки данных их необходимо доставить в последующие системы. Это можно сделать с помощью:

  • Конечных точек API: предоставление API для доступа и получения данных в режиме реального времени или в пакетном режиме;
  • Pub/Sub: использование систем публикации/подписки сообщений, таких как Apache Kafka или Google Pub/Sub, для распространения данных среди различных подписчиков;
  • Дашборды в режиме реального времени: визуализация потоковых данных в режиме реального времени с помощью таких инструментов, как Tableau или Grafana.

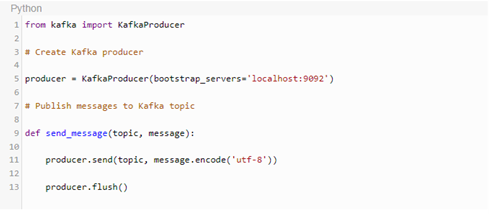
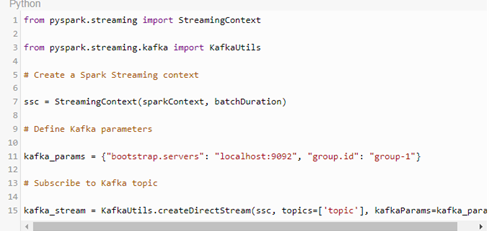
Вот примеры кода для конвейера потоковых данных с использованием Apache Kafka и Apache Spark:

Настройка Apache Kafka
 

Настройка Spark Streaming
 

Обработка потока сообщений
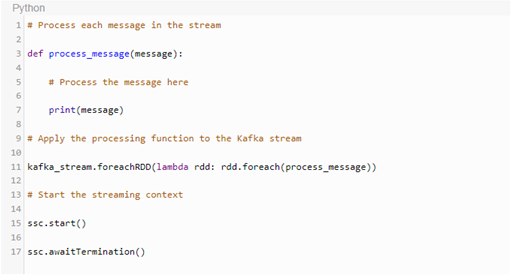
 

Этот код настраивает продюсера Kafka для публикации сообщений в Kafka. Затем он создает контекст Spark Streaming и подписывается на тему Kafka. Наконец, он обрабатывает каждое сообщение в потоке с помощью указанной функции.

Обязательно замените 'localhost:9092' на фактический адрес брокера Kafka, 'topic' - на тему, на которую Вы хотите подписаться, и укажите длину пакета.


Заключение

Создание конвейера потоковых данных требует тщательной проработки архитектуры и различных этапов всего процесса. Каждый этап - от приема данных до их обработки, хранения и доставки - вносит свой вклад в создание надежного конвейера данных, позволяющего получать информацию и аналитические данные в режиме реального времени. Следуя лучшим практикам и внедряя современные технологии, организации могут использовать всю мощь потоковых данных для принятия более эффективных решений и достижения поставленных целей.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Составление проектной документации для конвейеров данных
Следующая статья →
Self-service - аналитика как иерархия потребностей
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • ГК «Агропромкомплектация-Курск» - одна из ведущих в Российской Федерации агропромышленных компаний с полным производственным циклом "от поля до прилавка". За 32 года работы на рынке компания заслуженно завоевала репутацию одного из лидеров страны в производстве свинины и молока.

  • ООО «Модум-Транс» — независимый оператор грузовых железнодорожных перевозок, лидирующий по количеству инновационного парка на сети РЖД.

  • «Синтека» — ведущий разработчик инновационных сервисов для строительной отрасли, который решает ключевые задачи автоматизации службы снабжения строительных компаний.

  • С объединением компании Savencia Fromage & Dairy и молочного комбината в г.Белебей, одного из лидеров по производству твердых сычужных сыров в России, Savencia выходит на российский рынок не только как импортер, но и как производитель молочной продукции.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.