

CDC в PostgreSQL и MySQL с Apache Flink: архитектура, экосистема коннекторов и практические кейсы применения
Введение: контекст Change Data Capture в PostgreSQL/MySQL и роль Apache Flink
Change Data Capture (CDC) представляет собой паттерн проектирования, позволяющий обнаруживать и распространять изменения данных в системах хранения. В контексте реляционных баз данных CDC позволяет реагировать на события обновления, вставки и удаления без повторного чтения всего объема данных, что критично для современных аналитических платформ и оперативной отчетности. В источниках данных, таких как PostgreSQL и MySQL, CDC реализуется через чтение журналов транзакций: Write-Ahead Log (WAL) в PostgreSQL и binlog в MySQL. Такая реализация обеспечивает минимальную нагрузку на мастер-базу и низкую задержку между событием и последующим потребителем.
Apache Flink выступает как гибкая платформа для потоковой обработки данных в реальном времени и поддерживает обработку изменений как часть единой архитектуры. Благодаря строгим семантикам доставки (at-least-once и exactly-once в зависимости от конфигурации), stateful вычислениям и тесной интеграции с CDC-коннекторами, Flink позволяет не только передавать изменения, но и обогащать их, соединять данные из разных источников и строить проекции в виде таблиц и потоков с минимальной задержкой. В рамках корпоративных проектов CDC-подход становится основой для цифровой трансформации: от синхронизации источников до поддержки аудит-слоев, мониторинга рисков и ускорения принятия решений на основе актуальных данных.
Настоящая статья предназначена для аналитиков, архитекторов, лидов data-направлений и ИТ-директоров, которые хотят понять как концептуально устроен CDC в сочетании PostgreSQL/MySQL, Apache Flink и экосистемы коннекторов вокруг него; каковы архитектурные паттерны, гарантии доставки и операционные аспекты развёртывания; и как реализовать практические кейсы, начиная от захвата изменений в WAL/ binlog и заканчивая публикацией в Elasticsearch через ELK-стек и визуализацией в Kibana. Мы движемся от общих принципов к конкретным техническим решениям, подчёркивая стратегические решения, риски и направления дальнейших исследований.
Теоретическая база Change Data Capture: принципы, паттерны и гарантии
CDC базируется на двух основных подходах к получению изменений: через периодический сканинг и через потоковую обработку журналов изменений. Периодический full scan подходит для сценариев со слабо изменяющимися данными и для медленно меняющихся измерений (Slow Changing Dimensions), однако он вводит задержку и риск пропуска изменений между итерациями. В отличие от этого потоковый подход, основанный на логах базы данных, позволяет потребителям не только получать каждое изменение в порядке его фиксации, но и строить детерминированные проекции состояния.
Понимание семантик доставки имеет ключевое значение. В CDC встречаются три основных режима доставки: at-least-once, at-most-once и exactly-once. Первый обеспечивает повторную доставку событий в случае сбоев, что может приводить к дубликатам без противодействий на уровне потребителя. Режим exactly-once достигается посредством грамотной реализации через трансформацию данных на стороне потоков и надёжных механизмов управления состоянием, чтобы повторная обработка не приводила к неконсистентности. В контексте CDC в базе данных это означает не только корректную доставку событий, но и сохранение целостности источника и корректной корреляции между предварительным и последующим состоянием.
Ключевые концепции, которые следует зафиксировать, включают:
- Event-carried state transfer: передача состояния вместе со значениями изменений, что позволяет потребителю восстанавливать более полные проекции и поддерживать консистентность при обработке в режиме стриминга.
- Stateful вычисления: сохранение состояния между событиями, поддержка окон (tumbling, sliding, session) и управление временем события, задержками и обработкой поздних данных.
- Архитектура на основе источников-конвейеров-потребителей: источники данных (PostgreSQL, MySQL), конвейеры преобразования (CDC-коннекторы и потоковая обработка) и потребители (информационные панели, хранилища, поисковые индексы).
В теоретическом плане CDC в Flink опирается на универсальные принципы обработки потоков данных: единая модель времени, преобладание процедурной части над purely batch-образами, детальная работа с changelog в виде набора изменений и возможность конвертации изменений в табличный API Flink. Роль Debezium и интеграционных коннекторов в этом контексте сводится к надёжному извлечению изменений из журналов и генерации структурированных сообщений, удобных для последующей обработки в Flink.
Архитектурные подходы к CDC: от периодического сканирования к потоковой работе с журналами изменений
Архитектура CDC выбирается в зависимости от целей, требований к задержкам, объёма данных и доступности инфраструктуры. Традиционно выделяют две фундаментальные парадигмы:
- Периодическое сканирование (full scan) с детектированием изменений между snapshots. Этот подход прост в реализации и не требует доступа к журналам транзакций, однако он несёт риск пропуска событий и существенные задержки, особенно в больших системах. Он применим для медленно изменяющихся измерений и для задач, где точный порядок изменений не критичен.
- Потоковая обработка журналов изменений (log-based CDC), основанная на WAL (Write-Ahead Log) в PostgreSQL или binlog в MySQL. Эта парадигма обеспечивает минимальную задержку и высокий уровень детальности событий. Она требует поддержки логирования на уровне СУБД и доступ к журналам транзакций, что возможно через настройки репликации и Identity репликации. В этом контексте Debezium и Flink CDC Conectors позволяют реализовать цепочку обработки: журнал транзакций → топики Kafka (или непосредственно в поток Flink) → анализ и агрегации.
Преимущества потокового подхода очевидны: практически нулевые задержки между изменением и доступностью изменений, меньшая нагрузка на источник данных по сравнению с частыми сканированиями, возможность поддержания обновляемых проекций в реальном времени. Но потоковый подход требует устойчивого управления состоянием и обработки ошибок, обеспечения целостности и согласованности между мастером и потребителями, а также настройки на уровне базы данных (wal_level, replica identity и пр.).
С практической стороны ключевым моментом становится согласование границ между точной доставкой событий и распределённой обработкой. В рамках CDC задача состоит не только в "пересылке" изменений, но и в построении корректных проекций, которые потребитель может использовать для аналитики или транзакционных операций. Именно здесь архитектуры, поддерживающие stateful вычисления и правильную семантику доставки, выходят на передний план.
Потоковая обработка изменений и event-driven архитектура: роль stateful вычислений
Переход к потоковой обработке изменений означает переход к архитектуре, в которой данные представляются не как статические наборы строк, а как непрерывный поток событий. В таком контексте ключевую роль играют stateful вычисления, позволяющие сохранить контекст на протяжении обработки и использовать его для построения сложных проекций.
Stateful подход в Flink реализуется через механизмы управления состоянием операторов, а также через окна (windows), которые позволяют агрегировать события во времени. В CDC это особенно полезно, когда нужно сопоставлять данные из разных таблиц, например, делать join между информацией о клиенте, его транзакциями и геолокацией, а затем сохранять результаты в системе хранения данных или поисковый индекс.
Рассмотрим типовую схему: источники изменений (PostgreSQL/MySQL) через CDC-коннекторы подготавливают события в виде потоков изменений. Затем эти события проходят этапы обработки в Flink: извлечение, трансформация, агрегации и корреляции между событиями разных типов. В рамках event-driven архитектуры каждое событие несёт трафареты состояния и может инициировать последующие процессы, например, обновление внешнего индекса или формирование агрегированных метрик.
Гарантии доставки и обработка поздних данных являются критическими вопросами. Exactly-once может быть достигнуто при правильно настроенном состоянии и детерминированной Idempotent-логике на стороне потребителя. Однако в реальных сценариях часто используется гибридный подход: at-least-once на входе с механизмами дедупликации и идемпотентности на выходе. Важно помнить, что семантика exactly-once в полном объёме зависит от используемых источников и sink-тайп. Например, при публикации в Elasticsearch пользователи чаще всего применяют idempotent-записи или апдейты, чтобы избежать дубликатов в индексе.
Декомпозиция технических компонентов и их взаимодействие в CDC-решении
CDC-решения представляют собой сложные конвейеры, состоящие из нескольких взаимосвязанных компонентов. Основные участники:
- Источник изменений: реляционная база данных, такая как PostgreSQL или MySQL, с включённым логированием изменений (WAL/binlog) и корректной настройкой replica identity или аналогичных механизмов. Это обеспечивает детальное отражение изменений, включая старые значения полей.
- CDC-коннектор: компонент, отвечающий за извлечение изменений из журнала и представление их в виде событий, пригодных для дальнейшей обработки. В экосистеме широко применяются Debezium (для журналов) и коннекторы Flink CDC, которые позволяют считывать лог непосредственно и конвертировать его в табличный или потоковый формат.
- Подсистема обмена сообщениями: часто используют Kafka как брокер потоков, который обеспечивает масштабируемость, буферизацию и долговременное хранение событий. В некоторых случаях возможно прямое потребление Flink-джобой без Kafka, но Kafka остаётся удобной точкой интеграции и позволяет decoupling компонентов.
- Обработчик потоков: Apache Flink, который, в зависимости от конфигурации, может работать как единый кластер для обработки SQL-запросов через Table API и как DataStream-путь для более тонкой реализации потоковых преобразований и соединений.
- Потребители и хранилища: Elasticsearch (для индексирования и аналитики), Kibana (визуализация), а также другие системные потребители, например data-warehouses или BI-инструменты.
- Контроль и мониторинг: Flink WebUI, сбор метрик, логи и мониторинговые панели, которые позволяют наблюдать задержки, пропускную способность и состояние конвейера.
Ключевым моментом взаимодействия является согласование форматов сообщений между коннектором и Flink. Debezium обычно публикует изменения в JSON-формате с полями до/после состояния и флагами типа операции. Flink SQL Table API может превратить эти данные в таблицу, а затем преобразовать их в DataStream для дальнейшей обработки. В некоторых сценариях возможно минимизировать число посредников и реализовать прямую интеграцию через CDC-коннектор Flink, что сокращает задержки и упрощает инфраструктуру, но требует аккуратной настройки и тестирования совместимости версий.
Архитектура данных CDC: источники, конвейеры и потребители
Архитектура данных CDC описывает, как данные проходят от источников к потребителям через конвейеры трансформаций. В этом контексте источники - это базы данных PostgreSQL или MySQL, которые генерируют изменения через журнал транзакций. Конвейеры - это комбинации CDC-коннекторов и обработчиков потоков (Flink), которые превращают журнал изменений в структурированные события, обогащённые и коррелированные. Потребители - это Elasticsearch, аналитические базы, системы мониторинга и другие целевые хранилища.
Основные принципы при построении архитектуры CDC:
- Архитектурная цель: обеспечить непрерывный поток изменений, минимизировать задержки и сохранить целостность данных на всем конвейере.
- Форматы данных: использование JSON или Kafka Record форматов, которые позволяют сохранять старые и новые состояния элемента, поддерживать временные метки и обеспечить обратную совместимость.
- Обогащение и денормализация: часто требуется объединение изменений из нескольких источников для построения полноценных бизнес-сущностей. В таком подходе данные сначала читаются из разных таблиц, затем через join-обработку в окнах формируется единая проекция и публикуется в целевые хранилища.
- Механизмы контроля: обработка ошибок, повторная попытка, мониторинг задержек и пропускной способности, тестирование под нагрузкой.
Ключевые компоненты архитектуры: источники изменений, CDC-коннекторы, потоковое вычисление (Flink), агрегаторы и sinks. Этот каркас позволяет последовательно обрабатывать изменения и поддерживать согласованные проекции по бизнес-объектам.
Фреймворк Apache Flink в контексте CDC: API SQL и DataStream, гарантии доставки
Apache Flink - это гибкая платформа потоковой обработки данных с богатым набором API. В контексте CDC востребованы два основных уровня:
- API SQL (Table API): декларативный подход, где разработчик описывает таблицы и запросы на уровне SQL, а Flink компилирует их в план обработки. Это упрощает реализацию сложных трансформаций, соединений и агрегаций.
- DataStream API: программно-ориентированный путь, который обеспечивает полный контроль над потоком событий, управлением состоянием и реализацией пользовательской логики.
Для CDC Flask применим ряд механизмов:
- Поддержка changelog-потоков: Flink может превращать изменения, полученные из источника (через Debezium или Flink CDC коннектор), в changelog-трассу, сохраняя старые и новые значения и облегчая последующее объединение.
- Гарантии доставки: Flink поддерживает at-least-once и exactly-once режимы обработки. В контексте CDC это особенно важно для корректной агрегации и предотвращения дубликатов. Exactly-once достигается через единообразное управление состоянием и детерминированные выходы, например при записи в Elasticsearch с использованием идемпотентности или уникальных ключей записи.
- Управление временем: Flink предлагает временные семантики и окна (TumblingProcessingTimeWindows, EventTime, ProcessingTime) для корреляций между событиями из разных таблиц. В CDC-линейке окна помогают агрегировать транзакции и обновления местоположения по клиентам и временным отрезкам.
Тесная интеграция с CDC-коннекторами (Flink CDC, Debezium) позволяет реализовать конвейер: изменения из журналов → JSON-настройки Debezium → преобразование в Table/Changelog в Flink → вывод в Elasticsearch/Kafka/базы. Такой подход обеспечивает единое представление об изменениях и гибкость при построении бизнес-логики.
CDC-коннекторы и экосистема: Flink CDC, Debezium, интеграции с Kafka
Экосистема CDC включает несколько важных компонентов. Flink CDC - набор коннекторов, разработанных Alibaba/Ververica, который позволяет напрямую читать журналы баз данных и преобразовывать изменения в формат, удобный для Flink. Debezium - популярный движок изменений, который захватывает события из журналов и размещает их в Kafka, обеспечивая трассируемость и устойчивость потока.
Ключевые паттерны взаимодействия:
- Debezium + Kafka + Flink: Debezium читает журнал БД и публикует события в Kafka. Flink подписывается на Kafka-топики, читает JSON-сообщения Debezium и преобразует их в таблицы или DataStream для последующих трансформаций. Этот паттерн обеспечивает модульность и простое масштабирование, но introduces дополнительные задержки и инфраструктурные сложности.
- Flink CDC Connectors без промежуточной Kafka: коннекторы Flink могут читать журналы напрямую и выдавать данные во Flink-процессы. Это упрощает архитектуру и может снизить задержку, но требует более тесной интеграции и строгой совместимости версий коннектора и базы данных.
- Интеграция с Elasticsearch: для целей аудита и аналитики, выдача результатов в Elasticsearch целесообразна. Kibana обеспечивает визуализацию. В рамках v2 решений можно избегать дополнительной трансформации, отправляя агрегаты напрямую в Elasticsearch, но чаще требуется этап трансформации и обогащения на Flink-слое.
Эта экосистема обеспечивает гибкость и масштабируемость: можно строить конвейеры, которые объединяют данные из нескольких БД, применяют агрегации во временных окнах и публикуют результаты в целевые хранилища для анализа и принятия решений.
ETL-паттерн на основе CDC: Extract-Transform-Load и роль Event Carried State Transfer
ETL-паттерн в CDC-архитектуре состоит из следующих стадий:
- Extract (Извлечение): CDC-источник извлекает изменения из журналов БД. Debezium считывает WAL/binlog и конструирует структурированные события.
- Transform (Преобразование): события проходят трансформацию и обогащение. В Flink они реализуются через Table API и DataStream, где выполняются фильтрации, привязки к справочникам, разведения по ключам и вычисления производных метрик.
- Load (Загрузка): результаты отправляются в целевые хранилища: Elasticsearch, другие базы данных, аналитические системы. В некоторых случаях загружаются в Kafka для дальнейшей интеграции.
Особую роль играет концепция Event Carried State Transfer (ECST). ECST предполагает передачу контекста состояния вместе с данными события. Это позволяет потребителю реконструировать актуальное состояние сложной бизнес-объекта даже если поступающие данные приходят в виде отдельных изменений. В сочетании с stateful вычислениями Flink ECST обеспечивает мощный механизм materialization иs и поддерживает идемпотентность на концевых узлах.
Преимущества данного подхода включают:
- Ускорение реакции на события за счёт минимизации задержек между источником и потребителем.
- Гибкость в построении денормализованных представлений и агрегатов в реальном времени.
- Улучшение качества аудита и мониторинга благодаря непрерывному трекингу изменений.
Практическая реализация кейса: захват изменений из WAL PostgreSQL и публикация в ELK
Практическая часть кейса демонстрирует, как реализовать CDC-процессы на реальном стенде: PostgreSQL в роли источника изменений с WAL, применение Flink CDC коннекторов для захвата изменений, последующее агрегирование и публикацию в ELK-стек (Elasticsearch и Kibana). В рамках кейса рассматриваются следующие шаги:
- Настройка WAL-логирования: включение wal_level не ниже logical, настройка replica identity и подключение реплики для минимизации воздействия на мастер. Это обеспечивает полноту изменений и корректную передачу старых значений для UPDATE/DELETE.
- Развёртывание инфраструктуры: docker-compose с сервисами PostgreSQL, Elasticsearch, Kibana и кластером Flink (Job Manager и Task Manager). В работе используются Debezium и Flink-CDC для захвата изменений и их преобразования.
- Табличная модель в Flink: создание таблиц через Flink Table API, отражающих структуру источников: Clients, ClientTransactions, ClientLocation. Затем данные превращаются в DataStream и проходят через агрегации.
- Обогащение и объединение: данные о клиентах соединяются с транзакциями и локациями во временных окнах, используется event-driven подход для формирования итоговых сущностей.
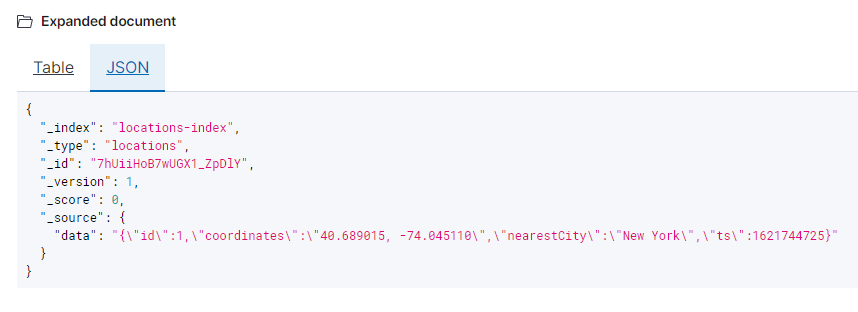
- Загрузка в Elasticsearch: результаты агрегирования публикуются в индексы locations-index, aggregations-index, clients-index, transactions-index. Kibana служит визуальным интерфейсом к этим индексам, обеспечивая аудит и мониторинг.
- Мониторинг и визуализация: Flink WebUI отображает DAG и исполнение джобов; Elasticsearch и Kibana представляют индексы и визуальные дашборды.
Этот кейс демонстрирует, что сочетание Flink, Debezium и ELK может дать компактную и эффективную архитектуру для реального времени, где минимальные задержки и точная детерминированная доставка изменений являются критически важными.
Архитектура данных и модели: Clients, ClientTransactions, ClientLocation
Рассматривая структурно ориентированную модель, в примере кейса выделяются три ключевых сущности:
- Clients: основная таблица клиентов с полями идентификатора, имени, фамилии, пола и адреса. Это медленно изменяющаяся размерная (Slow Changing Dimension) таблица, для которой CDC-процедуры сначала выполняют снапшот, затем переходят к потоковым обновлениям.
- ClientTransactions: сведения о транзакциях клиентов, включая идентификатор клиента, сумму и временную метку транзакции. Эти данные являются оперативными фактами и часто требуют агрегаций и корреляций.
- ClientLocation: геолокационная информация клиентов, полученная из мобильного приложения или локальных сервисов, включая координаты и временные метки. Эта таблица служит источником для геопространственных аналитик и корреляций.
Эти три сущности служат основой для событийной архитектуры и формирования целевых проекций. В процессе обработки может потребоваться доп. справочники или границы времени, чтобы корректно управлять поздними данными и временными окнами агрегаций.
Реализация на практике: создание таблиц Flink Table API, преобразование в DataStream и агрегации
Практическая реализация в рамках Flink предполагает несколько этапов:
- Определение таблиц через Flink Table API: создание отражений источников PostgreSQL (Clients, ClientTransactions, ClientLocation) в рамках Flink, с указанием схемы и источников данных.
- Преобразование в DataStream: через conversion функции Flink, например tableEnv.toChangelogStream(...), что позволяет получить поток изменений и сохранить возможность дальнейших изменений на уровне событий.
- Обогащение и агрегации: объединение потоков по ключу клиента в окна (например, tumbling window на 2-5 минут) для транзакций и локаций, затем объединение с таблицей Clients для получения полной информации по клиенту.
- Публикация в Elasticsearch: преобразование агрегированных объектов в соответствующие кейс-классы и их публикация в индексы Elasticsearch для аналитики и аудита.
- Мониторинг результатов: визуализация данных в Kibana, анализ задержек, пропускной способности и точности агрегаций.
Двухступенчатый подход, где сначала формируются детальные записи аудита в отдельные индексы (clients-index, transactions-index, locations-index), а затем строится агрегированная сущность aggregations-index, позволяет строить и аудит, и подробные аналитические проекции. В коде часто применяются смешанные подходы: сначала таблицы Flink Table API, затем DataStream-путь и сопутствующие Sinks. Это демонстрирует гибкость Flink и его способность сочетать табличный и стримовый API для достижения целей CDC.
Инфраструктура развёртывания: docker-compose, wal_level, replica identity и настройка Debezium
Практическое развёртывание CDC-платформы требует внимательного подхода к конфигурации инфраструктуры. Основные моменты включают:
- Уровень логирования базы данных: wal_level и параметры идентификации строк (replica identity) должны быть сконфигурированы на уровне СУБД, чтобы обеспечить полноту данных и возможность возврата старых значений для UPDATE/DELETE.
- Настройки Debezium: Debezium использует лог базы данных для захвата изменений. Конфигурация должна включать правильные параметры подключения, схемы трансляций и обработку старых значений.
- docker-compose: развёртывание набором контейнеров, включая PostgreSQL, Elasticsearch, Kibana, Flink Job Manager и Task Manager. В качестве образа Postgres часто выбирается Debezium-образ, который содержит необходимые плагины декодирования WAL.
- Производственные требования: выделение достаточного объёма памяти и CPU для всех сервисов, настройка сетевых ограничений и мониторинга.
Эти настройки обеспечивают надёжное и масштабируемое развёртывание CDC-решения, позволяя как локальные эксперименты, так и полноценные промышленные стенды. Важной частью является подготовка DDL и тестовых данных в базе, чтобы проверить корректность снапшотов и последовательность событий.
Мониторинг и визуализация: Elasticsearch, Kibana, Flink WebUI
Мониторинг является критическим компонентом CDC-решения. Flink WebUI предоставляет интерактивную визуализацию DAG-структуры и состояния джобов, включая задержки, throughput и текущий прогресс обработки. Elasticsearch с Kibana обеспечивает хранение и визуализацию индексированных данных аудита и агрегатов. В Kibana можно быстро создать дашборды, где присутствуют:
- индексы аудита по клиентам, локациям и транзакциям;
- агрегированные метрики по объединению данных;
- графики задержек и пропускной способности конвейера.
Такая синергия инструментов позволяет IT-команде оперативно обнаруживать проблемы, а бизнес-аналитикам - быстро исследовать поведение клиентов и транзакций в реальном времени.
Интеграция технологических стеков и их синергия: совместная работа Flink, Debezium, Kafka и Elasticsearch
Успешная интеграция перечисленных стеков зависит от грамотной координации между компонентами и устойчивого управления потоком данных. В типичной архитектуре CDC:
- Debezium выступает как первый уровень захвата изменений и публикует их в Kafka Topics, которые служат буфером и транспортом.
- Flink обеспечивает обработку событий в реальном времени, применяет трансформации, объединения и агрегации, генерируя новые события и проекции.
- Kafka выступает как распределённый журнал и буфер, особенно полезен в сценариях горизонтального масштабирования и устойчивости к сбоям.
- Elasticsearch и Kibana являются целевым хранилищем и инструментом визуализации, которые поддерживают аудит и анализ в реальном времени.
В некоторых реализациях возможен прямой поток из репозитория журналов БД в Flink без Kafka, что упрощает инфраструктуру. Но для крупных систем с высоким уровнем изменения и необходимостью устойчивости часто выбирают смешанный подход Debezium + Kafka + Flink, с последующим выводом в Elasticsearch. В любом случае критически важны согласование форматов данных, идентификаторов изменений и идемпотентность на уровне писателей в целевые хранилища.
Кейсы применения в реальных сценариях: финансовые операции, аудит и фрод-мониторинг
CDC-решения находят применение в разных сценариях, где критически важна синхронная и полноценно отраженная информация о состоянии бизнес‑объектов. В финансовом контексте CDC позволяет:
- отслеживать каждую операцию клиента в режиме реального времени;
- строить детальные аудиторские ленты изменений, удовлетворяющие регуляторным требованиям;
- быстро обнаруживать и расследовать подозрительные паттерны через фрод-мониторинг.
Для аудита и комплайенса CDC обеспечивает неизменяемый источник изменений, поддерживаемый через журнальные логи и независимые потребители. В телекоммуникациях, ритейле и государственном секторе подобные решения позволяют:
- синхронизировать данные между системами (CRM, ERP, BI) без зависания и конкурирующих обновлений;
- строить единое представление клиента через объединение данных из Clients, ClientTransactions и ClientLocation;
- поддерживать аналитическую активность и мониторинг по операциям и геолокации.
Эти кейсы демонстрируют практическую востребованность CDC в реальных бизнес‑потребностях, где низкие задержки, точная доставка и качественный аудит оптимизируют процессы и снижают риски.
Возможности применения в различных экономических секторах: банковский, ритейл, телеком и государственный сектор
CDC решения находят применение в множестве отраслей:
- банковский сектор: мониторинг транзакций клиентов в режиме реального времени, сопоставление операций в разных системах, аудит и соблюдение нормативов.
- ритейл: синхронизация клиентских профилей, локаций и транзакций между онлайн- и офлайн-каналами, агрегация поведения для персонализации и аналитики.
- телекоммуникации: отслеживание клиентских сессий, услуг и местоположения, поддержка мониторинга абонентских операций и предотвращение мошенничества.
- государственный сектор: интеграция региональных данных, аудит изменений, обеспечение прозрачности и подотчетности.
Эти примеры демонстрируют, как CDC в связке Postgres/MySQL + Flink + CDC-коннекторы может быть трансформирован в единый модуль для разных отраслевых сценариев, сохраняя при этом согласованность и обеспечивая мониторинг в реальном времени.
Анализ рисков, уязвимостей и ограничений с метриками эффективности: latency, throughput, exactly-once, мониторинг
Риски и ограничения CDC-решений следует рассматривать системно:
- латентность (latency): задержка между событием и доступностью в целевой системе; может быть критической для реального времени.
- пропускная способность (throughput): объем изменений, который конвейер может обрабатывать за единицу времени; ограничивается размером кластера, настройками коннекторов и нагрузкой на источники.
- exactly-once: достижение полной точности без дубликатов сложнее, требует идемпотентности и согласованности на краях конвейера.
- мониторинг: необходимость активного мониторинга задержек, ошибок, сбоев, а также корректности агрегаций и дат, особенно при поздних данных.
- совместимость версий: различия в версиях Debezium, Flink CDC connectors и СУБД могут привести к несовместимости; тестирование совместимости и регрессионные тесты критичны.
- устойчивость к сбоям: обеспечение, что после отказа часть данных не потеряется, а конвейер восстанавливается корректно.
Эффективность CDC оценивают по совокупности метрик: задержки, пропускная способность, доля ошибок, время восстановления после сбоев и точность агрегаций. Важно проектировать архитектуру с учётом реальных практических ограничений и бизнес‑требований.
Конкурентный анализ конкурирующих решений и их дифференциация
На рынке существуют несколько подходов к CDC. В числе основных:
- Debezium в связке с Kafka: хорошо зарекомендовал себя как надёжная система захвата изменений, особенно в экосистемах, ориентированных на Kafka. Преимущества - зрелость, обширная экосистема, простота масштабирования. Недостатки - может быть дополнительная задержка через Kafka и больше точек интеграции.
- Flink CDC Connectors: позволяют «приклеить» CDC к Flink-джобам, снижая задержки и упрощая архитектуру за счёт прямой интеграции с Flink. Преимущества - минимальная задержка, контроль над состоянием и возможностью прямой версионной обработки. Недостатки - зависимость от совместимости версий и сложности настройки.
- Прямые коннекторы Flink к логам БД: минимизируют количество компонентов и задержку, но требуют глубокой интеграции с СУБД и сложной поддержки.
Дифференциация между решениями опирается на: задержки, сложность инфраструктуры, требования к exactly-once и масштабируемость. В некоторых случаях оптимальным решением является смешанная архитектура: Debezium + Kafka + Flink для обеспечения надёжности и гибкости, с опциональным переходом на прямые коннекторы Flink для узких сценариев, где нужен сверхнизкий latency.
Практические выводы, рекомендации и направления дальнейших исследований
- CDC в PostgreSQL/MySQL с Apache Flink - мощный подход к реализации реального времени, который позволяет строить детализированные аудиты, управлять данными и поддерживать аналитические экосистемы.
- Архитектура должна учитывать не только технологическую эффективность, но и управляемость: мониторинг, логирование и документирование каждой стадии конвейера.
- Важно обеспечить согласование форматов данных, единые ключи и устойчивые стратегии обработки ошибок и дубликатов.
- Рекомендуется начинать с гибридной архитектуры: Debezium + Kafka для устойчивого захвата изменений и Flink для обработки и агрегаций, затем рассмотреть возможность прямых коннекторов Flink для снижения задержек в рамках критически важных сценариев.
- В исследованиях следует сосредоточиться на улучшении методик ECST и управлении поздними данными, адаптивных окон и динамических схемах изменений, чтобы обеспечить более гибкие проекции и устойчивость к изменчивым нагрузкам.
Вопрос-Ответ:
- Вопрос: Что такое CDC и зачем он нужен в современной архитектуре данных?
Ответ: Change Data Capture (CDC) - подход к отслеживанию изменений в исходных базах данных и распространению их в потребителей в реальном времени. Он обеспечивает актуальность данных, минимизирует нагрузку на источники и ускоряет аналитическую обработку и мониторинг. - Вопрос: Какие преимущества даёт использование Flink в CDC-проектах?
Ответ: Flink обеспечивает stateful вычисления, точную семантику доставки, возможности обработки в реальном времени и гибкость в использовании Table API и DataStream API. Это позволяет строить сложные проекции и агрегаты в потоковом режиме. - Вопрос: Какую роль играют CDC-коннекторы Debezium и Flink в связке?
Ответ: Debezium осуществляет захват изменений из журналов БД и публикацию в Kafka, а Flink обрабатывает эти события, реализуя преобразования, агрегации и загрузку в целевые системы. В некоторых случаях возможно прямое подключение Flink к журналам БД без Debezium. - Вопрос: Что означает ECST в контексте CDC?
Ответ: Event Carried State Transfer - концепция передачи состояния вместе с изменениями, что позволяет потребителю реконструировать полное состояние бизнес-сущности, улучшая консистентность и сокращая задержки. - Вопрос: Какие основные риски связаны с CDC-архитектурой?
Ответ: Основные риски - задержки и пропуск изменений, дубликаты и неидемпотентность, несоответствие версий компонентов, трудности мониторинга и восстановления после сбоев. - Вопрос: Где чаще всего размещается логика агрегаций для CDC?
Ответ: Логика агрегаций чаще всего размещается в обработчиках Flink DataStream, где возможно использование окон (например, tumbling windows) и объединение данных из разных источников. - Вопрос: Какие сектора получают наибольшую пользу от CDC‑решений?
Ответ: Банковский сектор, розничная торговля, телекоммуникации и государственный сектор - это области, где требуется реальное время, аудит и точная синхронизация данных между системами. - Вопрос: Какие метрики следует отслеживать при эксплуатации CDC‑конвейера?
Ответ: Latency (задержка), Throughput (пропускная способность), вероятность дубликатов, время восстановления после сбоев и точность агрегаций. Метрики обеспечивают управляемость и качество данных.
Мы рассмотрели архитектуру CDC в контексте PostgreSQL и MySQL с Apache Flink, обсудили паттерны, коннекторы, практические кейсы и риски, а также предложили рекомендации по выбору архитектурных решений и направлениям исследований. Это базовая платформа для внедрения современных решений по обработке данных в реальном времени в корпоративной среде, которая позволяет сочетать мощь потоковой обработки, надёжность журналирования изменений и гибкость интеграций с экосистемой аналитических инструментов.


