Обработка запросов в PostgreSQL - обзор
Несмотря на то, что в версии 9.6. реализована возможность распараллеливания запросов, PostgreSQL использует несколько фоновых рабочих процессов, а также обслуживающий процесс (backend), который в основном обрабатывает все запросы, отправляемые подключенным клиентом. Обслуживающий процесс состоит из 5 подсистем:
- Парсер (parser) преобразовывает текст на языке SQL в дерево разбора;
- Анализатор запроса (analyzer) генерирует из дерева разбора начальный логический план запроса (реляционное выражение);
- Система правил (rewriter) принимает разобранный запрос, одно дерево запроса, а также определённые пользователем правила перезаписи, представленные деревьями с некоторой дополнительной информацией, и создаёт определенное количество деревьев запросов;
- Планировщик (planner) создает наиболее оптимальный план выполнения запроса на основе множества факторов;
- Исполнитель (executor) выполняет запрос, обращаясь к таблицам и индексам в том порядке, который был создан деревом плана, и формирует результирующий набор строк, возвращаемый клиенту в виде серии сообщений.

В данном разделе представлен краткий обзор этих подсистем. Поскольку планировщик и исполнитель достаточно сложны, их подробное объяснение дано в последующих разделах.
Примечание: подробное описание выполнения запросов в PostgreSQL Вы сможете найти в официальном документе.
Парсер
Парсер генерирует дерево разбора, которое может быть прочитано последующими подсистемами из SQL-оператора в виде обычного текста. Приведем конкретный пример, не вдаваясь в подробности.
Рассмотрим следующий запрос:
testdb=# SELECT id, data FROM tbl_a WHERE id < 300 ORDER BY data;
Дерево разбора - это дерево, корневым узлом которого является структура SelectStmt.
SelectStmt:
typedef struct SelectStmt
{
        NodeTag         type;

        /*
         * These fields are used only in "leaf" SelectStmts.
         */
        List       *distinctClause;     /* NULL, list of DISTINCT ON exprs, or
                                         * lcons(NIL,NIL) for all (SELECT DISTINCT) */
        IntoClause *intoClause;         /* target for SELECT INTO */
        List       *targetList;         /* the target list (of ResTarget) */
        List       *fromClause;         /* the FROM clause */
        Node       *whereClause;        /* WHERE qualification */
        List       *groupClause;        /* GROUP BY clauses */
        Node       *havingClause;       /* HAVING conditional-expression */
        List       *windowClause;       /* WINDOW window_name AS (...), ... */

        /*
         * In a "leaf" node representing a VALUES list, the above fields are all
         * null, and instead this field is set.  Note that the elements of the
         * sublists are just expressions, without ResTarget decoration. Also note
         * that a list element can be DEFAULT (represented as a SetToDefault
         * node), regardless of the context of the VALUES list. It's up to parse
         * analysis to reject that where not valid.
         */
        List       *valuesLists;        /* untransformed list of expression lists */

        /*
         * These fields are used in both "leaf" SelectStmts and upper-level
         * SelectStmts.
         */
        List       *sortClause;         /* sort clause (a list of SortBy's) */
        Node       *limitOffset;        /* # of result tuples to skip */
        Node       *limitCount;         /* # of result tuples to return */
        List       *lockingClause;      /* FOR UPDATE (list of LockingClause's) */
        WithClause *withClause;         /* WITH clause */

        /*
         * These fields are used only in upper-level SelectStmts.
         */
        SetOperation op;                /* type of set op */
        bool            all;            /* ALL specified? */
        struct SelectStmt *larg;        /* left child */
        struct SelectStmt *rarg;        /* right child */
        /* Eventually add fields for CORRESPONDING spec here */
} SelectStmt;
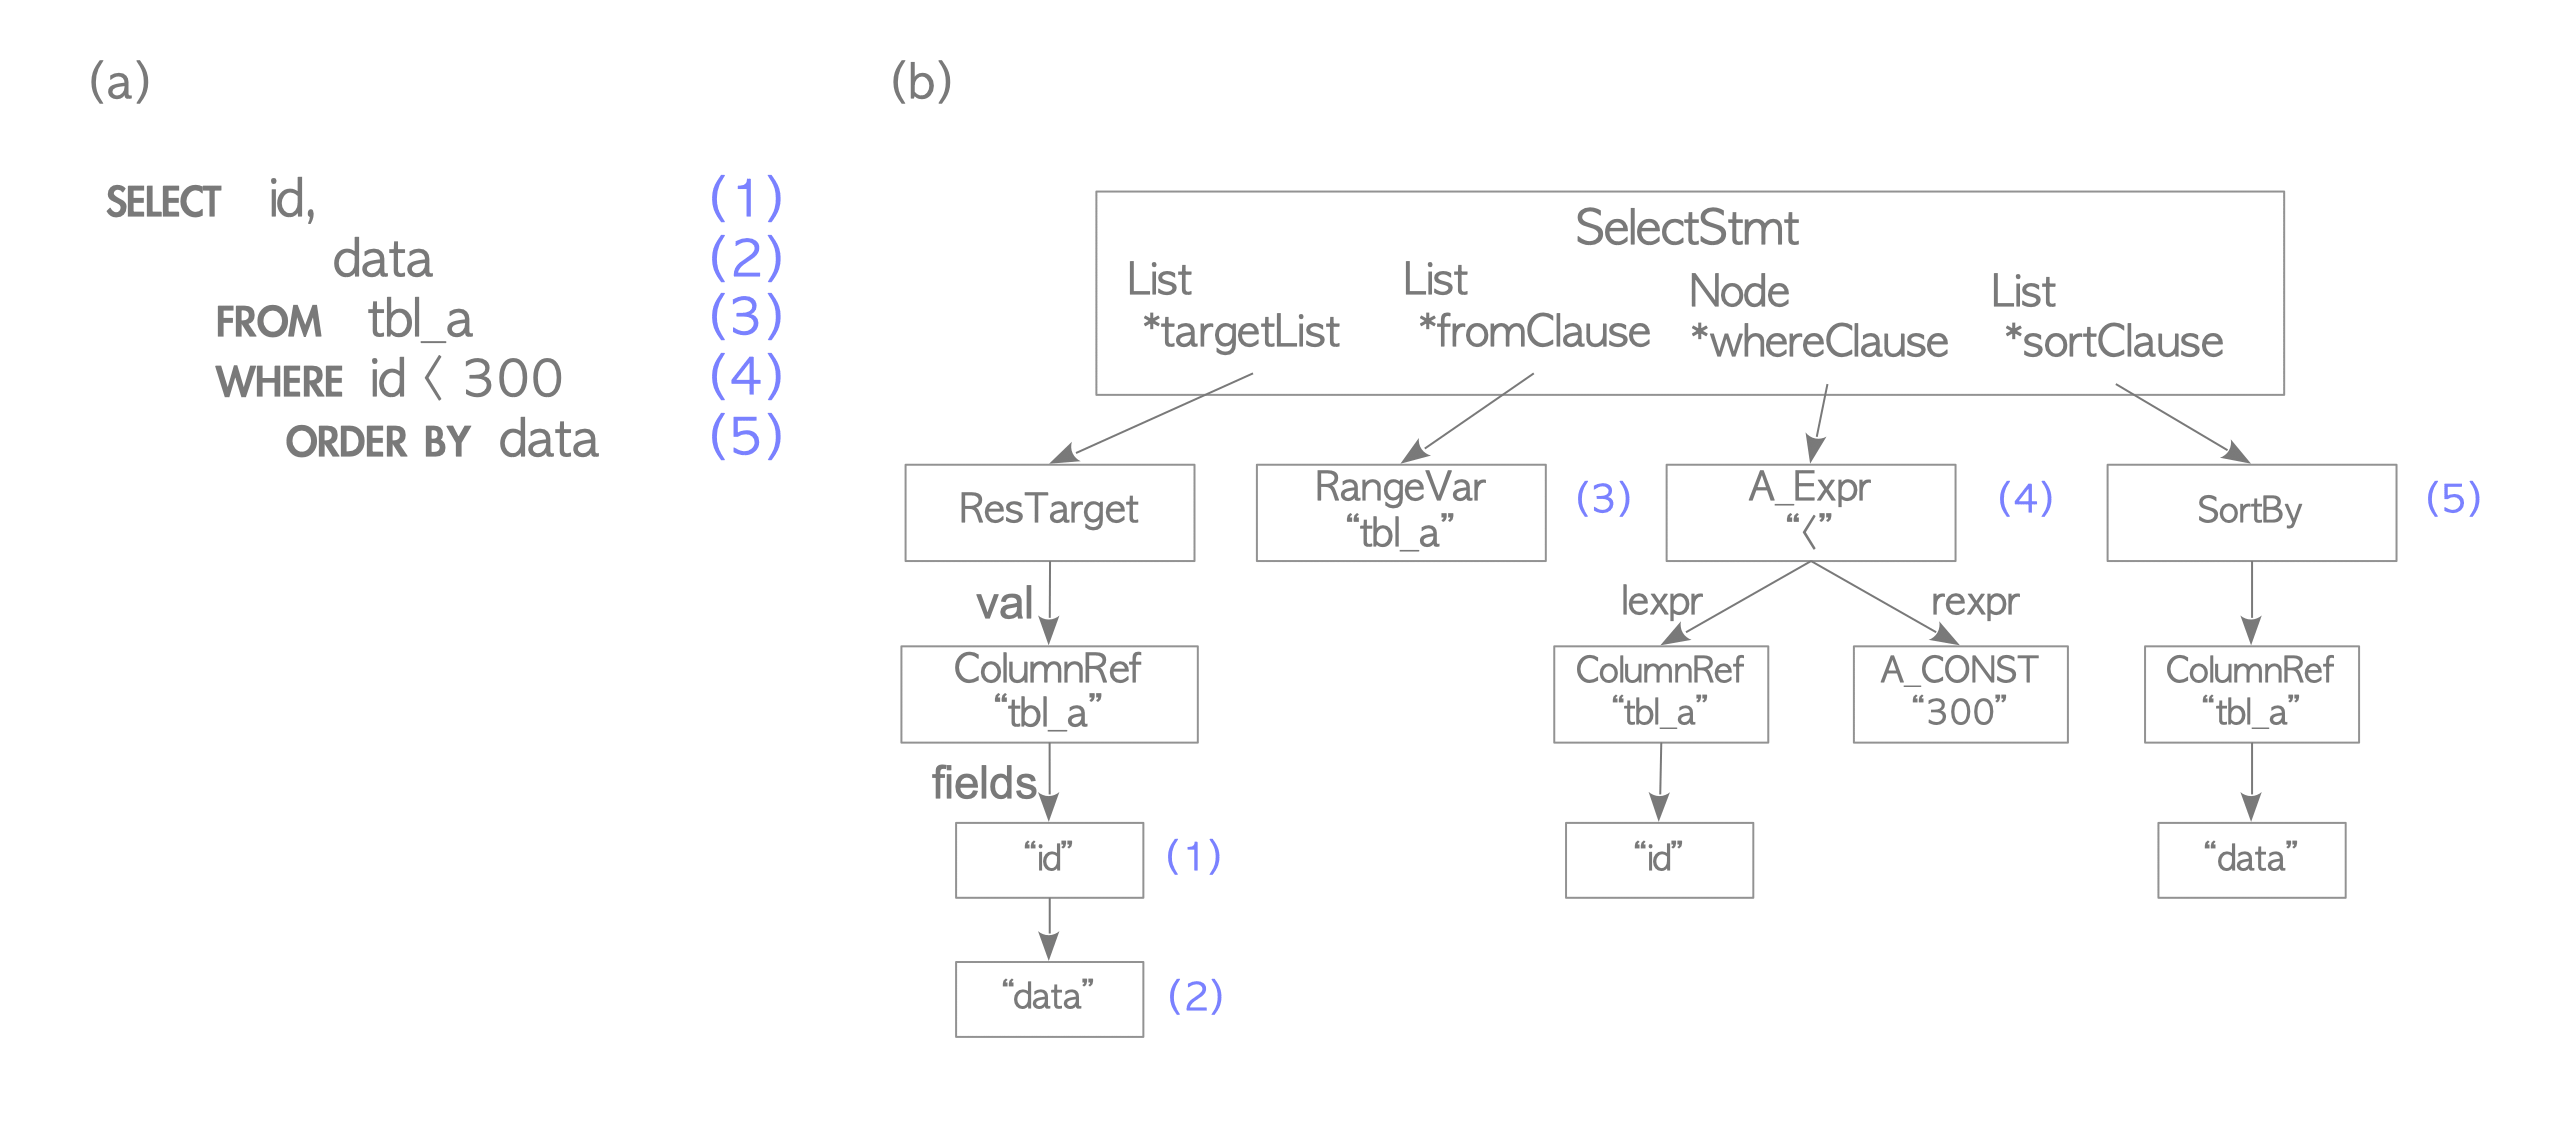
При генерации дерева разбора парсер проверяет только синтаксис входного запроса. Поэтому он возвращает ошибку только в том случае, если в запросе есть синтаксическая ошибка.
Семантику входного запроса парсер не проверяет. Например, даже если запрос содержит несуществующее имя таблицы, парсер не сможет выдать соответствующую ошибку. Семантическими проверками занимаются анализаторы.
Анализатор
Анализатор выполняет семантический анализ дерева разбора, сгенерированного парсером, и генерирует дерево запросов.
Корнем дерева запросов является структура Query, содержащая метаданные соответствующего запроса, такие как тип команды (SELECT, INSERT или другие), а также несколько листьев. Каждый лист образует список или дерево и содержит данные для каждого пункта.
Query:
/*
 * Query -
 *                   Parse analysis turns all statements into a Query tree
 *                   for further processing by the rewriter and planner.
 *
 *                   Utility statements (i.e. non-optimizable statements) have the
 *                   utilityStmt field set, and the Query itself is mostly dummy.
 *                   DECLARE CURSOR is a special case: it is represented like a SELECT,
 *                   but the original DeclareCursorStmt is stored in utilityStmt.
 *
 *                   Planning converts a Query tree into a Plan tree headed by a PlannedStmt
 *                   node --- the Query structure is not used by the executor.
 */
typedef struct Query
{
                    NodeTag                        type;

                    CmdType                      commandType;            /* select|insert|update|delete|merge|utility */

                    /* where did I come from? */
                    QuerySource querySource pg_node_attr(query_jumble_ignore);

                    /*
                    * query identifier (can be set by plugins); ignored for equal, as it
                    * might not be set; also not stored.  This is the result of the query
                    * jumble, hence ignored.
                    */
                    uint64                             queryId pg_node_attr(equal_ignore, query_jumble_ignore, read_write_ignore, read_as(0));

                    /* do I set the command result tag? */
                    bool                                 canSetTag pg_node_attr(query_jumble_ignore);

                    Node              *utilityStmt;               /* non-null if commandType == CMD_UTILITY */

                    /*
                    * rtable index of target relation for INSERT/UPDATE/DELETE/MERGE; 0 for
                    * SELECT.  This is ignored in the query jumble as unrelated to the
                    * compilation of the query ID.
                    */
                    int                                                        resultRelation pg_node_attr(query_jumble_ignore);

                    /* has aggregates in tlist or havingQual */
                    bool                                 hasAggs pg_node_attr(query_jumble_ignore);
                    /* has window functions in tlist */
                    bool                                 hasWindowFuncs pg_node_attr(query_jumble_ignore);
                    /* has set-returning functions in tlist */
                    bool                                 hasTargetSRFs pg_node_attr(query_jumble_ignore);
                    /* has subquery SubLink */
                    bool                                 hasSubLinks pg_node_attr(query_jumble_ignore);
                    /* distinctClause is from DISTINCT ON */
                    bool                                 hasDistinctOn pg_node_attr(query_jumble_ignore);
                    /* WITH RECURSIVE was specified */
                    bool                                 hasRecursive pg_node_attr(query_jumble_ignore);
                    /* has INSERT/UPDATE/DELETE in WITH */
                    bool                                 hasModifyingCTE pg_node_attr(query_jumble_ignore);
                    /* FOR [KEY] UPDATE/SHARE was specified */
                    bool                                 hasForUpdate pg_node_attr(query_jumble_ignore);
                    /* rewriter has applied some RLS policy */
                    bool                                 hasRowSecurity pg_node_attr(query_jumble_ignore);
                    /* is a RETURN statement */
                    bool                                 isReturn pg_node_attr(query_jumble_ignore);

                    List                 *cteList;                      /* WITH list (of CommonTableExpr's) */

                    List                 *rtable;                                            /* list of range table entries */

                    /*
                    * list of RTEPermissionInfo nodes for the rtable entries having
                    * perminfoindex > 0
                    */
                    List                 *rteperminfos pg_node_attr(query_jumble_ignore);
                    FromExpr   *jointree;                      /* table join tree (FROM and WHERE clauses);
                                                                                                                                                                   * also USING clause for MERGE */

                    List                 *mergeActionList;    /* list of actions for MERGE (only) */
                    /* whether to use outer join */
                    bool                                 mergeUseOuterJoin pg_node_attr(query_jumble_ignore);

                    List                 *targetList;                                     /* target list (of TargetEntry) */

                    /* OVERRIDING clause */
                    OverridingKind override pg_node_attr(query_jumble_ignore);

                    OnConflictExpr *onConflict; /* ON CONFLICT DO [NOTHING | UPDATE] */

                    List                 *returningList;           /* return-values list (of TargetEntry) */

                    List                 *groupClause;           /* a list of SortGroupClause's */
                    bool                                 groupDistinct;               /* is the group by clause distinct? */

                    List                 *groupingSets;           /* a list of GroupingSet's if present */

                    Node              *havingQual;                                 /* qualifications applied to groups */

                    List                 *windowClause;       /* a list of WindowClause's */

                    List                 *distinctClause; /* a list of SortGroupClause's */

                    List                 *sortClause;                                   /* a list of SortGroupClause's */

                    Node              *limitOffset;              /* # of result tuples to skip (int8 expr) */
                    Node              *limitCount;                                   /* # of result tuples to return (int8 expr) */
                    LimitOption limitOption;                /* limit type */

                    List                 *rowMarks;                                    /* a list of RowMarkClause's */

                    Node              *setOperations;         /* set-operation tree if this is top level of
                                                                                                                                                                   * a UNION/INTERSECT/EXCEPT query */

                    /*
                    * A list of pg_constraint OIDs that the query depends on to be
                    * semantically valid
                    */
                    List                 *constraintDeps pg_node_attr(query_jumble_ignore);

                    /* a list of WithCheckOption's (added during rewrite) */
                    List                 *withCheckOptions pg_node_attr(query_jumble_ignore);

                    /*
                    * The following two fields identify the portion of the source text string
                    * containing this query.  They are typically only populated in top-level
                    * Queries, not in sub-queries.  When not set, they might both be zero, or
                    * both be -1 meaning "unknown".
                    */
                    /* start location, or -1 if unknown */
                    int                                                        stmt_location;
                    /* length in bytes; 0 means "rest of string" */
                    int                                                        stmt_len pg_node_attr(query_jumble_ignore);
} Query;

Дерево запросов, приведенное выше, можно описать следующим образом:
- Targetlist - это список столбцов, которые являются результатом данного запроса. В данном примере список состоит из двух столбцов: 'id' и 'data'. Если во входном дереве запроса используется символ '∗∗', то анализатор заменит его на все столбцы;
- Range – это список отношений, которые используются в запросе. В данном примере список содержит информацию о таблице 'tbl_a', такую как OID таблицы и ее имя;
- Join tree хранит предложение FROM и предложения WHERE;
- Sort clause представляет собой список SortGroupClause.
Подробное описание дерева запросов дано в официальном документе.
Система правил
При необходимости система правил преобразует дерево запросов в соответствии с правилами, хранящимися в каталоге pg_rules . Система правил - достаточно интересная система, но мы даем лишь ее краткое описание, иначе данный раздел получился бы слишком большим.
Представление (VIEW)
Представления в PostgreSQL реализованы на основе системы правил. В случае, если представление задано командой CREATE VIEW, автоматически генерируется соответствующее правило, сохраняемое в каталоге.
Предположим, что представление, описанное ниже, уже задано, а соответствующее правило хранится в системном каталоге pg_rules:
sampledb=# CREATE VIEW employees_list
sampledb-#      AS SELECT e.id, e.name, d.name AS department
sampledb-#            FROM employees AS e, departments AS d WHERE e.department_id = d.id;
Когда выдается запрос, содержащий представление, показанное ниже, синтаксический анализатор создает дерево разбора, как показано на рис. 12.
sampledb=# SELECT * FROM employees_list;
На данном этапе система правил обрабатывает узел таблицы диапазонов до дерева разбора подзапроса, который является соответствующим представлением, хранящимся в pg_rules.

Поскольку PostgreSQL реализует представления с помощью такого механизма, обновлять представления было не возможно вплоть до выхода версии 9.2. Версии 9.3 сделала обновление представлений возможным; однако существует множество ограничений. Подробную информацию Вы найдете в официальном документе.
Планировщик и Исполнитель
Задача планировщика — построить наилучший план выполнения. Определённый SQL-запрос (а значит, и дерево запроса) на самом деле можно выполнить самыми разными способами, при этом получая одни и те же результаты. Если это не требует больших вычислений, оптимизатор запросов будет перебирать все возможные варианты планов, чтобы в итоге выбрать тот, который должен выполниться быстрее остальных.
Планировщик в PostgreSQL основан на оптимизации на основе затрат. Он не поддерживает оптимизацию на основе правил или подсказок. Планировщик является самой сложной подсистемой в PostgreSQL, поэтому его обзор будет предоставлен отдельно.
Примечание: pg_hint_plan
pg_hint_plan — модуль, позволяющий управлять планом выполнения с указаниями, записываемыми в комментариях особого вида. Модуль pg_hint_plan позволяет корректировать планы выполнения, применяя так называемые «указания», записываемые в виде простых описаний в SQL-комментариях особого вида. Дополнительная информация предоставлена на официальном сайте.
Выполняя любой полученный запрос, PostgreSQL разрабатывает для него план запроса. Выбор правильного плана, соответствующего структуре запроса и характеристикам данным, крайне важен для хорошей производительности, поэтому в системе работает сложный планировщик, задача которого — подобрать хороший план. Узнать, какой план был выбран для какого-либо запроса, можно с помощью команды EXPLAIN. Пример показан ниже:
testdb=# EXPLAIN SELECT * FROM tbl_a WHERE id < 300 ORDER BY data;
                          QUERY PLAN
---------------------------------------------------------------
 Sort  (cost=182.34..183.09 rows=300 width=8)
   Sort Key: data
   ->  Seq Scan on tbl_a  (cost=0.00..170.00 rows=300 width=8)
         Filter: (id < 300)
(4 rows)
В результате получается дерево планов, показанное на рис. 13.
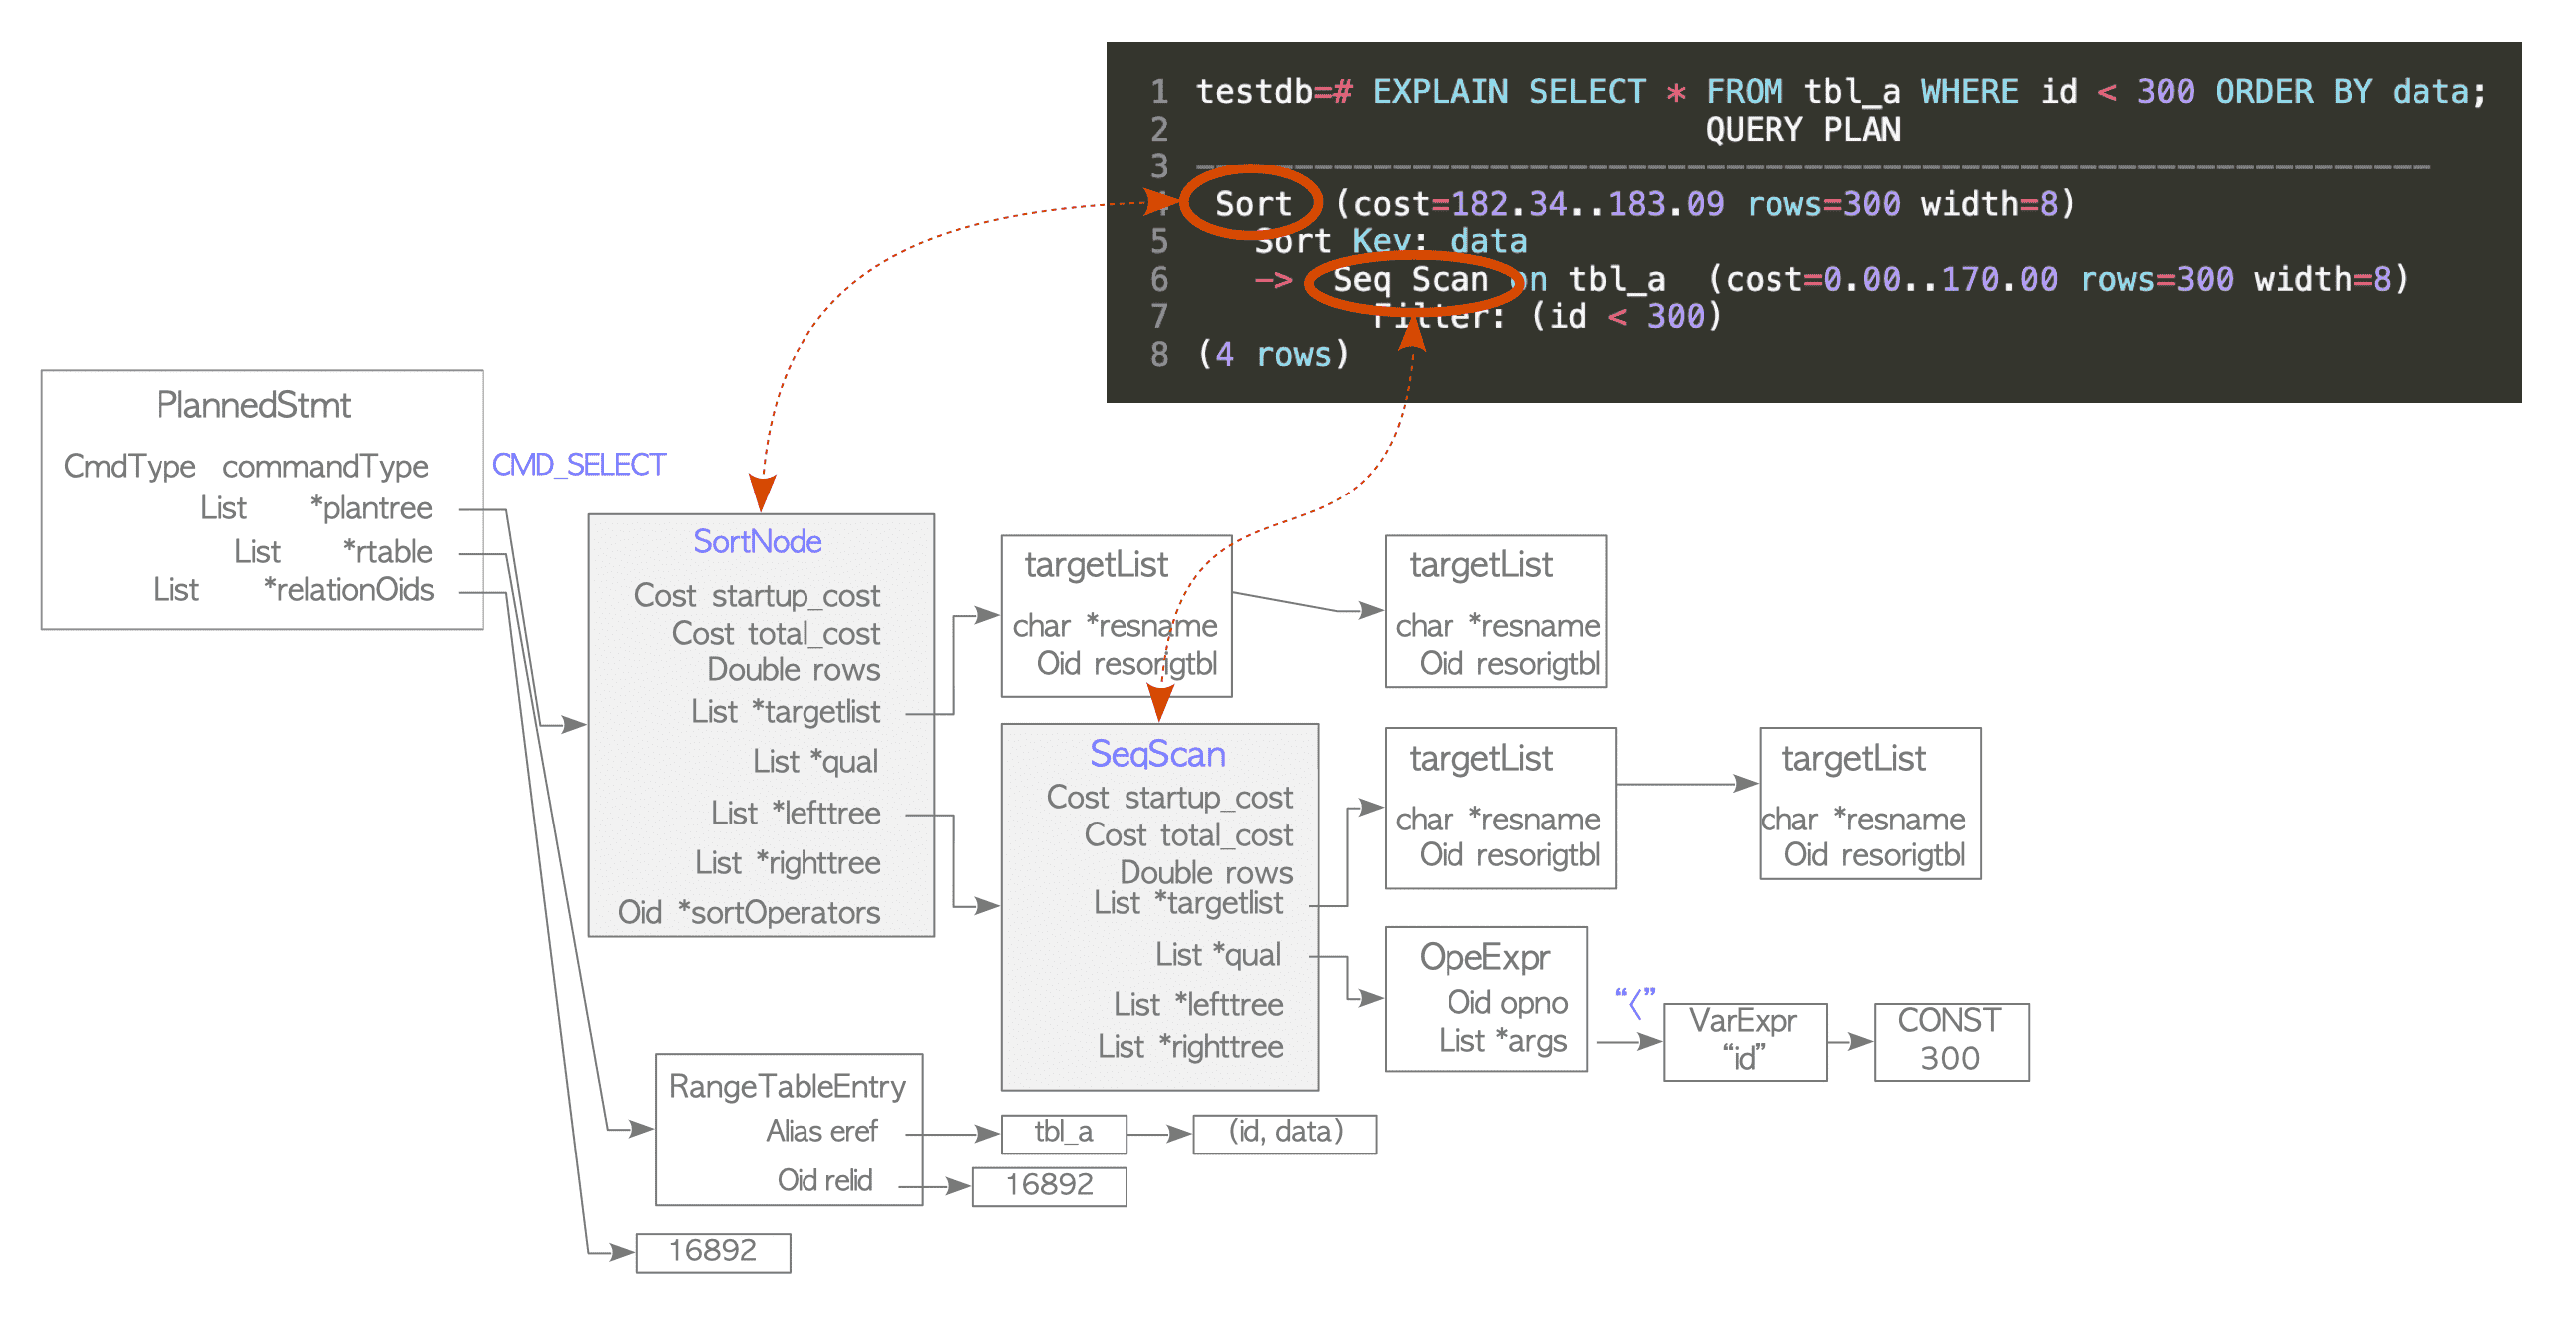
Дерево плана состоит из элементов, называемых узлами плана, и связано со списком plantree структуры PlannedStmt. Данные элементы определены в plannodes.h. Более подробная информация предоставлена в главе 3.3.3 и 3.5.4.2.
Каждый узел плана содержит информацию, необходимую исполнителю для обработки запроса. В случае однотабличного запроса исполнитель выполняет обработку от конца дерева плана к корню.
Например, дерево плана, показанное на рис. 13, представляет собой список из узла сортировки и узла последовательного сканирования. Поэтому исполнитель сканирует таблицу tbl_a последовательным сканированием, а затем сортирует полученный результат.
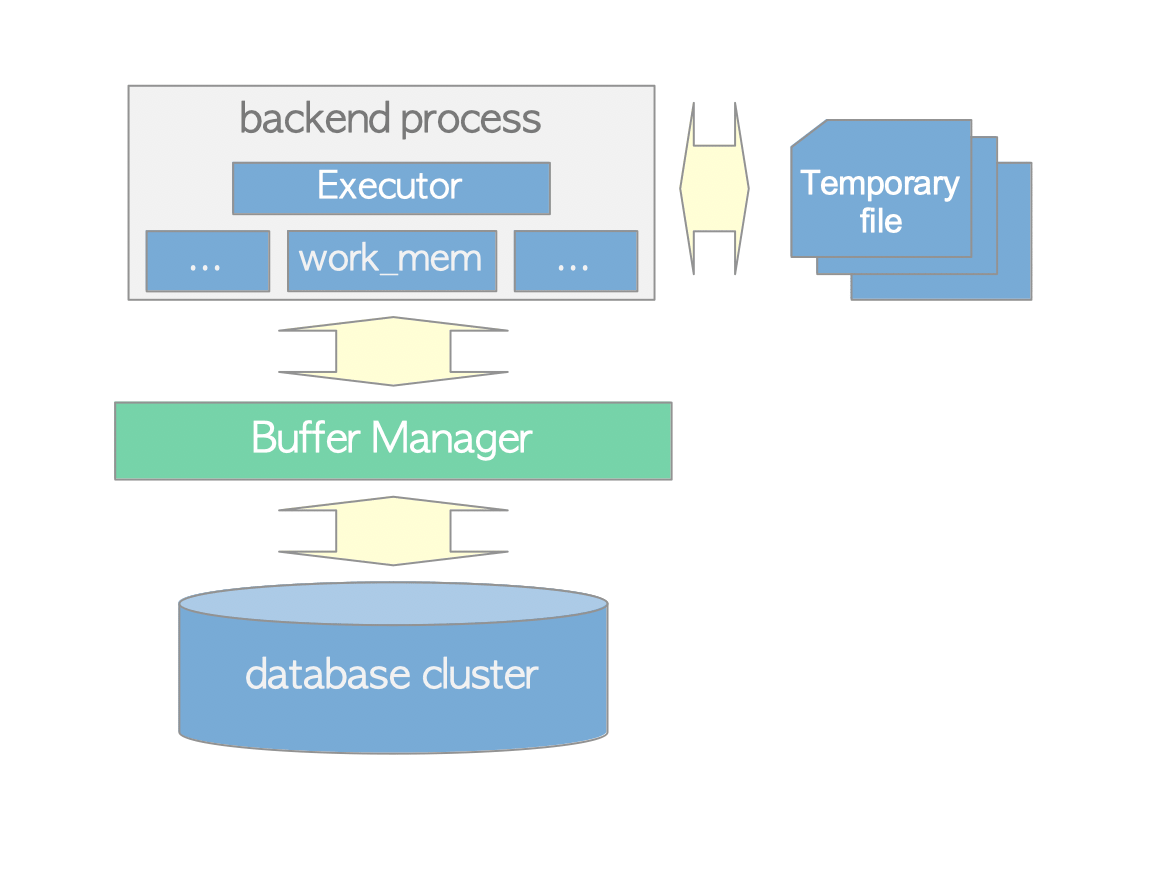
Исполнитель читает и записывает таблицы и индексы в кластере баз данных с помощью менеджера буферов, описанного в Разделе 8. При обработке запроса исполнитель использует некоторые области памяти, такие как temp_buffers и work_mem, выделенные заранее, и при необходимости создает временные файлы.
Кроме того, при обращении к кортежам PostgreSQL использует механизм управления параллелизмом для поддержания согласованности и изоляции выполняемых транзакций. Механизм управления параллелизмом описан в главе 5.