

Оценка стоимости при работе с однотабличным запросом PostgreSQL
Оптимизация запросов в PostgreSQL основана на стоимости выполнения. Затраты - это безразмерные величины, являющиеся показателями для сравнения относительной производительности операций.
Затраты оцениваются функциями, определенными в файле costize.c. Все операции, выполняемые исполнителем, имеют соответствующие функции затрат. Например, затраты на последовательное сканирование и сканирование индекса оцениваются функциями cost_seqscan() и cost_index(), соответственно.
В PostgreSQL есть три вида затрат: начальные (startup), текущие (run) и общие (total). Общая стоимость - это сумма начальных и текущих затрат.
- Начальная стоимость (start-up) - это затраты, понесенные до получения первого кортежа;
- Стоимость выполнения (run) - это стоимость получения всех кортежей;
- Общая стоимость представляет собой сумму начальных затрат и затрат на выполнение.
Команда EXPLAIN отражает начальные и общие затраты по каждой операции. Пример:
testdb=# EXPLAIN SELECT * FROM tbl;
                       QUERY PLAN
---------------------------------------------------------
Seq Scan on tbl  (cost=0.00..145.00 rows=10000 width=8)
(1 row)
В строке 4 команда отображает информацию о последовательном сканировании. В разделе затрат Вы найдете два значения: 0,00 и 145,00. В данном случае начальные и общие затраты составляют 0,00 и 145,00 соответственно.
В этом разделе мы подробно рассмотрим процесс оценки последовательного сканирования, индексного сканирования и операции сортировки.
Далее мы будем использовать таблицу и индекс, которые показаны ниже:
testdb=# CREATE TABLE tbl (id int PRIMARY KEY, data int);
testdb=# CREATE INDEX tbl_data_idx ON tbl (data);
testdb=# INSERT INTO tbl SELECT generate_series(1,10000),generate_series(1,10000);
testdb=# ANALYZE;
testdb=# \d tbl
      Table "public.tbl"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer | not null
 data   | integer |
Indexes:
    "tbl_pkey" PRIMARY KEY, btree (id)
    "tbl_data_idx" btree (data)
Последовательное сканирование
Стоимость последовательного сканирования оценивается функцией cost_seqscan(). В этом подразделе мы рассмотрим, как оценить стоимость последовательного сканирования для следующего запроса:
testdb=# SELECT * FROM tbl WHERE id < 8000;
При последовательном сканировании начальная стоимость равна 0, а стоимость выполнения определяется следующим уравнением:
'run cost'='cpu run cost'+'disk run cost'
             =(cpu_tuple_cost+cpu_operator_cost)×Ntuple+seq_page_cost×Npage
где seq_page_cost, cpu_tuple_cost и cpu_operator_cost задаются в файле postgresql.conf, а значения по умолчанию составляют 1.0, 0.01 и 0.0025 соответственно. Ntuple и Npage - это номера всех кортежей и всех страниц данной таблицы соответственно. Эти значения можно получить с помощью следующего запроса:
testdb=# SELECT relpages, reltuples FROM pg_class WHERE relname = 'tbl';
 relpages | reltuples
----------+-----------
       45 |     10000
(1 row)
Ntuple = 10000 (1) Npage = 45 (2)
Таким образом,
'run cost'=(0.01+0.0025)×10000+1.0×45=170.0
И наконец,
'total cost'=0.0+170.0=170'total cost'=0.0+170.0=170
В качестве подтверждения ниже приведен результат выполнения команды EXPLAIN для вышеуказанного запроса:
testdb=# EXPLAIN SELECT * FROM tbl WHERE id < 8000;
                       QUERY PLAN
--------------------------------------------------------
 Seq Scan on tbl  (cost=0.00..170.00 rows=8000 width=8)
   Filter: (id < 8000)
(2 rows)
В строке 4 мы видим, что начальные и общие затраты составляют 0,00 и 170,00 соответственно. Также предполагается, что при сканировании всех строк будет отобрано 8000 строк (кортежей).
В строке 5 показан фильтр 'Filter:(id<8000)' последовательного сканирования.
Обратите внимание, что этот тип фильтра используется при чтении всех кортежей в таблице и не сужает диапазон сканирования страниц таблицы.
Примечание:
PostgreSQL предполагает, что все страницы будут прочитаны из хранилища. Другими словами, PostgreSQL не учитывает, находится ли сканируемая страница в общих буферах или нет.
Индексное сканирование
Несмотря на то, что PostgreSQL поддерживает некоторые методы индексов, такие как B-дерево, GiST, GIN и BRIN, стоимость индексного сканирования оценивается с помощью функции cost_index().
В этом подразделе мы рассмотрим, как оценить стоимость индексного сканирования для следующего запроса:
testdb=# SELECT id, data FROM tbl WHERE data < 240;
Перед оценкой стоимости необходимо определить количество индексных страниц и индексных кортежей Nindex,page и Nindex,tuples:
testdb=# SELECT relpages, reltuples FROM pg_class WHERE relname = 'tbl_data_idx';
 relpages | reltuples
----------+-----------
       30 |     10000
(1 row)
Nindex,tuple= 10000 (3) Nindex, page = 30 (4)
Начальная стоимость
Начальная стоимость индексного сканирования - это стоимость чтения страниц индекса для доступа к первому кортежу в целевой таблице. Она определяется следующим уравнением:
'start-up cost'={ceil(log2(Nindex,tuple))+(Hindex+1)×50}×cpu_operator_cost
где Нindex – высота индексного дерева.
В нашем случае случае Nindex,tuple = 10000, Hindex = 1; cpu_operator_costcpu_operator_cost = 0,00250,0025 (по умолчанию).
Таким образом,
'start-up cost'={ceil(log2(10000))+(1+1)×50}×0.0025=0.285 (5)Стоимость выполнения
Стоимость выполнения индексного сканирования складывается из стоимости процессора и стоимости операций ввода-вывода (input/output):
'run cost'=('index cpu cost'+'table cpu cost')+('index IO cost'+'table IO cost').
Примечание: В случае, если может быть применен Index-Only Scan, описанный в разделе 7.2, 'table cpu cost' 'table cpu cost' и 'table IO cost' 'table IO cost' не оцениваются.
Первые три стоимости (index CPU cost, table CPU cost, и index I/O cost) представлены ниже:
'index cpu cost'=Selectivity×Nindex,tuple×(cpu_index_tuple_cost+qual_op_cost)
'table cpu cost'=Selectivity×Ntuple×cpu_tuple_cost
'index IO cost'=ceil(Selectivity×Nindex,page)×random_page_cost
где:
- cpu_index_tuple_cost и random_page_cost определены в файле postgresql.conf. Значения по умолчанию - 0.005 и 4.0 соответственно.
- qual_op_cost - это, грубо говоря, стоимость оценки индексного предиката. Значение по умолчанию - 0,0025.
-
Селективность - это доля диапазона поиска индекса, удовлетворяющая условию WHERE, значение которой может быть от 0 до 1.
(Selectivity×Ntuple) означает количество кортежей таблицы, которые необходимо прочитать;
(Selectivity×Nindex,page) означает количество страниц индекса, которое необходимо прочитать.
Примечание: Селективность
Селективность предикатов запроса оценивается либо с помощью histogram_bounds, либо с помощью MCV (Most Common Value), которые хранятся в pg_stats.
Более подробная информация содержится в официальном документе.
MCV каждого столбца таблицы хранится в представлении pg_stats в виде пары столбцов с именами 'most_common_vals' и 'most_common_freqs':
- ‘most_common_vals’ - список наиболее распространенных комбинаций значений в столбцах.
- ‘most_common_freqs’ Список частот наиболее распространенных комбинаций, то есть количество вхождений каждой комбинации, деленное на общее количество строк.
Приведем простой пример:
Таблица “Countries” содержит два столбца:
- Столбец ‘country’ содержит названия стран;
- Столбец ‘continent’ содержит названия континентов, на которых располагается та или иная страна.
Countries:
C --
-- PostgreSQL database dump
--

-- Dumped from database version 9.6.0
-- Dumped by pg_dump version 9.6.0

SET statement_timeout = 0;
SET lock_timeout = 0;
SET idle_in_transaction_session_timeout = 0;
SET client_encoding = 'UTF8';
SET standard_conforming_strings = on;
SET check_function_bodies = false;
SET client_min_messages = warning;
SET row_security = off;

SET search_path = public, pg_catalog;

SET default_tablespace = '';

SET default_with_oids = false;

--
-- Name: countries; Type: TABLE; Schema: public; Owner: postgres
--

CREATE TABLE countries (
    continent text,
    country text
);


ALTER TABLE countries OWNER TO postgres;

--
-- Data for Name: countries; Type: TABLE DATA; Schema: public; Owner: postgres
--

COPY countries (continent, country) FROM stdin;
Africa         Algeria
Africa         Angola
Africa         Benin
Africa         Botswana
Africa         Burkina
Africa         Burundi
Africa         Cameroon
Africa         Cape Verde
Africa         Central African Republic
Africa         Chad
Africa         Comoros
Africa         Congo
Africa         Djibouti
Africa         Egypt
Africa         Equatorial Guinea
Africa         Eritrea
Africa         Ethiopia
Africa         Gabon
Africa         Gambia
Africa         Ghana
Africa         Guinea
Africa         Guinea-Bissau
Africa         Ivory Coast
Africa         Kenya
Africa         Lesotho
Africa         Liberia
Africa         Libya
Africa         Madagascar
Africa         Malawi
Africa         Mali
Africa         Mauritania
Africa         Mauritius
Africa         Morocco
Africa         Mozambique
Africa         Namibia
Africa         Niger
Africa         Nigeria
Africa         Rwanda
Africa         Sao Tome and Principe
Africa         Senegal
Africa         Seychelles
Africa         Sierra Leone
Africa         Somalia
Africa         South Africa
Africa         South Sudan
Africa         Sudan
Africa         Swaziland
Africa         Tanzania
Africa         Togo
Africa         Tunisia
Africa         Uganda
Africa         Zambia
Africa         Zimbabwe
Asia            Afghanistan
Asia            Bahrain
Asia            Bangladesh
Asia            Bhutan
Asia            Brunei
Asia            Burma (Myanmar)
Asia            Cambodia
Asia            China
Asia            East Timor
Asia            India
Asia            Indonesia
Asia            Iran
Asia            Iraq
Asia            Israel
Asia            Japan
Asia            Jordan
Asia            Kazakhstan
Asia            North Korea
Asia            South Korea
Asia            Kuwait
Asia            Kyrgyzstan
Asia            Laos
Asia            Lebanon
Asia            Malaysia
Asia            Maldives
Asia            Mongolia
Asia            Nepal
Asia            Oman
Asia            Pakistan
Asia            Philippines
Asia            Qatar
Asia            Russian Federation
Asia            Saudi Arabia
Asia            Singapore
Asia            Sri Lanka
Asia            Syria
Asia            Tajikistan
Asia            Thailand
Asia            Turkey
Asia            Turkmenistan
Asia            United Arab Emirates
Asia            Uzbekistan
Asia            Vietnam
Asia            Yemen
Europe       Albania
Europe       Andorra
Europe       Armenia
Europe       Austria
Europe       Azerbaijan
Europe       Belarus
Europe       Belgium
Europe       Bosnia and Herzegovina
Europe       Bulgaria
Europe       Croatia
Europe       Cyprus
Europe       Czech Republic
Europe       Denmark
Europe       Estonia
Europe       Finland
Europe       France
Europe       Georgia
Europe       Germany
Europe       Greece
Europe       Hungary
Europe       Iceland
Europe       Ireland
Europe       Italy
Europe       Latvia
Europe       Liechtenstein
Europe       Lithuania
Europe       Luxembourg
Europe       Macedonia
Europe       Malta
Europe       Moldova
Europe       Monaco
Europe       Montenegro
Europe       Netherlands
Europe       Norway
Europe       Poland
Europe       Portugal
Europe       Romania
Europe       San Marino
Europe       Serbia
Europe       Slovakia
Europe       Slovenia
Europe       Spain
Europe       Sweden
Europe       Switzerland
Europe       Ukraine
Europe       United Kingdom
Europe       Vatican City
North America              Antigua and Barbuda
North America              Bahamas
North America              Barbados
North America              Belize
North America              Canada
North America              Costa Rica
North America              Cuba
North America              Dominica
North America              Dominican Republic
North America              El Salvador
North America              Grenada
North America              Guatemala
North America              Haiti
North America              Honduras
North America              Jamaica
North America              Mexico
North America              Nicaragua
North America              Panama
North America              Saint Kitts and Nevis
North America              Saint Lucia
North America              Saint Vincent and the Grenadines
North America              Trinidad and Tobago
North America              United States
Oceania     Australia
Oceania     Fiji
Oceania     Kiribati
Oceania     Marshall Islands
Oceania     Micronesia
Oceania     Nauru
Oceania     New Zealand
Oceania     Palau
Oceania     Papua New Guinea
Oceania     Samoa
Oceania     Solomon Islands
Oceania     Tonga
Oceania     Tuvalu
Oceania     Vanuatu
South America              Argentina
South America              Bolivia
South America              Brazil
South America              Chile
South America              Colombia
South America              Ecuador
South America              Guyana
South America              Paraguay
South America              Peru
South America              Suriname
South America              Uruguay
South America              Venezuela
\.

--
-- Name: idx_continent; Type: INDEX; Schema: public; Owner: postgres
--

CREATE INDEX idx_continent ON countries USING btree (continent);

--
-- PostgreSQL database dump complete
--
testdb=# \d countries
   Table "public.countries"
  Column   | Type | Modifiers
-----------+------+-----------
 country   | text |
 continent | text |
Indexes:
    "continent_idx" btree (continent)

testdb=# SELECT continent, count(*) AS "number of countries",
testdb-#     (count(*)/(SELECT count(*) FROM countries)::real) AS "number of countries / all countries"
testdb-#       FROM countries GROUP BY continent ORDER BY "number of countries" DESC;
   continent   | number of countries | number of countries / all countries
---------------+---------------------+-------------------------------------
 Africa        |                  53 |                   0.274611398963731
 Europe        |                  47 |                   0.243523316062176
 Asia          |                  44 |                   0.227979274611399
 North America |                  23 |                   0.119170984455959
 Oceania       |                  14 |                  0.0725388601036269
 South America |                  12 |                  0.0621761658031088
(6 rows)
Рассмотрим следующий запрос, в котором есть предложение WHERE, 'continent = 'Asia'':
testdb=# SELECT * FROM countries WHERE continent = 'Asia';
В этом случае планировщик оценивает стоимость сканирования индекса, используя MCV столбца 'continent'. Ниже показаны значения 'most_common_vals' и 'most_common_freqs' этого столбца:
testdb=# \x
Expanded display is on.
testdb=# SELECT most_common_vals, most_common_freqs FROM pg_stats
testdb-#                  WHERE tablename = 'countries' AND attname='continent';
-[ RECORD 1 ]-----+-------------------------------------------------------------
most_common_vals  | {Africa,Europe,Asia,"North America",Oceania,"South America"}
most_common_freqs | {0.274611,0.243523,0.227979,0.119171,0.0725389,0.0621762}
Значение most_common_freqs, соответствующее 'Asia' из most_common_vals, равно 0,227979. Таким образом, 0,227979 используется в качестве селективности.
Если MCV не может быть использован (например, тип целевого столбца - целое число), то для оценки стоимости используется значение histogram_bounds целевого столбца.
- histogram_bounds - это список значений, которые делят значения столбца на примерно одинаковые группы.
Ниже приводим конкретный пример. Это значение histogram_bounds столбца 'data' в таблице 'tbl':
testdb=# SELECT histogram_bounds FROM pg_stats WHERE tablename = 'tbl' AND attname = 'data';
              histogram_bounds
---------------------------------------------------------------------------------------------------
 {1,100,200,300,400,500,600,700,800,900,1000,1100,1200,1300,1400,1500,1600,1700,1800,1900,2000,2100,
2200,2300,2400,2500,2600,2700,2800,2900,3000,3100,3200,3300,3400,3500,3600,3700,3800,3900,4000,4100,
4200,4300,4400,4500,4600,4700,4800,4900,5000,5100,5200,5300,5400,5500,5600,5700,5800,5900,6000,6100,
6200,6300,6400,6500,6600,6700,6800,6900,7000,7100,7200,7300,7400,7500,7600,7700,7800,7900,8000,8100,
8200,8300,8400,8500,8600,8700,8800,8900,9000,9100,9200,9300,9400,9500,9600,9700,9800,9900,10000}
(1 row)
По умолчанию histogram_bounds разделен на 100 сегментов. На рисунке ниже представлены сегменты и соответствующие им границы гистограммы. Сегменты нумеруются, начиная с 0, в каждом сегменте хранится (примерно) одинаковое количество кортежей. Значения histogram_bounds - это границы соответствующих сегментов. Например, 0-е значение границ гистограммы равно 1, что означает, что это минимальное значение кортежей, хранящихся в сегменте 0. 1-е значение равно 100, это минимальное значение кортежей, хранящихся в сегменте 1, и так далее.
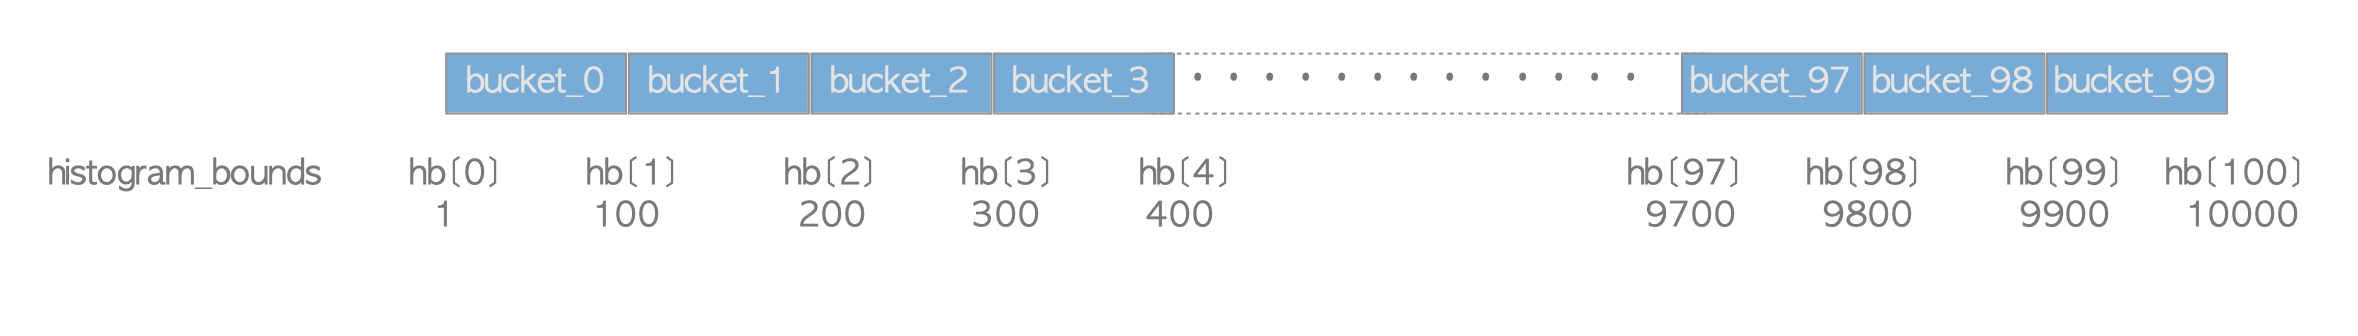
Далее будет показан расчет селективности. В запросе есть предложение WHERE 'data<240data<240', значение 240 находится во втором сегменте. В этом случае селективность может быть получена путем применения линейной интерполяции. Таким образом, селективность столбца 'data' в данном запросе можно вычислить с помощью следующего уравнения:
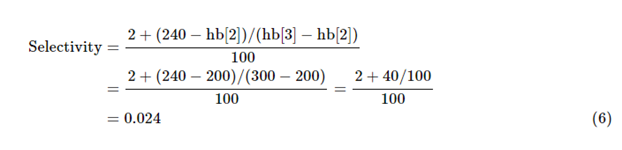
Таким образом,
'index cpu cost'=0.024×10000×(0.005+0.0025)=1.8                    (7)
'table cpu cost'=0.024×10000×0.01=2.4                  (8)
'index IO cost'=ceil(0.024×30)×4.0=4.0                    (9)
’table IO cost’ определяется следующим уравнением:
'table IO cost'=max_IO_cost+indexCorrelation2×(min_IO_cost−max_IO_cost)
max_IO_cost - это наихудший случай стоимости ввода-вывода, то есть стоимость случайного сканирования всех страниц таблицы; эта стоимость определяется следующим уравнением:
max_IO_cost=Npage×random_page_cost
В нашем случае Npage=45, таким образом,
max_IO_cost=45×4.0=180.0(10)
min_IO_cost - это наилучший вариант стоимости ввода-вывода, то есть стоимости последовательного сканирования выбранных страниц таблицы; эта стоимость определяется следующим уравнением:
min_IO_cost=1×random_page_cost+(ceil(Selectivity×Npage)−1)×seq_page_cost
В нашем случае,
min_IO_cost=1×4.0+(ceil(0.024×45))−1)×1.0=5.0(11)
Подробное описание indexCorrelation дано ниже, в нашем случае,
indexCorrelation=1.0 (12)
Итого, согласно (10),(11), (12):
'table IO cost'=180.0+1.02×(5.0−180.0)=5.0 (13)
И. согласно (7), (8),(9) и (13)
'run cost'=(1.8+2.4)+(4.0+5.0)=13.2 (14)
Примечание: indexCorrelation
В indexCorrelation записывается корреляция (в диапазоне от -1.0 до 1.0) между порядком записей в индексе и в таблице. Это значение будет корректировать оценку стоимости выборки строк из основной таблицы.
Приведем пример:
Таблица 'tbl_corr' содержит пять столбцов: два столбца текстового типа и три столбца целочисленного типа. Три целочисленных столбца хранят числа от 1 до 12. Физически tbl_corr состоит из трех страниц, и каждая страница содержит четыре кортежа. Каждый столбец целочисленного типа имеет индекс с именем, например index_col_asc и так далее.
testdb=# \d tbl_corr
    Table "public.tbl_corr"
  Column  |  Type   | Modifiers
----------+---------+-----------
 col      | text    |
 col_asc  | integer |
 col_desc | integer |
 col_rand | integer |
 data     | text    |
Indexes:
    "tbl_corr_asc_idx" btree (col_asc)
    "tbl_corr_desc_idx" btree (col_desc)
    "tbl_corr_rand_idx" btree (col_rand)
testdb=# SELECT col,col_asc,col_desc,col_rand
testdb-#                         FROM tbl_corr;
   col    | col_asc | col_desc | col_rand
----------+---------+----------+----------
 Tuple_1  |       1 |       12 |        3
 Tuple_2  |       2 |       11 |        8
 Tuple_3  |       3 |       10 |        5
 Tuple_4  |       4 |        9 |        9
 Tuple_5  |       5 |        8 |        7
 Tuple_6  |       6 |        7 |        2
 Tuple_7  |       7 |        6 |       10
 Tuple_8  |       8 |        5 |       11
 Tuple_9  |       9 |        4 |        4
 Tuple_10 |      10 |        3 |        1
 Tuple_11 |      11 |        2 |       12
 Tuple_12 |      12 |        1 |        6
(12 rows)
indexCorrelation этих столбцов указан ниже:
testdb=# SELECT tablename,attname, correlation FROM pg_stats WHERE tablename = 'tbl_corr';
 tablename | attname  | correlation
-----------+----------+-------------
 tbl_corr  | col_asc  |           1
 tbl_corr  | col_desc |          -1
 tbl_corr  | col_rand |    0.125874
(3 rows)
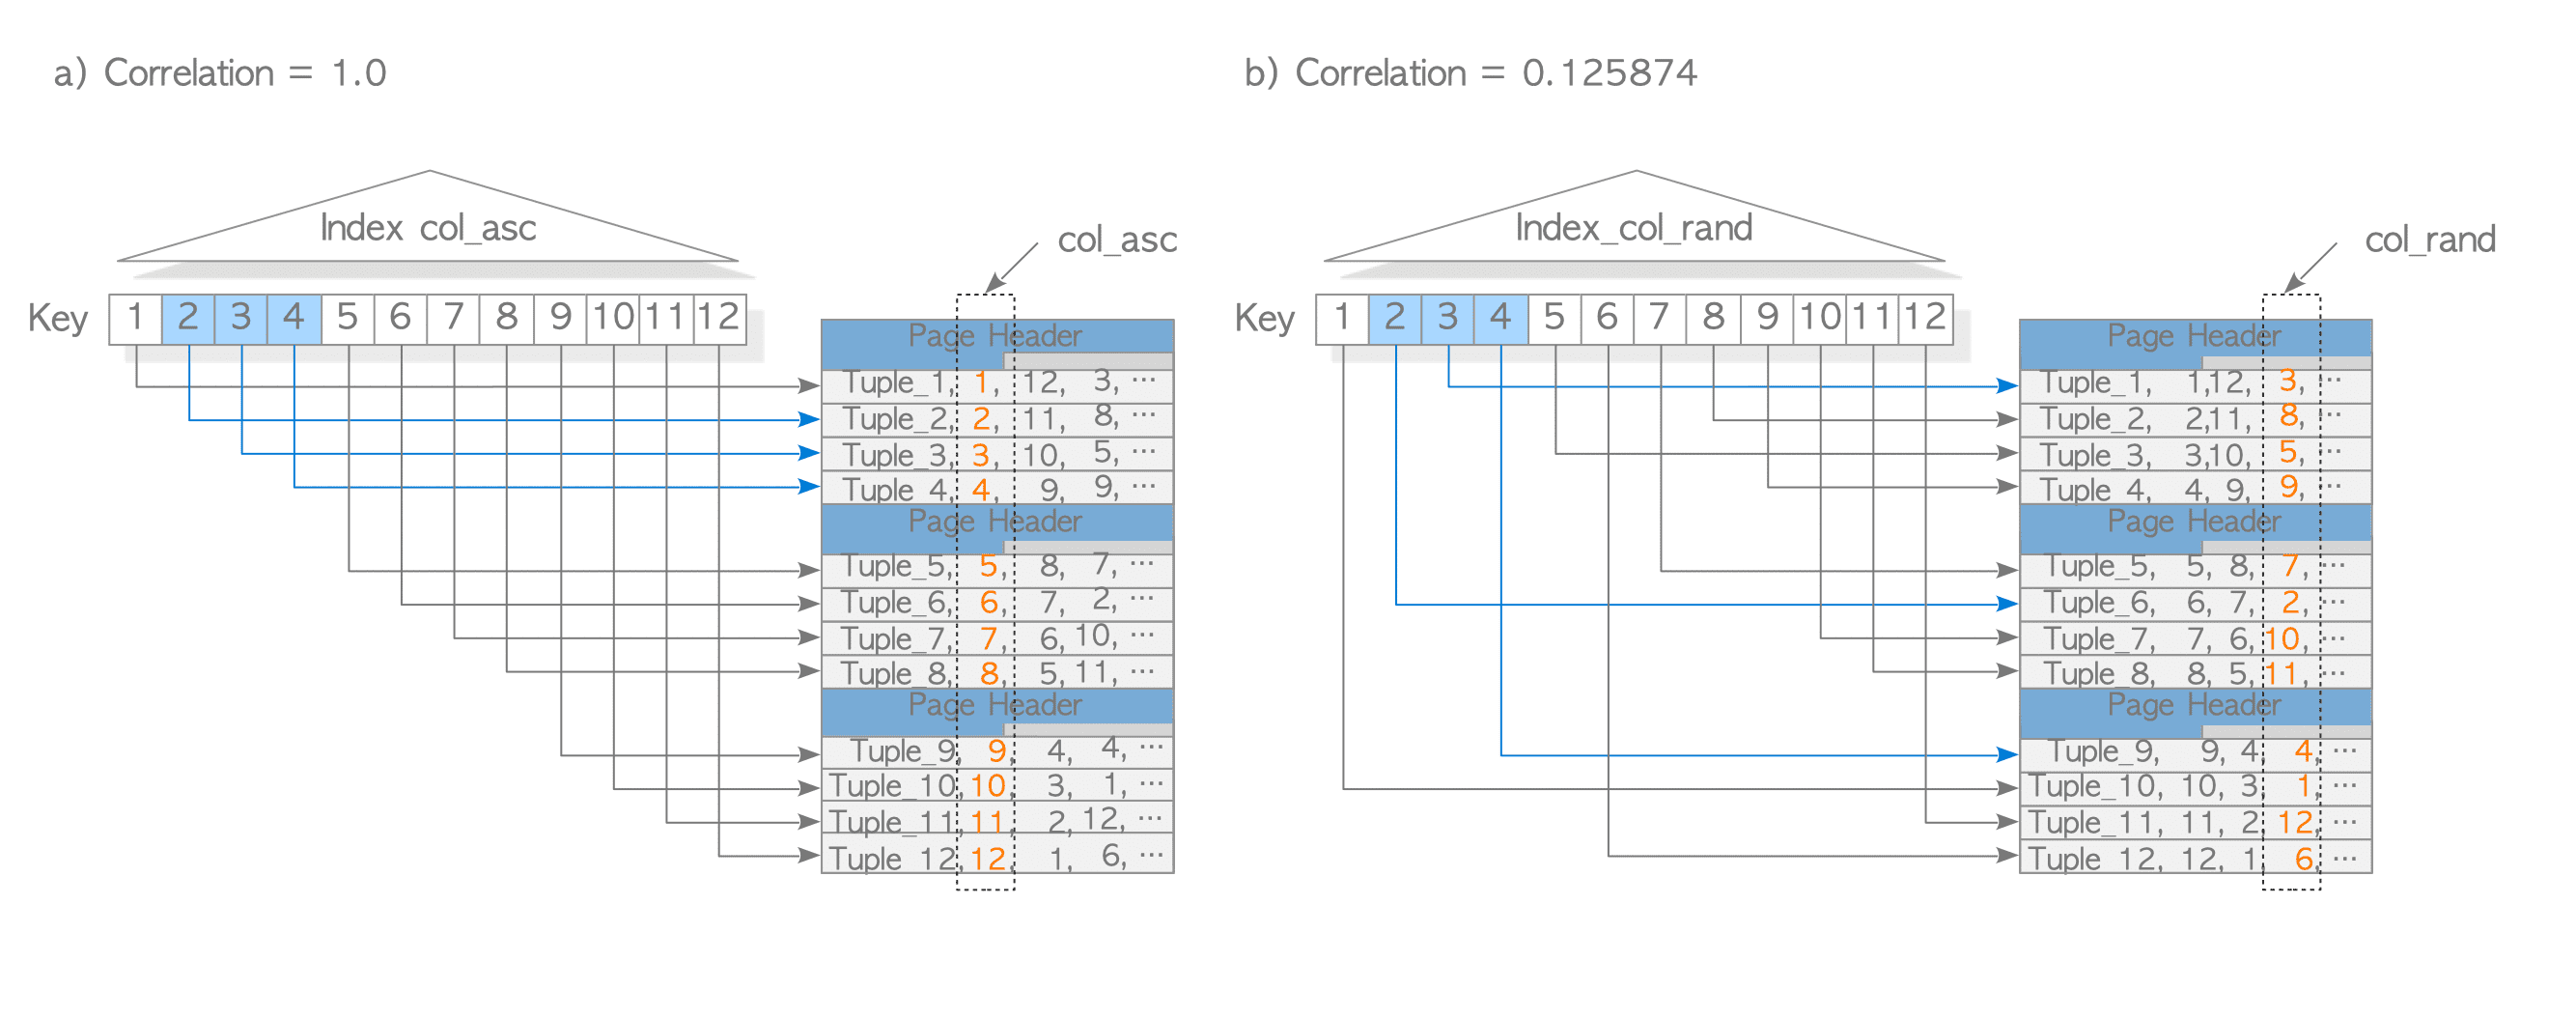
При выполнении следующего запроса PostgreSQL считывает только первую страницу, поскольку все целевые кортежи хранятся на первой странице. Смотрите рисунок 16 (а).
testdb=# SELECT * FROM tbl_corr WHERE col_asc BETWEEN 2 AND 4;
С другой стороны, когда выполняется следующий запрос, PostgreSQL приходится читать все страницы. Смотрите рисунок 16 (b).
testdb=# SELECT * FROM tbl_corr WHERE col_rand BETWEEN 2 AND 4;
Таким образом, indexCorrelation - это статистическая зависимость, которая отражает влияние случайного доступа, вызванного несоответствием между порядком индекса и физическим порядком кортежей в таблице, при оценке стоимости сканирования индекса.
Общая стоимость
Согласно (3) и (14),
'total cost'=0.285+13.2=13.485 (15)
В качестве подтверждения вышесказанного приводим результат выполнения команды EXPLAIN запроса SELECT:
testdb=# EXPLAIN SELECT id, data FROM tbl WHERE data < 240;
                                QUERY PLAN
---------------------------------------------------------------------------
 Index Scan using tbl_data_idx on tbl  (cost=0.29..13.49 rows=240 width=8)
   Index Cond: (data < 240)
(2 rows)
В строке 4 мы видим, что начальные и общие затраты составляют 0,29 и 13,49, соответственно, предполагается, что будет отсканировано 240 строк (кортежей).
В строке 5 указан indexCond:(data<240)IndexCond:(data<240)' индексного сканирования. Если быть более точным, это условие называется предикатом доступа, и оно выражает условия начала и остановки сканирования индекса.
Условие индекса (index condition)
Согласно данной публикации команда EXPLAIN в PostgreSQL не делает различий между предикатом доступа и предикатом индексного фильтра. Поэтому, анализируя вывод EXPLAIN, обращайте внимание не только на условия индекса, но и на оценочное значение строк.
Примечание: seq_page_cost и random_page_cost
Значения seq_page_cost и random_page_cost по умолчанию - 1.0 и 4.0 соответственно.
Это означает, что по оценке PostgeSQL случайное сканирование в четыре раза медленнее, чем последовательное. Другими словами, значение по умолчанию в PostgreSQL основано на использовании жестких дисков.
С другой стороны, в последнее время значение по умолчанию random_page_cost слишком велико, поскольку в основном используются SSD. Если использовать значение random_page_cost по умолчанию, несмотря на использование SSD, планировщик может выбрать неэффективные планы. Поэтому при использовании SSD лучше изменить значение random_page_cost на 1.0.
Данная статья описывает проблему использования значения random_page_cost, установленного по умолчанию.
Сортировка
PostgreSQL предоставляет возможность проводить операции сортировки, такие как ORDER BY, предварительную обработку операций объединения, а также другие операции. Стоимость сортировки оценивается с помощью функции cost_sort().
Если все кортежи, подлежащие сортировке, могут быть сохранены в work_mem, используется алгоритм quicksort. В противном случае создается временный файл и используется алгоритм сортировки слиянием.
Начальная стоимость сортировки - это стоимость сортировки целевых кортежей. Таким образом, стоимость определяется следующим образом: О(Nsort×log2(Nsort)), где Nsort - это количество кортежей, подлежащих сортировке. Стоимость выполнения сортировки – это стоимость чтения отсортированных кортежей. Таким образом, стоимость определяется так: O(Nsort).
В этом подразделе мы рассмотрим алгоритм оценки стоимости сортировки запроса, сформулированного ниже. Предположим, что этот запрос будет отсортирован в work_mem, без использования временных файлов.
testdb=# SELECT id, data FROM tbl WHERE data < 240 ORDER BY id;
В данном случае начальная стоимость будет определяться следующим образом:
'start-up cost'=C+comparison_cost×Nsort×log2(Nsort)
где:
- C - общая стоимость последнего сканирования, то есть общая стоимость сканирования индекса; согласно (15), она равна 13,485;
- Nsort – число кортежей, подлежащих соритировке. В данном случае оно составляет 240.
- comparison_cost определяется следующим образом: 2×cpu_operator_cost
Таким образом, начальная стоимость рассчитывается следующим способом:
'start-up cost'=13.485+(2×0.0025)×240.0×log2(240.0)=22.973
Стоимость выполнения - это стоимость чтения отсортированных кортежей. Поэтому:
'run cost'=cpu_operator_cost×Nsort=0.0025×240=0.6
И наконец,
'total cost'=22.973+0.6=23.573
В качестве подтверждения приводим результат команды EXPLAIN вышеуказанного запроса SELECT:
testdb=# EXPLAIN SELECT id, data FROM tbl WHERE data < 240 ORDER BY id;
                                   QUERY PLAN
---------------------------------------------------------------------------------
 Sort  (cost=22.97..23.57 rows=240 width=8)
   Sort Key: id
   ->  Index Scan using tbl_data_idx on tbl  (cost=0.29..13.49 rows=240 width=8)
         Index Cond: (data < 240)
(4 rows)
В строке 4 мы видим, что начальные и общие затраты составляют 22,97 и 23,57 соответственно.


