

Создание дерева плана для многотабличного процесса PostgreSQL
Данный раздел описывает процесс создания дерева плана для многотабличного запроса.
Предварительная обработка
Функция subquery_planner(), определенная в planner.c, вызывает предварительную обработку. Предварительная обработка для запросов с одной таблицей описана в разделе 3.3.1. В данном подразделе дается описание предварительной обработки многотабличного запроса. Однако будут описаны только основные этапы данного процесса.
-
Планирование и преобразование CTE
Если есть списки WITH, планировщик обрабатывает каждый запрос WITH с помощью функции SS_process_ctes(). - Подзапросы
Если в предложении FROM есть подзапрос, но в нем нет предложений GROUP BY, HAVING, ORDER BY, LIMIT, DISTINCT, INTERSECT или EXCEPT, планировщик преобразует его в форму join с помощью функции pull_up_subqueries().
Например, запрос, содержащий подзапрос в предложении FROM, может быть преобразован в запрос join. Само собой разумеется, что это преобразование выполняется в дереве запросов.
testdb=# SELECT * FROM tbl_a AS a, (SELECT * FROM tbl_b) as b WHERE a.id = b.id;
testdb=# SELECT * FROM tbl_a AS a, tbl_b as b WHERE a.id = b.id;
- Преобразование внешнего JOIN во внутренний
Планировщик преобразует запрос с внешним соединением в запрос с внутренним соединением, если это возможно.
Получение оптимального пути
Для того, чтобы получить оптимальное дерево плана, планировщик должен рассмотреть все комбинации индексов и методов объединения. Это очень дорогостоящий процесс. К счастью, если число таблиц меньше 12, планировщик может получить оптимальный план, применив динамическое программирование. В противном случае планировщик использует генетический алгоритм.
Примечание: Генетический оптимизатор запросов
Когда выполняется запрос, объединяющий множество таблиц, на оптимизацию плана запроса уходит очень много времени. Чтобы справиться с этой ситуацией, в PostgreSQL реализована достаточно интересная функция, а именно Генетический оптимизатор запросов.
Это ориентировочный алгоритм, позволяющий определить оптимальный план за разумное время. Таким образом, на этапе оптимизации запроса, если количество объединяемых таблиц превышает порог, заданный параметром geqo_threshold (по умолчанию 12), PostgreSQL генерирует план запроса с помощью генетического алгоритма.
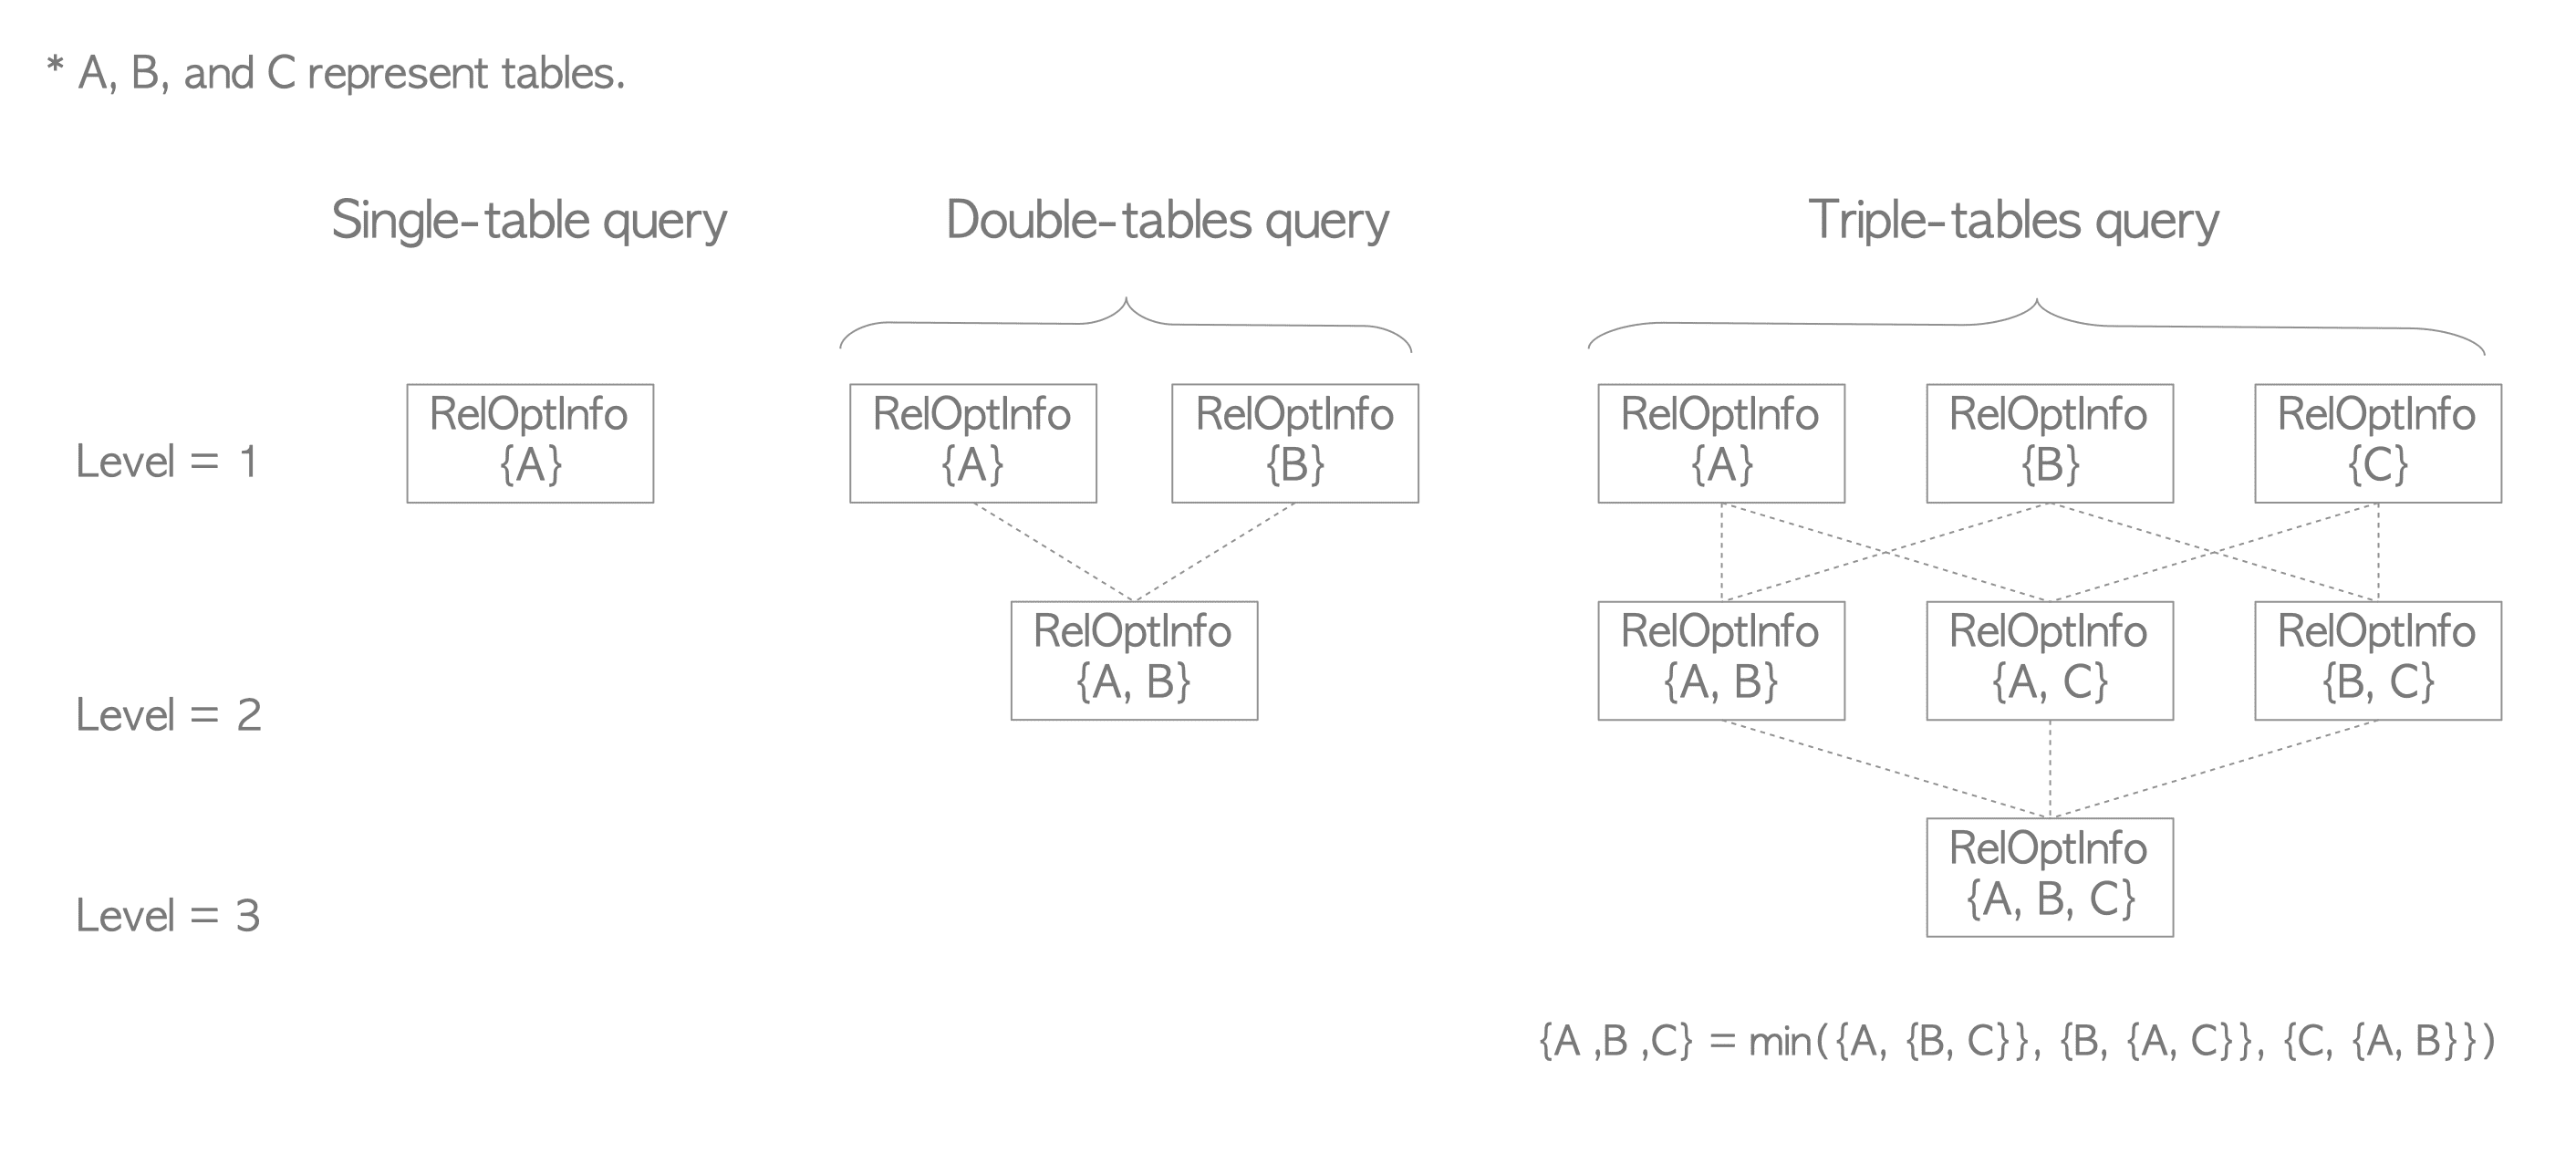
Определение оптимального дерева планов с помощью динамического программирования состоит из следующих этапов:
-
Уровень = 1
Получение самого недорогого пути для каждой таблицы. Самый недорогой путь хранится в соответствующем RelOptInfo. -
Уровень = 2
Получиение самого недорогого пути для каждой комбинации, состоящей из двух таблиц.
Например, если есть две таблицы A и B, необходимо найти самый недорогой путь соединения таблиц A и B.
Далее RelOptInfo двух таблиц представлено следующим образом: {A, B}.
Если таблиц три, необходимо найти самый недорогой путь для каждой из {A, B}, {A, C} и {B, C}.
- Уровень = 3 и выше
Продолжение этого процесса до тех пор, пока не будет достигнут уровень, равный количеству таблиц.
Таким образом, на каждом уровне определяются самые недорогие пути решения задач, используемых для расчета верхнего уровня, что позволяет эффективно вычислять дерево оптимальных планов.
Ниже описан процесс получения оптимального плана для следующего запроса:
testdb=# \d tbl_a
     Table "public.tbl_a"
Column | Type | Modifiers --------+---------+----------- id | integer | not null
data   | integer |
Indexes:
    "tbl_a_pkey" PRIMARY KEY, btree (id)

testdb=# \d tbl_b
     Table "public.tbl_b"
Column | Type | Modifiers --------+---------+----------- id | integer | data | integer | testdb=# SELECT * FROM tbl_a AS a, tbl_b AS b WHERE a.id = b.id AND b.data < 400;
Обработка на уровне 1
На уровне 1 планировщик создает структуру RelOptInfo и оценивает затраты для каждого отношения в запросе. Структуры RelOptInfo добавляются к массиву simple_rel_array в PlannerInfo данного запроса.
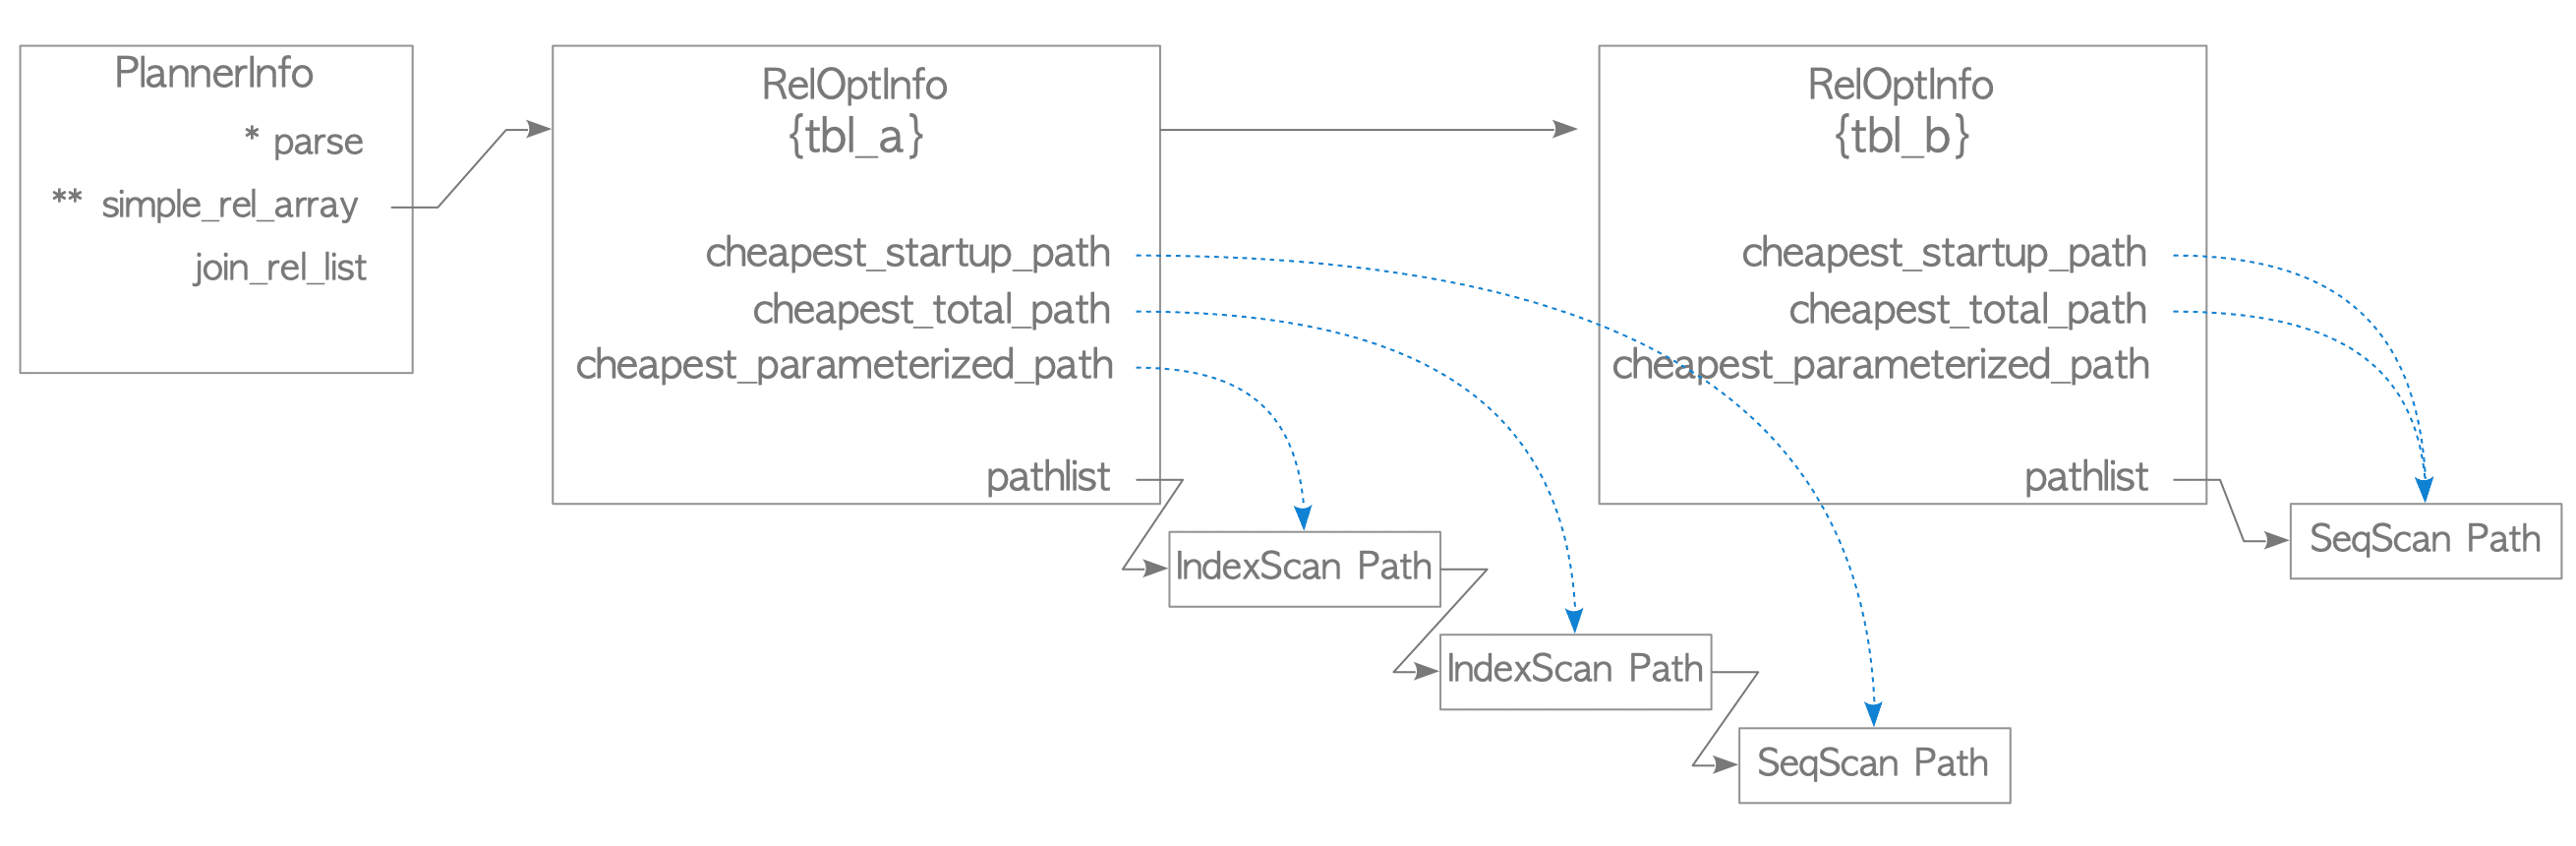
У RelOptInfo таблицы tbl_a есть три пути доступа, которые добавляются в pathlist RelOptInfo. Каждый путь доступа связан с самым недорогим путем: самый недорогой начальный путь (стоимость), самый недорогой общий путь (стоимость) и самый недорогой параметризованный путь (стоимость). Самые недорогие пути начальной и общей стоимости очевидны, поэтому ниже предоставлено описание стоимости самого недорогого параметризованного пути.
Как описано в разделе 3.5.1.3, планировщик рассматривает использование параметризованного пути для индексированного соединения вложенным циклом.
RelOptInfo из tbl_b имеет только путь доступа с последовательным сканированием, потому что у tbl_b нет связанного индекса.
Обработка на уровне 2
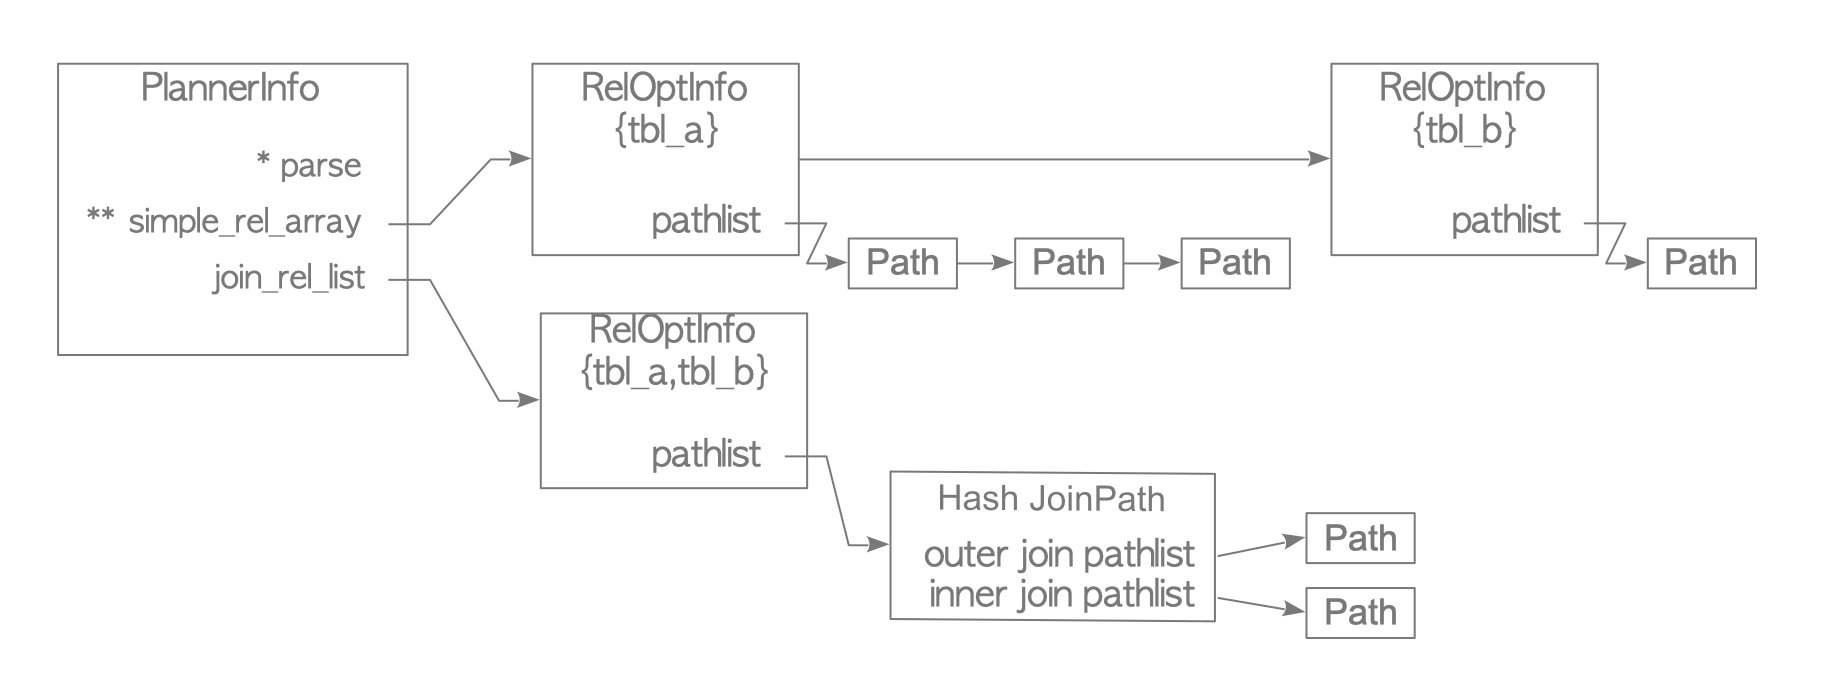
На уровне 2 создается структура RelOptInfo, которая добавляется в список join_rel_list в PlannerInfo. Затем оцениваются затраты всех возможных путей присоединения, и выбирается наиболее оптимальный путь доступа, чья суммарная стоимость является самой низкой. RelOptInfo сохраняет оптимальный путь доступа как путь с наименьшими суммарными затратами. Смотрите рисунок 40.
В таблице, приведенной ниже, описаны все комбинации путей доступа к соединению. Запрос в этом примере относится к типу equi-join, поэтому оцениваются все три метода присоединения. Для удобства используются некоторые обозначения путей доступа:
- SeqScanPath(table) означает путь последовательного сканирования таблицы.
- Materialized->SeqScanPath(table) означает материализованный путь последовательного сканирования таблицы.
- IndexScanPath(table, attribute) означает путь индексного сканирования по атрибуту таблицы.
- ParameterizedIndexScanPath(table, attribute1, attribute2) означает параметризованный индексный путь по атрибуту1 таблицы, который параметризован атрибутом2 внешней таблицы.
|
Таблица 3.1: Все комбинации путей доступа join в данном примере |
|||
|
Внешний путь |
Внутренний путь |
||
|
Соединение вложенными циклами |
|||
|
1 |
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
|
2 |
SeqScanPath(tbl_a) |
Materialized->SeqScanPath(tbl_b) |
Материализованное соединение вложенным циклом |
|
3 |
IndexScanPath(tbl_a,id) |
SeqScanPath(tbl_b) |
Соединение вложенным циклом с внешним индексным сканированием |
|
4 |
IndexScanPath(tbl_a,id) |
Materialized->SeqScanPath(tbl_b) |
Материализованное соединение вложенным циклом с внешним индексным сканированием |
|
5 |
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
|
|
6 |
SeqScanPath(tbl_b) |
Materialized->SeqScanPath(tbl_a) |
Материализованное соединение вложенным циклом |
|
7 |
SeqScanPath(tbl_b) |
ParametalizedIndexScanPath(tbl_a, id, tbl_b.id) |
Индексированное соединение вложенным циклом |
|
Соединение слиянием |
|||
|
1 |
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
|
2 |
IndexScanPath(tbl_a,id) |
SeqScanPath(tbl_b) |
Соединение слиянием с внешним индексным сканированием |
|
3 |
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
|
|
Хэш-соединение |
|||
|
1 |
SeqScanPath(tbl_a) |
SeqScanPath(tbl_b) |
|
|
2 |
SeqScanPath(tbl_b) |
SeqScanPath(tbl_a) |
|
Таким образом, в рамках соединения вложенным циклом оценивается семь путей соединения. Первый указывает на то, что внешний и внутренний пути - это пути последовательного сканирования tbl_a и tbl_b соответственно. Второй указывает на то, что внешний путь - это путь последовательного сканирования tbl_a, а внутренний - материализованный путь последовательного сканирования tbl_b. И так далее.
В итоге планировщик выбирает самый оптимальный путь доступа из оцененных путей соединения, который затем добавляется в pathlist RelOptInfo {tbl_a,tbl_b}.
В данном случае планировщик выбирает хэш-соединение, внутренней и внешней таблицами которого являются tbl_b и tbl_c.
testdb=# EXPLAIN  SELECT * FROM tbl_b AS b, tbl_c AS c WHERE c.id = b.id AND b.data < 400;
                              QUERY PLAN
----------------------------------------------------------------------
 Hash Join  (cost=90.50..277.00 rows=400 width=16)
   Hash Cond: (c.id = b.id)
   ->  Seq Scan on tbl_c c  (cost=0.00..145.00 rows=10000 width=8)
   ->  Hash  (cost=85.50..85.50 rows=400 width=8)
         ->  Seq Scan on tbl_b b  (cost=0.00..85.50 rows=400 width=8)
               Filter: (data < 400)
(6 rows)
Получение оптимального пути для запроса, связывающего три таблицы
Получить самый недорогой путь для запроса, связывающего три таблицы, можно следующим образом:
testdb=# \d tbl_a
     Table "public.tbl_a"
Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# \d tbl_b
     Table "public.tbl_b"
Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 data   | integer |

testdb=# \d tbl_c
     Table "public.tbl_c"
Column | Type | Modifiers --------+---------+----------- id | integer | not null
data   | integer |

Indexes:
    "tbl_c_pkey" PRIMARY KEY, btree (id)

testdb=# SELECT * FROM tbl_a AS a, tbl_b AS b, tbl_c AS c
testdb-#                WHERE a.id = b.id AND b.id = c.id AND a.data < 40;
- Уровень 1:
Планировщик оценивает самые дешевые пути для всех таблиц и сохраняет эту информацию в соответствующих объектах RelOptInfo: {tbl_a}, {tbl_b} и {tbl_c}.
- Уровень 2:
Планировщик выбирает все комбинации пар из трех таблиц и оценивает самый дешевый путь для каждой комбинации. Затем планировщик сохраняет информацию в соответствующих объектах RelOptInfo: {tbl_a, tbl_b}, {tbl_b, tbl_c} и {tbl_a, tbl_c}.
- Уровень 3:
В итоге планировщик находит самый недорогой путь, используя уже полученные объекты RelOptInfo.
Если быть точнее, то планировщик рассматривает три комбинации объектов RelOptInfo: {tbl_a, {tbl_b, tbl_c}}, {tbl_b, {tbl_a, tbl_c}} и {tbl_c, {tbl_a, tbl_b}}, потому что
{tbl_a,tbl_b,tbl_c}=min({tbl_a,{tbl_b,tbl_c}},{tbl_b,{tbl_a,tbl_c}},{tbl_c,{tbl_a,tbl_b}}).
Затем планировщик оценивает стоимость всех возможных путей соединения.
В рамках RelOptInfo {tbl_c, {tbl_a, tbl_b}} планировщик оценивает все комбинации tbl_c и самый недорогой путь {tbl_a, tbl_b}, которым в данном случае является хэш-соединение, чьи внутренние и внешние таблицы - tbl_a и tbl_b, соответственно.
Предполагаемые пути присоединения будут содержать три вида путей присоединения и их вариации, как описано в предыдущем подразделе, а именно: соединение вложенным циклом и его вариации, соединение слиянием и его вариации, а также хэш-соединение.
Планировщик обрабатывает объекты RelOptInfo {tbl_a, {tbl_b, tbl_c}} и {tbl_b, {tbl_a, tbl_c}} таким же образом и в итоге выбирает из всех предполагаемых путей самый недорогой путь доступа.
Результат выполнения команды EXPLAIN для данного запроса показан ниже:
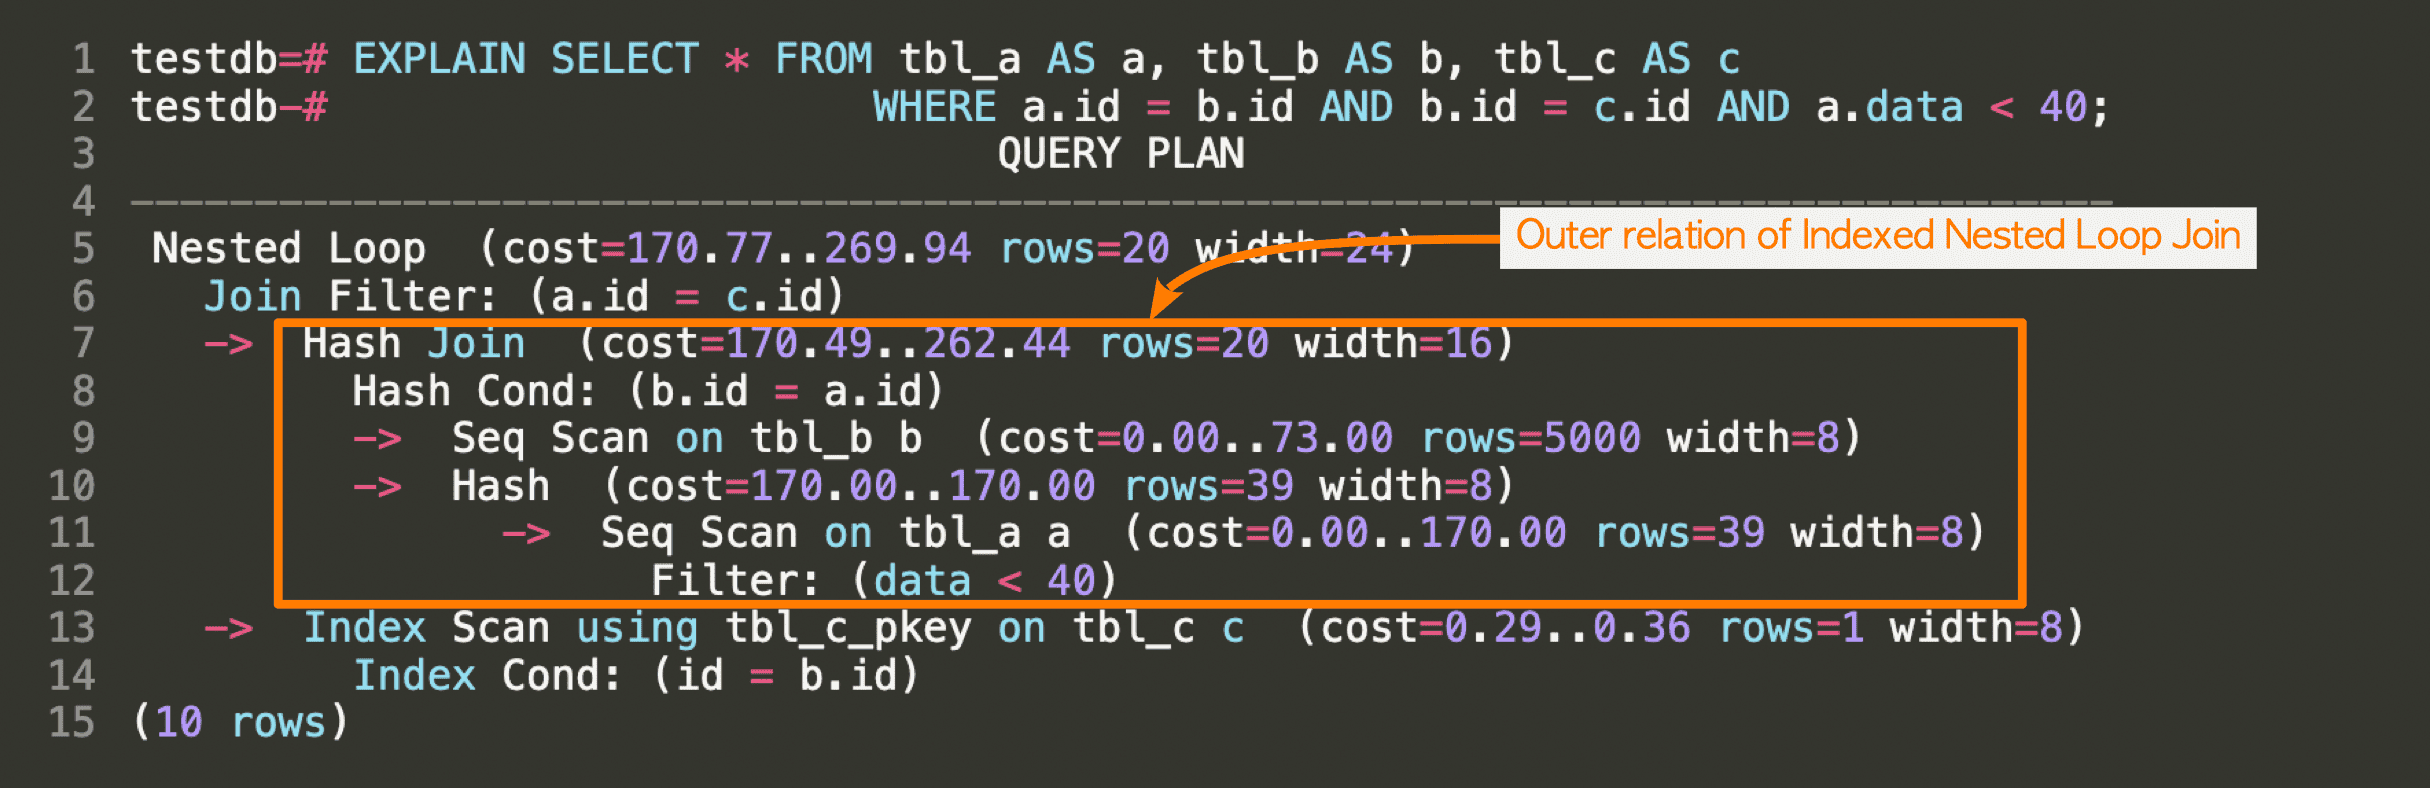
OUTER JOIN - это индексированное соединение вложенным циклом (строка 5). Внутреннее параметризованное индексное сканирование показано в строке 13, а внешнее отношение является результатом хэш-соединения, внутренняя и внешняя таблицы которого - tbl_b и tbl_a соответственно (строки 7-12). Таким образом, исполнитель сначала выполняет хэш-соединение tbl_a и tbl_b, а затем выполняет индексированное соединение вложенным циклом.


