

Способы соединения в PostgreSQL
PostgreSQL поддерживает три алгоритма соединения : соединение вложенным циклом (nested loop), соединение слиянием (merge join) и хэш-соединение (hash join). У соединения вложенными циклами и соединения слиянием в рамках PostgreSQL есть несколько вариаций.
В дальнейшем предполагается, что читатель достаточно хорошо знаком с тремя способами соединения в рамках PostgreSQL.
Если Вы не знакомы с данной темой, рекомендуем ознакомиться со следующими материалами:
1. Abraham Silberschatz, Henry F. Korth, S. Sudarshan, “Database System Concepts”, McGraw-Hill Education, ISBN-13: 978-0073523323
2. Thomas M. Connolly, Carolyn E. Begg, “Database Systems”, Pearson, ISBN-13: 978-0321523068
Данный раздел содержит информацию о:
- Соединении вложенными циклами
- Соединении слиянием
- Хэш-соединении
- Путях доступа к соединению и узлам соединения
Обратите внимание, что три метода соединения, поддерживаемые PostgreSQL, могут выполнять все операции объединения - не только INNER JOIN, но и LEFT/RIGHT OUTER JOIN, FULL OUTER JOIN и так далее. В данном разделе мы остановимся на NATURAL INNER JOIN.
Соединение вложенными циклами
Соединение вложенными циклами - это оновная операция соединения в PostgreSQL, которая поддерживает пять разновидностей данного типа соединения.
Соединение вложенными циклами
Соединение вложенными циклами не требует подготовительных действий, поэтому начальная стоимость будет равна 0:
'start-up cost'=0
Стоимость выполнения соединения вложенными циклами пропорциональна произведению размеров внешней и внутренней таблиц. Другими словами, ‘run cost’‘ = O(Nouter×Ninner), где Nouter и Ninner - количество кортежей внешней и внутренней таблиц. Если быть точнее, то стоимость выполнения определяется следующим уравнением:
'run cost'=(cpu_operator_cost+cpu_tuple_cost)×Nouter×Ninner+Cinner×Nouter+Couter
где Couter и Cinner - затраты на сканирование внешней и внутренней таблиц.

Стоимость соединения вложенными циклами оценивается всегда, но эта операция соединения используется редко, поскольку обычно применяются более эффективные способы, описанные ниже.
В целом, данный тип соединения эффективен для небольших выборок, зависит от порядка соединения, при этом поддерживает соединение по любому условию.
Материализованное соединение вложенным циклом
Соединение вложенными циклами, описанное выше, должно сканировать все кортежи внутренней таблицы. Поскольку это достаточно дорогостоящий процесс, PostgreSQL поддерживает материализованное соединение вложенными циклами, позволяющее уменьшить общую стоимость сканирования внутренней таблицы.
Перед выполнением данного соединения исполнитель записывает кортежи внутренней таблицы в work_mem или во временный файл, предварительно просканировав внутреннюю таблицу один раз с помощью модуля временного хранения кортежей, описанного ниже.
Это позволяет обрабатывать кортежи внутренней таблицы более эффективно (по сравнению с использованием менеджера буферов).
На рисунке 24 показано, как работает материализованное соединение вложенными циклами, которое по-другому называется rescan.

Примечание: Временное хранилище кортежей
PostgreSQL предоставляет модуль временного хранения кортежей для материализации таблиц. Данный модуль состоит из функций, определенных в tuplestore.c, которые хранят и считывают последовательность кортежей в/из work_mem или временных файлов. Решение о том, использовать ли work_mem или временные файлы, зависит от общего размера хранимых кортежей.
Рассмотрим, как исполнитель обрабатывает дерево плана материализованного соединения вложенными циклами, и как именно оценивается стоимость. Пример:
testdb=#EXPLAINSELECT*FROMtbl_aASa, tbl_bASbWHEREa.id=b.id;QUERY PLAN-----------------------------------------------------------------------Nested Loop (cost=0.00..750230.50rows=5000width=16)JoinFilter: (a.id=b.id)->Seq Scanontbl_a a (cost=0.00..145.00rows=10000width=8)->Materialize (cost=0.00..98.00rows=5000width=8)->Seq Scanontbl_b b (cost=0.00..73.00rows=5000width=8)(5rows)
Сначала показана работа исполнителя. Исполнитель обрабатывает отображаемые узлы плана следующим образом:
- Строка 7: Исполнитель материализует внутреннюю таблицу tbl_b путем последовательного сканирования (строка 8).
- Строка 4: Исполнитель выполняет операцию соединения вложенным циклом; внешней таблицей является tbl_a, а внутренней - материализованная tbl_b.
Далее оцениваются затраты на операции 'Materialize' (строка 7) и 'Nested Loop' (строка 4). Предположим, что материализованные внутренние кортежи хранятся в памяти work_mem.
Materialize:
Затраты на подготовительные мероприятия отсутствуют, поэтому начальная стоимость равна 0.
'start-up cost'=0
Стоимость выполнения определяется следующим уравнением:
'run cost'=2×cpu_operator_cost×Ninner
Таким образом,
'run cost'=2×0.0025×5000=25.0
Кроме того, общая стоимость – это сумма начальной стоимости, общей стоимости последовательного сканирования и стоимости выполнения:
'total cost'=('start-up cost'+'total cost of seq scan')+'run cost'
Таким образом,
'total cost'=(0.0+73.0)+25.0=98.0.
(Materialized) nested loop:
Затраты на подготовительные мероприятия отсутствуют, поэтому начальная стоимость равна 0.
'start-up cost'=0
Прежде чем оценивать стоимость выполнения, определим стоимость rescan, определяемую следующим уравнением:
'rescan cost'=cpu_operator_cost×Ninner
В нашем случае,
'rescan cost'=(0.0025)×5000=12.5.
Стоимость выполнения определяется следующим образом:
'run cost'=(cpu_operator_cost+cpu_tuple_cost)×Ninner×Nouter+'rescan cost'×(Nouter−1)+Ctotalouter,seqscan+Ctotalmaterialize
где Ctotalouter,seqscan- общая стоимость сканирования ншней таблицы, а Ctotalmaterialize – это общая стоимость materialized. Таким образом,
'run cost'=(0.0025+0.01)×5000×10000+12.5×(10000−1)+145.0+98.0=750230.5.
Индексированное соединение вложенными циклами
Если во внутренней таблице есть индекс, по которому можно найти кортежи, удовлетворяющие условию соединения для каждого кортежа внешней таблицы, планировщик рассмотрит возможность использования этого индекса для прямого поиска кортежей во внутренней таблице вместо последовательного сканирования. Этот вариант называется индексированным соединением вложенным циклом, смотрите рисунок 25.
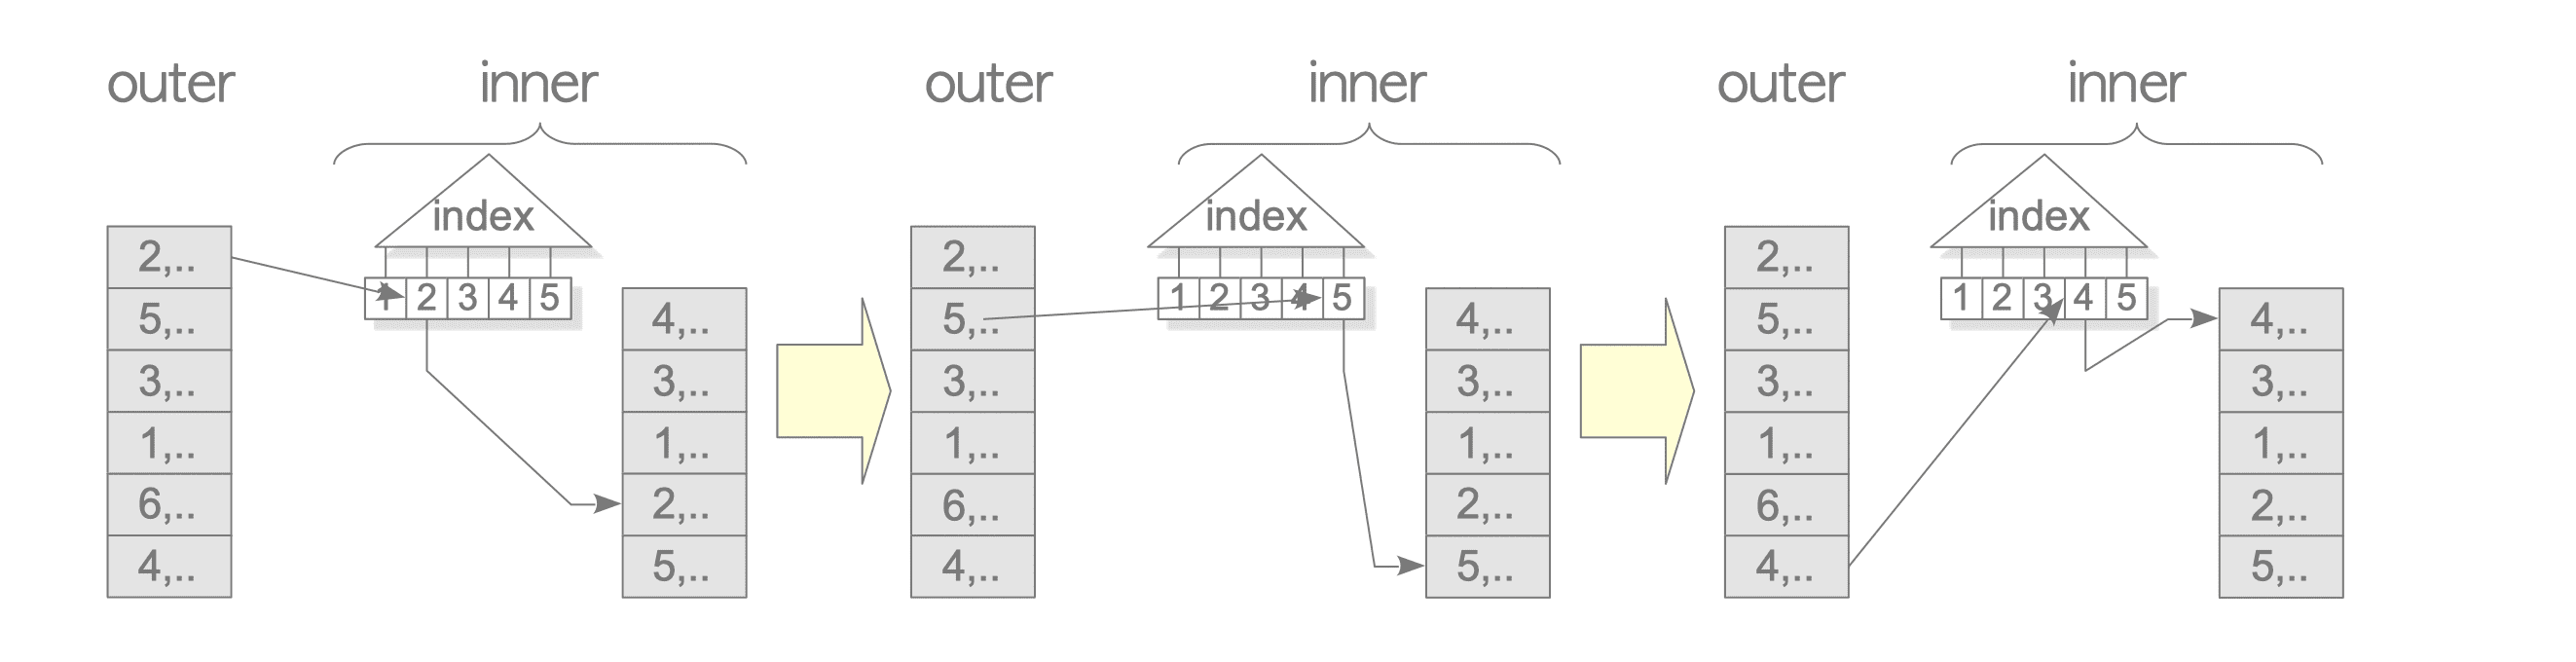
Приведем пример индексированного соединения вложенным циклом.
testdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_bASbWHEREc.id=b.id;QUERY PLAN--------------------------------------------------------------------------------Nested Loop (cost=0.29..1935.50rows=5000width=16)->Seq Scanontbl_b b (cost=0.00..73.00rows=5000width=8)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..0.36rows=1width=8)IndexCond: (id=b.id)(4rows)
В строке 6 показана стоимость доступа к кортежу внутренней таблицы. Это стоимость поиска во внутренней таблице, если кортеж удовлетворяет условию индекса '(id=b.id)', которое показано в строке 7.
В индексном условии '(id=b.id)' в строке 7 'b.idb.id' - это значение атрибута внешней таблицы, используемое в условии соединения. Всякий раз, когда путем последовательного сканирования из внешней таблицы извлекается кортеж, путь сканирования индекса в строке 6 ищет внутренние кортежи, которые необходимо объединить. Другими словами, всякий раз, когда внешняя таблица передается в качестве параметра, этот путь индексного сканирования ищет внутренние кортежи, удовлетворяющие условию соединения. Такой индексный путь называется параметризованным (индексным) путем. Более подробная информация описана в README.
Начальная стоимость соединения вложенным циклом равна затратам на сканирование индекса в строке 6; таким образом,
'start-up cost'=0.285
Общая стоимость индексированного соединения вложеннм циклом определяется следующим уравнением:
'total cost'=(cpu_tuple_cost+Ctotalinner,parameterized)×Nouter+Crunouter,seqscan
где Ctotalinner,parameterized – это общая стоимость параметризованного внутреннего индексного сканирования.
В нашем случае,
'total cost'=(0.01+0.3625)×5000+73.0=1935.5
А стоимость выполнения:
'run cost'=1935.5−0.285=1935.215.
Как показано выше, общая стоимость индексированного соединения вложенным циклом равна O(Nouter).
Другие виды соединения вложенными циклами
Если есть индекс внешней таблицы и его атрибуты участвуют в условии объединения, то его можно использовать для индексного сканирования вместо последовательного сканирования внешней таблицы. В частности, если есть индекс, атрибут которого может быть использован в качестве предиката доступа в предложении WHERE, диапазон поиска во внешней таблице заметно сужается. Это может значительно снизить стоимость соединения вложенным циклом.
PostgreSQL поддерживает три варианта соединения вложенным циклом с внешним индексным сканированием.
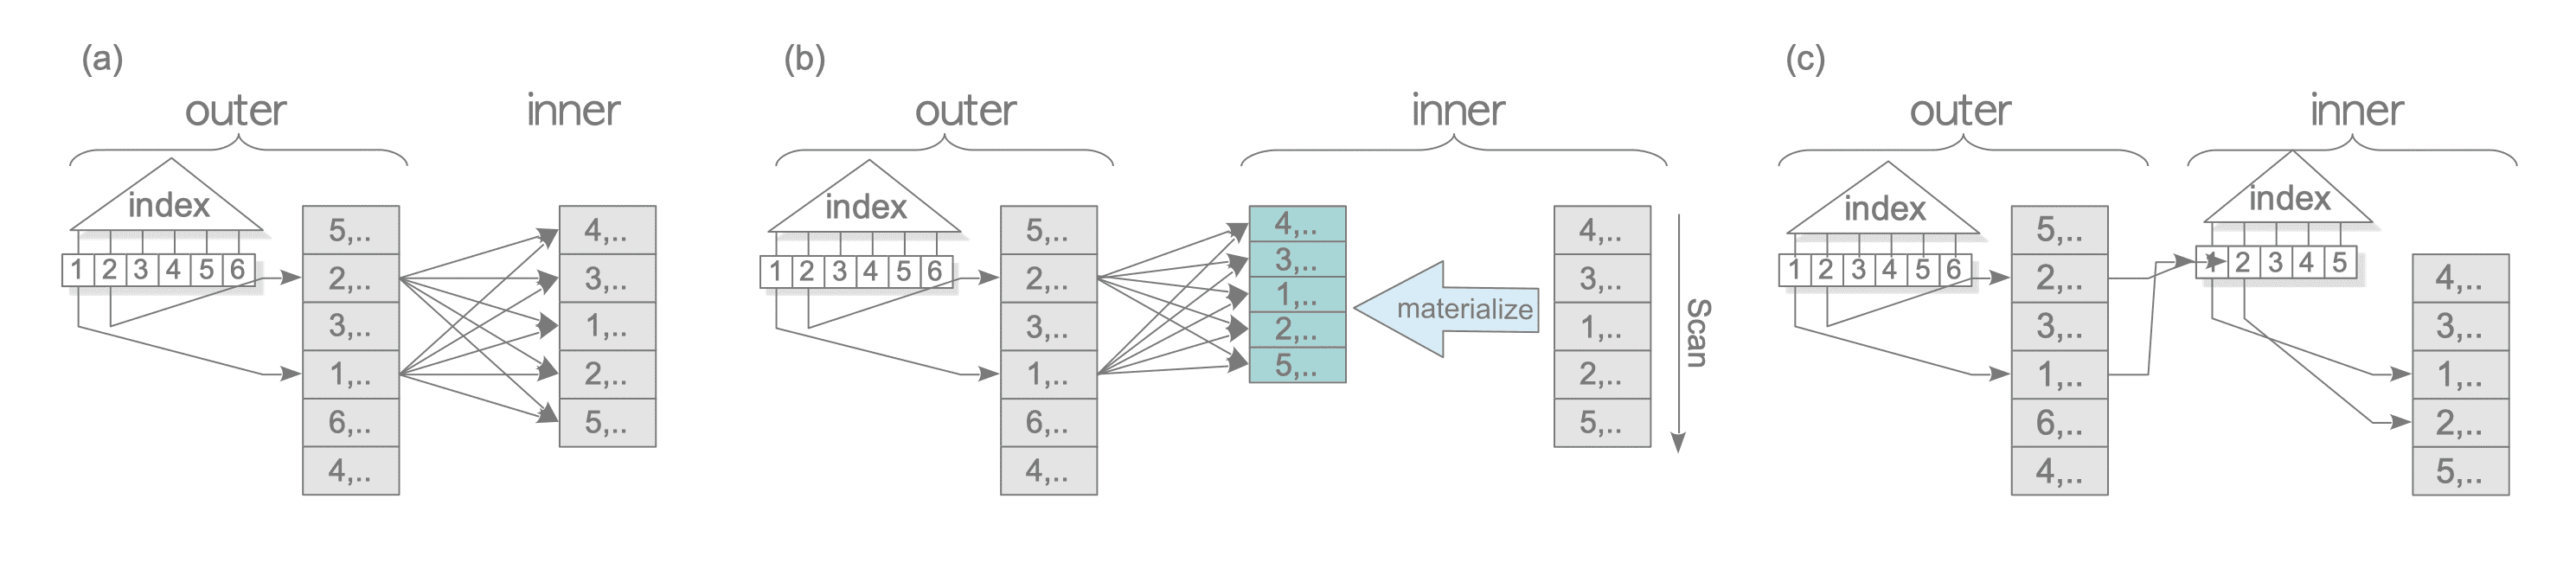
Результаты EXPLAIN этих объединений показаны ниже:
(a) Соединение вложенным циклом с внешним индексным сканированием:
SETtestdb=#SETenable_mergejoinTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_bASbWHEREc.id=b.idANDc.id=500;QUERY PLAN--------------------------------------------------------------------------------Nested Loop (cost=0.29..93.81rows=1width=16)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..8.30rows=1width=8)IndexCond: (id=500)->Seq Scanontbl_b b (cost=0.00..85.50rows=1width=8)Filter: (id=500)(5rows)
(2) Материализованное соединение вложенным циклом с внешним индексным сканированием:
testdb=#SETenable_hashjoinTOoff;SETtestdb=#SETenable_mergejoinTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_bASbWHEREc.id=b.idANDc.id<40ANDb.id<10;QUERY PLAN---------------------------------------------------------------------------------Nested Loop (cost=0.29..99.76rows=1width=16)JoinFilter: (c.id=b.id)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..8.97rows=39width=8)IndexCond: (id<40)->Materialize (cost=0.00..85.55rows=9width=8)->Seq Scanontbl_b b (cost=0.00..85.50rows=9width=8)Filter: (id<10)(7rows)
(3) Индексированное соединение вложенным циклом с внешним индексным сканированием:
testdb=#SETenable_hashjoinTOoff;SETtestdb=#SETenable_mergejoinTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_aASa, tbl_dASdWHEREa.id=d.idANDa.id<40;QUERY PLAN---------------------------------------------------------------------------------Nested Loop (cost=0.57..173.06rows=20width=16)->IndexScanusingtbl_a_pkeyontbl_a a (cost=0.29..8.97rows=39width=8)IndexCond: (id<40)->IndexScanusingtbl_d_pkeyontbl_d d (cost=0.28..4.20rows=1width=8)IndexCond: (id=a.id)(5rows)
Соединение слиянием
Соединение слиянием, в отличие от соединеня вложенными циклами, требует подготовительных действий, эффективно для больших выборок, зависит от порядка соединения.
Стоимость соединения слиянием оценивается с помощью функций initial_cost_mergejoin() и final_cost_mergejoin().
Точная оценка стоимости данной операции слишком сложна, поэтому здесь она не приводится. Вместо этого мы рассмотрим только порядок выполнения алгоритма объединения. Начальные затраты на объединение представляют собой сумму затрат на сортировку внутренней и внешней таблиц. Это означает, что начальная стоимость определяется следующим способом: O(Nouterlog2(Nouter)+Ninnerlog2(Ninner)), где Nouter и Ninner – количество кортежей во внешней и внутренней таблицах соответственно. Стоимость выполнения рассчитывается так: O(Nouter+Ninner).
По аналогии с соединением вложенным циклом, различают 4 типа соединения слиянием.
Соединение слиянием
На рисунке 27 изображен процесс соединения слиянием.
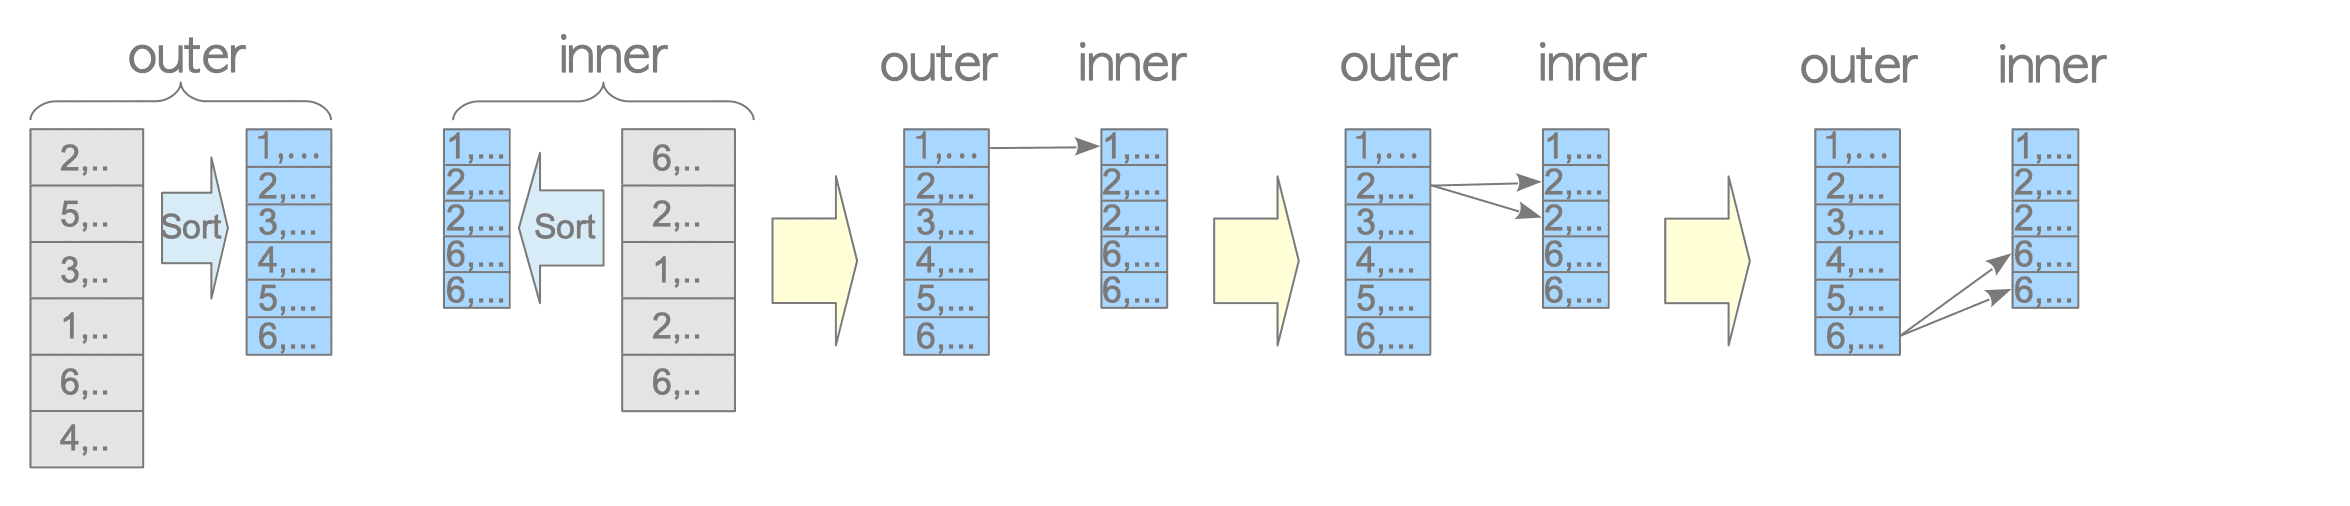
Если все кортежи можно хранить в памяти, то и операции сортировки можно выполнять в самой памяти. В противном случае будут использоваться временные файлы.
Ниже показан пример результата работы команды EXPLAIN с объединением.
testdb=#EXPLAINSELECT*FROMtbl_aASa, tbl_bASbWHEREa.id=b.idANDb.id<1000;QUERY PLAN-------------------------------------------------------------------------MergeJoin(cost=944.71..984.71rows=1000width=16)Merge Cond: (a.id=b.id)->Sort (cost=809.39..834.39rows=10000width=8)SortKey: a.id->Seq Scanontbl_a a (cost=0.00..145.00rows=10000width=8)->Sort (cost=135.33..137.83rows=1000width=8)SortKey: b.id->Seq Scanontbl_b b (cost=0.00..85.50rows=1000width=8)Filter: (id<1000)(9rows)
- Строка 9: Исполнитель сортирует внутреннюю таблицу tbl_b с помощью последовательного сканирования (строка 11).
- Строка 6: Исполнитель сортирует внешнюю таблицу tbl_a с помощью последовательного сканирования (строка 8).
- Строка 4: Исполнитель выполняет операцию объединения; внешней таблицей является отсортированная tbl_a, а внутренней - отсортированная tbl_b.
Материализованное соединение слиянием
Как и в случае соединения вложенными циклоами, соединение слиянием также поддерживает материализованное соединение слиянием для повышения эффективности сканирования внутренней таблицы.

Нижен приведен пример результата материализованного соединения. Очевидно, что главным его отличием от результата объединения выше является строка 9: 'Materialize'.
testdb=#EXPLAINSELECT*FROMtbl_aASa, tbl_bASbWHEREa.id=b.id;QUERY PLAN-----------------------------------------------------------------------------------MergeJoin(cost=10466.08..10578.58rows=5000width=2064)Merge Cond: (a.id=b.id)->Sort (cost=6708.39..6733.39rows=10000width=1032)SortKey: a.id->Seq Scanontbl_a a (cost=0.00..1529.00rows=10000width=1032)->Materialize (cost=3757.69..3782.69rows=5000width=1032)->Sort (cost=3757.69..3770.19rows=5000width=1032)SortKey: b.id->Seq Scanontbl_b b (cost=0.00..1193.00rows=5000width=1032)(9rows)
- Строка 10: Исполнитель сортирует внутреннюю таблицу tbl_b с помощью последовательного сканирования (строка 12);
- Строка 9: Исполнитель материализует результат сортировки tbl_b;
- Строка 6: Исполнитель сортирует внешнюю таблицу tbl_a с помощью последовательного сканирования (строка 8);
- Строка 4: Исполнитель выполняет операцию объединения; внешней таблицей является отсортированная tbl_a, а внутренней - материализованная отсортированная tbl_b.
Другие типы соединения слиянием
Подобно соединению вложенным циклом, у соединения слиянием в PostgreSQL есть вариации, на основе которых можно выполнять сканирование индексов внешней таблицы.

Результаты EXPLAIN данных объединений приведены ниже:
(a) Соединение слиянием с внешним индексным сканированием
testdb=#SETenable_hashjoinTOoff;SETtestdb=#SETenable_nestloopTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_bASbWHEREc.id=b.idANDb.id<1000;QUERY PLAN--------------------------------------------------------------------------------------MergeJoin(cost=135.61..322.11rows=1000width=16)Merge Cond: (c.id=b.id)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..318.29rows=10000width=8)->Sort (cost=135.33..137.83rows=1000width=8)SortKey: b.id->Seq Scanontbl_b b (cost=0.00..85.50rows=1000width=8)Filter: (id<1000)(7rows)
(b) Материализованное соединение слиянием с внешним индексным сканированием
testdb=#SETenable_hashjoinTOoff;SETtestdb=#SETenable_nestloopTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_bASbWHEREc.id=b.idANDb.id<4500;QUERY PLAN--------------------------------------------------------------------------------------MergeJoin(cost=421.84..672.09rows=4500width=16)Merge Cond: (c.id=b.id)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..318.29rows=10000width=8)->Materialize (cost=421.55..444.05rows=4500width=8)->Sort (cost=421.55..432.80rows=4500width=8)SortKey: b.id->Seq Scanontbl_b b (cost=0.00..85.50rows=4500width=8)Filter: (id<4500)(8rows)
(c) Индексированное соединение слиянием с внешним индексным сканированием
testdb=#SETenable_hashjoinTOoff;SETtestdb=#SETenable_nestloopTOoff;SETtestdb=#EXPLAINSELECT*FROMtbl_cASc, tbl_dASdWHEREc.id=d.idANDd.id<1000;QUERY PLAN--------------------------------------------------------------------------------------MergeJoin(cost=0.57..226.07rows=1000width=16)Merge Cond: (c.id=d.id)->IndexScanusingtbl_c_pkeyontbl_cc(cost=0.29..318.29rows=10000width=8)->IndexScanusingtbl_d_pkeyontbl_d d (cost=0.28..41.78rows=1000width=8)IndexCond: (id<1000)(5rows)
Хэш-соединение
Хэш-соединение также требует подготовительных действий, эффективно для больших выборок, при этом не зависит от порядка соединения. Данный алгоритм распараллеливается и масштабируется лучше любого другого соединения и сильно выигрывает при большой производительности информационных хранилищ.
Хэш-соединение имеет много общего с соединением слиянием. Подобно соединению слиянием, для него требуются не менее одного предиката объединения по эквивалентности, оно поддерживает остаточные предикаты, а также все внешние соединения и полусоединения. В отличие от соединения слиянием, для него не требуется наличие упорядоченных входных потоков и для поддержки полного внешнего соединения требуется наличие предиката соединения по эквивалентности.
Хэш-соединение происходит по-разному в зависимости от размера таблиц. Если целевая таблица достаточно мала (точнее, размер внутренней таблицы составляет < = 25 % от work_mem), то это будет простое двухфазное in-memory хэш-соединение. В противном случае используется гибридное хэш-соединение.
В данном подразделе дано описание процесса выполнения обоих хэш-соединений.
Оценка стоимости опущена, так как это слишком сложный процесс. Грубо говоря, начальная стоимость и стоимость выполнения составляет O(Nouter+Ninner).
In-Memory хэш-соединение
In-memory хэш-соединение обрабатывается в work_mem, а область хэш-таблицы в PostgreSQL называется партией. Партия хэш-слотов, называемых сегментами, и количество сегментов определяется функциейExecChooseHashTableSize(), определенной в nodeHash.c; количество сегментов всегда равно , где n- целое число.
In-memory хэш-соединение состоит из двух фаз: фазы компоновки и фазы пробы. Во время компоновки осуществляется чтение всех строк первого входного потока (часто, его называют левым потоком или потоком компоновки), хеширование строк по ключам соединения эквивалентности и создание в оперативной памяти хеш-таблицы. Во время пробы осуществляется чтение всех строк второго входного потока (часто его называют правым потоком или пробным потоком), хеширование строк этого потока по тем же ключам соединения эквивалентности, а потом осуществляется просмотр или поиск соответствий строк в хеш-таблице. Так как хеш-функции могут быть подвержены коллизиям (два разных значения ключа имеют одинаковый хэш), приходится проверять каждое потенциальное соответствие, что необходимо для гарантии того, что в этом случае действительно совпадение обусловлено соединением, а не коллизией.
Для лучшего понимания этой операции рассмотрим пример, приведенный ниже. Предположим, что запрос, обозначенный ниже, выполняется при помощи хэш-соединения.
testdb=#SELECT*FROMtbl_outerASouter, tbl_innerASinnerWHEREinner.attr1=outer.attr2;
Далее показан процесс хэш-соединения. Смотрите рисунок 30 и 31.
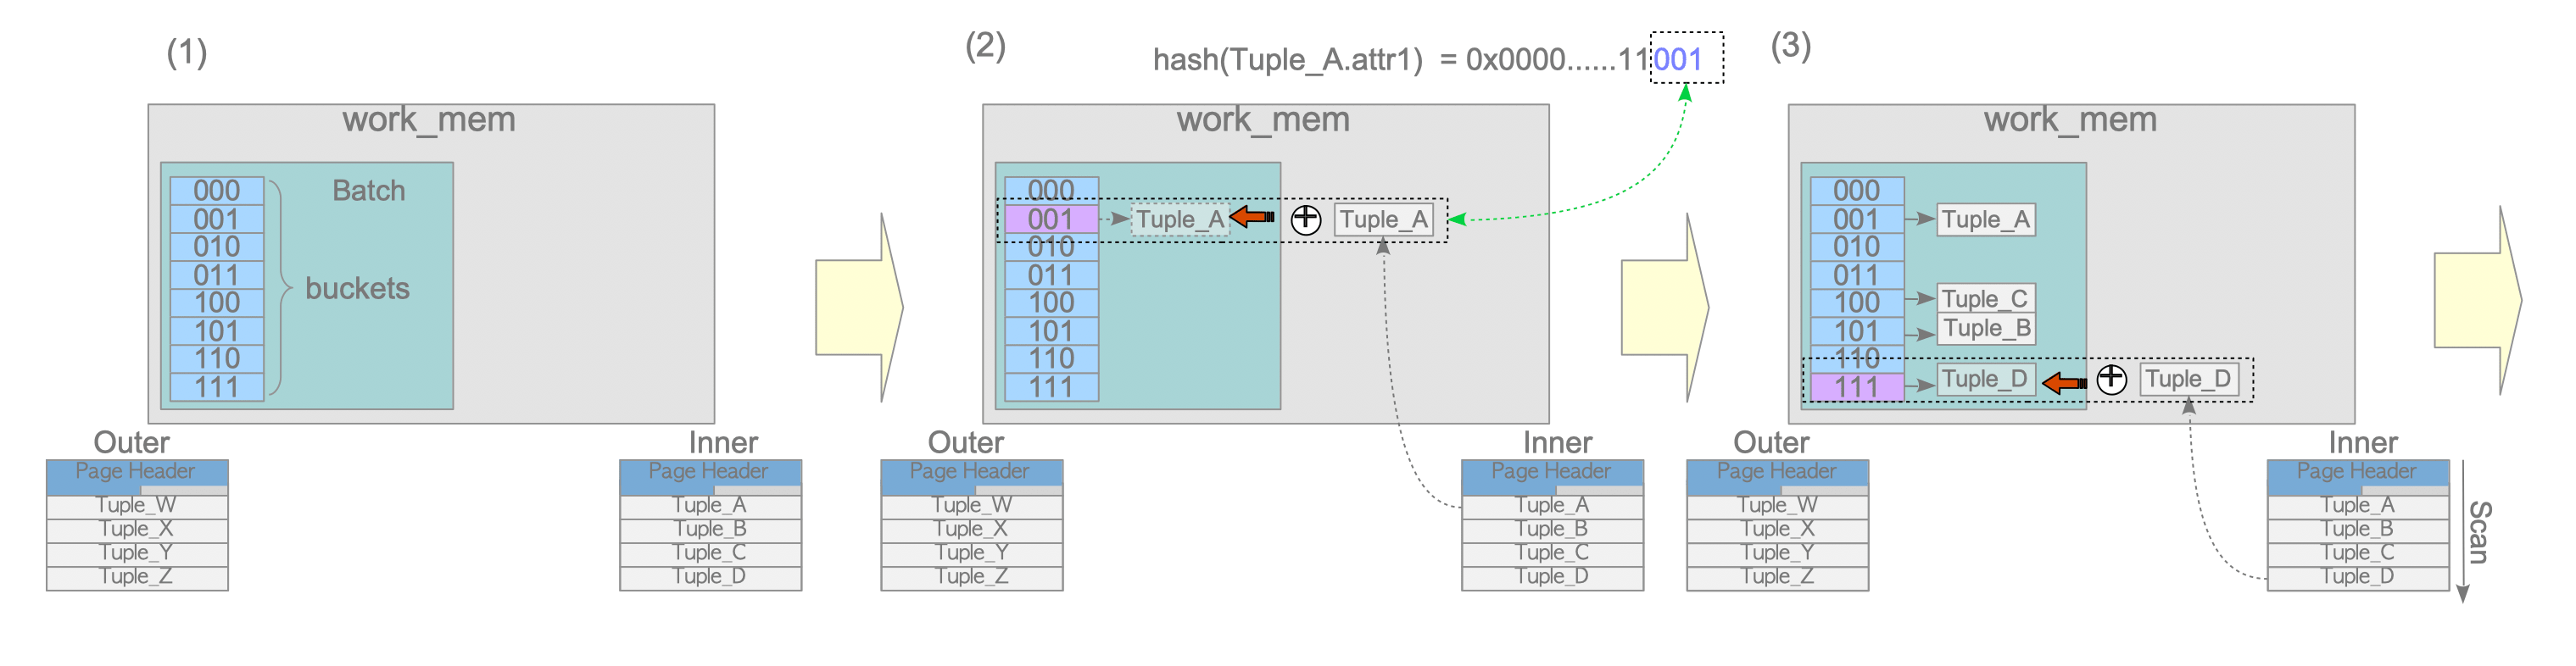
(1) В work_mem создается партия.
В данном примере партия состоит из 8 сегментов, что означает, что количество сегментов равно.
(2) Первый кортеж из внутренней таблицы вставляется в соответствующий сегмент пакета:
1.Вычислите хэш-ключ атрибута первого кортежа, участвующего в условии объединения.
В данном примере хэш-ключ атрибута 'attr1' первого кортежа вычисляется с помощью встроенной хэш-функции, поскольку в предложении WHERE стоит 'inner.attr1 = outer.attr2'.
2.Вставьте первый кортеж в соответствующий сегмент.
Предположим, что хэш-ключ первого кортежа равен '0x000...001', что означает, что последние три бита равны '001'. В этом случае данный кортеж вставляется в сегмент, ключ которого равен '001'.
В этом документе операция вставки для создания партии представлена этим оператором: ⊕
(3) Вставьте оставшиеся кортежи внутренней таблицы.
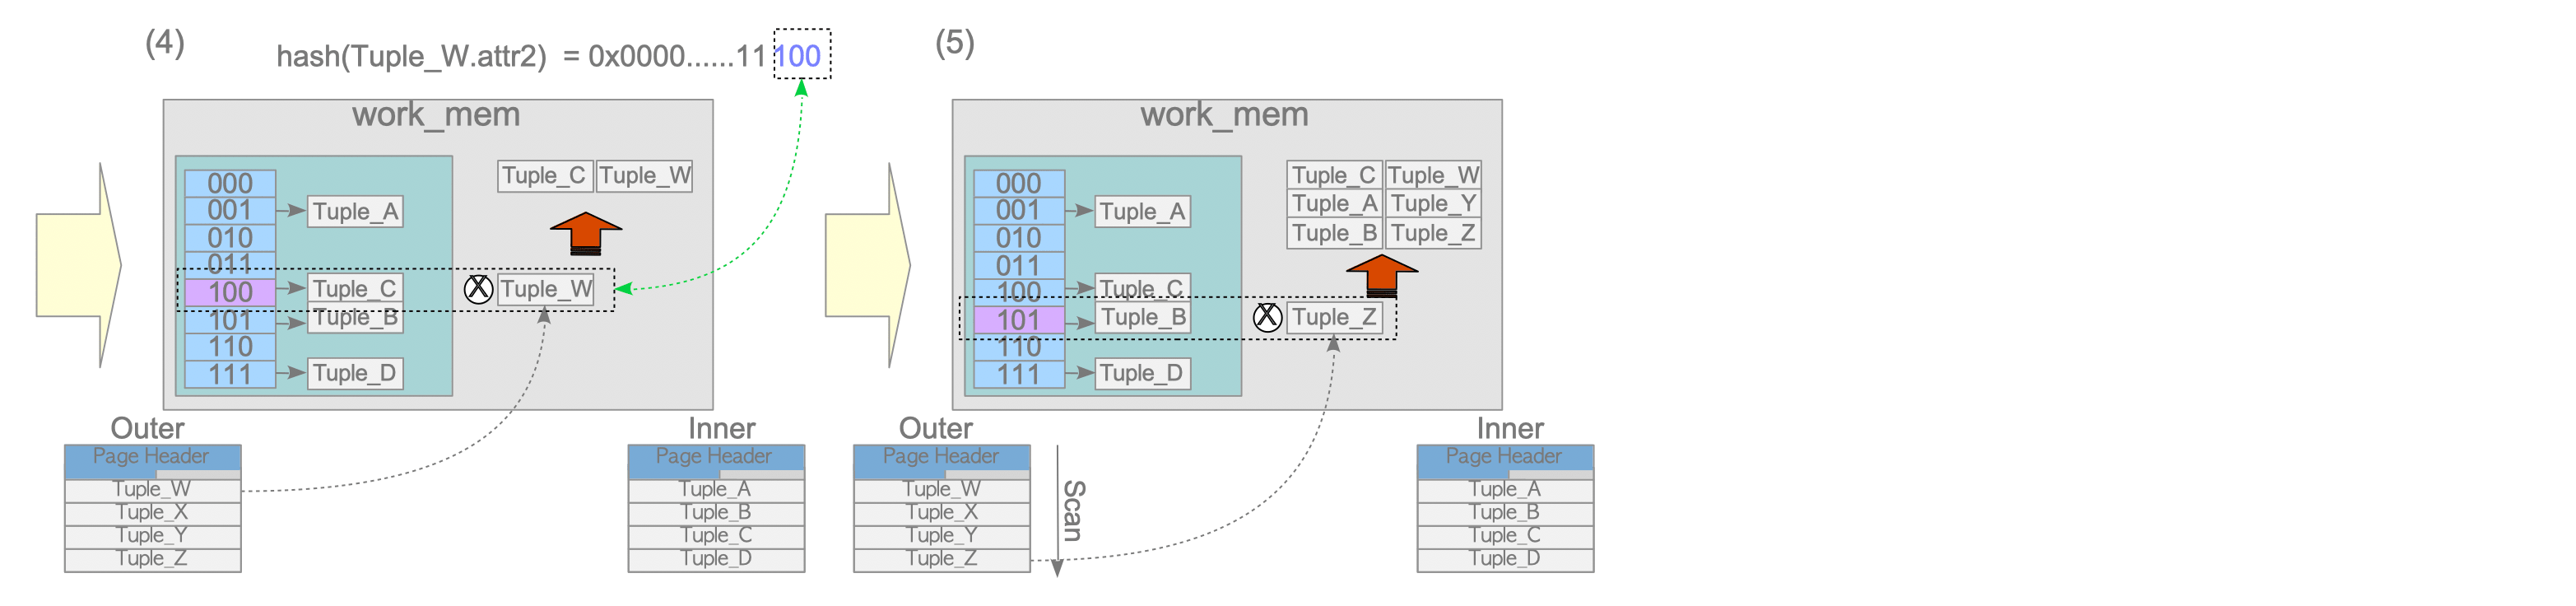
(4) Проверьте первый кортеж внешней таблицы:
- Вычислите хэш-ключ атрибута первого кортежа, участвующего в условии присоединения к внешней таблице.
В данном примере предположим, что хэш-ключ атрибута первого кортежа 'attr2' равен '0x000...100'; то есть последние три бита равны '100'.
- Сравните первый кортеж внешней таблицы с внутренними кортежами в пакете и объедините кортежи, если выполнено условие объединения.
Поскольку последние три бита хэш-ключа первого кортежа равны '100', исполнитель извлекает кортежи, принадлежащие сегменту, ключ которого равен '100', и сравнивает оба значения соответствующих атрибутов таблиц, указанных в условии объединения (заданном предложением WHERE).
Если условие соединения выполнено, то первый кортеж внешней таблицы и соответствующий кортеж внутренней таблицы будут объединены. В противном случае исполнитель ничего не сделает.
В данном примере сегмент, ключ которого '100', содержит кортеж_C. Если attr1 Tuple_C равен attr2 первого кортежа (Tuple_W), то Tuple_C и Tuple_W будут объединены и сохранены в памяти или временном файле.
В данном документе операция проверкия партии представлена оператором: ⊕
(5) Проверьте оставшиеся кортежи внешней таблицы.
Гибридное хэш-соединение
Алгоритм гибридного хэш-соединения использует преимущество большего объема доступной памяти. На этапе разделения гибридное хеш-соединение использует доступную память для двух целей:
- для хранения текущей страницы выходного буфера для каждого из разделов;
- Для хранения всего раздела в памяти, известного как «раздел 0»
Поскольку раздел 0 никогда не записывается на диск и не читается с него, гибридное хеш-соединение обычно выполняет меньше операций ввода-вывода, чем льготное хеш-соединение. Обратите внимание, что этот алгоритм чувствителен к памяти, потому что есть два конкурирующих требования к памяти (хеш-таблица для раздела 0 и выходные буферы для оставшихся разделов). Выбор слишком большой хэш-таблицы может привести к рекурсии алгоритма, потому что один из ненулевых разделов слишком велик для размещения в памяти
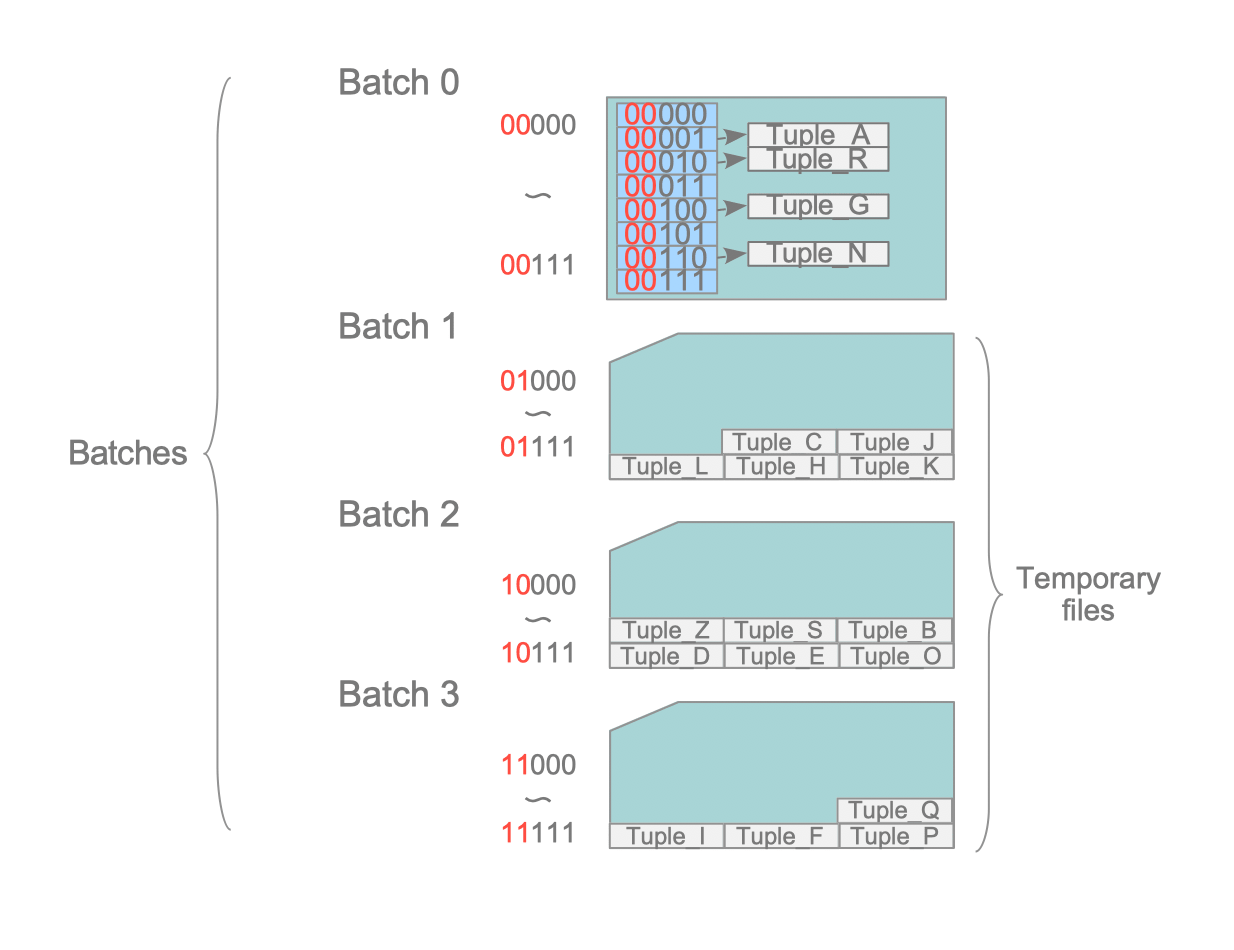
Сначала описывается основная концепция гибридного хэш-соединения. На первых этапах компоновки и пробы PostgreSQL подготавливает несколько партий. Количество партий совпадает с количеством корзин, определяемым функцией ExecChooseHashTableSize(). Оно всегда равно , где m - целое число. На этом этапе в work_mem выделяется только одна партия, остальные партии создаются как временные файлы. Кортежи, принадлежащие этим партиям, записываются в соответствующие файлы и сохраняются с помощью функции временного хранения кортежей.
На рисунке 32 показано, как именно кортежи хранятся в четырех партиях (= ). В этом случае то, в какой партии хранится каждый кортеж, определяется первыми двумя битами из последних 5 бит хэш-ключа кортежа, поскольку размеры сегментов и партий равны и . Batch_0 хранит кортежи, последние 5 бит хэш-ключа которых находятся между '00000' и '00111', Batch_1 - кортежи, последние 5 бит хэш-ключа которых находятся между '01000' и '01111' и так далее.
В гибридном хэш-соединении количество фаз компоновки и пробы соответствует количеству пакетов. В первом этапе фаз построения и проверки не только создается отдельный пакет, но и обрабатываются первые пакеты как внутренней, так и внешней таблиц. Обработка второго и последующих этапов требует записи и перезагрузки во/из временных файлов, таким образом, это достаточно дорогостоящие процессы. Поэтому PostgreSQL также готовит специальную партию, называемую skew, для более эффективной обработки большого количества кортежей в рамках первого этапа.
Партия skew хранит кортежи внутренней таблицы, которые затем будут объединены с кортежами внешней таблицы, чьи значения MCV, участвующие в условии объединения, относительно велики. Рассмотрим пример, приведенный ниже.
Предположим, что у нас есть две таблицы: customers и purchase_history.
- У таблицы customers’ есть два атрибута: ’name’ and ‘address’.
- У таблицы purchase_history также два атрибута: ‘customer_name’ и ‘purchased_item’.
- Таблица customers’ содержит 10,000 строк, таблица purchase_history - 1,000,000 строк.
- 10% постоянных покупателей приобрели 70% от общего количества товаров.
Учитывая условия, описанные выше, рассмотрим, как работает гибридное хэш-соединение во время перевого этапа при выполнении запроса, описанного ниже.
testdb=# SELECT * FROM customers AS c, purchase_history AS h WHERE c.name = h.customer_name;
Если таблица customers является внутренней, а purchase_history - внешней, то 10% постоянных покупателей сохраняются в выборке skew с использованием значений MCV таблицы purchase_history. Обратите внимание, что значения MCV внешней таблицы используются для вставки кортежей внутренней таблицы в партию перекоса. На этапе зондирования первого раунда 70 % кортежей внешней таблицы (purchase_history) будут объединены с кортежами, хранящимися в партии перекоса. Таким образом, чем более неравномерно распределена внешняя таблица, тем больше кортежей из нее может быть обработано в первом раунде.
Далее описан процесс гибридного хэш-соединения. Смотрите рисунки 33-36.
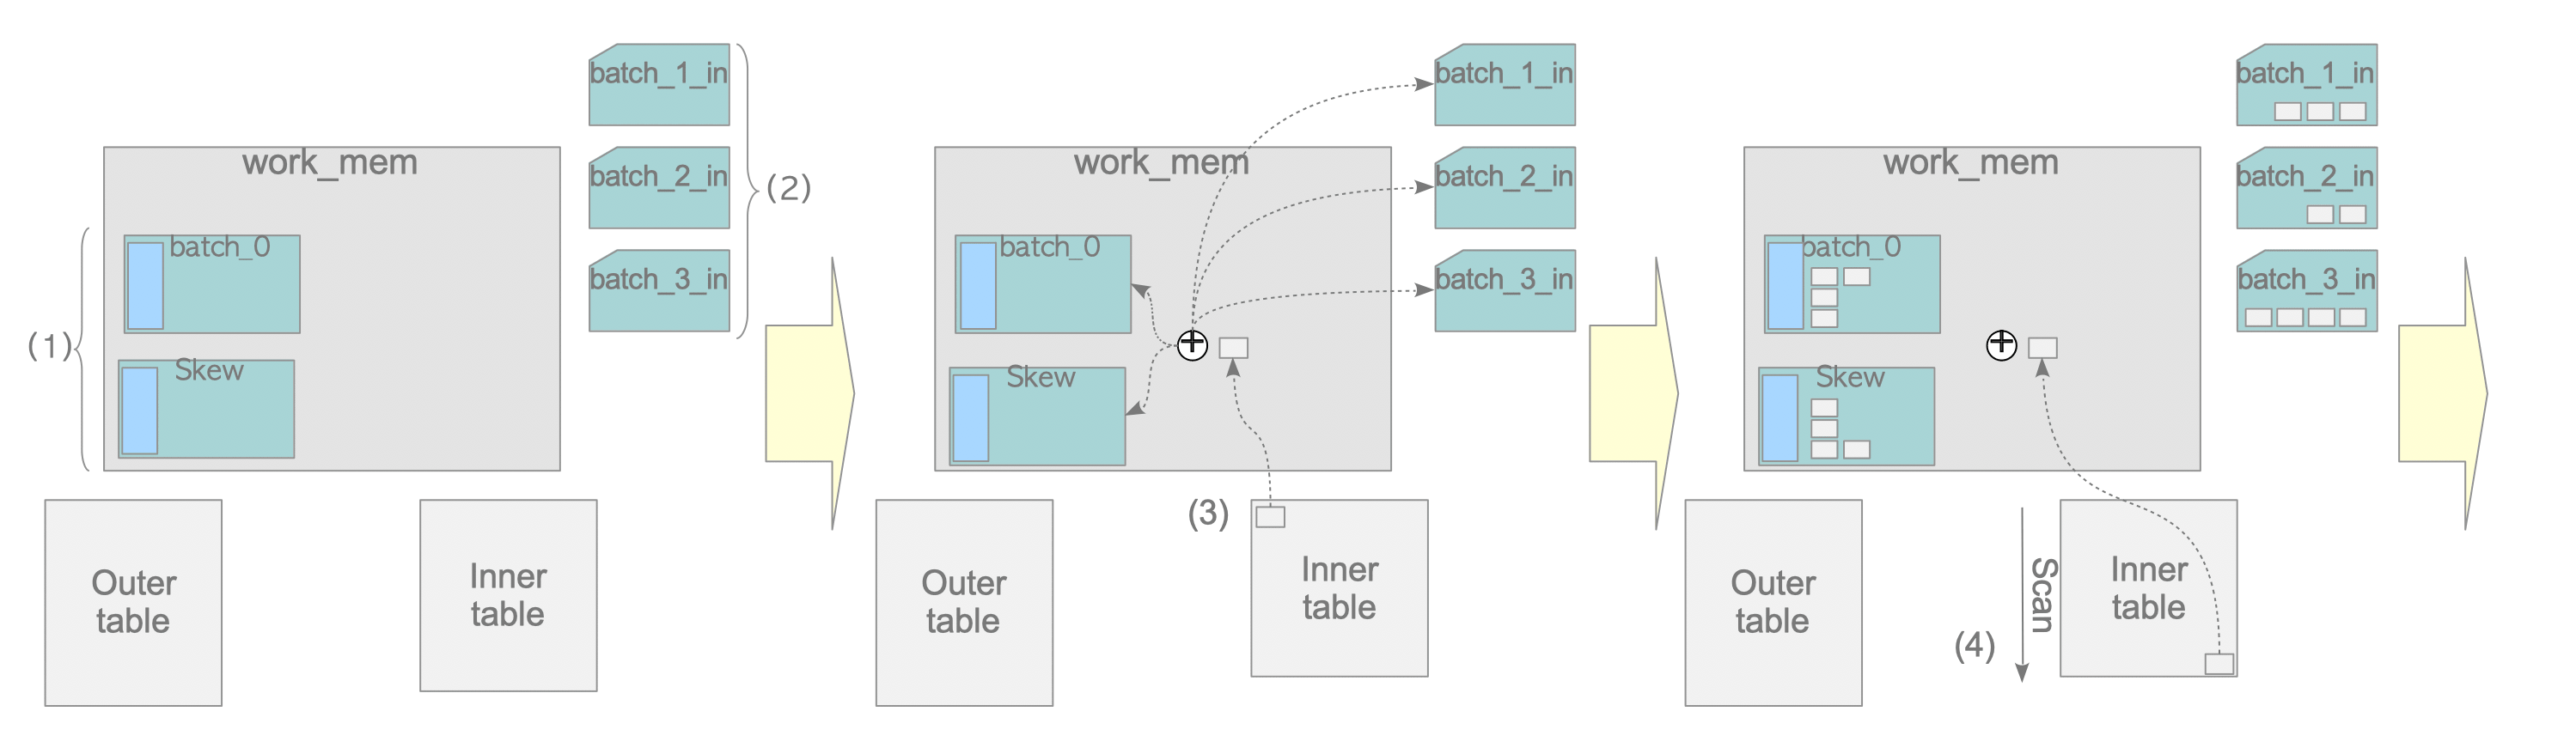
(1) Создайте партию и партию skew на work_mem.
(2) Создайте временные пакетные файлы для хранения кортежей внутренней таблицы.
В нашем примере создается три пакетных файла, поскольку внутренняя таблица будет разделена на четыре пакета.
(3) Выполните операцию построения для первого кортежа внутренней таблицы:
1. Если первый кортеж можно вставить в партию skew, сделайте это. В противном случае перейдите к пункту 2.
2. В примере, приведенном выше, если первый кортеж входит в число 10 % постоянных клиентов, он становится частью партии skew.
3. Вычислите хэш-ключ первого кортежа, а затем вставьте его в соответствующую партию.
(4) Выполните операцию построения для оставшихся кортежей внутренней таблицы.
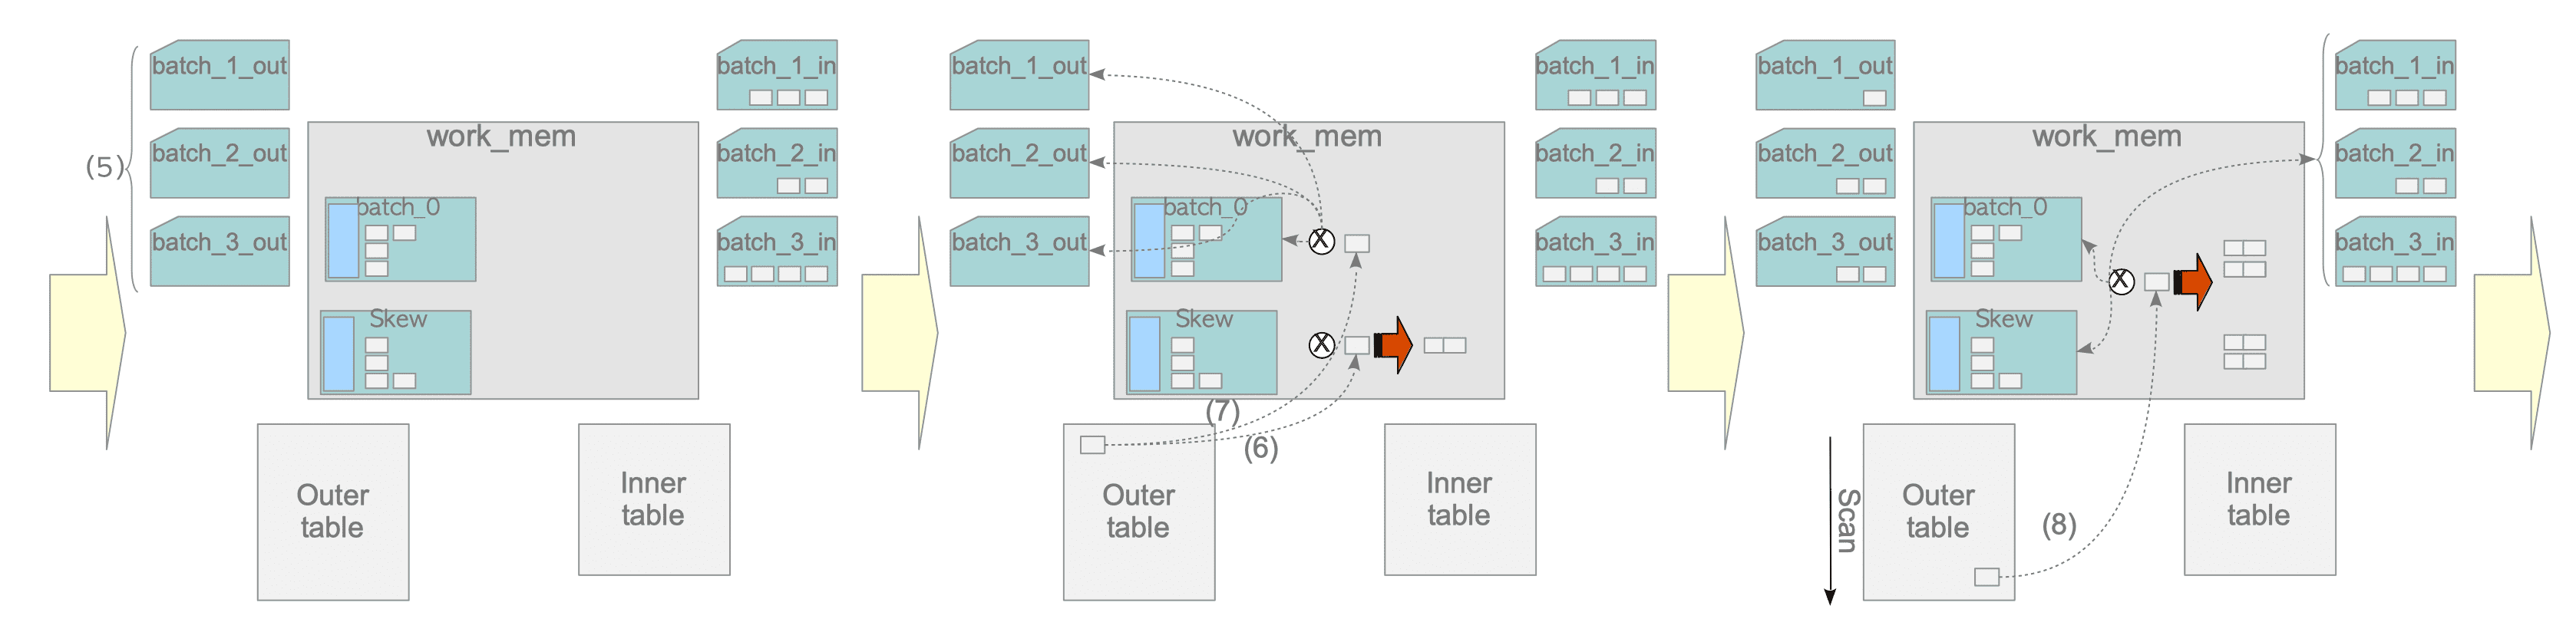
(5) Создайте временные пакетные файлы для хранения кортежей внешней таблицы.
(6) Если значение MCV первого кортежа слишком велико, выполните операцию проверки. В противном случае переходим к пункту (7).
(7) Выполните операцию проверки первого кортежа.
В зависимости от значения хэш-ключа первого кортежа выполняется следующий процесс:
1. Если первый кортеж принадлежит Batch_0, выполните операцию зондирования.
2. В противном случае вставьте в соответствующую партию.
(8) Выполните операцию проверки оставшихся кортежей внешней таблицы.
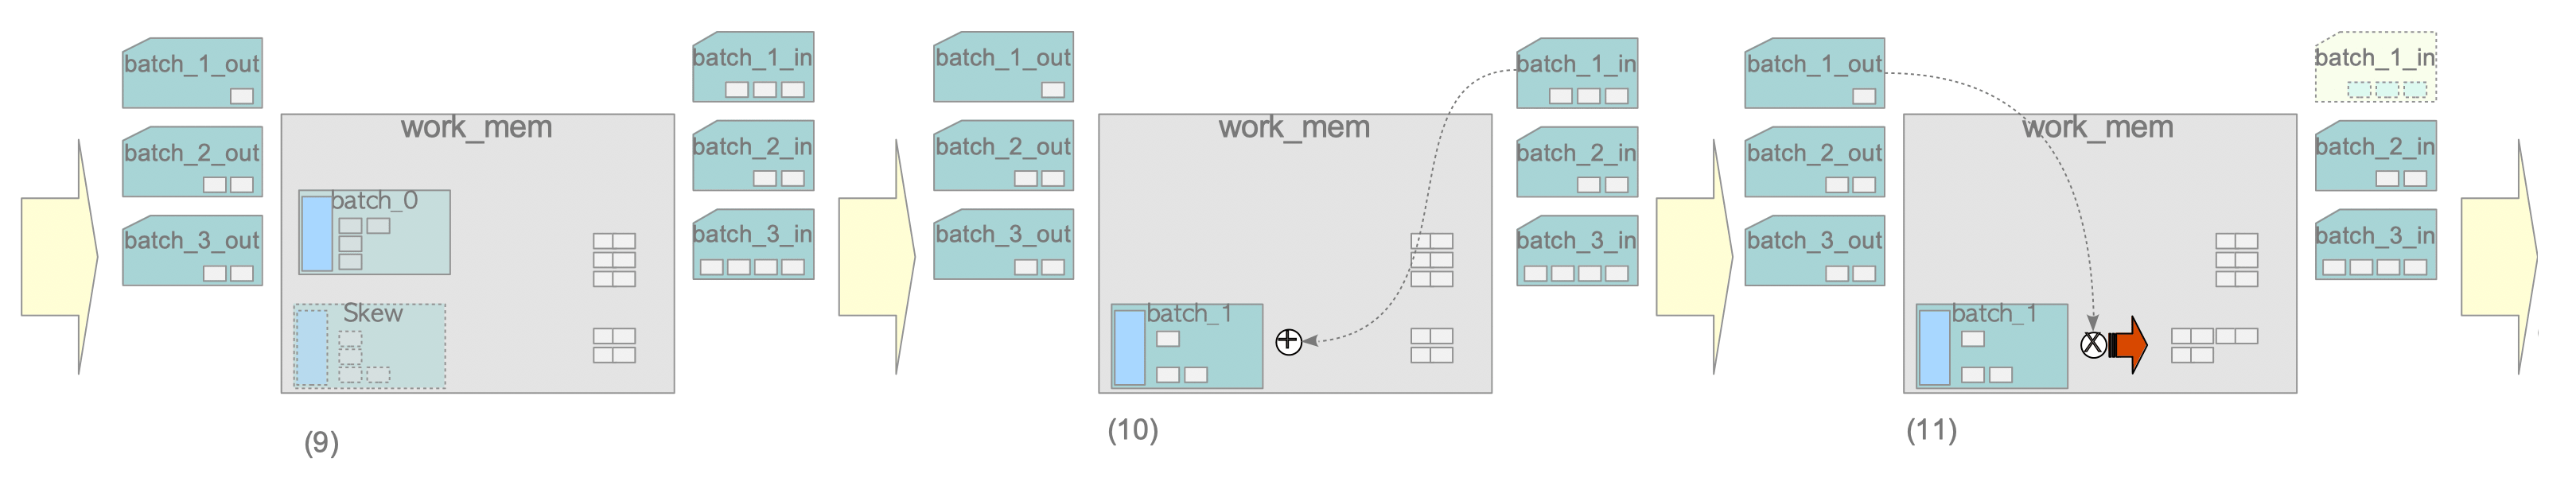
(9) Для подготовки второго этапа удалите партию skew и очистите Batch_0.
(10) Выполните операцию построения из пакетного файла 'batch_1_in'..
(11) Выполните операцию зондирования для кортежей, которые хранятся в пакетном файле 'batch_1_out'.
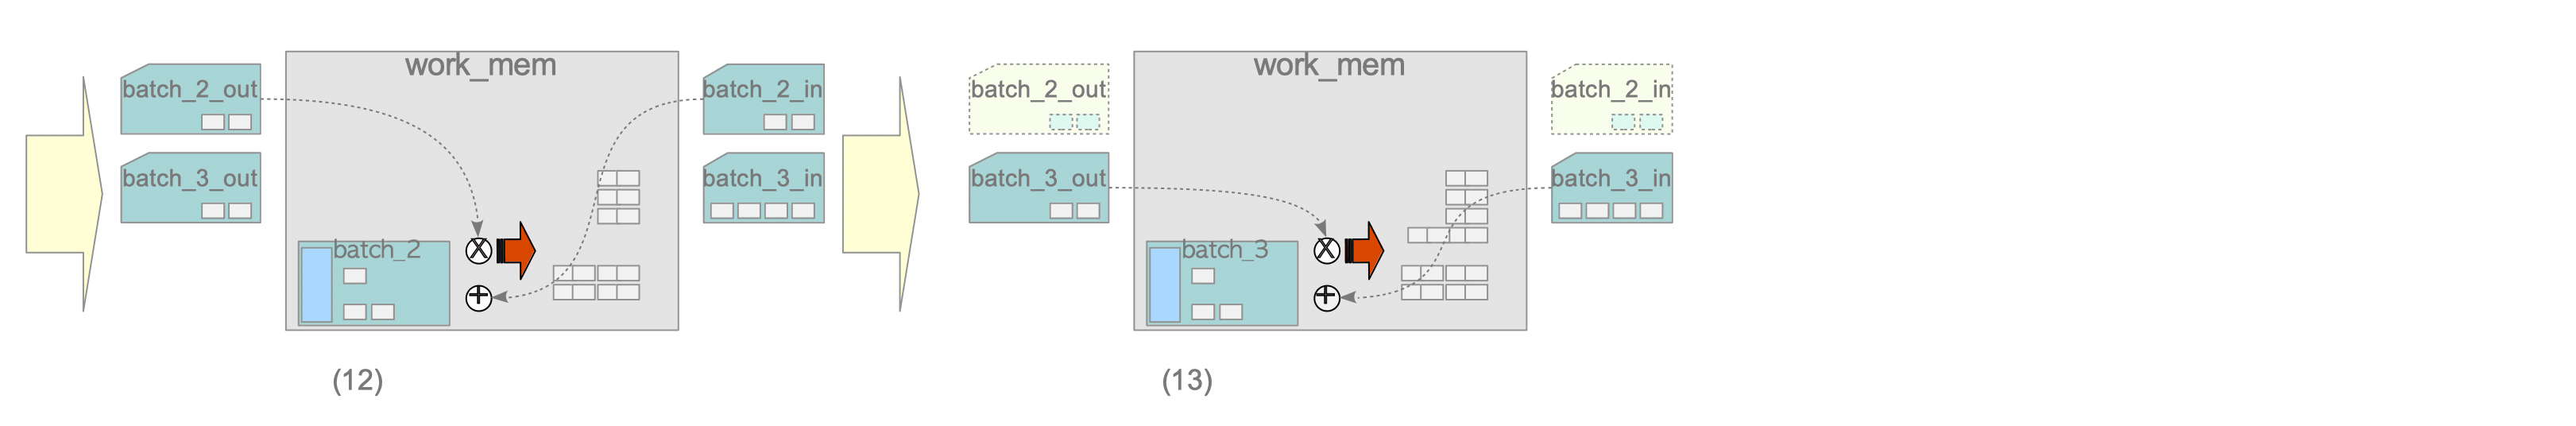
(12) Выполните операции построения и проверки с помощью пакетных файлов ‘batch_2_in’ и ‘batch_2_out’.
(13) Выполните операции построения и проверки с помощью пакетных файлов ‘batch_3_in’ и ‘batch_3_out’.
Индексное сканирование в хэш-соединении
Там, где это возможно, хэш-соединение использует индексное сканирование. Рассмотрим пример, приведенный ниже.
testdb=#EXPLAINSELECT*FROMpgbench_accountsASa, pgbench_branchesASbtestdb-#WHEREa.bid=b.bidANDa.aidBETWEEN100AND1000;QUERY PLAN----------------------------------------------------------------------------------------------------------HashJoin(cost=1.88..51.93rows=865width=461)Hash Cond: (a.bid=b.bid)->IndexScanusingpgbench_accounts_pkeyonpgbench_accounts a (cost=0.43..47.73rows=865width=97)IndexCond: ((aid>=100)AND(aid<=1000))->Hash (cost=1.20..1.20rows=20width=364)->Seq Scanonpgbench_branches b (cost=0.00..1.20rows=20width=364)(6rows)
Строка 7: На этапе проверки при сканировании таблицы pgbench_accounts PostgreSQL использует индексное сканирование, поскольку в предложении WHERE есть условие для столбца 'aid', имеющего индекс
Пути доступа к JOIN и узлы JOIN
Пути доступа к JOIN
Структура PathJoin - это путь доступа для соединения вложенными циклами.
Все пути доступа к join проиллюстрированы ниже.
JoinPath
typedefJoinPath NestPath;/** JoinType -* enums for types of relation joins** JoinType determines the exact semantics of joining two relations using* a matching qualification. For example, it tells what to do with a tuple* that has no match in the other relation.** This is needed in both parsenodes.h and plannodes.h, so put it here...*/typedefenumJoinType{/** The canonical kinds of joins according to the SQL JOIN syntax. Only* these codes can appear in parser output (e.g., JoinExpr nodes).*/JOIN_INNER,/* matching tuple pairs only */JOIN_LEFT,/* pairs + unmatched LHS tuples */JOIN_FULL,/* pairs + unmatched LHS + unmatched RHS */JOIN_RIGHT,/* pairs + unmatched RHS tuples *//** Semijoins and anti-semijoins (as defined in relational theory) do not* appear in the SQL JOIN syntax, but there are standard idioms for* representing them (e.g., using EXISTS). The planner recognizes these* cases and converts them to joins. So the planner and executor must* support these codes. NOTE: in JOIN_SEMI output, it is unspecified* which matching RHS row is joined to. In JOIN_ANTI output, the row is* guaranteed to be null-extended.*/JOIN_SEMI,/* 1 copy of each LHS row that has match(es) */JOIN_ANTI,/* 1 copy of each LHS row that has no match */JOIN_RIGHT_ANTI,/* 1 copy of each RHS row that has no match *//** These codes are used internally in the planner, but are not supported* by the executor (nor, indeed, by most of the planner).*/JOIN_UNIQUE_OUTER,/* LHS path must be made unique */JOIN_UNIQUE_INNER/* RHS path must be made unique *//** We might need additional join types someday.*/} JoinType;/** All join-type paths share these fields.*/typedefstructJoinPath{pg_node_attr(abstract)Path path;JoinType jointype;boolinner_unique;/* each outer tuple provably matches no more* than one inner tuple */Path*outerjoinpath;/* path for the outer side of the join */Path*innerjoinpath;/* path for the inner side of the join */List*joinrestrictinfo;/* RestrictInfos to apply to join *//** See the notes for RelOptInfo and ParamPathInfo to understand why* joinrestrictinfo is needed in JoinPath, and can't be merged into the* parent RelOptInfo.*/} JoinPath;
MergePath
/** A mergejoin path has these fields.** Unlike other path types, a MergePath node doesn't represent just a single* run-time plan node: it can represent up to four. Aside from the MergeJoin* node itself, there can be a Sort node for the outer input, a Sort node* for the inner input, and/or a Material node for the inner input. We could* represent these nodes by separate path nodes, but considering how many* different merge paths are investigated during a complex join problem,* it seems better to avoid unnecessary palloc overhead.** path_mergeclauses lists the clauses (in the form of RestrictInfos)* that will be used in the merge.** Note that the mergeclauses are a subset of the parent relation's* restriction-clause list. Any join clauses that are not mergejoinable* appear only in the parent's restrict list, and must be checked by a* qpqual at execution time.** outersortkeys (resp. innersortkeys) is NIL if the outer path* (resp. inner path) is already ordered appropriately for the* mergejoin. If it is not NIL then it is a PathKeys list describing* the ordering that must be created by an explicit Sort node.** skip_mark_restore is true if the executor need not do mark/restore calls.* Mark/restore overhead is usually required, but can be skipped if we know* that the executor need find only one match per outer tuple, and that the* mergeclauses are sufficient to identify a match. In such cases the* executor can immediately advance the outer relation after processing a* match, and therefore it need never back up the inner relation.** materialize_inner is true if a Material node should be placed atop the* inner input. This may appear with or without an inner Sort step.*/typedefstructMergePath{JoinPath jpath;List*path_mergeclauses;/* join clauses to be used for merge */List*outersortkeys;/* keys for explicit sort, if any */List*innersortkeys;/* keys for explicit sort, if any */boolskip_mark_restore;/* can executor skip mark/restore? */boolmaterialize_inner;/* add Materialize to inner? */} MergePath;
HashPath
/** A hashjoin path has these fields.** The remarks above for mergeclauses apply for hashclauses as well.** Hashjoin does not care what order its inputs appear in, so we have* no need for sortkeys.*/typedefstructHashPath{JoinPath jpath;List*path_hashclauses;/* join clauses used for hashing */intnum_batches;/* number of batches expected */Cardinality inner_rows_total;/* total inner rows expected */} HashPath;

Узлы Join
В этом подразделе показаны три узла JOIN: NestedLoopNode, MergeJoinNode и HashJoinNode. Все они основаны на узле JoinNode
JoinNode
/* ----------------* Join node** jointype: rule for joining tuples from left and right subtrees* inner_unique each outer tuple can match to no more than one inner tuple* joinqual: qual conditions that came from JOIN/ON or JOIN/USING* (plan.qual contains conditions that came from WHERE)** When jointype is INNER, joinqual and plan.qual are semantically* interchangeable. For OUTER jointypes, the two are *not* interchangeable;* only joinqual is used to determine whether a match has been found for* the purpose of deciding whether to generate null-extended tuples.* (But plan.qual is still applied before actually returning a tuple.)* For an outer join, only joinquals are allowed to be used as the merge* or hash condition of a merge or hash join.** inner_unique is set if the joinquals are such that no more than one inner* tuple could match any given outer tuple. This allows the executor to* skip searching for additional matches. (This must be provable from just* the joinquals, ignoring plan.qual, due to where the executor tests it.)* ----------------*/typedefstructJoin{pg_node_attr(abstract)Plan plan;JoinType jointype;boolinner_unique;List*joinqual;/* JOIN quals (in addition to plan.qual) */} Join;
NestedLoopJoin
/* ----------------* nest loop join node** The nestParams list identifies any executor Params that must be passed* into execution of the inner subplan carrying values from the current row* of the outer subplan. Currently we restrict these values to be simple* Vars, but perhaps someday that'd be worth relaxing. (Note: during plan* creation, the paramval can actually be a PlaceHolderVar expression; but it* must be a Var with varno OUTER_VAR by the time it gets to the executor.)* ----------------*/typedefstructNestLoop{Join join;List*nestParams;/* list of NestLoopParam nodes */} NestLoop;typedefstructNestLoopParam{pg_node_attr(no_equal, no_query_jumble)NodeTag type;intparamno;/* number of the PARAM_EXEC Param to set */Var*paramval;/* outer-relation Var to assign to Param */} NestLoopParam;
MergeJoinNode
/* ----------------* merge join node** The expected ordering of each mergeable column is described by a btree* opfamily OID, a collation OID, a direction (BTLessStrategyNumber or* BTGreaterStrategyNumber) and a nulls-first flag. Note that the two sides* of each mergeclause may be of different datatypes, but they are ordered the* same way according to the common opfamily and collation. The operator in* each mergeclause must be an equality operator of the indicated opfamily.* ----------------*/typedefstructMergeJoin{Join join;/* Can we skip mark/restore calls? */boolskip_mark_restore;/* mergeclauses as expression trees */List*mergeclauses;/* these are arrays, but have the same length as the mergeclauses list: *//* per-clause OIDs of btree opfamilies */Oid*mergeFamiliespg_node_attr(array_size(mergeclauses));/* per-clause OIDs of collations */Oid*mergeCollationspg_node_attr(array_size(mergeclauses));/* per-clause ordering (ASC or DESC) */int*mergeStrategiespg_node_attr(array_size(mergeclauses));/* per-clause nulls ordering */bool*mergeNullsFirstpg_node_attr(array_size(mergeclauses));} MergeJoin;
HashJoinNode
/* ----------------* hash join node* ----------------*/typedefstructHashJoin{Join join;List*hashclauses;List*hashoperators;List*hashcollations;/** List of expressions to be hashed for tuples from the outer plan, to* perform lookups in the hashtable over the inner plan.*/List*hashkeys;}HashJoin;


