INDEX-ONLY-SCAN PostgreSQL
Среди применяемых в PostgreSQL методов доступа к данным Index Only Scan стоит особняком, считаясь у многих разработчиков "волшебной пилюлей" для ускорения работы запроса.
Index Only Scan может быть выбран в качестве способа извлечения записей в случае чтения запросом только полей, которые присутствуют в самом индексе - его ключах или INCLUDE-списке.
Для поиска необходимой записи Index Only Scan:
- переходит по записям структуры btree-дерева в файле индекса, пока не дойдет до "листа", указывающего на файл таблицы
- проверяет бит "видимости всех записей" нужной страницы с помощью Visibility Map
-
если бит не взведен, ровно как "обычный"
Index Scan, извлекает из файла таблицы необходимую запись, удостоверяясь в ее "видимости" для текущей транзакции (по значениямxmin/xmax)
Далее на конкретном примере мы рассмотрим, как выполняется Index-Only-Scan:
- Определение таблицы tbl:
testdb=# \d tbl
      Table "public.tbl"
 Column |  Type   | Modifiers
--------+---------+-----------
 id     | integer |
 name   | text    |
 data   | text    |
Indexes:
    "tbl_idx" btree (id, name)
- Индекс
Таблица 'tbl' имеет индекс 'tbl_idx', который состоит из двух столбцов: 'id' и 'name'.
- Кортежи
В 'tbl' уже вставлены следующие кортежи:
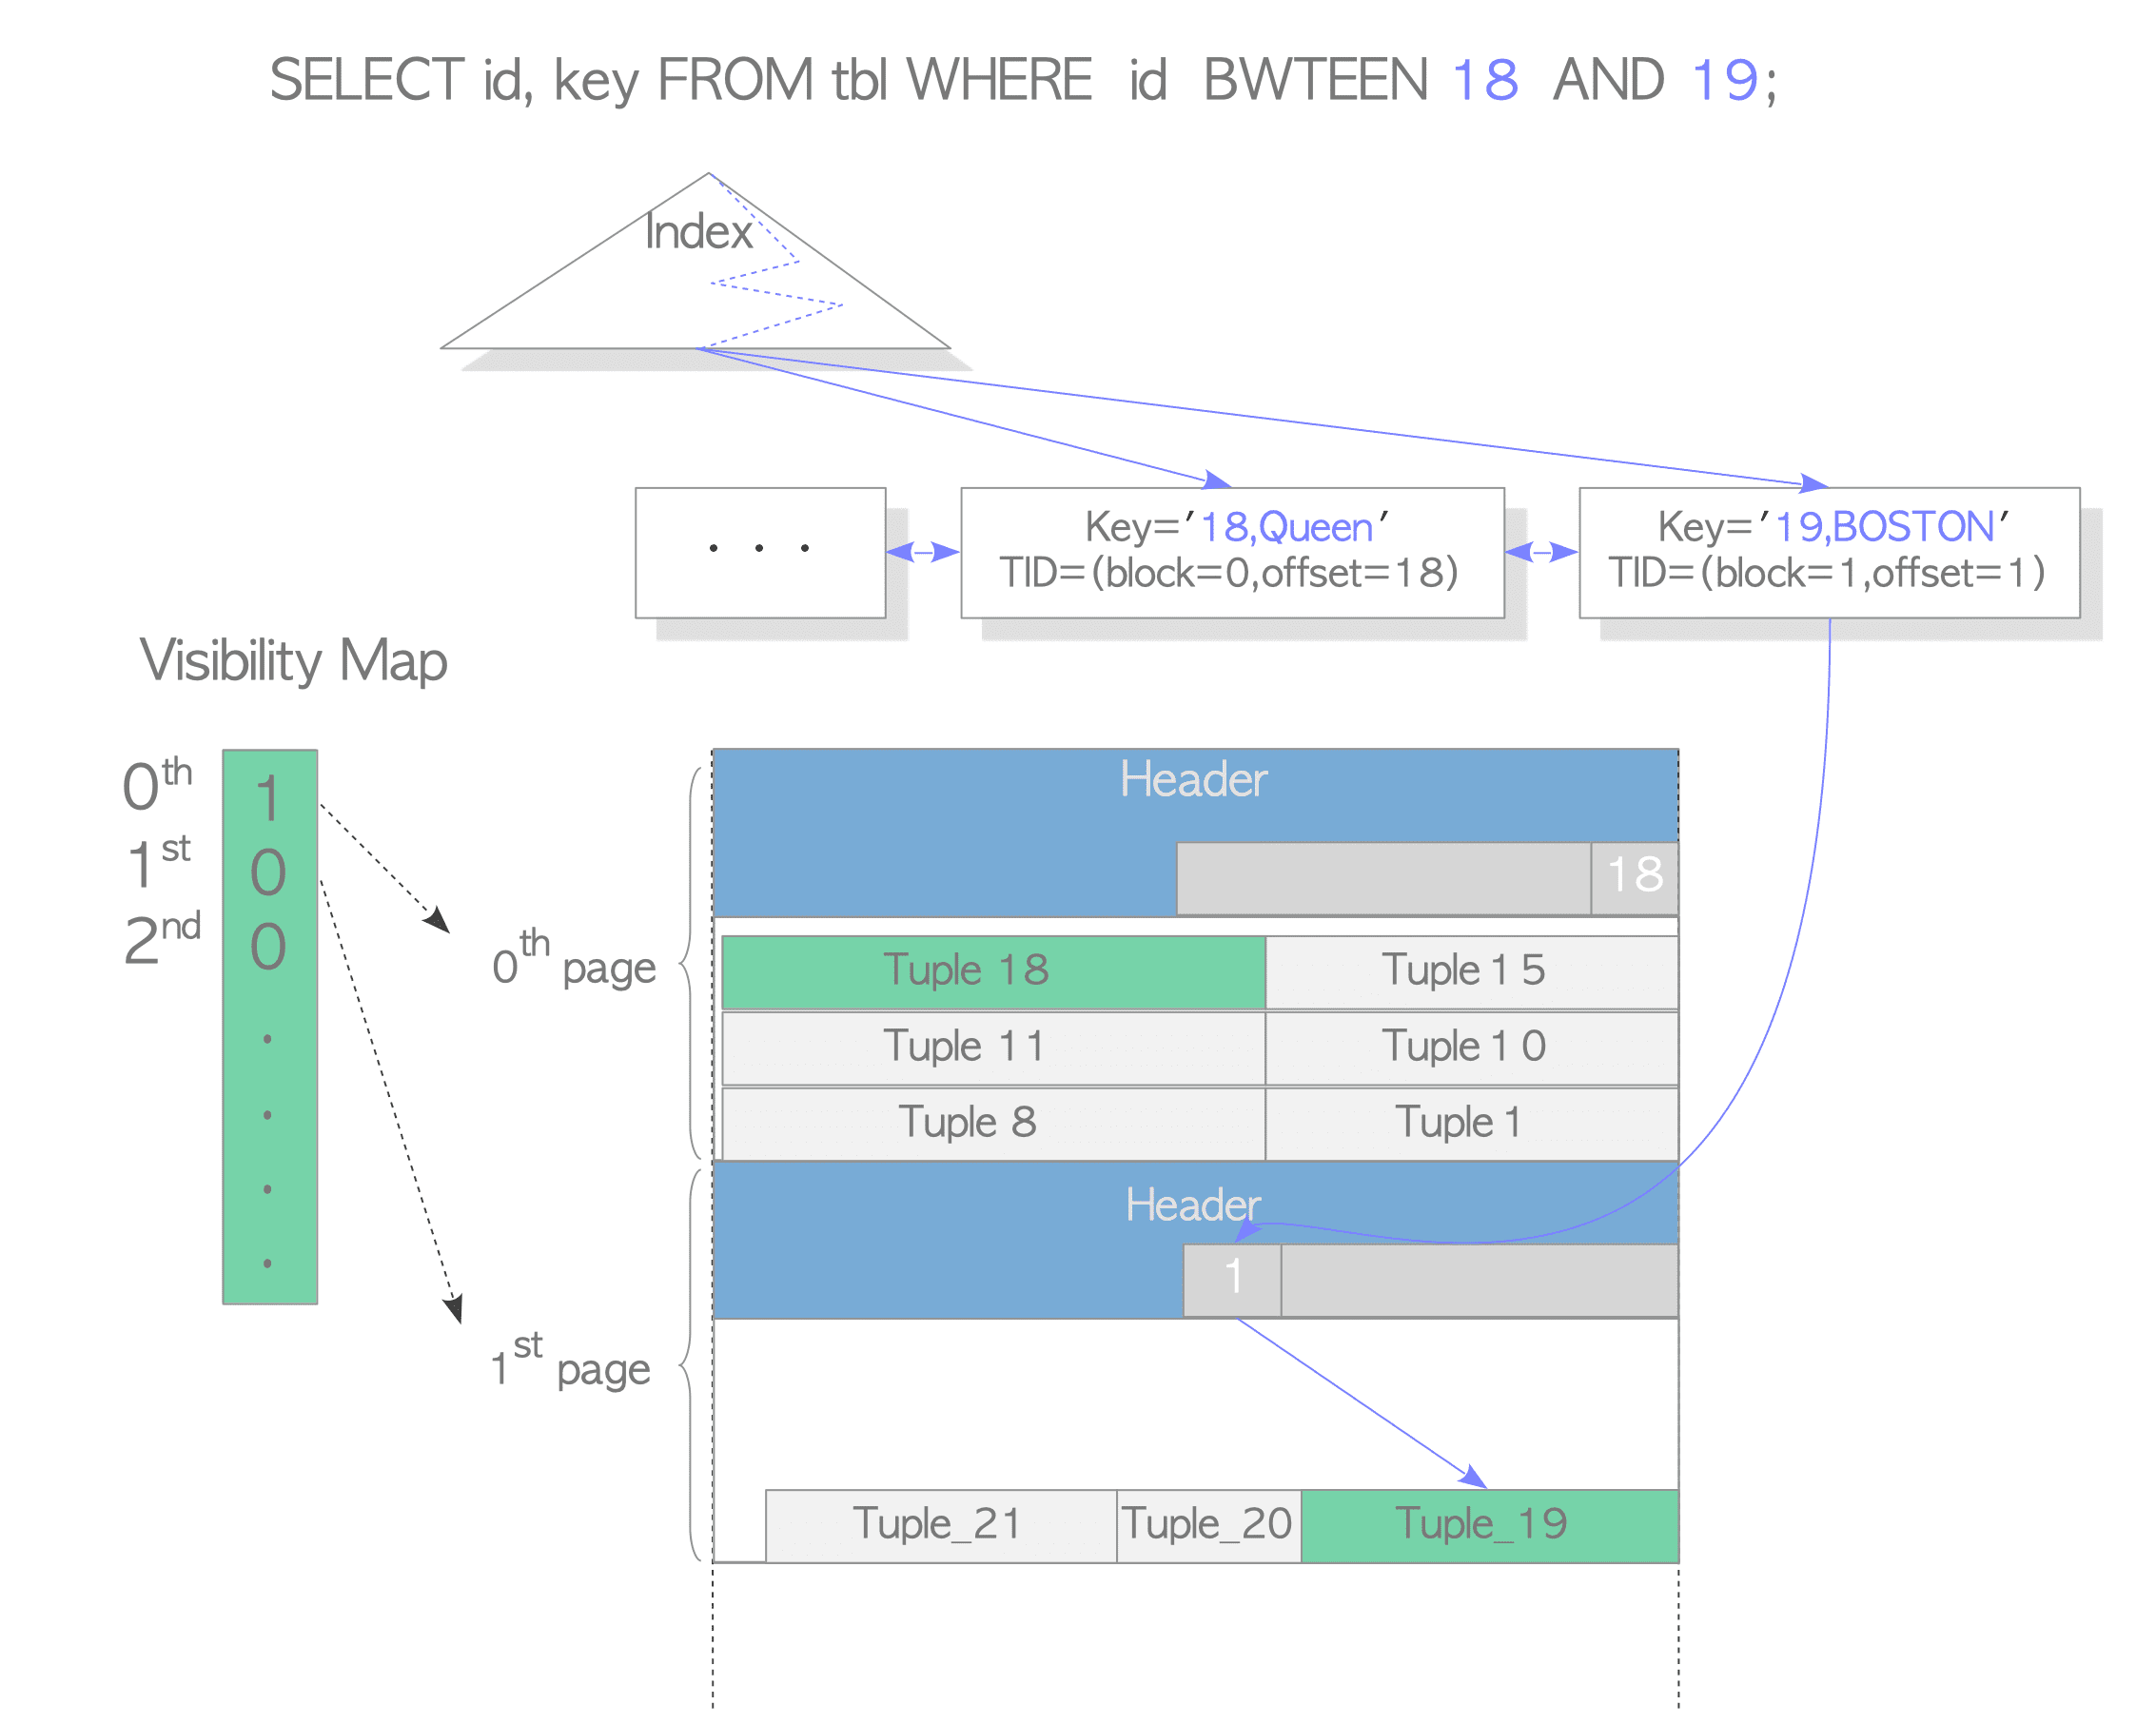
- Tuple_18, идентификатор которого равен 18, а имя - 'Queen', хранится на 0-й странице;
- Tuple_19, идентификатор которого равен 19, а имя - 'BOSTON', хранится на 1-й странице.
- Видимость
Все кортежи на 0-й странице видны всегда; кортежи на 1-й странице не всегда видны. Обратите внимание на то, что видимость каждой страницы хранится в соответствующей карте видимости (VM), описание которой дано в подразделе 6.2.
Итак, как же PostgreSQL считывает кортежи при выполнении команды SELECT:
testdb=# SELECT id, name FROM tbl WHERE id BETWEEN 18 and 19;
id |  name
---+--------
18 | Queen
19 | Boston
(2 rows)
Этот запрос получает данные из двух столбцов таблицы, 'id' и 'name', из которых состоит индекс 'tbl_idx'. Таким образом, на первый взгляд кажется, что обращение к страницам таблицы при использовании индексного сканирования не требуется, поскольку кортежи индекса уже содержат все необходимые данные.
Однако на самом деле PostgreSQL приходится каждый проверять видимость кортежей.
Поэтому для того, чтобы проверить видимость данных, PostgreSQL приходится обращаться к данным таблицы. Это все равно, что поставить телегу впереди лошади.
Чтобы избежать этой дилеммы, PostgreSQL использует карту видимости целевой таблицы. Если все кортежи, хранящиеся в странице, видимы, PostgreSQL использует ключ индексного кортежа и для проверки ее видимости не обращается к странице таблицы, на которую указывает индек,. В противном случае PostgreSQL считывает кортеж таблицы, на которую указывает индекс, и проверяет его видимость, что является обычным процессом.
В данном примере нет необходимости обращаться к Tuple_18, поскольку 0-я страница, на которой хранится Tuple_18, является видимой. То есть все кортежи 0-й страницы, включая Tuple_18, являются видимыми. Напротив, для обработки управления параллелизмом нужно обращаться к Tuple_19, поскольку 1-ая страница невидима. Смотрите рис. 84.