

Предыстория Data Mesh
Обоснование появления концепции Data Mesh
Руководитель одного из моих проектов заявил, что хочет децентрализовать существующую архитектуру платформы данных и сделать данные более доступными в рамках организации.
Когда я услышал о децентрализации архитектуры данных, я даже и не понял, о чем вообще идет речь! Тогда я был не совсем опытным инженером данных, я имел преставление только о централизованных платформах данных и, на мой взгляд, они были достаточно хороши. Поэтому я задался вопросом: «А какую именно задачу мы хотим решить с помощью децентрализованной архитектуры данных?» Или мы впутываем самих себя в какое - то «темное» дело?
Где я начал искать ответы на свои вопросы?
Очевидно, что это была книга «Data Mesh» Жамаха Дегани.
Отличная книга, в которой Вы познакомитесь с организацией, внедряющей эту концепцию и преодолевающей некоторые трудности, связанные с интеграцией совершенно новой парадигмы. Настоятельно рекомендую к прочтению!
Прежде чем выразить свое мнение касательно этой совершенно новой концепции я хотел бы заглянуть в прошлое и проследить за тем, как развивался ландшафт данных с течением времени.
Развитие ландшафта данных
1980-е годы — начало истории
- Появление реляционных БД;
- Организации начинают использовать реляционные БД во всех сферах своей деятельности;
- Базы данных были перегружены транзакционными и аналитическими нагрузками;
Результат - появление хранилищ данных
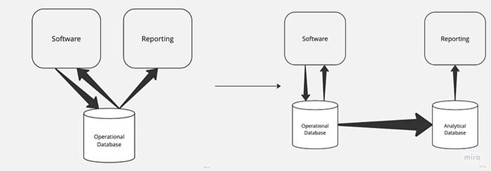
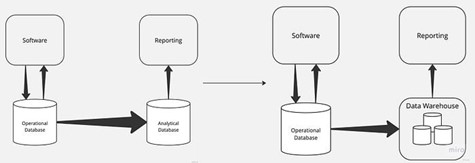
Начало 1990 – х годов — ситуация набирает обороты
- Аналитические нагрузки становятся все более и более серьезными;
- Стремительный рост объема данных;
- Появляется потребность в повышении производительности.
Результат – появление концепции «массово-параллельной архитектуры» (Massively Parallel Processing, MPP)
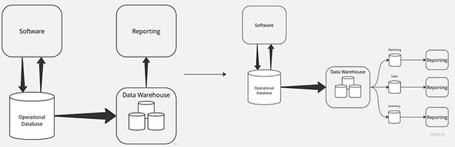
Конец 1990- годов – начало 2000- х годов – Продуктизация
- Отчетность становится одним из приоритетов;
- Архитектура данных становится сложнее;
- Бизнес-подразделениям нужны данные, необходимые для анализа их сферы деятельности.

Результат:
- Компании начали продвигать предварительно сконфигурированные хранилища данных в качестве продукта;
- Появление концепции «витрины данных».
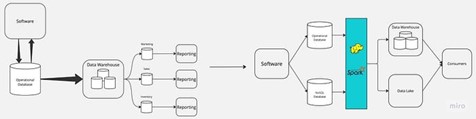
2004 - 2010 гг — Появление гигантов
- Появление новой волны приложений - социальные сети, наблюдаемость ПО и т. д.;
- Появление новых форматов данных — JSON, Avro, Parquet, XML и т.д.
Результат:
- Появление фреймворков Hadoop и NoSQL;
- Для хранения новых форматов данных разрабатываются озера данных.
2010 – 2020 гг – Облачные хранилища данных
- Предприятиям нужна быстрая аналитика данных без ограничений по гибкости, вычислительной мощности и масштабируемости;
Результат:
- Облачные хранилища данных стали идеальным решением для хранения реляционных и полуструктурированных данных;
- Примеры: Amazon Redshift, Google BigQuery, Snowflake, Azure Synapse Analytics, Databricks и т.д.
Так чего же не хватало?
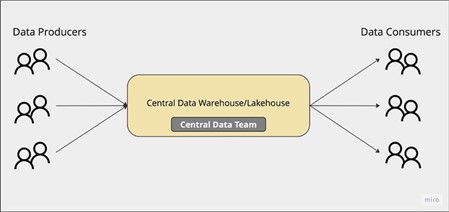
Если мы внимательно посмотрим на поток данных в организации, использующей централизованную архитектуру данных, то увидим, что существует 3 основные «точки соприкосновения» с данными:
- Производители данных;
- Центральная команда по работе с данными;
- Потребители данных
А теперь зададим себе несколько вопросов:
- Кто управляет хранилищем данных?
- Какая команда отвечает на запросы данных?
- Какая команда отвечает за качество данных?
- Какая команда должна стать SME (subject-matterexpert) по данным?
Когда я задал эти вопросы нескольким людей, все они ответили, что это 2 вариант – центральные команды по работе с данными.
Таким образом, основными обязанностями центральной группы по данным являются следующие:
- Управление хранилищами данных;
- Обработка запросов данных;
- Обеспечение качества данных;
- Выполнение функций SME по данным.
И так далее.
Все-таки, чего же не хватало?
По мере развития предприятий растет нагрузка и давление на центральную команду по работе с данными, они должны выполнять огромное количество задач, лежащих в различных плоскостях.
Таким образом, появление децентрализованной архитектуры данных, известной как Data Mesh, вполне обоснованно.
Data Mesh - это децентрализованный гибкий подход к работе распределенных команд и распространению информации. Кроме того, это операционная модель, которая передает право собственности на аналитические данные командам, наиболее тесно связанным с данными, а именно на производителей и потребителей данных.
На мой взгляд, архитектура Data Mesh как нельзя лучше описана здесь:
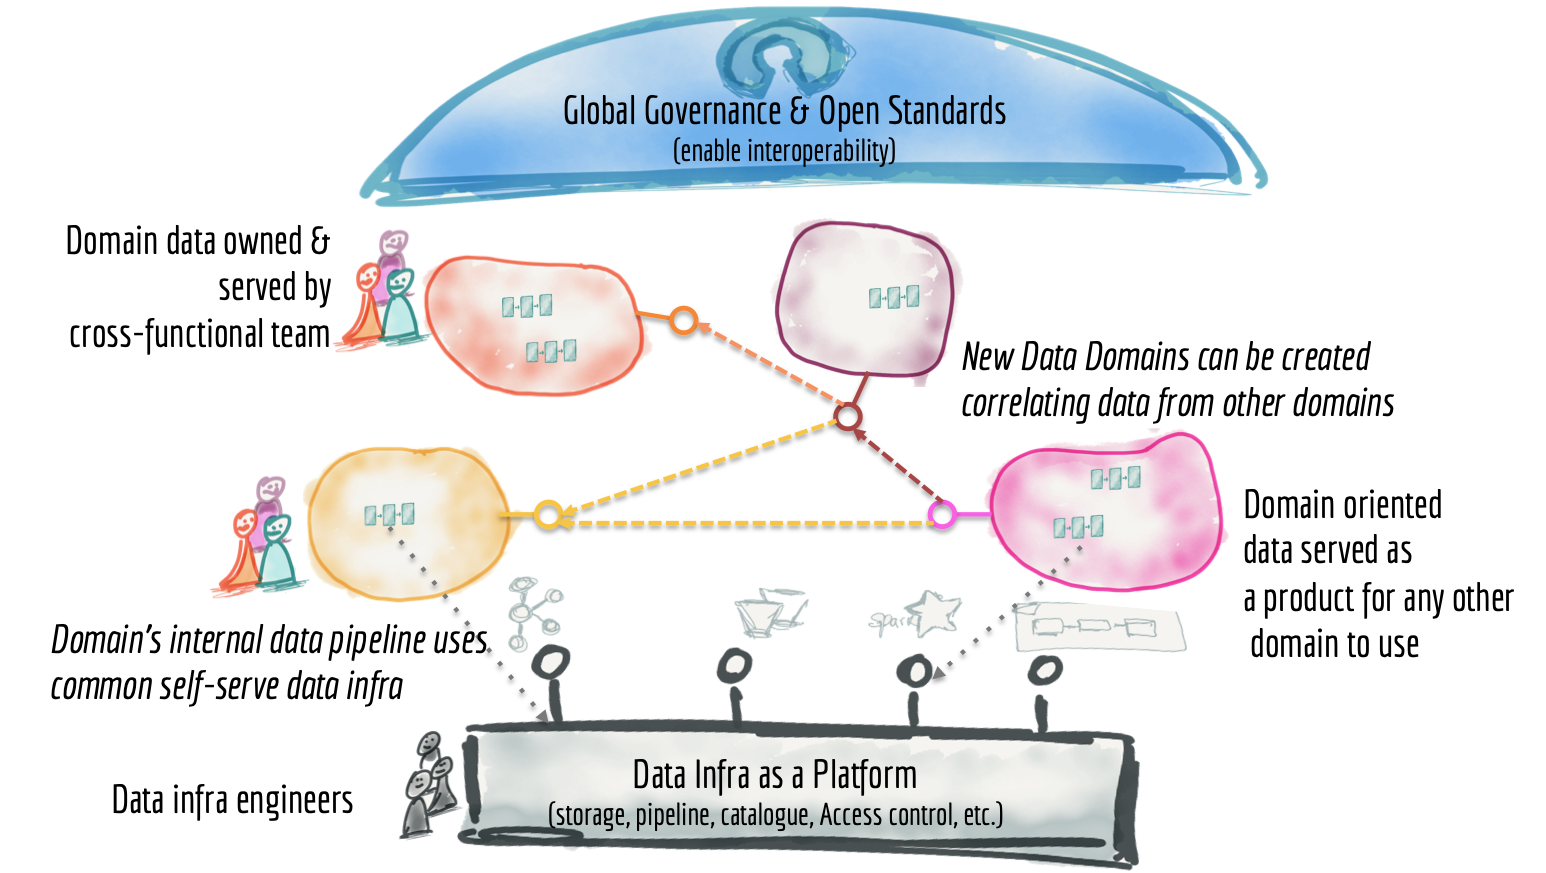
Я не буду углубляться в принципы и логическую архитектуру Data Mesh, так как на эту тему уже написано достаточно много статей. Вот те, которые, на мой взгляд, действительно заслуживают внимания:
Полезные ссылки:
- https://www.oreilly.com/library/view/data-mesh/9781492092384/
- https://martinfowler.com/articles/data-monolith-to-mesh.html
- https://www.snowflake.com/wp-content/uploads/2017/09/Past-Present-Future-DW-FINAL.pdf


