

Процессы извлечения, очистки, контроля и сохранения - ETL\ELT
ETL (Extract, Transform, Load) и ELT (Extract, Load, Transform) - два основных процесса, используемых в хранилищах данных для интеграции данных из различных систем-источников в централизованное хранилище. Оба процесса важны для подготовки данных к анализу и созданию отчетов, но они различаются порядком и местом, где происходит преобразование данных. Понимание того, как работает каждый процесс, особенно в контексте области хранения, имеет решающее значение для эффективного управления рабочими процессами с данными.
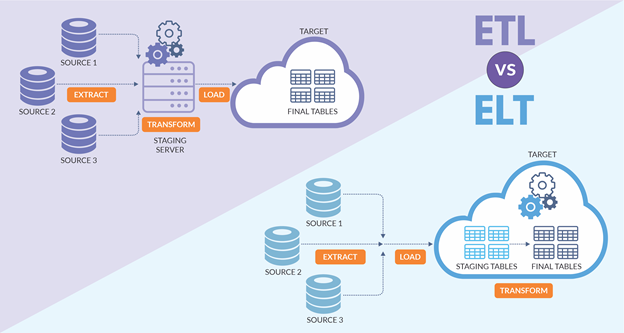
ETL (Extract, Transform, Load)
1. Извлечение
На этапе извлечения данные собираются из различных систем-источников, которые могут включать реляционные базы данных, плоские файлы, API или другие системы хранения данных. Извлеченные данные часто являются необработанными и могут включать структурированные, полуструктурированные или неструктурированные данные. Ключевым моментом является извлечение всех необходимых данных без ущерба для производительности исходных систем.
2. Преобразование
На этапе преобразования, который является следующим в ETL, данные обрабатываются в зоне обработки. Здесь происходит очистка, нормализация, дедупликация, валидация и другие преобразования данных, чтобы подготовить их к загрузке в целевую систему. Преобразования применяются для того, чтобы сделать данные согласованными, надежными и пригодными для бизнес-аналитики и отчетности. Область хранения служит буферной зоной, где эти операции выполняются безопасно, не затрагивая исходные данные.
3. Загрузка
Наконец, преобразованные данные загружаются в хранилище данных или другое целевое хранилище. Этот этап включает в себя запись данных в целевую систему таким образом, чтобы оптимизировать производительность запросов, часто организуя данные в таблицы фактов и измерений с использованием схемы, такой как звезда или снежинка, для облегчения доступа и анализа.
ELT (Extract, Load, Transform)
1. Извлечение
Как и ETL, ELT начинается с извлечения данных из исходных систем. Критерии извлечения аналогичны, основное внимание уделяется извлечению необходимых данных без нарушения исходной среды.
2. Загрузка
В ELT извлеченные данные загружаются непосредственно в хранилище данных или озеро данных без предварительной трансформации. Это означает, что данные загружаются в сыром виде, используя мощные возможности обработки современных технологий хранения данных, таких как Amazon Redshift, Google BigQuery или Snowflake, которые могут эффективно обрабатывать большие объемы данных.
3. Трансформация
В отличие от ETL, трансформация в ELT происходит после того, как данные уже загружены в хранилище данных. Это позволяет выполнять преобразования больших наборов данных, используя мощные вычислительные возможности самого хранилища данных. Данные преобразуются по мере необходимости для конкретных аналитических запросов или отчетности, что обеспечивает гибкость и может быть более эффективным с точки зрения производительности для больших наборов данных.
Выбор между ETL и ELT часто зависит от конкретных требований бизнеса, возможностей целевого хранилища данных, а также характера и объема обрабатываемых данных. ETL традиционно предпочтительнее для сред, где логика преобразования должна управляться централизованно, вне хранилища данных, в то время как ELT подходит для использования высокопроизводительных вычислительных ресурсов в современных хранилищах данных.
Основные различия между ETL и ELT
1. Порядок обработки
ETL: Данные извлекаются из исходной системы, преобразуются на отдельном сервере обработки или в промежуточном ПО, а затем загружаются в хранилище данных. Это означает, что преобразования выполняются до того, как данные попадают в хранилище данных.
ELT: Данные извлекаются, загружаются непосредственно в хранилище данных, а затем преобразуются в самом хранилище данных. При этом для выполнения преобразований используется вычислительная мощность современного хранилища данных.
2. Место преобразования данных
ETL: преобразования происходят в промежуточной зоне хранения данных с использованием отдельных инструментов и серверов ETL. Это может быть полезно, если хранилище данных не обладает мощными вычислительными возможностями.
ELT: преобразования происходят в целевом хранилище данных. Это особенно эффективно в новых хранилищах данных, таких как Amazon Redshift, Google BigQuery или Snowflake, которые предназначены для эффективной обработки огромных массивов данных.
3. Производительность и масштабируемость
ETL: может быть менее масштабируемым, поскольку зависит от производительности сервера ETL. Преобразование данных перед их загрузкой в хранилище данных также может увеличить время обработки, особенно при больших объемах данных.
ELT: обладает высокой масштабируемостью, поскольку использует надежные вычислительные мощности хранилища данных. Это особенно удобно при работе с большими массивами данных, характерными для сценариев больших данных.
4. Сложность и гибкость
ETL: как правило, предполагает более сложную настройку с использованием дополнительных систем для процессов преобразования. Это требует значительных предварительных усилий для определения преобразований.
ELT: Обеспечивает большую гибкость, поскольку данные, загруженные в хранилище, могут быть преобразованы несколько раз различными способами. Это полезно для динамичной бизнес-среды, где аналитические потребности часто меняются.
5. Устаревание данных
ETL: поскольку данные преобразуются перед загрузкой, возможны задержки в их доступности, что может повлиять на устаревание данных в хранилище данных.
ELT: позволяет ускорить доступность данных в хранилище данных, поскольку они сначала загружаются, а затем преобразуются, что позволяет проводить анализ данных в режиме реального времени.
6. Рентабельность
ETL: требует инвестиций в инструменты ETL и потенциально больше оборудования для уровня преобразования, что может увеличить затраты.
ELT: может быть более рентабельным в облачных средах, где вычислительные ресурсы эластичны и могут быть увеличены или уменьшены в зависимости от спроса.
ELT обычно лучше подходит для работы с очень большими объемами данных, поскольку может использовать высокую вычислительную мощность современных хранилищ данных.
ETL может быть предпочтительнее, когда данные необходимо анонимизировать или безопасно обрабатывать перед загрузкой в хранилище, поскольку этап преобразования происходит вне хранилища данных.
Выбор может также зависеть от имеющегося инструментария и опыта. Некоторые организации могут иметь значительные инвестиции в инструменты ETL и квалифицированный персонал, что делает переход на ELT более сложным.
ETL является традиционным подходом и имеет преимущества в средах, где необходимо контролировать процесс преобразования извне или где хранилище данных не может справиться с интенсивными вычислениями. ELT, с другой стороны, использует достижения в области технологий баз данных, предлагая более рациональное и масштабируемое решение, идеально подходящее для приложений с большими данными. Решение о выборе между ETL и ELT во многом зависит от конкретных требований проекта, технологических возможностей и стратегических приоритетов организации.


