

Слои операционного и многомерного хранения данных
Прежде чем погружаться в архитектуру хранилища данных, необходимо точно определить, что такое хранилище данных. Билл Инмон широко известен как "отец хранилища данных" и автор, возможно, самой важной книги по этой теме, "Создание хранилища данных". Он определяет хранилище данных следующим образом:
"Архитектура хранилища данных - это предметно-ориентированный, интегрированный, изменяющийся во времени и независимый сбор данных для поддержки процесса принятия решений руководством".
Предметно-ориентированный
Данные в хранилище организованы по предметам или темам, а не по приложениям или исходным системам, которые генерируют эти данные. Например, все данные о продажах, независимо от того, откуда они поступают, логически организованы и сгруппированы в хранилище данных. Сборка данных по тематическим областям позволяет получить единое представление о предмете - в нашем случае о продажах - а не разрозненные представления из каждой системы.
Интегрированный
Данные из каждой системы-источника (например, CRM, ERP, поведенческие данные или платформы электронной коммерции) объединяются и становятся согласованными в хранилище данных.
Изменяющийся во времени
Данные в хранилище хранятся в течение длительного времени, что позволяет проводить анализ тенденций, прогнозирование, AI/ML и историческую отчетность. Это не просто моментальный снимок текущего момента, а временная шкала данных, которая позволяет предприятиям видеть изменения и развитие событий во времени.
Независимый
Данные, записанные в хранилище, никогда не перезаписываются и не удаляются, обеспечивая стабильность и надежность данных, что очень важно для достоверного анализа. Данные могут быть добавлены в хранилище, но существующие данные, как правило, остаются неизменными.
Архитектура DWH
Архитектуры хранилищ данных обычно состоят из нескольких слоев, каждый из которых предназначен для выполнения определенных процессов, связанных с хранением, обработкой и получением данных. Слои обеспечивают организованный поток данных, облегчают управление, повышают производительность и масштабируемость хранилища данных. Ниже приводится описание общих слоев в типичной архитектуре хранилища данных:
1. ODS (Operational Data Store)
Именно здесь находятся все данные. Он включает в себя различные внешние и внутренние источники данных, такие как оперативные базы данных, внешние каналы данных и плоские файлы.
Основная роль этого слоя - выступать в качестве начальной точки сбора данных перед их очисткой и загрузкой в хранилище.
2. STG (Staging)
Этот слой, также известный как область подготовки данных, служит в качестве временного хранилища данных, поступающих из различных систем-источников.
В области обработки данные подвергаются процессам извлечения, преобразования и загрузки (ETL). Это включает в себя очистку, объединение и реструктуризацию данных, чтобы обеспечить их готовность к интеграции в основное хранилище данных. Область обработки имеет решающее значение для устранения несоответствий данных, стандартизации форматов и исправления ошибок.
3. DDS (Data Detail Store)
Это центральное хранилище, в котором хранятся интегрированные, преобразованные и исторические данные. Обычно оно реализуется с помощью системы управления базами данных.
В основном хранилище данных хранятся данные, организованные в таблицы и схемы, часто с использованием размерных моделей (например, схемы "звезда" или "снежинка") для облегчения эффективного запроса и создания отчетов. На этом уровне данные хранятся в наиболее консолидированном виде, готовые к детальному анализу и бизнес-анализу.
4. DM (Data Mart)
Data Mart – это подмножества хранилища данных, часто предназначенные для конкретных направлений бизнеса или отделов, таких как отдел продаж, финансовый отдел или отдел кадров.
Они предоставляют пользователям доступ к конкретным данным, которые им нужны, улучшая производительность запросов и время отклика пользователей. Витрины ориентированы на пользователя и предлагают более понятный и сфокусированный взгляд на данные по сравнению со всем хранилищем данных.
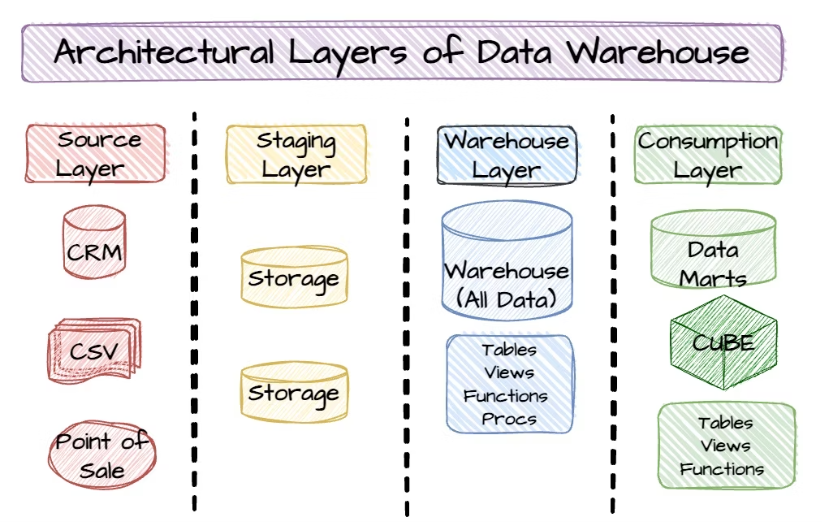
Каждый слой хранилища данных играет важную роль в обеспечении эффективности процессов хранения и поиска данных. Разделив архитектуру на эти слои, организации могут более эффективно управлять сложными интеграциями данных, поддерживать целостность данных и удовлетворять разнообразные аналитические потребности различных отделов. Такой структурированный подход также способствует масштабируемости и адаптации по мере изменения требований бизнеса.
Любая архитектура хранилища данных состоит из архитектурных слоев, процессов ввода и преобразования данных. Эти слои и процессы также опираются на общие компоненты архитектуры данных.
Компоненты архитектуры хранилища данных
ETL и ELT
Извлечение, преобразование и загрузка (ETL) - это процесс, в ходе которого данные перемещаются или преобразуются из источника. Как следует из названия, данные извлекаются из источника, преобразуются и загружаются в хранилище. Подход ETL часто страдает от низкой производительности и проблем с масштабируемостью, потому что процесс перемещает данные из базовой платформы данных. Затем он кропотливо обрабатывает каждую строку за строкой (RBAR). Именно поэтому подход ELT в значительной степени заменил подход ETL. Извлечение, загрузка и преобразование (ELT) - это стандарт для современных архитектур данных. При таком подходе данные извлекаются из источника, загружаются в область хранения, а затем преобразуются. ELT является предпочтительным подходом в современных методологиях хранения данных, таких как Data Vault 2.0 (DV2).
Метаданные
Метаданные - это "данные о данных". Они обеспечивают контекст, смысл и информацию о данных, помогая пользователям понять источник, происхождение, историю и характеристики данных. Они также позволяют инструментам инженерии данных, генеративного ИИ, большим языковым моделям и инструментам бизнес-аналитики быстро преобразовывать необработанные данные в смоделированные. К числу распространенных вариантов использования метаданных относятся моделирование данных, история данных, документация, каталоги, базы знаний и наблюдаемость.
Механизмы запросов
Механизмы выполнения, иногда называемые механизмами запросов, представляют собой вычислительные ресурсы для хранилищ данных и аналитики. Наиболее распространенные механизмы выполнения поддерживают язык структурированных запросов (SQL), который используется для вставки, преобразования и извлечения данных из хранилища. Эффективная обработка SQL-запросов обеспечивает эффективное, точное, масштабируемое и экономичное извлечение данных. Современные механизмы выполнения запросов служат для удовлетворения потребностей инженеров по обработке данных, инженеров-аналитиков и аналитических потребностей предприятий.
Современные облачные платформы данных создали собственные, высокопроизводительные и масштабируемые механизмы выполнения, которые поддерживают преобразование данных и машинное обучение с помощью R, Python и SQL, а также собственных языков запросов, таких как DAX.
Сервисы хранения данных
Сервисы хранения данных являются ядром хранилища данных, где хранятся все консолидированные данные, включая необработанные, поэтапные и смоделированные данные. Они отвечают за хранение, разделение данных, сжатие, репликацию, резервное копирование и восстановление, управление жизненным циклом и целостность данных.


