

Что такое Lakehouse?
За последние несколько лет работы в Databricks мы стали свидетелями появления совершенно новой архитектуры управления данными, которая стала популярной сразу в нескольких организациях, независимых друг от друга – речь идет о LakeHouse. В этой статье мы подробно рассмотрим это новое явление и поговорим о ключевых преимуществах данной архитектуры.
Хранилища данных появились достаточно давно. С момента своего появления на свет в конце 1980-х годов технология хранилищ данных продолжала развиваться, а MPP-архитектуры привели к появлению систем, способных работать с большими объемами данных. Однако хранилища данных были предназначены исключительно для структурированных данных, но со временем многим предприятиям потребовались решения, пригодные для работы с неструктурированными или полуструктурированными данными. Таким образом, хранилища данных были не в состоянии удовлетворить новые потребности.
Когда компании начали обрабатывать большие объемы данных из самых разных источников, архитекторы стали задумываться о создании единой системы хранения всего этого многообразия данных. В результате появились Data Lake, позволяющее хранить данные в их натуральном (RAW) формате, который предполагает одновременное хранение данных в различных схемах и форматах. Хотя данный метод прекрасно подходит для хранения самых различных данных, у него все же есть ряд недостатков:
- в Data Lake не требуется структурировать данные, поэтому их сложнее анализировать;
- Data Lake не имеет инструментов для интегрированного или целостного получения всех данных;
- без квалифицированного контроля трудно гарантировать конфиденциальность и безопасность хранилища;
- если управление Data Lake организовано плохо, в нем быстро накапливаются большие объемы неконтролируемых, и, возможно, бесполезных данных. Для эффективной фильтрации данных и отсечения недостоверных источников требуется высокая квалификация специалистов.
Какое-то время Data Lake вполне отвечали требованиям организаций, но затем и они перестали справляться с изменившимися запросами. Компаниям потребовались более гибкие системы, позволяющие анализировать данные в режиме реального времени и работать с машинным обучением. Распространенным решением стало использование сразу нескольких систем - озер данных, нескольких хранилищ данных и других специализированных систем, таких как потоковые базы данных, базы данных временных рядов и графов. Однако наличие множества систем создало массу непредвиденных сложностей и, что еще важнее, привело к нежелательным задержкам, поскольку специалистам по работе с данными по-прежнему приходилось перемещать или копировать данные между различными системами.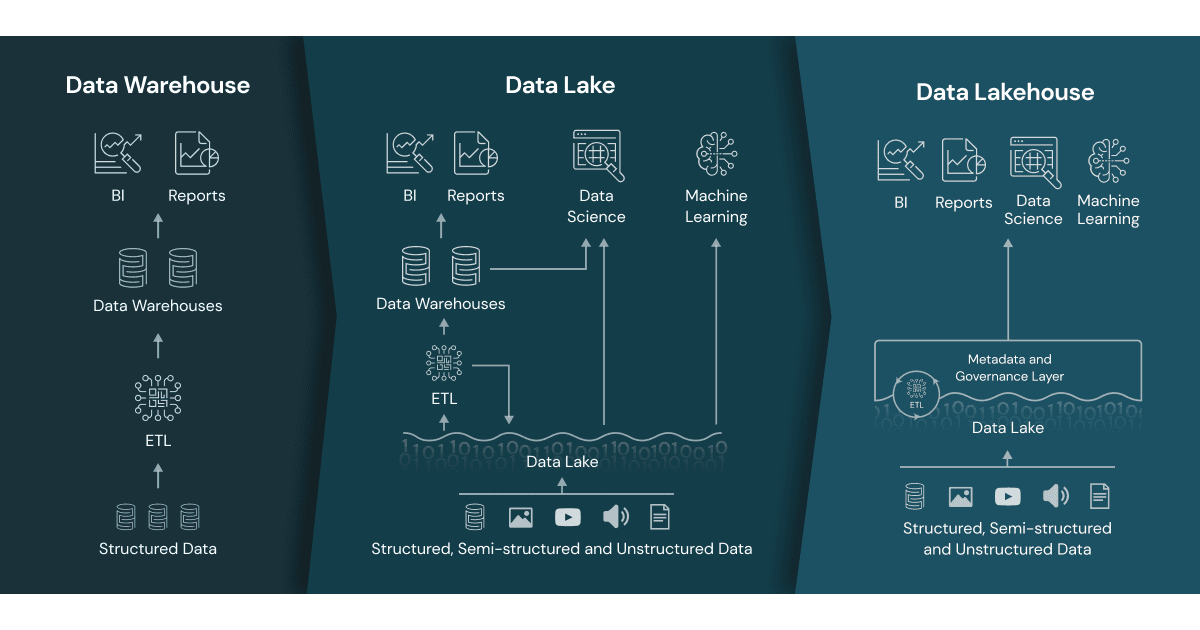
Что такое Lakehouse?
В результате появляются совершенно новые системы, устранившие все недостатки озер данных. LakeHouse - это новая открытая архитектура, которая сочетает в себе лучшие элементы озер данных и хранилищ данных. Lakehouse позволяют реализовать более сложные структуры данных и обладают функциями управления данными, схожими с теми, что используются в хранилищах данных. По сути это усовершенствованные хранилища данных, более надежные и эффективные.
Ключевые характеристики Lakehouse:
- Поддержка транзакций: конвейеры данных способны одновременно считывать и записывать данные. Поддержка ACID-транзакций обеспечивает согласованность, поскольку несколько сторон одновременно считывают или записывают данные, обычно используя популярный инструментарий SQL-запросов;
- Принудительное применение и управление схемой, включая поддержку классических моделей DWH, такие как схемы звезды и снежинки, с обеспечением целостности и полноты данных , а также надежные механизмы управления и аудита;
- Совместимость с BI: Lakehouse позволяет использовать инструменты бизнес-аналитики непосредственно в исходных данных, минимизируя затраты, связанные с необходимостью выполнения операций над двумя копиями данных как в озере данных, так и в хранилище;
- Разделение хранения от вычислений: по разным кластерам, что облегчает масштабирование для большего количества одновременных пользователей и объемов данных;
- Открытость стандартизованных форматов хранения данных, таких как Apache Parquet или Iceberg, которые предоставляют API, поэтому различные инструменты и механизмы, включая ML-системы и библиотеки Python/R, могут эффективно обращаться к данным напрямую
- Многообразие различных типов данных, от неструктурированных до структурированных. Lakehouse можно использовать для хранения, уточнения, анализа и доступа к разным типам данных, включая изображения, видео, аудио, JSON-структуры и текст;
- Поддержка разнообразных рабочих нагрузок, от алгоритмов машинного обучения до SQL-запросов и распределенных вычислений – хотя все эти рабочие нагрузки требуют разных технологий реализации, все они полагаются на один и тот же репозиторий данных;
- Сквозная потоковая передача данных в режиме реального времени.
Это ключевые характеристики Lakehouse, однако, современные корпоративные системы требуют дополнительных функций, в частности, инструменты обеспечения безопасности и контроля доступа к данным. Возможности управления данными, включая аудит и data lineage стали крайне важны, особенно с учетом повышенных требований к конфиденциальности данных. Кроме того, необходимы инструменты, позволяющие обнаруживать данные, такие как каталоги данных и метрики использования данных.

Примеры
Databricks Lakehouse Platform обладает архитектурными характеристиками Lakehouse. Azure Synapse Analytics от Microsoft также являются полноценными Lakehouse. Другие сервисы, такие как BigQuery и Redshift Spectrum, обладают некоторыми из характеристик Lakehouse, перечисленных выше, но в первую очередь они ориентированы на BI и другие SQL приложения. Компании, которые хотят создать и внедрить собственные Lakehouse, могут воспользоваться такими форматами хранения, как Delta Lake, Apache Iceberg или Apache Hudi.
Объединение озер данных и хранилищ данных в единую систему означает, что команды по работе с данными могут работать быстрее, поскольку им больше не нужно обращаться сразу к нескольким системам. Уровень поддержки SQL и интеграции с BI-инструментами в целом достаточен для большинства корпоративных хранилищ данных. Материализованные представления и хранимые процедуры доступны, но пользователям могут потребоваться другие механизмы, отличающиеся от тех, которые присутствуют в традиционных хранилищах данных.
Примечание, касающееся технических строительных блоков. Хотя распределенные файловые системы могут использоваться для хранения данных, в хранилищах данных чаще всего применяются объектные хранилища, обеспечивающие недорогое хранение данных и возможность массового параллельного чтения.
От BI к AI
Lakehouse - это новая архитектура управления данными, которая значительно упрощает инфраструктуру корпоративных данных и ознаменовывает инновационный подход к вопросу хранения данных. Если раньше данные, использующиеся для принятия бизнес-решений, были структурированными то сегодня во многих продуктах используется искусственный интеллект в виде моделей компьютерного зрения, анализа текста и т.д. Почему для ИИ лучше использовать Lakehouse, а не Data Lake? А потому, что Lakehouse обеспечивает версионирование данных, эффективное управление ими, безопасность и свойства ACID, которые важны для неструктурированных данных.
Нынешние Lakehouse позволяют снизить стоимость хранения данных, однако их производительность все еще оставляет желать лучшего. Пользователи могут переходить от одних инструментов (BI-инструменты, IDE, блокноты) к другим, поэтому для того, чтобы удерживать лидирующие позиции Lakehouse должны усовершенствовать свой UX и коннекторы к популярным инструментам. Эти и другие вопросы будут решаться по мере становления и развития новой технологии. Со временем Lakehouse избавятся и от этих недостатков, сохранив при этом простоту в использовании и экономичный подход к работе с данными.


