

DBT: лучшие практики
Безусловно, Вы можете найти в Chat GPT список лучших практик: контроль версий, документация, модулирование, соглашения об именах, тестирование, конфигурации для конкретной среды, планирование и т.д.
Список достаточно полный, но все же не полностью описывает строительные блоки для успешной реализации проекта. Поэтому давайте поговорим о компонентах, которые, на мой взгляд, являются основными.
Присвоение имени и структура модели
Это первый и основной блок, с которым нужно разобраться. При выборе наименования и структуры модели необходимо учитывать как среду разработки, так и производственную среду.
Для среды разработки большое значение имеют наименования и организация папок и файлов. Для производственной среды особое значение имеет то, в какие базы данных добавляются те или иные таблицы.
Прежде чем изобретать велосипед, ознакомьтесь с тем, что уже разработано. У DBT есть набор пакетов, которые Вы можете запросто использовать. Они размещены здесь: hub.getdbt.com. Результатом элементарного поиска в Интернете станет перечень наиболее часто используемых пакетов. Например, если Вы работаете с внешними источниками, такими как salesforce, Вам нужно проверить, какие пакеты поддерживают модели salesforce, например, salesforce_formula_utils. Так что обязательно загляните в getdbt, там Вы найдете сотни уже готовых пакетов.
Макросы
К сожалению, далеко не все, что нам нужно, уже есть, поэтому зачастую нам приходится разрабатывать свои собственные решения. Как и в любом POC, Вы начинаете работать в рамках монолита, а затем стараетесь выйти за его пределы. В нашем случае Вы начнете действовать в рамках проекта, но очень скоро Вам понадобится создать отдельный git-проект для своих собственных макросов и предоставить их в виде пакета.
Конечно, Вы хотите свести к минимуму копирование-вставку данных между проектами, а также ограничить возможность версионирования макросов, которыми Вы делитесь с другими.
Конфигурации для разных сред
DBT обладает на редкость приятным интерфейсом, использующим файлы Profile. Вы должны всегда помнить о том, что безопасность – на первом месте. Ни в коем случае нельзя сохранять в этих файлах конфиденциальную информацию.
DBT подталкивает Вас к созданию двух профилей, одного для среды разработки и второго для производственной среды. Я считаю, что это не совсем целесообразно. Вы же не хотите, чтобы Ваши разработчики что-то изменили в производственной среде по ошибке. Поэтому у Вас должны быть созданы только профили для среды разработки и staging среды, но никак не для производственной среды.
На мой взгляд, только CD может создавать профиль для производственной среды, устанавливая правильные соединения.
Планирование
Планирование и оркестрация процессов - очень важная область, которую DBT еще предстоит освоить. Для запуска моделей DBT предлагает достаточно простую утилиту CLI. Хотя возможности запуска моделей достаточно широки, они все же не совсем отвечают требованиям оптимального производственного решения.
Это означает то, что Вам нужно заранее продумать о том, по какому расписанию Вы хотите запускать свои модели. Вы должны быть уверены в том, что не запускаете модели без необходимости -> например, обновлять модель каждый час, когда она основана на модели, которая обновляется раз в день, очень расточительно.
Есть и другие вопросы, связанные с тестированием данных и транзакциями, которые нужно заранее предусмотреть.
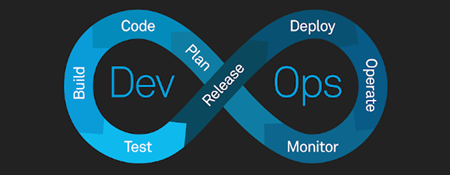
Каждому проекту нужен в цикл тестирования/ci/cd. Проект DBT не исключение. В Вашем проекте должны быть предусмотрены модульные тесты для разрешения сложных бизнес-ситуаций. Существуют различные фреймворки для имитации исходных данных для тестирования моделирования.
Я считаю, что в каждой ветке должны быть запущены все модели, которые были изменены. Все модульные тесты для этих моделей должны быть запущены. Если данных для них слишком много, то Вы можете начать режима просмотра, некоторые постоянные модели можно настроить исключительно для производственной среды.
После соединения кода с main/master необходимо запустить все модели. Это позволит Вам убедиться в том, что все они хорошо работают вместе и что ни один код или пакет не пропал.
Производственная среда
Теперь у нас есть проект, который можно запустить в производство, но как лучше это сделать?
Лучше всего создать образ Docker, содержащий все необходимые модели, пакеты и версию ядра dbt. Даже если Вы используете Airflow или другое решение на базе Python, в котором установлен DBT, не стоит использовать именно установленную версию, в дальнейшем это может привести к нежелательным последствиям. У Вас должна быть возможность выбирать, когда и где Вы можете обновить ядро dbt. Вы можете обновить его только на одном домене и при этом не обновлять на других.
Все пакеты должны быть скачаны заново и установлены в Docker, это позволит сократить время работы моделей, которым перед запуском необходимо загружать пакеты.
Документация
Документация - один из самых сложных аспектов. Большинство специалистов не хотят составлять документацию. С помощью dbt сделать это гораздо проще: документация может быть добавлена как часть исходного кода. Чтобы облегчить себе жизнь, как правило, документация добавляется не только в исходный код, но и на уровне витрин.
Почему документация так важна? Поскольку мы хотим создать самостоятельно обслуживаемую платформу данных, она должна быть максимально понятной, навигация по ней должна быть хорошо продуманной. Именно здесь-то и пригодится правильно составленная документация.
Существует множество решений по оптимизации документации. В частности, можно настроить предварительное одобрение, которое обязывает изучить документацию до фиксации своего кода.
Кроме того, было бы неплохо иметь опцию наследования документов между моделями. Если бы я мог определить документ на поле базовой таблицы, я бы смог увидеть тот же самый текст во всех таблицах, использующих это поле.
Каталог данных
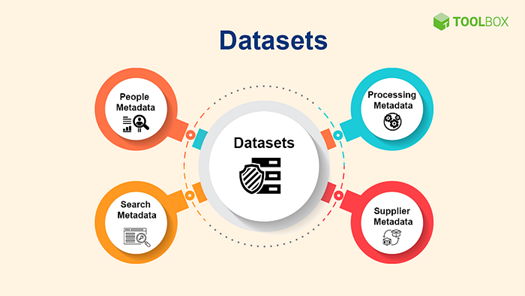
Каталог данных - это относительно новый продукт, появившийся на рынке. На первый взгляд, он выглядит достаточно многообещающе, но если копнуть глубже, то Вы сразу же поймете, что получить действительно полезный каталог, способный принести реальную пользу Вашей компании, совсем непросто. В этом случае dbt опять спешит к нам на помощь, большинство каталогов данных могут импортировать схемы данных DBT, которые также включают в себя data lineage. Кроме того, я также присматриваюсь к datahub, как к достаточно приятному open-source решению.
CLI
Мы рассмотрели несколько лучших практик использования dbt, но пока не поговорили о том, как обеспечить их соблюдение и как облегчить жизнь разработчикам?
Основы CLI - это добавление функциональности в Ваш проект, а также ограничений на то, что с ним можно делать.
Основные принципы работы с CLI заключаются в генерации yaml-файлов и создании новых моделей с правильным наименованием и атрибутами.
Если Вы не хотите создавать полноценное CLI-приложение, начните с dbt power user.
Резюме
Data Build Tool (dbt) стал одним из наиболее популярных решений в области аналитики данных, в том числе и в Израиле. В этой статье мы поговорили об особенностях использования dbt и описали лучшие практики его применения. Поскольку организации все больше признают важность эффективного управления данными и их анализа, статья может послужить руководством по максимально эффективному использованию dbt. Будь то оптимизация рабочих процессов, связанных с обработкой данных, или оптимизация аналитических процессов, лучшие практики, представленные в данной статье, призваны помочь специалистов эффективно использовать dbt для совершенствования процесса принятия решений на основе данных.


