

Закат Druid и восход ClickHouse: опыт компании Lyft
Введение
В компании Lyft для аналитики данных в режиме, близкому к реальному времени, в разные времена использовались различные системы, такие как ClickHouse и Apache Druid. С помощью этих решений можно выполнять запросы с низкой задержкой и высокой пропускной способностью, что особенно ценно для работы с данными временных рядов. Для наших клиентов это означает высокую скорость аналитической обработки данных в режиме реального времени и, следовательно, возможность быстрее ориентироваться в высоконкурентом мире и принимать более взвешенные решения. В первую очередь, это касается таких задач, как прогнозирование рынка и поведения покупателей, для решения которых требуется самая «свежая» информация.
В этой статье мы поговорим о нашем опыте работы с Druid, а также о том, что послужило толчком к переходу на ClickHouse.
Lyft и Druid
Apache Druid - это распределенное хранилище данных с открытым исходным кодом, предназначенное для обработки запросов к данным в режиме реального времени. Druid – это синоним гибкого подхода к исследованию данных, а также быстрой агрегации данных.
Мы начали работать с Druid около шести лет. Изначально он использовался для быстрой обработки геопространственных запросов в режиме, приближенному к реальному времени. Кроме того, с помощью этой системы мы эффективно оптимизировали работу с данными временных рядов.
Druid основан на концепции сегментов. Сегмент - это единица хранения данных, позволяющая выполнять параллельные запросы, хранить данные по столбцам, а также эффективно сжимать и извлекать данные.
Архитектура Druid, используемая в компании Lyft
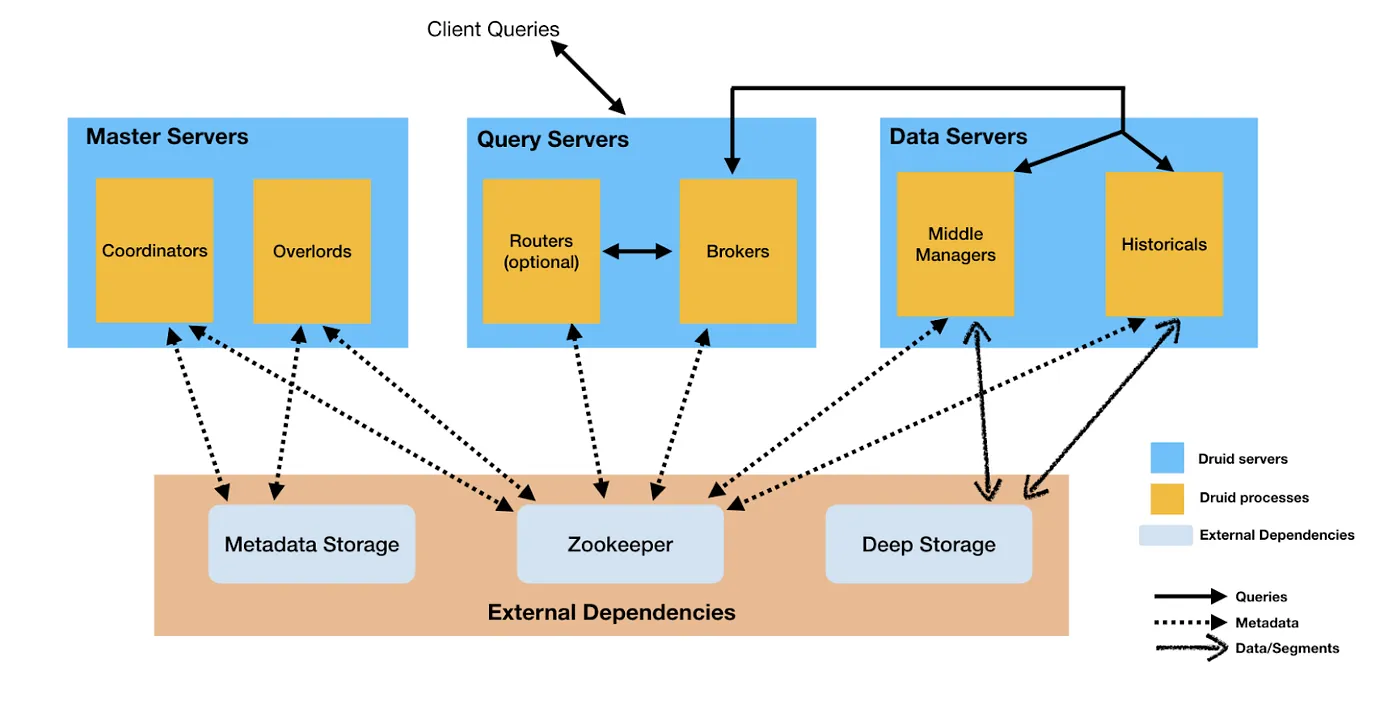
В качестве платформы мы использовали Kubernetes; все процессы, перечисленные выше, выполнялись в подах Kubernetes. Для хранения сегментов мы использовали Amazon S3.
Производительность Druid
Для увеличения производительности работы Druid мы сфокусировались на 2 способах оптимизации работы: rollup и компатификация.
- rollup мы использовали в качестве метода предварительной обработки данных, который агрегирует и уменьшает детализацию данных перед их сохранением в сегментах. Предварительная агрегация данных на этапе их получения помогла оптимизировать производительность обработки запросов и снизить затраты на хранение данных;
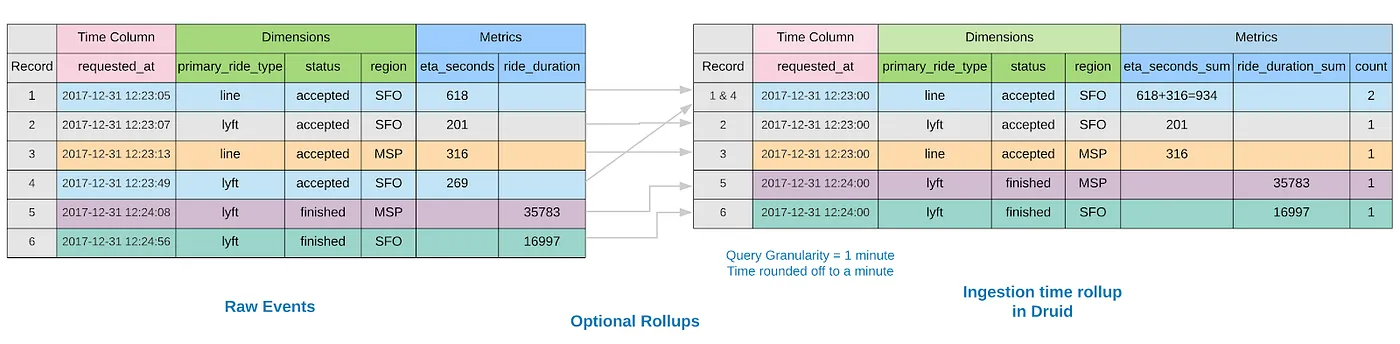
- в процессе компатификации множество небольших фрагментированных сегментов объединяются в меньшее количество оптимизированных сегментов, что еще больше повышает производительность обработки запросов.
Druid: загрузка данных
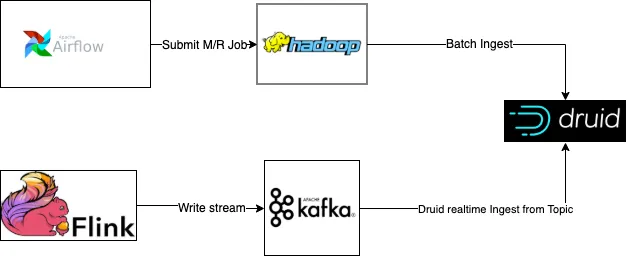
Наш конвейер обработки данных настроен таким способом, что загрузка данных в Druid осуществляется двумя способами – пакетная обработка данных и загрузка данных в режиме реального времени.
Загрузка данных в режиме реального времени
Для обработки больших объемов потовых данных в режиме реального времени мы использовали внутреннее приложение Flink, Kafka и Druid. Это был наш основной способ загрузки информации.
Пакетная обработка данных
Наш конвейер пакетной обработки данных служил в качестве резервного метода ввода данных для выполнения следующих задач:
- Заполнение резервных копий на случай потери данных или простоя системы в режиме реального времени;
- Задачи технического обслуживания, такие как компатификация

Druid: настройка процессов загрузки данных
Для эффективного запуска Druid нужно было обеспечить потоковую передачу данных в наше приложение Flink. Если в этом была необходимость, мы выполняли ряд преобразований для подготовки данных к загрузке в Druid. Затем нужно было определить спецификацию загрузки данных, которая указывала Druid способ, как необходимо обрабатывать загружаемые данные.
В спецификации мы прописывали следующее:
- Схема источника данных: имя, гранулярность запроса / сегмента, временная метка, метрики и т.д.
- ioConfig: информация о сервере Kafka, название топиков (например, tuningConfig)
druid: {
ioConfig: {
taskCount: 3
replicas: 2
taskDuration: PT15M
completionTimeout: PT60M
earlyMessageRejectionPeriod: PT2H
}
tuningConfig: {
intermediatePersistPeriod: PT5M,
maxRowsPerSegment: 15000000
maxRowsInMemory: 500000
resetOffsetAutomatically: true
}
}
kafka {
partitions: 3
}
В каких случаях мы использовали Druid?
Druid использовался для обработки таких важных задач, как работа с моделями ценообразования, маркетинговыми кампаниями (включая анализ их эффективности), а также со способами взаимодействиями с клиентами.
Управление Druid и проблемы, с которыми мы столкнулись
В компании Lyft основными пользователями Druid были дата - инженеры и разработчики ПО. Одной из основных проблем, с которой мы столкнулись при попытках заинтересовать других специалистов, было резкое увеличение объема работ по написанию и сопровождению спецификаций загрузки данных, а также использование различных механизмов настройки для каждого отдельного случая.
Это привело к следующему:
- Обеспечение правильного формата загружаемых данных;
- Исправление последующих конвейеров ввода данных в соответствии с изменениями в предыдущих версиях;
- Создание файлов спецификаций для пользователей, хорошо разбирающихся в семантике Python/SQL, при этом не обязательно владеющих тонкостями работы с Druid
Эти «блоки» затрудняли процесс внедрения Druid в масштабах всей компании. Со временем интерес к этой БД пропал. В первую очередь это было связано с тем, что вложенные инвестиции практически не окупались. Хотя БД по-прежнему была незаменимым помощником для отслеживания расходов и прогнозирования событий в краткосрочной перспективе.
Примерно в это время же Lyft начала более пристально относиться к своим расходам, тестируя различные инициативы по сокращению затрат. Это создало ряд проблем для новых дата – инженеров, им было чрезвычайно сложно адаптироваться к постоянно изменяющейся системе работы с данными. Этот фокус на экономии затрат фактически означал невозможность регулярного обновления версий Druid и их настройку в соответствии с нашими потребностями.
Кроме того, переход Lyft на Kubernetes повлек за собой увеличение трудозатрат команды, поскольку в обновленной системе работало сразу несколько кластеров Druid с большим количеством компонентов.
Учитывая все эти факторы, мы решили сделать шаг назад, пересмотреть свой выбор и постараться понять, могут ли другие технологии справиться со всеми нашими потребностями наиболее оптимальным способом.
Lyft и ClickHouse
ClickHouse – что это?
ClickHouse - это open-source колоночно-ориентированная СУБД для онлайн-обработки аналитических запросов. Одной из отличительных характеристик ClickHouse является ее высокая производительность, обусловленная сочетанием таких факторов, как оптимизированное хранение и обработка данных на основе столбцов, сжатии и индексировании данных.
С чего в нашей компании началась эпоха Clickhouse
В 2020 году, когда команда платформы данных спокойно работала с Druid, ряд наших требований существенно расширился:
- Полученные данные должны быть доступными для запросов в режиме, близком к реальному времени.
- Быстрая загрузка запрашиваемых данных (например, сколько поездок было совершено за последние 2 часа в регионе SF?)
- Поддержка вложенных данных
- Поддержка ввода данных как в режиме реального времени, так и в пакетном режиме
- Встроенная дедупликация данных в месте назначения
Хотя последняя версия Druid в той или иной степени справлялась с несколькими задачами из этого списка, все же были и слабые места. Например, функция дедупликации данных в месте назначения, не поддерживалась. Используя наш существующий стек, мы рассмотрели возможность выполнения дедупликации на потоковом уровне, а не в месте назначения.
Однако мы не стали реализовывать эту идею исходя из следующих соображений:
- Мы хотим дедуплицировать данные между потоковой и пакетной загрузкой.
- Потоковые решения требуют установки окна изменяемости для каждой сущности (например, 24 часа за поездку). Это было жесткое требование со стороны руководства. Кроме того, нам нужно было сделать так, чтобы сущность можно было запросить как можно скорее (например, в конце поездки, если не раньше).
Мы поняли то, что нам крайне важно иметь возможность перезаписывать записи по мере необходимости, используя средства дедупликации. Исходя из всего вышесказанного мы обратили внимание на популярную тогда ClickHouse. Именно она стала тем самым вариантом, который был способен удовлетворить все наши потребности.
Дилемма: ClickHouse или Druid?
Нас поразило то, с какой скоростью ClickHouse справился с поставленными перед ним задачами. Это заставило нас задуматься о следующем:
- Есть ли смысл использовать Clickhouse и в других случаях?
- Можем ли мы «делегировать» задачи Druid ClickHouse?
- Стоит ли продолжать работать с двумя системами или нужно выбрать какую-то одну?
По результатам всестороннего анализа затрат, особенностей управления инфраструктурой, а также других важных аспектов, мы приняли решение о постепенном расширении круга задач ClickHouse «в ущерб» Druid. По нашему мнению ClickHouse превосходит Druid по следующим пунктам:
- Более простая система управления инфраструктурой — в связи с переходом Lyft на более компактную архитектуру было решено выбрать достаточно «неприхотливую» систему в плане управления и обслуживания. Druid, ввиду своей модульной конструкции, не отвечала этому требованию;
- Быстрое обучение персонала - наши специалисты хорошо разбираются в семантике Python и SQL (лучше, чем Java). Таким образом, им будет намного легче определить ключ сортировки и тип движка в определениях объектов с TTL . Они сделают это гораздо быстрее, чем, если бы им нужно было определить эти же параметры в спецификации Druid;
- Дедупликация данных - об этом мы говорили чуть выше;
- Затраты - для Lyft, как компании, использующей вычисления Kubernetes, использование ClickHouse вместо Druid означает сокращение расходов на вычисления;
- Специализированные типы движков ClickHouse - Replicated*, Replacing* и Kafka Engine позволяют Lyft управлять pull-based загрузкой данных в Kafka, а также поддерживать высокую доступность (HA) за счет репликации с несколькими ведущими узлами.
Бенчмаркинг, производительность и миграция
Мы создали тестовый набор для бенчмаркинга и, продолжая обрабатывать запросы в Druid, обеспечили загрузку данных в режиме реального времени/пакетную загрузку данных в ClickHouse. Мы также сравнили производительность работы ClickHouse и Druid.
Мы вовлекли в эти тесты самых заинтересованных пользователей. В качестве опытного образца мы взяли запрос, выполняющийся в нашей производственной системе Druid, и динамически преобразовали его в синтаксис ClickHouse. Затем мы запустили оба запроса в Druid и ClickHouse соответственно и сравнили время ожидания, а также выявили некоторые узкие места в ClickHouse.
В ходе некоторых экспериментов в случае с ClickHouse мы наблюдали ненадежное (скачкообразное, повышенное) время ожидания ввиду использования ключа сортировки таблицы и запроса, приводящего к сканированию всей таблицы. Поскольку форма запроса была постоянной, а запрашиваемые данные можно было предварительно агрегировать, мы решили добавить в ClickHouse проекции.
Проекции - это, по сути, предварительно вычисленные представления Ваших данных, которые считывают только необходимые столбцы. Соответственно, вместо того, чтобы выполнять полное сканирование таблиц, ClickHouse сканирует только лишь один столбец проекции. Благодаря проекциям мы смогли не только повысить производительности обработки запросов, но и существенно сократить объем I/O.
Мы измерили различные показатели, в том числе корректность (по количеству возвращенных строк и разнице точных результатов таблиц) и время ожидания, а также использовали многоуровневую миграцию с переходом на 1%, 5%, 10%, 20%, 50% и затем на 100% в пользу ClickHouse. В итоге мы опять же получили меньшее время ожидания, о чем подробнее расскажем в наших последующих статьях.
В целом миграция прошла достаточно гладко. В ее процессе были задействованы кампании, эксперименты, прогнозы и различные методы расчета затрат. Мы тесно сотрудничали с основными пользователями системы и следили за корректным переводом запросов из Druid в ClickHouse, а также проводили вышеуказанные бенчмаркинг-тесты и анализы производительности. На протяжении всего процесса миграции мы работали над оптимизацией некоторых сценариев использования, для которых время ожидания было чуть выше, чем хотелось бы.
Архитектура ClickHouse, , используемая в компании Lyft
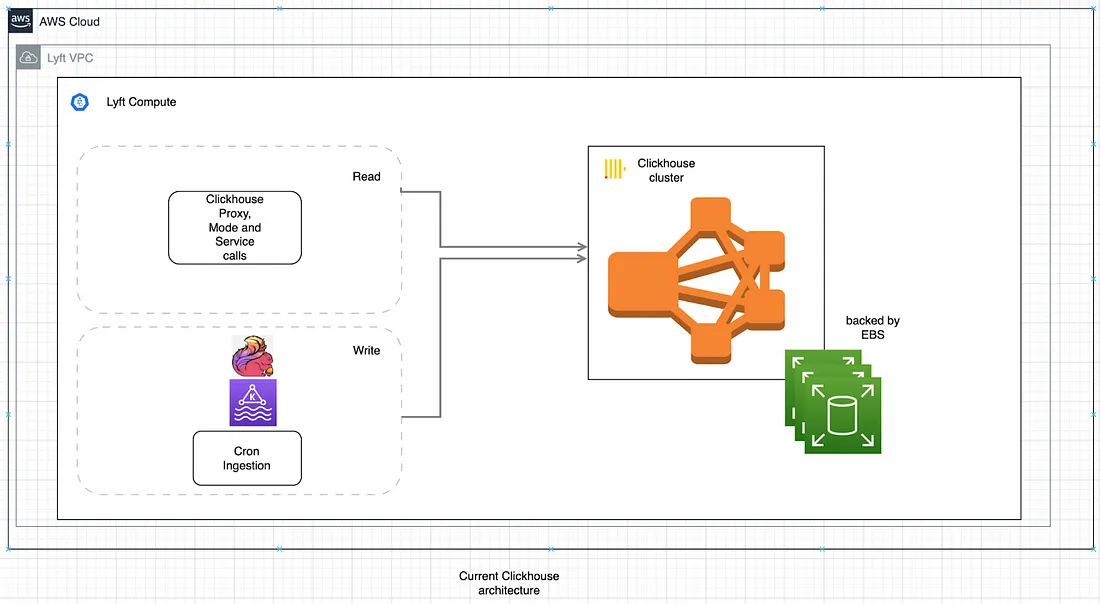
Для развертывания кластеров ClickHouse мы использовали Kubernetes Operator от Altinity. В настоящее время мы работаем c ClickHouse 21.7 и планируем обновиться до самой последней версии. В качестве хранилища мы используем расположенные вместе тома EBS в нашем кластере Kubernetes. Мы запускаем наши кластеры в режиме HA с вычислительными инстансами общего назначения AWS M5-типа, при этом объекты базы данных реплицируются между несколькими узлами. В настоящее время мы не используем шардинг на наших кластерах, но , возможно, в ближайшее время что-то изменится.
ClickHouse: загрузка данных
Для загрузки данных в ClickHouse мы организовали три отдельных конвейеров данных:
- Kafka → ClickHouse: в основном используется нашими службами, работающими по модели pub-sub. В ClickHouse есть встроенная поддержка KafkaTableEngine, которая использует механизм чтения из тем кластера Kafka. Ежедневно из кластера Kafka в ClickHouse поступает около 2 миллиардов записей;
- Kinesis → Flink → ClickHouse: этот механизм используется командами по организации мероприятий, которые регулярно анализируют данные ClickHouse. Lyft генерирует около 600 миллионов строк в день в ClickHouse только за счет использования Flink.
- Trino → Cron → ClickHouse: пакетная загрузка данных из наших автономных систем через Trino. В основном эта схема используется для экспорта наборов данных, полученных в результате анализа состояния рынка.
В дальнейшем мы планируем объединить все наших конвейеры обработки данных и организовать загрузку данных в режиме реального времени только через Kafka. Это упростит архитектуру данных и позволит снизить расходы на ее обслуживание.
Оптимизация запросов в ClickHouse
Ключ сортировки
Ключ сортировки помогает понять, как данные физически организованы на диске, а также ускоряет выполнение запросов. Если данные отсортированы по определенным столбцам, наиболее часто используемым в запросах, то БД будет пропускать нерелевантные данные во время выполнения запроса. Для наших наборов данных, основанных на временных рядах, многие таблицы отсортированы по времени события (event_time или occurred_at time).
Выбор правильного ключа сортировки зависит от типа запросов, которые Вы планируете обработать.
Skip индексы
При обработке запросов, содержащих предложение WHERE, где ключи сортировки не определены, существует риск полного сканирования каждого столбца. Для оценки таких неиндексированных запросов используется Skip индексы, позволяющию понять, какие блоки данных можно пропустить при обработке запроса. В нашей компании для повышения производительности запросов мы в основном используем индексы minmax.
ALTER TABLE <database>.<table> ON cluster <cluster> ADD INDEX logged_at_idx (logged_at) TYPE minmax GRANULARITY 8192
Затем мы материализуем этот индекс на уже существующих данных. Это позволяет ClickHouse пропускать ненужные блоки данных и минимизировать операции ввода-вывода при выполнении запросов, что в разы снижает время ожидания.
Проекции
Одним из главных требований наших пользователей при миграции с одной системы на другую было сохранение или даже снижение времени ожидания. Для решения этой задачи мы использовали проекции ClickHouse, в частности, для предварительного вычисления и хранения последней временной метки мы создали и материализовали проекцию SELECT max(occurred_at). С помощью этой проекции можно сканировать только пару тысяч строк, а не всю таблицу, что ускоряет процесс обработки запроса с ~20 секунд до суб-секунды.
Задачи, которые мы решаем с помощью ClickHouse:
- Отслеживаем состояние рынка
- Составляем отчеты по использованию велосипедов и скутеров
- Отслеживанием расходов
- Составляем прогнозы и отслеживаем рыночные сигналы
- R&D - деятельность
Разрабатываем и анализируем эффективность кампаний
Мы ежедневно обрабатываем миллионы запросов на чтение в ClickHouse, при этом их количество растет в геометрической прогрессии. В месяц это более 25 ТБ данных (чтение и запись).
Сложности работы с Clickhouse
Да, процесс миграции прошел достаточно гладко, но, увы, в обновленной системе есть несколько прорех:
- Производительность кэширования запросов - иногда мы наблюдаем скачки времени ожидания, что затрудняет соблюдение SLA для определенных рабочих нагрузок. Выручает использование кэша запросов с соответствующим размером кэша и TTL. Когда кэш наполняется, производительность запросов может меняться, но скачки времени ожидания при этом очень кратковременны.
- Проблемы с интеграцией MSK - мы активно используем Kafka Table Engine, созданный для потоковой загрузки данных в ClickHouse. В Kafka Table Engine есть схема аутентификации, используемая для SASL, - SCRAM-SHA-256. librdkafka - это библиотека на языке C, используемая ClickHouse для получения данных из Kafka. При попытке получить данные из Amazon Managed Kafka (AWS MSK оказалось, что механизм SASL AWS_MSK_IAM (механизм SASL от AWS) не доступен в librdkafka (Confluent). Одним из возможных решений может стать Kafka Connect / MSK Connect. Проверим сразу после обновления ClickHouse.
- Устойчивость конвейера загрузки данных - наш Flink → ClickHouse основан на модели push. Когда ZooKeeper выполняет разрешение конфликтов, он может пометить таблицу как доступную для чтения, что приведет к сбоям в модели push. Мы хотим протестировать эффективность включения Kafka Connect в ClickHouse и использовать Kafka между Flink и ClickHouse для потоковой записи и хранения данных в Kafka.
Будущее ClickHouse в компании Lyft
На ближайшее время мы выделили три основных направления, которые хотим оптимизировать с помощью ClickHouse:
- Стабилизировать процесс объединения пакетного ввода данных с потоковым вводом Kinesis через Kafka – на данный момент мы работаем над стабилизацией нашей архитектуры пакетного ввода на платформе оркестровки Apache Airflow, широко используемой в Lyft.
- Перенос Flink SQL в ClickHouse - определенные преобразования Flink могут быть выполнены непосредственно в месте назначения в ClickHouse. Мы планируем расширение сферы деятельности ClickHouse, поэтому данное преобразование вполне уместно.
- Отказ от ZooKeeper - в настоящее время мы используем Apache ZooKeeper. В ближайшее время мы хотим обновить ClickHouse и планируем рассмотреть целесообразность перехода на ClickHouse Keeper.
Cегодня ClickHouse отлично справляется со всеми нашими требованиями, и мы с нетерпением ждем новых серьезных вызовов и амбициозных задач!


