

Kafka + NiFi + Clickhouse в Docker
Давайте прокачаем свои навыки работы с Nifi и перейти к другой системе хранения данных.
Представим себя инженерами по работе с большим данным, трудящимися на благо компании, которая управляет несколькими парковками. Используя нужные нам инструменты для работы с Big Data и Apache NiFi, оперативно обработаем данные о въезде/выезде автомобилей с 5 различных парковок и создадим E2E линию данных и отчет. Затем, используя накопленные данные, составим для наших менеджеров и разработчиков красивый дашборд.
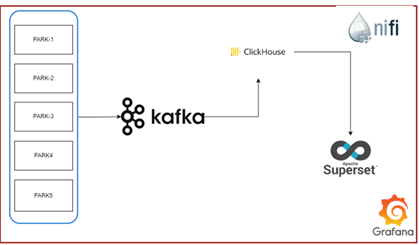
Необходимые условия
- Docker — Docker Compose
- Apache Kafka (потоковая обработка)
- Apache NiFi (инструмент ETL)
- ClickHouse (хранение данных)
- PostgreSQL(по желанию)
- Superset(отчет/дашборд)
- Grafana (мониторинг системы)
- Kafka UI (мониторинг Kafka)

Установка
A. Скрипт генерации данных
Данные, сгенерированные REST API, будут выглядеть так:
class CarPark:
  def __init__(self, City, Plate, Name, Make, Model, Category, Year, ID, TS):
    self.City = City     self.Plate = Plate     self.Name = Name     self.Make = Make     self.Model = Model     self.Category = Category     self.Year = Year     self.ID = ID     self.TS = TS # example api path
@app.route("/park-1")
def createCar2():
    carobj = json.dumps(fake.vehicle_object())     carobj = json.loads(carobj)     days  = random.randint(1, 60)
    hours = random.randint(9, 20)
    minutes = random.randint(0, 59)
    seconds = random.randint(0, 60)
    ts = datetime.now() - timedelta(days=days, hours=hours, minutes=minutes, seconds=seconds)     car = Park.CarPark(         City= fake.city(),         Plate= fake.license_plate(),         Name=fake.name(),         Make= carobj['Make'],
        Model= carobj['Model'],
        Category= carobj['Category'],
        Year = carobj['Year'],
        ID=PARK_2,         TS=ts     )     return json.dumps(car.__dict__, indent=4, sort_keys=True, default=serialize_datetime)
B. Подготовка инфраструктуры
Поскольку мы будем разворачивать разрабатываемые приложения в Docker, нам нужен файл Docker Compose:
version: "3"
services:
  datagenerator:
    build: .
    ports:
      - "5000:5000"
  nifi:
    image: apache/nifi:latest
    ports:
      - "8081:8081"
    volumes:
      - ./nifi/jar:/opt/nifi/nifi-current/ls-target
    environment:
      - NIFI_WEB_HTTP_PORT=8081
  clickhouse1:
    image: clickhouse/clickhouse-server
    hostname: ch1
    container_name: ch1
    ports:
      - "9000:9000"
      - "8123:8123"
    volumes:
      - ./ch1_config/ckeeper_config.xml:/etc/clickhouse-server/config.d/ckeeper_config.xml
      - ./ch1_config/cluster_definition_config.xml:/etc/clickhouse-server/config.d/cluster_definition_config.xml
      - ./ch1_config/external_listen_config.xml:/etc/clickhouse-server/config.d/external_listen_config.xml
      - ./ch1_config/macros_config.xml:/etc/clickhouse-server/config.d/macros_config.xml
      - ./ch1_config/default_grants_config.xml:/etc/clickhouse-server/users.d/default_grants_config.xml
    ulimits:
      nproc: 65535
      nofile:
        soft: 262144
        hard: 262144
  postgres:
    image: postgres:latest
    ports:
      - 5432:5432
    volumes:
      - ~/apps/postgres:/var/lib/postgresql/data
    environment:
      - POSTGRES_PASSWORD=postgres
      - POSTGRES_USER=postgres
      - POSTGRES_DB=postgres
  keeper1:
    image: clickhouse/clickhouse-server
    hostname: keeper1
    container_name: keeper1
    volumes:
      - ./keeper1_config/external_listen_config.xml:/etc/clickhouse-server/config.d/external_listen_config.xml
      - ./keeper1_config/keeper1_config.xml:/etc/clickhouse-server/config.d/keeper1_config.xml
    ports:
      - "9004:9000"
      - "9181:9181"
      - "9234:9234"
    ulimits:
      nproc: 65535
      nofile:
        soft: 262144
        hard: 262144
  grafana:
    image: grafana/grafana:latest
    ports:
      - "3000:3000"
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=123456
  kafka-ui:
    container_name: kafka-ui
    image: provectuslabs/kafka-ui:latest
    ports:
      - 8080:8080
    depends_on:
      kafka:
        condition: service_started
    environment:
      KAFKA_CLUSTERS_0_NAME: local
      KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS: kafka:9092
      DYNAMIC_CONFIG_ENABLED: "true"
  kafka:
    image: bitnami/kafka:3.4.1
    hostname: kafka
    container_name: kafka
    ports:
      - 9092:9092
    environment:
      KAFKA_HEAP_OPTS: -Xmx512m -Xms512m
      KAFKA_CFG_NODE_ID: 0
      KAFKA_CFG_PROCESS_ROLES: controller,broker
      KAFKA_CFG_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      KAFKA_CFG_CONTROLLER_QUORUM_VOTERS: 0@kafka:9093
      KAFKA_CFG_CONTROLLER_LISTENER_NAMES: CONTROLLER
      KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE: "true"
    volumes:
      - ./data/kafka:/bitnami/kafka
Мы добавили в файл docker compose все необходимые системы:
NiFi + Kafka + Kafka UI + PostgreSQL + ClickHouse + Grafana
Запустите файл Docker Compose:
cd Real-Time-Car-Park-Analysis
cd Docker
docker compose up
Если все пройдет успешно, Вы увидите следующее:
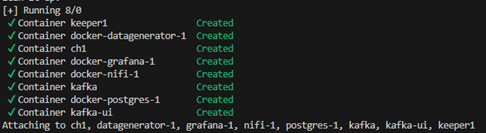
У нас есть все необходимые инструменты, давайте используем их для создания конвейера данных.
C. Создание FlowFile в NiFi
Создание данных
Прежде всего, давайте разберемся, что такое FlowFile и его атрибуты.
Flowfile - это базовый объект обработки в Apache NiFi. Он содержит контейнер с данными и атрибуты данных, которые используются процессорами NiFi для обработки данных. Как правило, контейнер с данными обычно содержит данные, полученные из различных систем-источников.
Часть атрибутов FlowFile представляет собой информацию о самих данных или метаданные.
Создадим наш первый FlowFile.
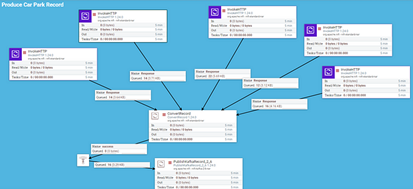
Для получения данных из REST API используем процессор invokehttp:
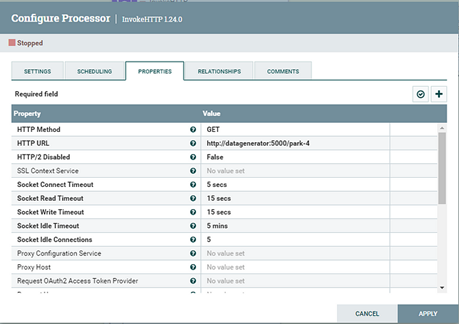
Nifi отправляет GET-запрос по адресу http://datagenerator:5000/park-{1–2–3–4–5}. Мы будем использовать один и тот же адрес для всех API. Затем с помощью процессора ConvertRecord мы преобразуем данные в json-структуру.
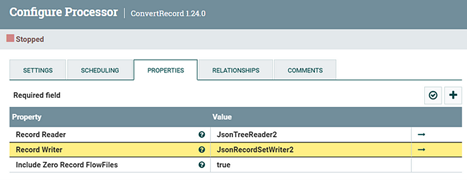
Не забудьте настроить JsonTreeReader и JsonRecordSetWriter.
Наши данные будут выглядеть так:
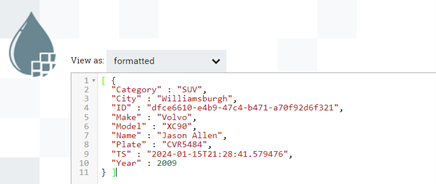
Завершаем создание FlowFile путем отправления готовых данные в Kafka Producer. Для этого выберем процессор PublishKafkaRecord.
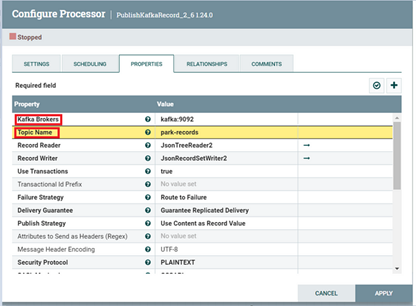
Здесь важен адрес, где находятся kafka IP и kafka topic. Я пишу топики для парковых записей.
Проверяем Kafka
Проверим записи сообщений в Kafka. Перейдите по адресу http://{ваш_ip}:8080/. Вы увидите окно, которое выглядит следующим образом:
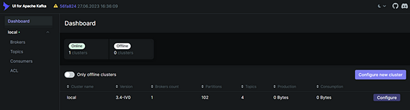
Здесь Вы увидите активные кластеры, доступные топики, количество разделов и т.д.
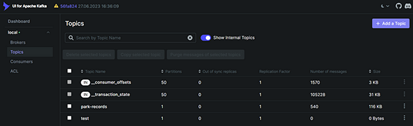
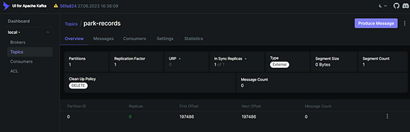
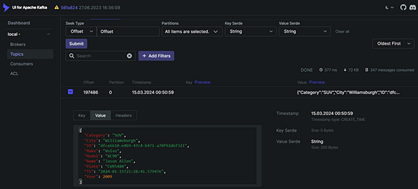
На этом экране можно проанализировать данные, хранящиеся в топиках, просмотреть разделы и активных брокеров, а также изучить типы данных.
Настройки для сервера ClickHouse для Docker-Compose


