

Использование AWS S3 для резервного копирования и восстановления данных Clickhouse
Использование AWS S3 в качестве диска для хранения таблиц также дает нам возможность использовать S3 в целях резервного копирования/восстановления нашей базы данных. Специальная настройка позволит Clickhouse автоматически управлять процессом резервного копирования и восстановления. Давайте посмотрим, как правильно все настроить.

Настройка AWS S3 диска для бэкапов
Чтобы добавить S3 в качестве хранилища резервных копий, добавьте новое хранилище s3.xml file under /etc/clickhouse-server/config.d :
Эта конфигурация указывает диск s3 с заданными учетными данными. Для определения бакета и каталога для сохранения резервных копий укажите <endpoint>. Затем для того, чтобы разрешить использование s3-диска в качестве устройства резервного копирования. Определите блок <backups>. Значение <allowed_path> должно быть таким же, как путь к каталогу из параметра <endpoint> (/backups/ в нашем случае).
Для того, чтобы убедиться, что все работает нормально, перезапустите Clickhouse:
sudo clickhouse restart
Теперь мы готовы приступить к резервному копированию данных в AWS S3.
Резервное копирование таблицы в S3
Для резервного копирования одной таблицы используем следующий запрос:
BACKUP TABLE test TO Disk('s3', 'test_backup.zip')
В данном случае мы создаем резервную копию S3 с именем test_backup.zip. Это займет некоторое время (в зависимости от размера нашей таблицы). Если все прошло нормально, мы увидим следующее:
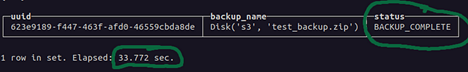
На резервное копирование нашей тестовой таблицы, содержащей 20 млн строк, которая в сжатом виде займет ~200 Мб, ушло 34 секунды. Супер!
Восстановление таблицы
Для восстановления таблицы используем следующий запрос:
RESTORE TABLE test AS test_restored
FROM Disk('s3', 'test_backup.zip')
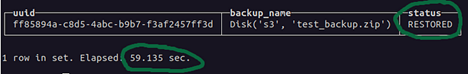
Этот запрос восстановит таблицу из резервной копии test_backup.zip в таблицу test_restored. Мы можем обойтись и без AS test_restored, в этом случае Clickhouse восстановит таблицу непосредственно в тестовую таблицу. Если все прошло нормально, мы увидим следующее:
Резервное копирование и восстановление БД
Вместо того чтобы создавать резервные копии и восстанавливать каждую таблицу по отдельности, мы можем создать резервную копию ВСЕЙ базы данных. Давайте создадим пример базы данных и содержащихся в ней таблиц.
CREATE DATABASE db;
USE db;
CREATE TABLE t1 (id UInt32) ENGINE=MergeTree ORDER BY id;
CREATE TABLE t2 (dt DateTime, msg String) ENGINE=MergeTree ORDER BY dt;
Давайте заполним таблицы t1 и t2 предварительно сгенерированными данными:
INSERT INTO t1 SELECT * FROM generateRandom('id UInt32') LIMIT 1000000;
INSERT INTO t2 SELECT * FROM generateRandom('dt DateTime, msg String') LIMIT 1000000;
Резервное копирование БД
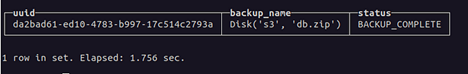
Создадим резервную копию базы данных db на диске S3:
BACKUP DATABASE db TO Disk('s3', 'db.zip')
Восстановление БД из резервной копии
Для начала удалим локальную базу данных db:
DROP DATABASE db;
Теперь из резервной копии S3 db.zip восстановим нашу базу данных:
RESTORE DATABASE db FROM Disk('s3', 'db.zip')
На восстановление нашей БД ушло всего 11 секунд:
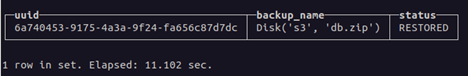
Подтвердим наличие всех восстановленных таблиц:
USE db;
SHOW tables;
┌─name─┐
│ t1   │
│ t2   │
└──────┘
Инкрементальное резервное копирование
В производственных средах в случае огромных БД полное резервное копирование может стать самой настоящей проблемой. А раз мы работаем с Clickhouse, то это именно наш случай – мы работаем с очень большими БД.
Резервное копирование всех данных может занять больше времени, чем хотелось бы. В этом случае на помощь приходит инкрементальное резервное копирование, когда мы создаем резервную копию данных, измененных с момента последнего резервного копирования:
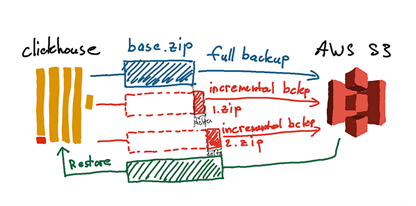
Сначала нужно создать базовую резервную копию (единожды), которая делается как обычная резервная копия:
BACKUP TABLE test TO Disk('s3', 'test-base.zip')
Предположим, что прошло некоторое время, и поступила новая порция данных:
INSERT INTO test
SELECT number + 2000000000, randomPrintableASCII(15), now() - rand32()
FROM numbers(1000);
Для создания инкрементной резервной копии необходимо указать параметры base_backup, - только так Clickhouseп сможет понять, какую именно существующую резервную копию можно использовать для понимания дельты данных:
BACKUP TABLE test TO Disk('s3', 'test-2022-10-03.zip')
SETTINGS base_backup = Disk('s3', 'test-base.zip');
Как Вы можете видеть, последнее резервное копирование заняло гораздо меньше времени, чем предыдущее полное резервное копирование:
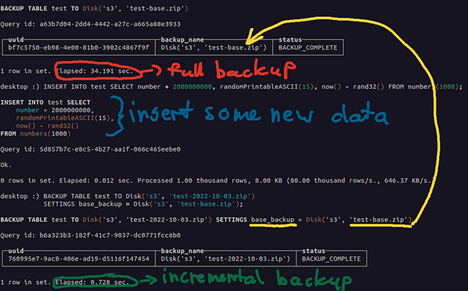
На следующий день (или через какой-то другой определенный период времени) в качестве новой базовой_резервной копии укажите test-2022-10-03.zip, так Clickhouse правильно идентифицирует новую дельту данных:
BACKUP TABLE test TO Disk('s3', 'test-2022-10-04.zip')
SETTINGS base_backup = Disk('s3', 'test-2022-10-03.zip');
Далее процесс повторяется снова и снова - в качестве base_backup для нового файла резервной копии Вы указываете имя предыдущего файла резервной копии.
Восстановление инкрементной резервной копии
Для восстановления таблицы целиком необходимо указать имя файла последней резервной копии, Clickhouse автоматически объединит все дельты:
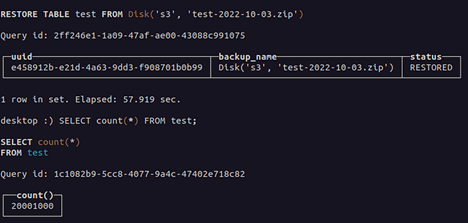
RESTORE TABLE test FROM Disk('s3', 'test-2022-10-04.zip')
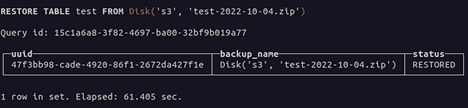
Фактически мы можем восстановить данные из любого снимка инкрементной резервной копии (в том числе, из базового файла):
RESTORE TABLE test FROM Disk('s3', 'test-2022-10-03.zip')
Управление резервными копиями данных
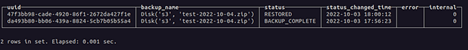
Полный список операций резервного копирования Вы сможете найти в таблице system.backups :
SELECT * FROM system.backups
Мы видим, что в бакете S3 Clickhouse создает следующие файлы:
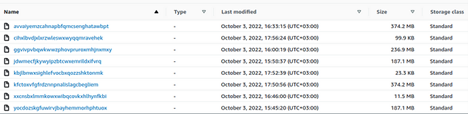
Если Вы используете инкрементальное резервное копирование, не удаляйте эти файлы. В случае полного резервного копирования можно периодически удалять старые файлы – так Вы сможете сэкономить драгоценное место.
Заключение
Clickhouse поддерживает AWS S3 в качестве хранилища для резервных копий данных, которые затем можно будет восстановить. Использование инкрементального резервного копирования позволяет использовать это решение в случае работы с большими объемами данных в производственных средах.


