

ClickHouse + Kafka =
Дайте угадаю, почему Вы здесь. Скорее всего, Вам нужно создать инструмент, который будет собирать данные из разных источников и создавать на их основе аналитические отчеты. Если я не совсем прав, просто продолжите мою мысль, и у Вас обязательно появятся идеи касательно того, как можно обогатить Ваш текущий проект мощным аналитическим инструментом.
На самом деле, эта статья – базовая инструкция по использованию комбинации ClickHouse и Kafka. Вперед!
ClickHouse – к Вашим услугам
Возможно, Вы уже слышали о ClickHouse и Kafka по отдельности. Давайте немного углубимся в эту тему и узнаем, что будет, если мы их объединим.
Что такое ClickHouse? ClickHouse - это колоночно-ориентированная система баз данных, которая позволяет решать аналитические задачи разной сложности.
Построение аналитических отчетов подразумевает работу с большим количеством данных. Clickhouse приспособлена к высокой пропускной способности вставки, поскольку входит в группу OLAP. Речь идет не о множестве одиночных вставок и постоянных обновлений и удалений. ClickHouse допускает и даже требует вставки с большой пропускной способностью, например, миллионы строк за раз. Но он просто обрабатывает обновления или удаления и не более того.
Когда Ваша команда занимается внедрением аналитического сервиса, не забудьте о разработке общего интерфейса для работы с различными источниками данных, а также о разработке стандартов для других команд. В этом Вам могут помочь самые разные готовые решения, представленные на рынке, Вы даже можете создать свой собственный API или шину данных. Не забудьте только о важности соблюдения требований к высокой пропускной способности! Как раз здесь-то Вам и пригодится Kafka.

Kafka
Kafka стал одним из лучших инструментов, представленных в отрасли, потому что он обеспечивает высокую пропускную способность и точность данных, сохраняет порядок записей и при всем при этом работает очень и очень быстро. Кроме того, это отказоустойчивый инструмент, который хорошо масштабируется.
Kafka позволяет разделять различные подсистемы (микросервисы), то есть с его помощью можно сократить количество соединений «все ко всем». Таким образом, система может выступать в роли общей шины данных.
В основном Kafka состоит из хорошо синхронизированной комбинации продюсеров, консюмеров и брокера (посредника).
Как Вы уже могли догадаться, продюсеры создают сообщения для тем брокеров, брокеры хранят эти сообщения и передают их консюмерам.
Консюмеры подписываются на темы и начинают «потреблять» данные. Kafka может хранить сообщения столько, сколько Вы пожелаете, сколько позволяет объем Вашей памяти и сколько позволяют нормативные документы.
Брокер включает в себя множество тем (например, очереди сообщений или таблицы) для хранения различных типов доменных объектов или сообщений - данных о денежных транзакциях, платежах, операциях, изменениях в профиле пользователей и всего, что Вы только можете себе представить.
Среди продюсеров и консюмеров есть еще один элемент под названием Streams, который мы не будем рассматривать в этой статье. Но вкратце скажем, что это опци, которая способна получать данные от продюсеров, анализировать и применять к ним некоторые функции (агрегации и т. д.) в режиме реального времени и затем передавать их консюмерам.
Но что же является главным аргументом в пользу Kafka? Конечно же, поддержка ClickHouse. У ClickHouse есть движок Kafka, который облегчает внедрение Kafka в аналитическую экосистему.
Построение простой системы аналитики платежей
Домен
Придумаем пример сами. Пусть наша модель платежей будет выглядеть следующим образом:
Платеж
(
  id             # => primary key
  cents          # => number of cents that payment holds
  status         # => boolean - can be (cancelled, completed)
  created_at     # => creation timestamp
  payment_method # => some string holding values like Paypal, Braintree, etc.
  version        # => timestamp holding a datetime when a record was pushed to Kafka
)
Движок Kafka
Наш путь начнется с определения таблицы в Clickhouse с помощью Clickhouse Kafka Engine. У Вас уже должен быть настроен кластер Kafka (в этой статье мы используем одноузловую настройку) и Вы должны быть в состоянии указать всю необходимую информацию для подключения определенной темы Kafka к Вашей таблице. Эта таблица не является целевым адресатом для Ваших данных, потому что такую таблицу можно рассматривать как поток данных, и она позволяет читать данные только один раз. Кроме того, она не позволяет делать фоновые агрегации (подробнее об этом позже).
Создадим нужный нам поток данных, который назовем в соответствии с доменными моделями с постфиксом _queue:
CREATE TABLE IF NOT EXISTS payments_queue
(
  id             UInt64,
  status         String,
  cents          Int64,
  created_at     DateTime,
  payment_method String,
  version        UInt64
)
ENGINE=Kafka('localhost:9292', 'payments_topic', 'payments_group1, 'JSONEachRow');
где первый аргумент Kafka Engine - брокер, второй - тема Kafka, третий - группа консюмеров, а последний аргумент - формат сообщения. Например, JSONEachRow означает, что данные представлены разделенными строками с корректным JSON-значением.
Далее нужно разработать механизм, который направит этот поток данных в место, где данные смогут храниться постоянно.
Постоянное хранение и консюмеры
Хранилищ (или таблиц), в которых мы хотим хранить наши данные, может быть несколько.
Первый тип хранилищ данных - это зеркало входящих данных, которое не применяет никаких агрегирующих функций и просто хранит полученные данные как есть. Вы можете спросить: «А зачем нам вообще хранить такие данные в ClickHouse?». Ну, допустим, мы хотим иметь коллекцию надежных необработанных данных, которую можно использовать, например, для безопасного сравнения входящих и сохраненных данных по количеству (так мы сможем убедиться в том, что мы получили все данные, которые были отправлены)
И второй тип - это агрегированная таблица. Но на самом деле одной такой таблицы вполне достаточно, поскольку по одной и той же доменной модели обычно существует несколько аналитических отчетов - некоторым из них нужно чуть больше данных, некоторым – меньше, каким-то нужны преобразованные данные, каким-то нет и так далее.
Здесь-то и приходят на помощь материализованные представления ClickHouse.
Материализованные представления в ClickHouse - это не то же самое, что материализованные представления в различных системах баз данных. По сути, это триггер вставки.
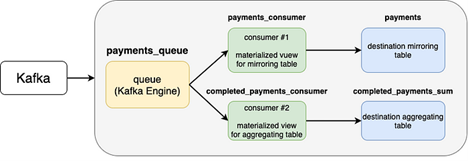
Почему мы не можем писать напрямую в таблицу? Технически мы можем. Но вспомните предыдущий раздел, где мы говорили о том, что нам нужно несколько таблиц для одной и той же доменной модели (зеркальная таблица и агрегированная таблица).
Давайте сначала создадим зеркальную и агрегированную таблицы, а затем соединим таблицу Kafka с нашей конечной таблицей через материализованное представление.
Создание таблиц назначения
Начнем с зеркальной таблицы, которую назовем «Платежи».
Для ее создания используем следующий SQL-запрос:
CREATE TABLE your_db.payments
(
  id             UInt64,
  status         String
  cents          Int64,
  created_at     DateTime,
  payment_method String,
  version        UInt64
)
Engine=ReplacingMergeTree()
ORDER BY (id, payment_method, status)
PARTITION BY (toStartOfDay(toDate(created_at)), status);
Кратко пробежимся по параметрам ENGINE, ORDER BY и PARTITION BY. ClickHouse, в отличие от традиционных СУБД, обладает расширенной функциональностью, которая позволяет нам выполнять некоторые фоновые манипуляции с данными. Например, при использовании движка таблицы ReplacingMergeTree мы можем хранить только релевантные записи, заменяя старые записи новыми. ClickHouse сравнивает записи по полям, перечисленным в ORDER BY, и в случае обнаружения похожих записей заменяет запись с большим значением версии. Версия - это число, которое в основном означает дату создания (или обновления), поэтому более новые записи имеют большее значение версии.
Что касается PARTITION BY, то это параметр, который используется для применения разделения к данным. В нашем случае мы применяем разделение и хотим хранить данные по дням и статусам. После этого мы можем безопасно отсоединять, удалять разделы, фильтровать данные и делать множество других полезных вещей, но это уже совсем другая история.
Переходим к следующему шагу, а именно к созданию агрегированной таблицы, которую назовем completed_payments_sum. В этой таблице мы будем хранить агрегаты платежей, которые будут содержать только завершенные платежи. Позже эта таблица будет отражена в материализованном представлении.
Мы создадим ее с помощью следующего SQL-запроса:
CREATE TABLE your_db.completed_payments_sum
(
  cents          Int64,
  payment_method String,
  created_at     Date
)
ENGINE = SummingMergeTree()
ORDER BY (payment_method, created_at)
PARTITION BY (toStartOfMonth(created_at));
Здесь мы видим совершенно другой механизм. На самом деле это механизм агрегирования, который берет все данные и применяет к ним суммирование. Допустим, у нас есть 10 записей даты с одинаковым payment_method. В итоге у нас будет одна запись с суммой центов и одинаковыми параметрами created_at и payment_method.
Создание консюмеров
Итак, пришло время соединить нашу таблицу Kafka Engine с целевыми таблицами. Как я уже сказал, мы сделаем это с помощью материализованных представлений.
Самый простой пример - создать материализованное представление для зеркальной таблицы платежей.
CREATE MATERIALIZED VIEW your_db.payments_consumer
TO your_db.payments
AS SELECT *
FROM your_db.payments_queue;
Настолько просто, насколько это возможно. По сути, мы получаем все данные из payments_queue как есть и отправляем их в таблицу payments.
Рассмотрим более сложный пример - прикрепление консюмера к таблице completed_payments_sum. Примечание: нам нужно выбрать только завершенные платежи, поэтому нам не нужно сохранять статус в нашей агрегирующей таблице, потому что мы и так храним только завершенные платежи.
Воспользуемся следующим SQL-запросом:
CREATE MATERIALIZED VIEW your_db.completed_payments_consumer
TO your_db.completed_payments_sum
AS SELECT cents, payment_method, toDate(created_at)
FROM your_db.payments_queue
WHERE status = 'completed';
Voilà. Через некоторое время мы получим агрегированные значения по дням для каждого метода оплаты. Так, например, мы мгновенно узнаем сумму, приходящуюся на 21-05-2021-05 и оплаченную с помощью метода Paypal:
SELECT cents
FROM your_db.completed_payments_sum
WHERE created_at = '2021-05-21' AND payment_method = 'Paypal';
Обратите внимание на то, что в данном случае мы не используем sum(cents), поскольку сents сам по себе уже является суммарным значением в таблице completed_payments_sum.
Теперь давайте соберем весь SQL-код воедино:
# creating the queue to connect to Kafka (data stream)CREATE TABLE IF NOT EXISTS payments_queue
(
  id             UInt64,
  status         String,
  cents          Int64,
  created_at     DateTime,
  payment_method String,
  version        UInt64
)
ENGINE=Kafka('localhost:9292', 'payments_topic', 'payments_group1, 'JSONEachRow');
# creating the mirroring payments table that holds raw dataCREATE TABLE your_db.payments
(
  id             UInt64,
  status         String
  cents          Int64,
  created_at     DateTime,
  payment_method String,
  version        UInt64
)
Engine=ReplacingMergeTree()
ORDER BY (id, payment_method, status)
PARTITION BY (toStartOfDay(toDate(created_at)), status);
# creating the aggregating table for the completed paymentsCREATE TABLE your_db.completed_payments_sum
(
  cents          Int64,
  payment_method String,
  created_at     Date
)
ENGINE = SummingMergeTree()
ORDER BY (payment_method, created_at)
PARTITION BY (toStartOfMonth(created_at));
# creating the consumer for the mirroring payments tableCREATE MATERIALIZED VIEW your_db.payments_consumer
TO your_db.payments
AS SELECT *
FROM your_db.payments_queue;
# creating the consumer for the aggregating payments tableCREATE MATERIALIZED VIEW your_db.completed_payments_consumer
TO your_db.completed_payments_sum
AS SELECT cents, payment_method, toDate(created_at)
FROM your_db.payments_queue
WHERE status = 'completed';
Вот, собственно, и все. Теперь Вы можете запрашивать таблицы назначения (платежи и сумму завершенных платежей) и создавать на их основе аналитические отчеты. О некоторых вещах, которые здесь мы не рассмотрели (например, многоузловая (кластерная) реализация, репликация, шардинг и т.д.), поговорим в отдельных статьях. Пишите мне, какая тема Вас интересует, обязательно раскроем и ее!
Мы рады сообщить о новом коннекторе базы данных ClickHouse для потоковой передачи данных CDC (Change Data Capture) в ClickHouse.
Поскольку ClickHouse идеально подходит для приложений, работающих в режиме реального времени, мы создали высокопроизводительный коннектор ClickHouse, использующий CDC, которые можно масштабировать линейно без ущерба производительности.
Если Вы пока еще не очень хорошо знакомы с концепцией захвата изменения данных (CDC), прочитайте о CDC в контексте потоковой передаче данных, - это поможет Вам понять, будет ли для Вас полезен ClickHouse CDC или нет. Это особенно актуально в свете сообщений о приобретении компанией OpenAI компании Rockset, поскольку компаниям очень часто приходится искать разные варианты CDC, в том числе от MongoDB и DynamoDB.
В этой статье мы рассмотрим некоторые основные функции коннектора, а также его влияние на производительность.
Технологии
ClickHouse - это колоночно-ориентированная база данных с открытым исходным кодом, работающая в режиме реального времени. Структура, ориентированная на столбцы, означает, что данные хранятся и извлекаются по столбцам, а не по строкам. Несмотря на сходство с хранилищами данных, ключевым отличием ClickHouse является создание материализованных представлений при записи, что позволяет ускорить выполнение аналитических запросов в разы. Как раз это и делает ее подходящей для использования в режиме реального времени.
Streamkap - это потоковая платформа обработки данных с высокой пропускной способностью, не требующая особого обслуживания. Идеально подходит для тех случаев, когда Вам нужно действовать быстро, при этом экономить средства, а также заручиться круглосуточной поддержкой, использующей такие хорошо знакомые всем нам технологии, как Apache Kafka, Kafka Connect, Debezium и Apache Flink.
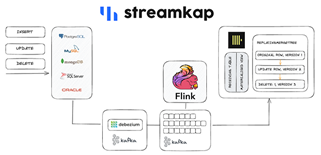
Представляем Вашему вниманию краткий обзор того, как Streamkap осуществляет потоковую передачу данных из базы данных в ClickHouse.
Поддерживаемые типы данных
Наш коннектор поддерживает следующие типы данных:
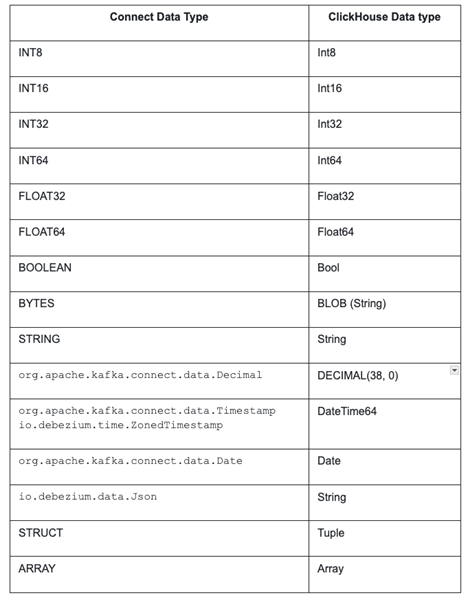
В настоящее время JSON-поля обрабатываются как строки, использование параметра allow_experimental_object_type=1 находится в стадии тестирования.
Режимы Insert/Upsert
Мы поддерживаем ввод данных в таблицы ClickHouse в режимах Insert и Upsert, при этом режим Upsert является режимом по умолчанию для нашего коннектора.
Режим Insert обеспечивает более высокую пропускную способность и сохраняет исторический набор изменений в таблицах ClickHouse.
Режим Upsert не сохраняет исторические изменения и может использоваться только в тех случаях, когда для обновления целевой таблицы можно использовать первичный ключ из источника.
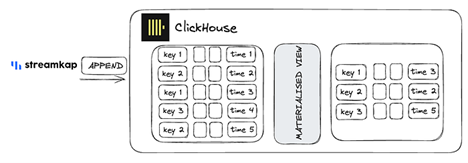
Режим Insert (Append)
При вставке/добавлении каждое изменение отслеживается и вставляется в ClickHouse как новая строка. Операции удаления в источнике будут отмечены с помощью мета-значения как удаленные __deleted.
Для использования режима Insert (Append) используется движок MergeTree.
Режим Upsert
Upsert - это то, к чему Вы, возможно, привыкли. В этом режиме прекрасно сочетаются и вставки, и обновления. Если есть совпадение по первичному ключу строки, значение будет перезаписано. И наоборот, если совпадения нет, событие будет вставлено.
Режим Upsert реализован с помощью движка ReplacingMergeTree .
Данный механизм удаляет дубликаты данных во время фонового слияния на основе ключа упорядочивания, что позволяет очищать старые записи.
Пример Upsert с базовыми типами
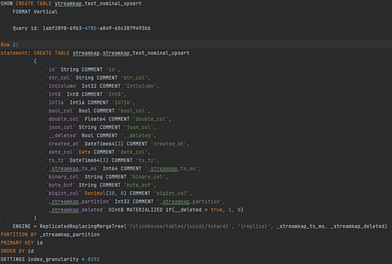
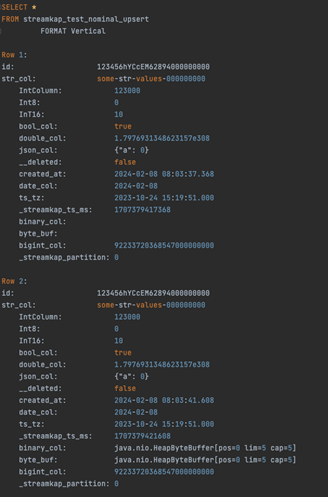
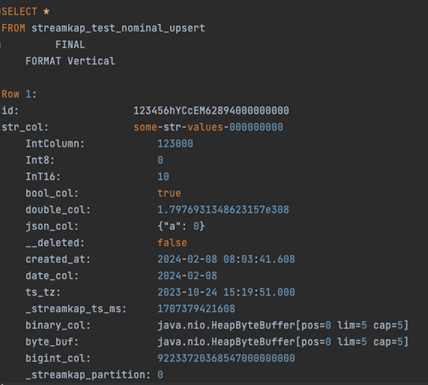
В данном случае Upsert выполнен в формате JSON. Ключ имеет только одно поле `id`, которое является первичным ключом, по которому будут дедуплицироваться строки.
Результирующая таблица:
Данные:
Дедуплицированные данные с использованием FINAL:
Создание моментальных снимков
Создание моментальных снимков - это процесс загрузки существующих данных из базы данных в ClickHouse. Заполнение данных осуществляется с помощью Select, который в отличие от потокового режима считывает данные из журнала базы данных.
По умолчанию Streamkap использует инкрементные снимки. Такой метод подходит для больших таблиц, он практически никак не влияет на исходную базу данных. Благодаря водяному знаку процесс создания моментальных снимков можно возобновить с того места, где он был прерван.
Метаданные
Streamkap добавляет дополнительные столбцы метаданных к каждой вставке в таблицу ClickHouse, что делает анализ данных еще более эффективным.
В каждую таблицу ClickHouse добавляются следующие столбцы метаданных:
- _streamkap_ts_ms: временная метка CDC
- _streamkap_deleted: если текущее событие CDC является событием удаления, то для режима «upsert» для ReplacingMergeTree используется вычисляемый столбец secod streamkap deleted типа UInt8
- _streamkap_partition: smallint, представляющий внутренний номер раздела Streamkap, полученный путем последовательного хэширования ключевых полей исходных записей
- _streamkap_source_ts_ms: метка времени, когда произошло событие изменения в исходной базе данных
- -streamkap_op: тип операции события CDC (c insert, u update, d delete, r snapshot, t truncate)
Работа с полуструктурированными данными
Вложенные массивы и структуры
Ниже мы приводим несколько примеров того, как сложные структуры автоматически переводятся на типы ClickHouse.
Для поддержки массивов, содержащих различные структуры, Streamkap в ClickHouse нужно изменить на следующее значение, а flatten_nested - на 0:

ALTER ROLE STREAMKAP_ROLE SETTINGS flatten_nested = 0;
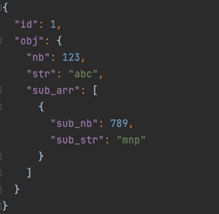
Поле Struct, содержащее подмассив
Здесь показана входная запись в формате JSON, где ключ имеет только одно поле id:
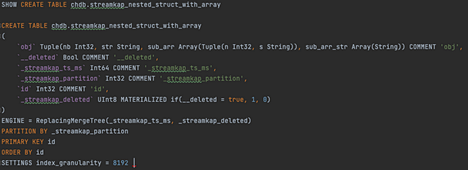
Результирующая таблица. Не видно, как для обработки сложной структуры в `Tuple(nb Int32, str String, sub_arr Array(Tuple(n Int32, s String)), sub_arr_str Array(String)) был отображен столбец `obj` `:
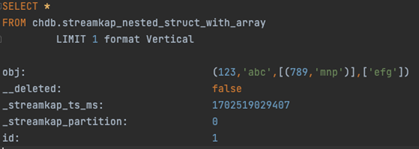
Данные:
Поле вложенного массива, содержащее подструктуру
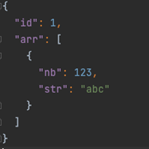
Здесь показана входная запись в формате JSON, в которой ключ имеет только одно поле id:
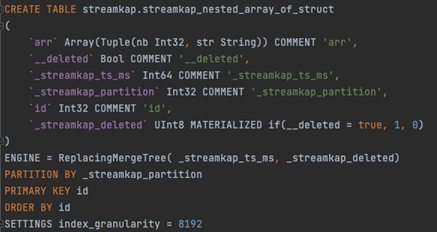
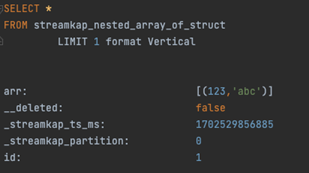
Снова результирующая таблица, в которой столбец `arr` отображен на `Array(Tuple(nb Int32, str String))`.
Данные:
Гарантия согласованности и доставки данных
Streamkap гарантирует доставку данных ClickHouse не менее одного раза и по умолчанию использует режим upsert.
Для режима Insert/Append это может привести к тому, что в ClickHouse будут вставлены дополнительные дубликаты строк, но материализованные представления ClickHouse смогут вовремя их отфильтровать.
В режиме Upsert, используемом по умолчанию, мы выполняем дедупликацию по ключу исходной записи.
Преобразования
Streamkap поддерживает преобразования в конвейере, так что данные могут быть отправлены в ClickHouse уже предварительно обработанными. Это осуществляется с помощью Apache Flink, который считывает данные из темы Kafka (вставляются неизменяемые данные), преобразует их внутри Flink и записывает обратно в новую тему для вставки в ClickHouse.
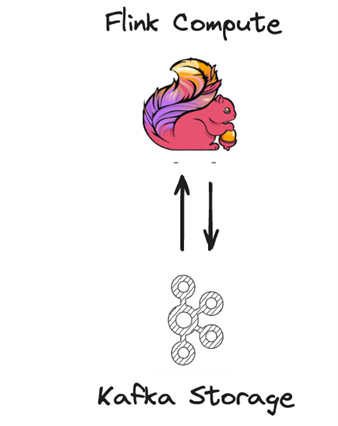
Это особенно полезно для полуструктурированных данных, предварительной обработки и задач очистки. Такой метод может быть значительно эффективнее, чем работа с данными после обработки.
Ниже мы приводим некоторые наиболее распространенные преобразования, выполняемые Streamkap.
Устранение несоответствий в полуструктурированных данных
Рассмотрим исправление несогласованного полуструктурированного поля даты:
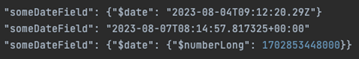
С помощью преобразований Streamkap все записи могут быть преобразованы в один общий формат, подходящий для столбца DateTime64:

Разделение больших полуструктурированных документов JSON
В базах данных документов дочерние сущности могут быть смоделированы как подмассивы, вложенные в документ родительской сущности.
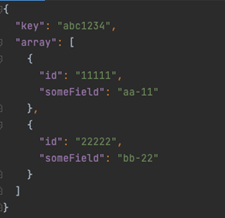
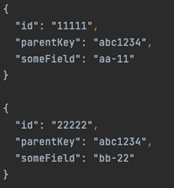
В ClickHouse эти дочерние сущности целесообразно представлять в виде отдельных строк. Используя преобразования Streamkap, записи дочерних сущностей можно разделить на отдельные записи следующим образом:
Эволюция схемы
Эволюция схемы или обработка дрейфа - это процесс внесения изменений в целевые таблицы для отражения исходных изменений, например, добавления/удаления дополнительных столбцов.
Коннектор Streamkap автоматически обрабатывает дрейф схемы в ClickHouse в следующих случаях:
- Дополнительные столбцы: Будет обнаружено дополнительное поле и затем создан новый столбец , предназначенный для новых данных.
- Удаление столбцов: Этот столбец теперь будет игнорироваться, никаких дальнейших действий по отношению к нему предприниматься не будет.
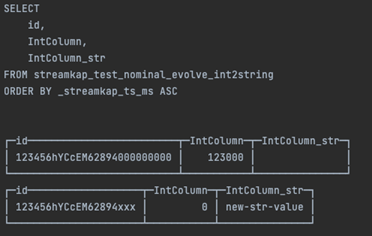
- Изменение типа столбца: В таблице создается дополнительный столбец с суффиксом, обозначающим новый тип, например, ColumnName_type
Дополнительные таблицы могут быть добавлены в конвейер на любом этапе.
Ниже мы приводим несколько примеров такой эволюции схемы.
Добавление столбца
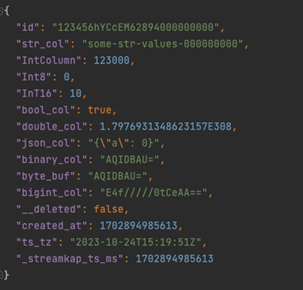
Рассмотрим следующую входную запись до эволюции схемы:
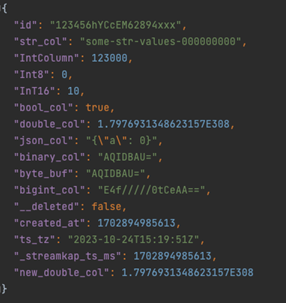
Новый столбец `new_double_col` добавлен в вышестоящую схему, что приводит к изменению схемы ClickHouse:
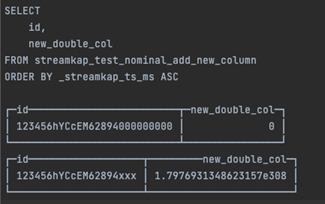
Данные ClickHouse:
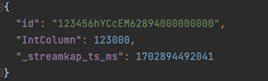
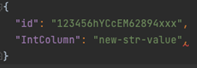
Преобразование Int в String
Входная запись перед эволюцией схемы:
Новая запись попадает в систему :
Данные ClickHouse после добавления нового столбца IntColumn_str:
Производительность
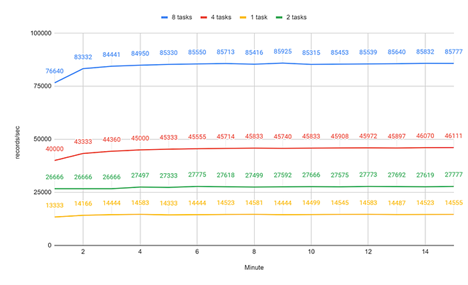
ClickHouse предназначен для использования в режиме реального времени, поэтому мы сделали так, чтобы при увеличении ресурсов наш коннектор мог линейно масштабироваться. Ниже мы продемонстрировали линейную производительность до 85 тыс. записей CDC в секунду в режиме upsert, но мы уверены, что она может масштабироваться настолько сильно, насколько Вам нужно.
Для нашего теста мы использовали экземпляр кластера Clickhouse, состоящего из 3 узлов по 32 Гб каждый с 8 vCPU.
Формат входных записей содержит основные типы, средний размер строки - ~100 символов, большая строка содержит примерно 1000 символов. Мы использовали режим upsert, который по сравнению с режимом insert будет менее производительным.
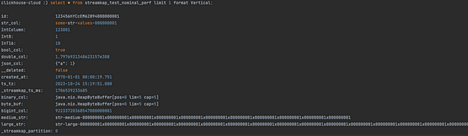
Baseline единичная партиция
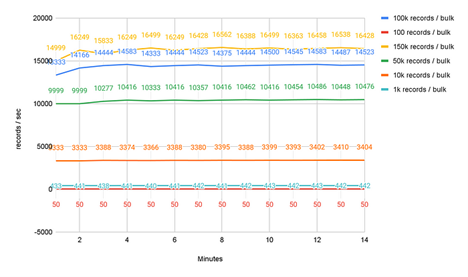
Baseline с одной задачей Streamkap и разделом Clickhouse с несколькими объемами.
Производительность:
Задержка в зависимости от объема:
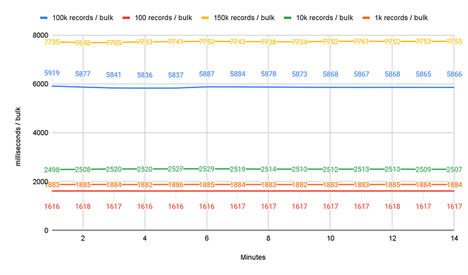
В случае моментальных снимков/обратных заполнений имеет смысл использовать объемы более 100 000 записей, и это автоматически оптимизируется в Streamkap.
Для потокового режима обычно желательно использовать меньшие размеры массива, но это опять же автоматически оптимизируется.
Это лишь некоторые тесты с фиксированным размером массива, проведенные для того, чтобы продемонстрировать компромисс между пропускной способностью и задержкой. На практике размер массива меняется в зависимости от размера внутренней очереди, и Streamkap всегда его автоматически оптимизирует.
Масштабирование
В данном случае мы протестировали 100 000 записей и постепенно увеличивали количество задач: 1, 2, 4 и 8. В результате мы видим, что пропускная способность линейно зависит от количества задач.
Заключение
Streamkap создал самый высокопроизводительный CDC-коннектор для ClickHouse и добавил в него множество полезных функций.


