

Гид по архитектуре MLOps
Успешный проект по машинному обучению - это не просто развертывание работающего приложения, это обеспечение реальной ценности для бизнеса.
Работая над несколькими проектами в области машинного обучения Вы можете заметить, что несмотря на то, что некоторые из них хороши в процессе разработки, они так и не выходят на рынок. Другие проекты доходят до производства, но их нельзя масштабировать. Некоторые проект могут оказаться слишком дорогими, чтобы приносить прибыль после масштабирования.
В обычном программном обеспечении есть DevOps, а у нас есть MLOps. Если Вы хотите добиться успеха в этой областе, Вам нужна оптимальная архитектура MLOps для рабочих нагрузок разработки и производства.
Приведенное ниже изображение, возможно, является самой распространенной диаграммой во всем сообществе MLOps, оно взято из одного из самых цитируемых документов по МО.
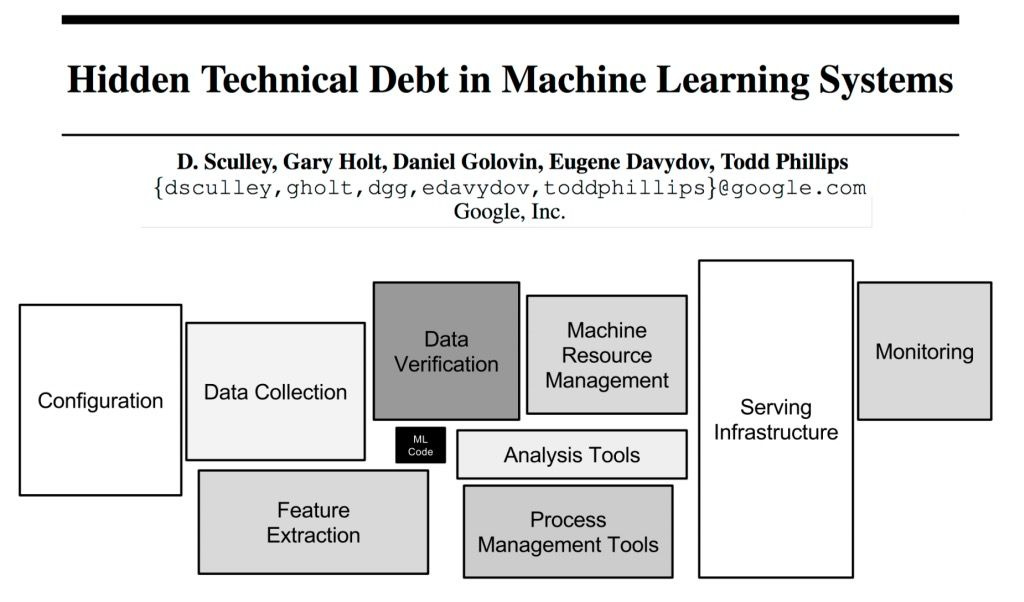
Эта диаграмма говорит нам о том, что системы машинного обучения производственного уровня - это нечто большее, чем просто разработка алгоритмов обучения и написание кода. Умение выбирать и проектировать оптимальную архитектуру проекта - это то, что зачастую позволяет преодолеть разрыв между машинным обучением и операционной деятельностью, и в конечном итоге то, что позволяет оплатить скрытый технический долг в Вашей системе МО.
В этой статье я дам Вам задание разработать оптимальную архитектуру с учетом всех тонкостей бизнес-вопроса/проблемы. Надеюсь, Вам будет интересно!
Реальность систем машинного обучения производственного уровня
Когда речь идет о работе над проектом по машинному обучению, рабочий процесс может быть представлен следующим образом:
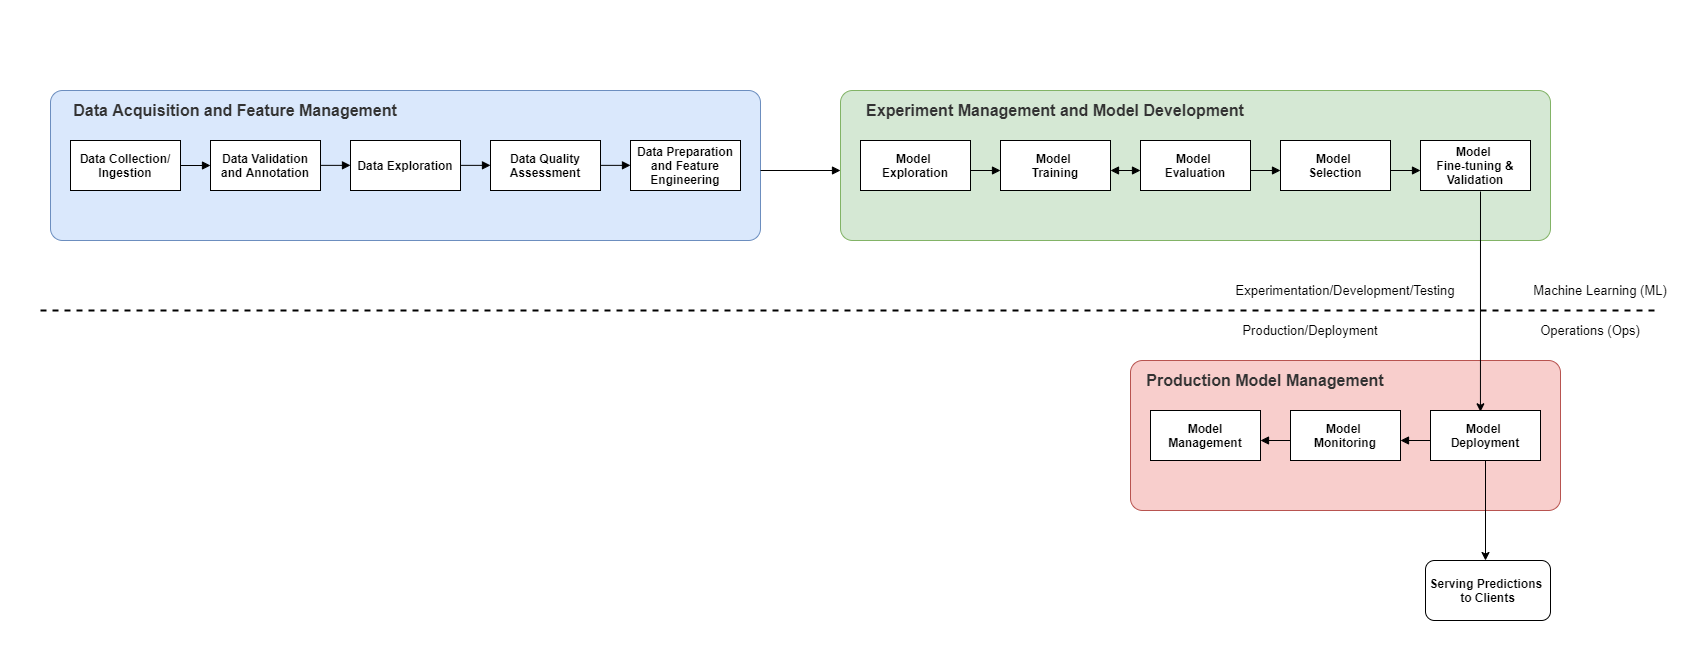
На самом деле, возможно, Вы уже разработали свою собственную модель и хотите развернуть ее в производстве.
Если Вы думаете о жизни за пределами разработок, Вам, возможно, придется все тщательно переосмыслить. Начать стоит с выбора правильной архитектуры.
Как, по Вашему, должна выглядеть архитектура проекта машинного обучения, обслуживающего пользователей в режиме реального времени? Что нужно учесть?
Ниже приведена иллюстрация дополнительных нюансов, которые Вы можете обнаружить при поиске подходящей архитектуры (хотя это и много, но все же не учитывает всего того, что необходимо для создания надежной системы машинного обучения производственного уровня).
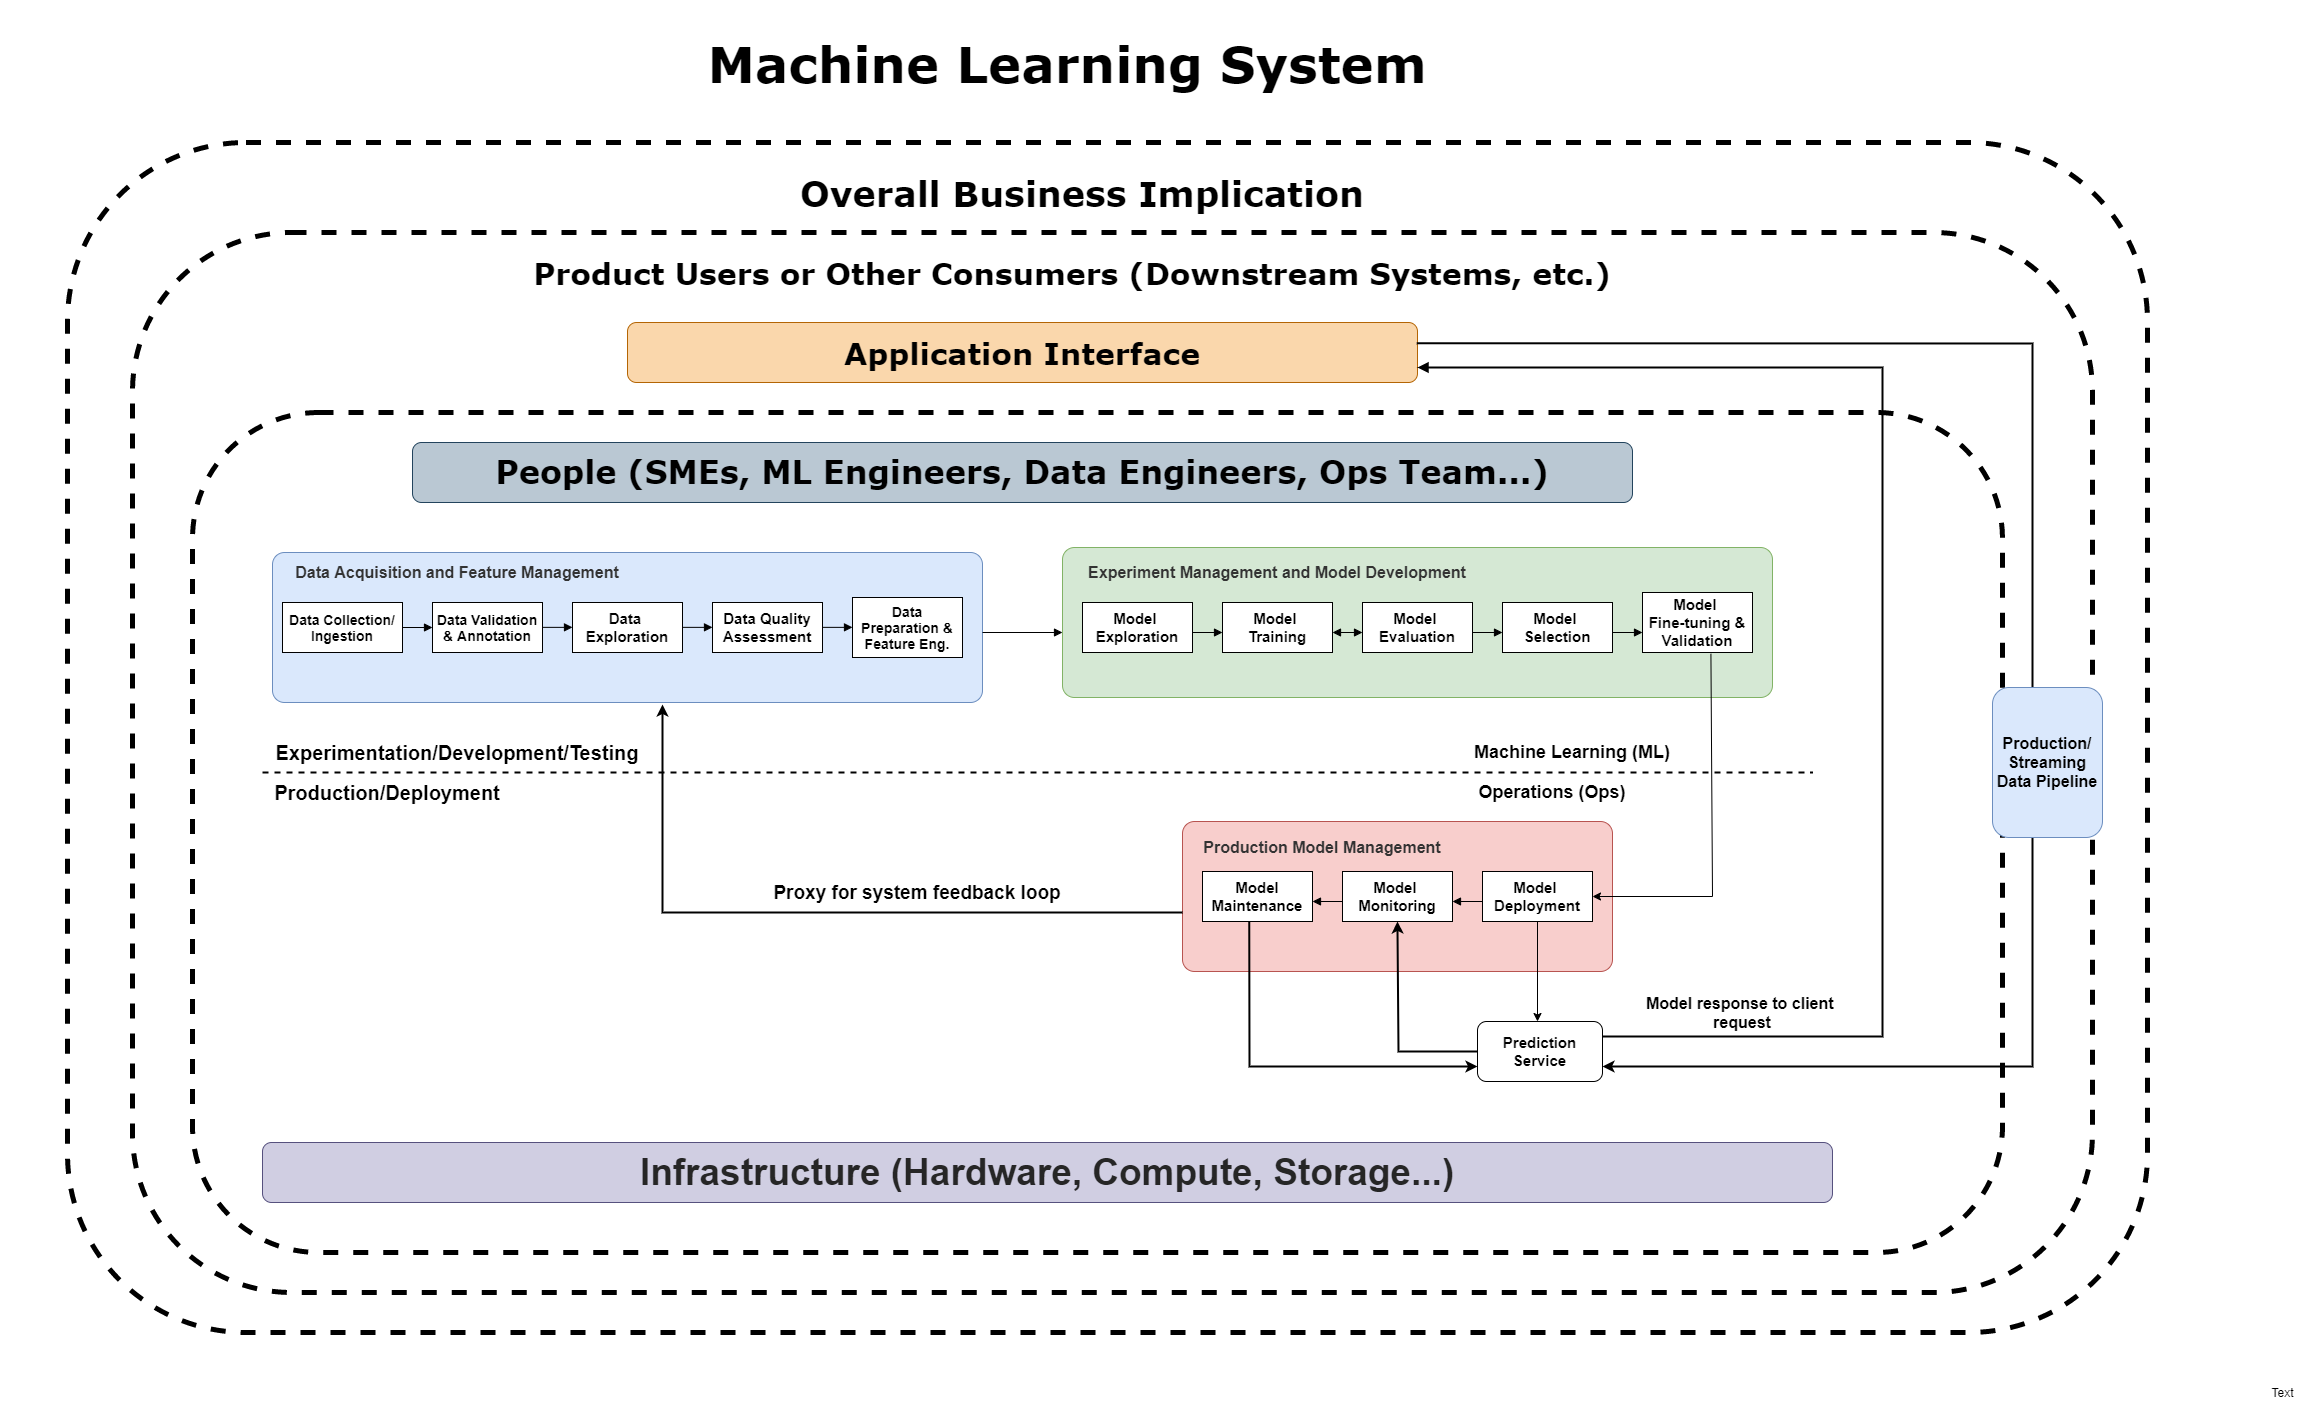
Особенностей, как видите, много! Есть раздел системы машинного обучения (ML) и раздел специальных операций (Ops). Вместе они определяют архитектуру системы машинного обучения.
В распространенных архитектурных паттернах MLOps изменения в архитектуре происходят как на этапе ML, так и на этапе Ops, где у Вас могут быть различные паттерны разработки и развертывания, которые зависят от проблемы и данных. В следующем разделе мы рассмотрим общие архитектурные паттерны MLOps для систем ML.
Общие архитектурные паттерны для MLOps
Как Вы видели на примере (довольно) сложного представления системы машинного обучения, представленного выше, MLOps - это машинное обучение и операции, смешанные вместе и работающие поверх инфраструктуры и ресурсов.
Архитектурные паттерны в MLOps связаны с дизайном обучения и обслуживания. Архитектуры конвейеров данных часто тесно связаны с архитектурами обучения и обслуживания.
Архитектурный паттерн разработки/ тестирования модели машинного обучения
На этапе обучения и тестирования моделей ML архитектурные решения часто основываются на типе входных данных и решаемой проблеме.
Например, если входные данные часто меняются в процессе работы, Вам стоит рассмотреть архитектуру динамического обучения. Если же входные данные меняются достаточно редко, лучше выбрать статическую архитектуру обучения.
Динамические тренировочные архитектуры
В этом случае Вы постоянно обновляете модель, переобучая ее на постоянно меняющемся распределении данных в производстве. Существует 3 различных архитектуры, которые зависят от получаемых входных данных и общего масштаба решаемой задачи.
1. Архитектура обучения на основе событий (push-based)
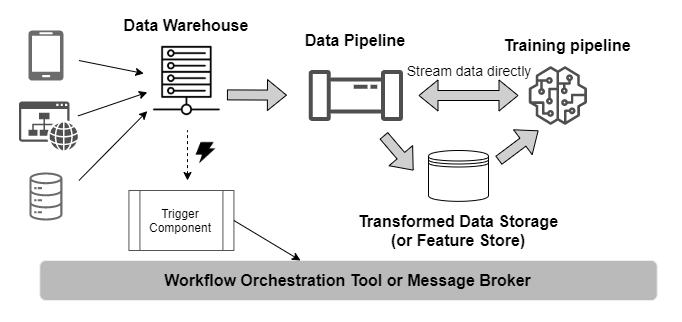
Обучающая архитектура для сценариев, основанных на событиях, в которых действие (например, поток данных в хранилище данных) вызывает включение триггерного компонента:
Инструмент оркестровки рабочих процессов (помогает организовать рабочий процесс, а также взаимодействие между хранилищем данных, конвейером данных и функциями, записываемыми в хранилище или конвейер обработки),
или брокер сообщений (служит посредником, помогающим координировать процессы между заданием данных и заданием обучения).

Это может понадобиться в том случае, если Вы захотите, чтобы Ваша система обучалась на данных, поступающих в режиме реального времени с IoT-устройств.
2. Архитектура обучения на основе оркестрации (pull-based)
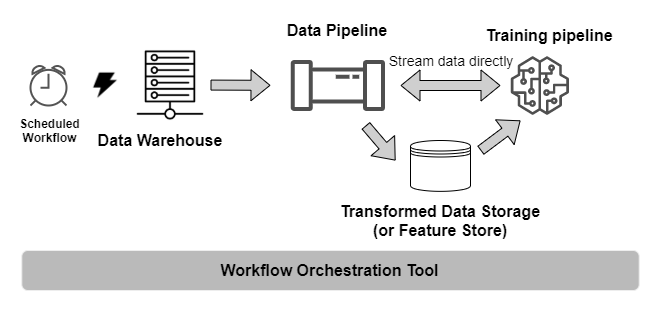
Архитектура обучения для сценариев, в которых через запланированные промежутки времени необходимо переобучать модель. Ваши данные находятся в хранилище, а инструмент оркестровки рабочих процессов используется для планирования извлечения и обработки, а также переобучения модели на свежих данных. Такая архитектура особенно полезна для задач, в которых пользователям не требуется оценка, например для рекомендаций по контенту (песням или статьям).
3. Архитектура обучения на основе сообщений
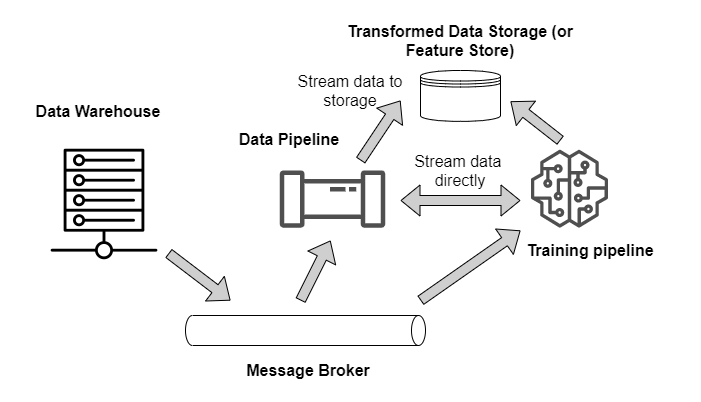
Такая архитектура обучения полезна, когда требуется непрерывное обучение модели. Например:
- новые данные поступают из разных источников (например, из мобильного приложения и/или других хранилищ данных),
- сервис данных подписывается на брокер сообщений, чтобы при поступлении данных в хранилище данных он отправлял сообщение непосредственно брокеру сообщений,
- брокер сообщений отправляет сообщение в конвейер данных для извлечения данных из хранилища.
После завершения процессов преобразования и загрузки данных в хранилище сообщение снова передается брокеру для того, чтобы он отправил сообщение в конвейер обучения для загрузки данных из хранилища и запуска задания на обучение.
По сути, это объединяет службу данных (конвейер данных) и службу обучения (конвейер обучения) в единую систему, чтобы обучение было непрерывным для каждого задания. Такая архитектура обучения может понадобиться, например, когда необходимо обновлять модель на транзакциях в режиме реального времени (приложения для обнаружения мошенничества).
Можно также использовать архитектуру обучения, запускаемую пользователем, когда пользователь отправляет запрос в службу конвейера обучения, чтобы начать обучение на имеющихся данных и выписать данные модели, а также, возможно, получить отчет об обучении.
Статическая архитектура обучения
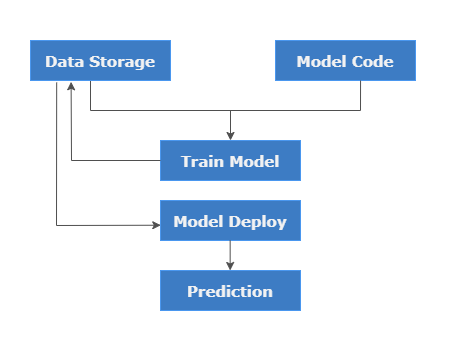
Эту архитектура подходит для решения задач, в которых распределение данных не сильно отличается от распределения в автономном режиме. В качестве примера можно привести систему одобрения кредитов, в которой атрибуты, необходимые для принятия решения об одобрении или отказе в выдаче кредита, постепенно меняются, а резкие изменения происходят только в редких случаях, например во время пандемии.
Ниже отображена эталонная для статического обучения архитектура – основное обучение происходит один раз, повторное обучение - время от времени.
Архитектура обслуживания
Архитектура обслуживания весьма разнообразна. Чтобы успешно реализовать модель в производстве, необходимо не только ее обслуживать, но и отслеживать, регулировать и управлять ею в производственной среде. Ваша архитектура обслуживания может быть разной, но она всегда должна учитывать все эти аспекты.
Выбор архитектуры обслуживания зависит от бизнес-контекста и требований, которые Вы предъявляете к модели.
Паттерны архитектуры общих операций
Архитектурные паттерны пакетной обработки данных
Это, пожалуй, самая простая архитектура, которую можно использовать для обслуживания проверенной модели в производстве. По сути, Ваша модель делает прогнозы в автономном режиме и помещает их в хранилище данных.
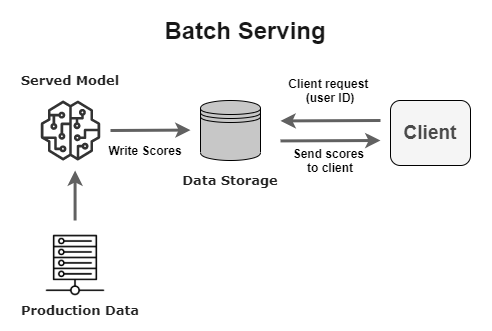
Вы можете использовать этот паттерн в том случае, если Вам не нужно отвечать на запросы клиентов в течение нескольких секунд или минут. Типичным примером может быть система предоставления рекомендаций контента (предварительный расчет рекомендаций для пользователя до того, как он войдет в свой аккаунт или откроет приложение).
Архитектурные паттерны онлайн -сервисов или операций, происходящих в режиме реального времени
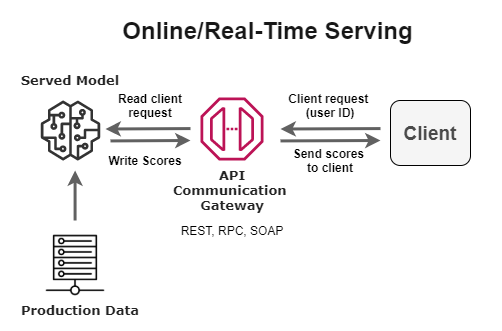
Бывают сценарии, когда необходимо предоставлять с минимальной задержкой (в течение нескольких секунд или минут). В этом случае Вам стоит рассмотреть архитектуру онлайн-сервиса, предназначенную для предоставления прогнозов в режиме реального времени, по мере их запроса пользователями.
Примером, который соответствует этому профилю, является обнаружение факта мошенничества во время проведения транзакции (до момента ее завершения).
Другие важные типы архитектуры:
Архитектура операций, проходящих в режиме близком к режиму реального времени – применима при решении задач, связанных с персонализацией.
Архитектура встраиваемых сервисов идеальна в случае, когда данные и/или вычисления должны оставаться на локальном или пограничном устройстве (например, мобильном телефоне или микроконтроллере).
Теперь, когда Вы познакомились с наиболее распространенными архитектурными паттернами MLOPs, давайте приступим к реализации одного из них!
Как выбрать самую подходящую архитектуру MLOps для своего проекта
Как и в случае с любым другим продуктом или решением, которое Вы хотите спроектировать, создание правильного проекта во многом зависит от конкретной задачи. Часто получается так, что схожие проблемы могут иметь лишь незначительные различия в архитектуре. Таким образом, понятие «лучший» или самый подходящий может быть очень субъективным. Я считаю, что «лучшая» архитектура, - это та, которая:
- Разрабатывается с учетом потребностей конечного пользователя.
- Учитывает все требования, предъявляемые к проекту.
- Следуют передовым практикам, принципам, методологиям и техникам; в отношении передовых практик и принципов проектирования я ссылаюсь на практику ML – лучшие практики создания фреймворков от AWS.
- Реализуется с помощью надежных инструментов и технологий.
Вы также увидите, что некоторые из них могут применяться (или не применяться) в зависимости от степени зрелости MLOps, что еще больше увеличивает субъективность при выборе архитектуры. Несмотря на это, я постарался дать полную информацию о проекте, включая уровень зрелости MLOps, а также стоимость эксплуатации системы.
Чтобы сохранить последовательность, наш проект учитывает четыре столпа MLOps.
- Развертывание производственной модели,
- Мониторинг производственных моделей,
- Управление моделями в производстве,
- Управление жизненным циклом модели (переобучение, реструктурирование, автоматизированные конвейеры).
Алгоритм оценки архитектуры:
- Анализ проблемы: Какова цель? В чем заключается специфика бизнеса? Текущая ситуация? Предлагаемое ML-решение? Имеются ли данные, необходимые для реализации проекта?
- Рассмотрение требований: Какие требования и спецификации необходимы для успешного выполнения проекта? Требования - это то, что должно делать приложение в целом, а спецификации в данном случае, это то, как именно приложение должно это делать - с точки зрения управления данными, тестами и производственными моделями.
- Определение структуры системы: Определение основы/структуры архитектуры с помощью различных методологий.
- Принятие решения о способе реализации: Наполнение структуры рекомендуемыми надежными инструментами и технологиями.
- Обсуждение того, почему такая архитектура является самой оптимальной и «лучшей» (с учетом выше упомянутых практик AWS.)
Адаптация принципов проектирования из фреймворка от AWS
Мы используем 5 основных принципов хорошо продуманных решений, разработанных AWS. Они помогают создавать оптимальные решения, используя лучшие практики, выработанные в данной области за несколько лет:
- Операционное совершенство: Сосредоточенность на способности внедрять модели в производство, контролировать и получать информацию о системах ML.
- Безопасность: Сосредоточенность на способности защищать информацию, системы и активы (данные), обеспечивая при этом ценность для бизнеса посредством оценки рисков и стратегий их минимизации.
- Надежность: Сосредоточенность на способности системы восстанавливаться после сбоев в работе инфраструктуры или сервисов, динамически получать вычислительные ресурсы для удовлетворения спроса и смягчать последствия сбоев, такие как неправильная конфигурация или временные сетевые проблемы.
- Эффективность производительности: Фокус на эффективном использовании вычислительных ресурсов для удовлетворения требований, а также на том, как поддерживать эту эффективность в условиях изменения спроса и развития технологий.
- Оптимизация затрат: Сосредоточенность на способности создавать и эксплуатировать системы ML, которые достигают поставленных результатов и минимизируют расходы, позволяя бизнесу получить максимальную отдачу от инвестиций.
Специально для Вас я создал сводную таблицу, основанную на принципах проектирования этих 5 столпов, на которые Вам следует обратить внимание при планировании архитектуры:
|
Аспект |
Принципы проектирования систем ML |
|---|---|
|
Операционная деятельность |
|
|
Безопасность |
|
|
Надежность |
|
|
Эффективность |
|
|
Оптимизация затрат |
|
Лучшие архитектуры MLOps в рамках конкретного проекта
У нас есть некий проект, для которого мы должны выбрать правильный тип архитектуры.
Проект: система рекомендации новостных статей
Системы рекомендаций контента помогают компаниям привлекать на свою платформу пользователей. Особенно это популярно в медиа-сфере.
Сценарий
Бизнес-аналитик нашей компании, специализирующейся на рекомендациях новостных статей, понял, что в последнее время наблюдается большой отток клиентов. Проанализировав ситуацию, он пришел к выводу, что пользователи не чувствуют себя вовлеченными в работу с платформой, поэтому они либо не продлевают подписку, либо просто переходят на другие медиаплатформы. Поэтому, пока компания не персонализирует платформу, мы будем и дальше наблюдать отток пользователей.
Первый шаг - создание функции, интегрируемой с существующим продуктом, которая будет рекомендовать новостные статьи, которые читатели, скорее всего, будут читать при входе в систему, и отправлять их на их электронную почту.
Руководство соглашается при условии, что прежде чем увеличивать масштабы, мы создадим систему и протестируем ее на определенном количестве пользователей.
… и вот как мы сюда попали. Что нам теперь делать? Ну, давайте начнем разрабатывать архитектуру!
Анализ проблемы
Понимание специфики бизнеса
В настоящее время у компании более 521 000 клиентов в 3 регионах (Латинская Америка, Африка и Северная Америка).
Для обслуживания платных подписчиков сотрудники компании собирают статьи, опубликованные различными изданиями.
Когда пользователь посещает платформу впервые или активирует бесплатную пробную версию, ему предлагается выбрать категории статей, которые его интересуют. Им предлагаются последние статьи в этой категории. Далее система собирает данные об их взаимодействии со статьями, а также о том, как долго они остаются на странице в приложении или на сайте.
Какова наша бизнес-цель? Повысить вовлеченность подписчиков, рекомендуя им наиболее релевантные статьи для каждого конкретного сеанса входа в систему.
Бизнес-метрика? Увеличение количества минут, проведенных пользователем за чтением статьи. Причина, по которой мы использовали эту метрику вместо кликов, заключается в том, что вне системы существует гораздо больше внешних факторов, которые могут повлиять на то, кликнет ли пользователь на статью или нет. От заголовка до фотографии на обложке или подзаголовка, до дизайна пользовательского интерфейса и так далее.
Какова сфера охвата проекта?
Это проект, ориентированный на внешнюю среду, где важен опыт пользователей.
Пока мы создаем проект и тестируем его только на ограниченном количестве пользователей (около ~15 000) для того, чтобы бизнес мог должным образом контролировать этот проект и эффективно управлять его последствиями.
Заинтересованные стороны также попросили, чтобы мы запустили всю систему в локальной сети, пока мы тестируем ее на ~15 000 пользователей, и когда появится отчет о финальной стоимости всего проекта, мы сможем обсудить этот вопрос более предметно.
Технические особенности
- Команда: В настоящее время наша команда состоит всего из двух человек: меня и инженера по обработке данных, что вполне нормально для такого масштаба - мы должны найти способы сделать работу менее напряженной для каждого из нас! У нас также есть доступ к команде Ops организации, которая уже развертывает приложения и внутренние системы на кластерах Kubernetes как для наших локальных систем, так и для частной облачной платформы.
- Предоставление оборудования/инфраструктуры: Мы выделяем собственные ресурсы для запуска проекта. Мы также получили свободу выбора инструментов - для вас это может быть не так, особенно если ваша команда Ops имеет уже существующие инструменты.
Понимание данных
Исторические данные включают в себя сведения о содержании статьи, категории содержания, времени, проведенном пользователем за чтением каждой конкретной статьи, уникальном идентификаторе пользователя, общем количестве посещений статьи и т.д.;
Ежедневно ожидается ~144 000 новых статей из самых различных изданий;
Статьи содержат ссылки, категории, дату выхода, название издания и другие метаданные.
Рассмотрение требований
Определяясь с требованиями к системе, Вы должны понимать несколько вещей:
- Что обеспечит хороший пользовательский опыт? Помните, что пользователь может быть как реальным человеком, так и сервисом, например, бэкэнд-сервисом.
- Какие части решения наиболее важны для обеспечения хорошего пользовательского опыта?
- Какой минимально ценный продукт мы можем реализовать как можно скорее, чтобы представить первую версию пользователям и собрать отзывы?
Требование: Сервис должен рекомендовать 10 наиболее подходящих статей, которые пользователь, скорее всего, прочтет за сеанс входа в систему через мобильное приложение или главную страницу сайта.
Теперь мы можем более подробно рассмотреть все спецификации, относящиеся к каждому компоненту системы ML.
Спецификации сбора данных и управления характеристиками
Поскольку все статьи поступают из разных источников, имеет смысл централизовать доступ к данным в хранилище данных, чтобы мы могли легко вводить производственные данные в конвейер обработки данных.
Для переобучения модели машинного обучения в автономном режиме нам понадобится хранилище признаков для хранения преобразованных значений признаков, извлеченных из производственных данных.
Также необходимо включить версионирование данных - так мы сможем должным образом отслеживать их историю в целях аудита и отладки.
Мы также должны следить и за качеством данных; они должны соответствовать требованиям автоматизированного рабочего процесса.
Управление тестированием и спецификации для разработки моделей
Обучение должно происходить в автономном режиме на основе имеющихся данных о пользователях и их взаимодействии с предыдущими статьями.
Нам понадобится динамическая архитектура обучения – так мы сможем обеспечить свежесть публикуемых статей и избежать устаревших рекомендаций.
Нам также понадобится реестр моделей для хранения подробной информации обо всех наших экспериментах и метаданных, полученных в ходе обучения. Это также позволит проследить историю развертываемой модели и данных.
Кроме того, потребуется конвейер обучения, поскольку нам нужно будет автоматизировать процесс переобучения, ведь каждый день на нашу платформу будут поступать новые статьи.
Поскольку наш бюджет ограничен, модель должна обучаться каждый день за разумное количество времени, и, возможно, нам придется ограничить объем данных, на которых она обучается, поскольку мы не можем позволить себе слишком длительное обучение и чрезмерно большой объем новых статей.
В нашей архитектуре обучения мы также воспользуемся всеми преимуществами контрольных точек модели для того, чтобы обучение и переобучение не занимали слишком много времени (желательно не более нескольких часов с момента их появления, так как это часто является пиковым временем входа наших пользователей).
Спецификации управления производственными моделями
1. Спецификации развертывания и обслуживания
Похоже, стоит использовать систему пакетного вывода данных, поскольку нам не нужно предоставлять рекомендации пользователю в режиме реального времени, пока он просматривает платформу. Рекомендации могут вычисляться в автономном режиме, храниться в базе данных и предоставляться пользователю при входе в систему.
Для взаимодействия с существующей системой мы можем предоставлять модель в виде сервиса с RESTful-интерфейсом.
Нам нужно будет избежать изменений зависимостей сервисов, чтобы наши автоматические прогоны не давали сбоев из-за этих изменений.
Мы также хотим обеспечить простоту постоянного развертывания новых версий модели после их оценки и отслеживать их, поскольку обучение будет происходить каждый день.
2. Спецификации мониторинга модели
Изменение модели нужно отслеживать в режиме реального времени для того, чтобы пользователи не получали устаревшие рекомендации, поскольку новостные события весьма динамичны, и читательское поведение пользователей также в какой-то момент времени может стать неопределенным.
Необходимо отслеживать и качество данных, так как в некоторых случаях количество свежих статей может быть меньше, чем обычно ожидается в течение одного дня. Также необходимо учитывать поврежденные данные.
Поскольку мы будем часто переобучать нашу модель, нам нужно отслеживать метаданные обучения для каждого запуска, чтобы в случае сбоя модели мы могли проверить данные обучения и устранить неполадки.
Поскольку мы имеем дело с конвейерами, нам понадобятся компоненты мониторинга для определения их состояния.
Нам нужно будет собирать данные о том, сколько времени человек проводит над 1 статьей для того, чтобы оценить производительность нашей модели и ее дрейф.
Мы также должны иметь возможность получать отчеты в виде дашбордов и оповещения о сбоях в работе конвейера, поскольку мы хотим быть уверены в том, что наша модель постоянно обновляется.
3. Спецификации управления модели
Поскольку большое количество статей поступает в случайном порядке на основе событий, мы можем создать pull-based архитектуру, которая будет выполнять переобучениt нашей модели на новых данных по расписанию.
Для каждой версии модели, прошедшей переобучение и развернутой на новом месте, необходимо создать систему версий модели для того, чтобы мы могли легко откатиться назад, если вдруг переобученная модель будет работать хуже.
4. Технические характеристики управления моделью
Решения модели должны быть объяснимы, поскольку дезинформация может быть подвергнута аудиту и должна быть исключена.
Спецификации, касающиеся системных операций (Ops)
Нам необходимо определить, как Ваши модели смогут работать в производственных средах. Каковы критерии взаимодействия сервисов друг с другом и как это будет определять работу всей системы? В основном, требования к производительности для оптимальной работы системы таковы:
- 95 % соглашение об уровне обслуживания (SLA) между рекомендательным сервисом и внутренним сервером.
- Низкая задержка при обслуживании и высокая пропускная способность при пакетном обслуживании прогнозов через хранилище данных для тысяч пользователей.
- Отслеживание количества успешных, неудачных и прерванных по времени вызовов API.
- Конвейеры обучения и система в целом должны контролироваться с точки зрения потребления ресурсов: ввода-вывода, использования процессора и памяти.
- Инфраструктура должна быть независимой от модели и времени выполнения.
- Наша производственная среда не должна требовать частых изменений зависимостей, которые могут привести к сбою наших конвейеров данных и моделей во время выполнения. В основном она должна быть детерминированной.
- Нам также нужна воспроизводимая среда, потому что она позволит нам реализовать стратегию отката при сбое системы.
- Мы должны обеспечить правильное версионирование каждого инфраструктурного пакета, чтобы конфликты, вызванные изменением зависимостей, можно было легко отладить.
Определение структуры системы
Основываясь на наших целях, требованиях и спецификациях, перечисленных выше, мы можем предложить структуру нашей системы. Вы можете заметить, что здесь нет упоминаний об инструментарии или реализации. И правильно! Ведь речь идет скорее о проектировании системы с учетом бизнес-целей и конечного пользователя. При проектировании архитектуры Вы должны максимально абстрагироваться от технологий и ориентироваться только на Ваши требования и спецификации.
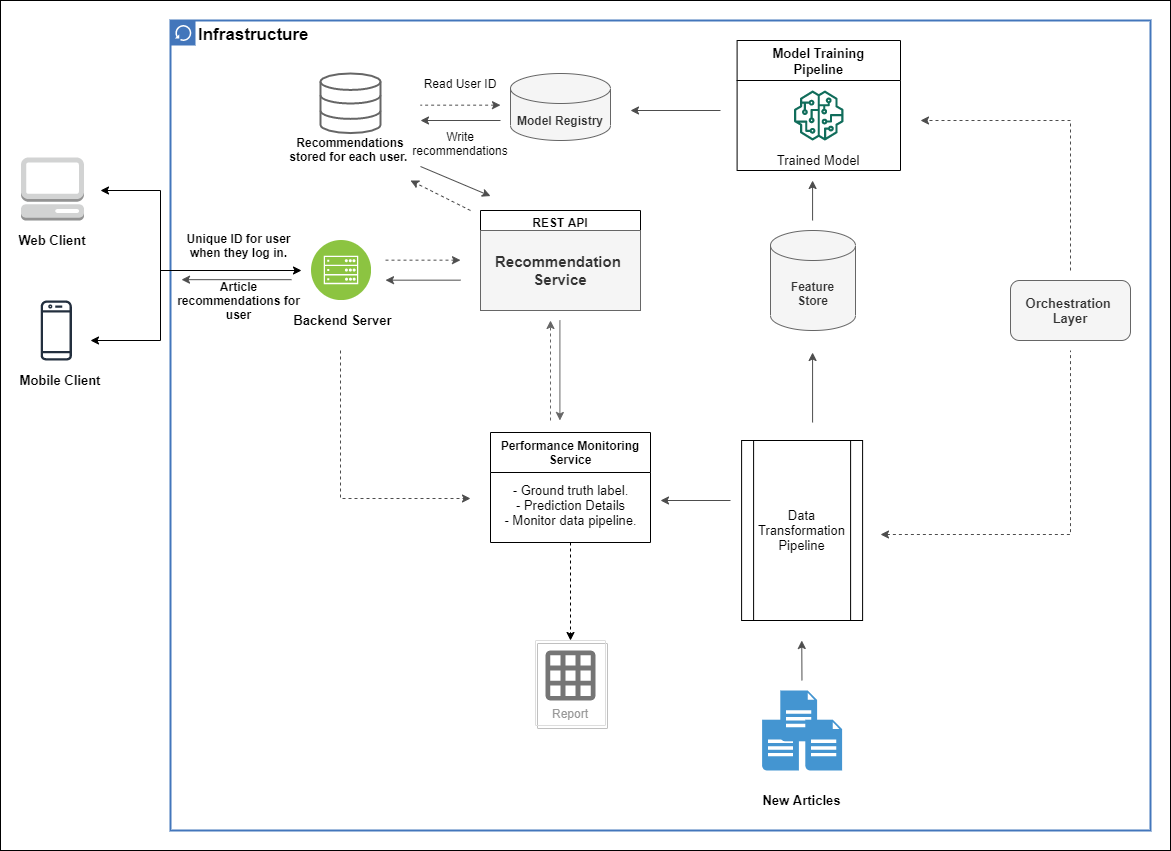
Структура системы основывается на требованиях и спецификациях, зависящих от поставленных целей. После того как Вы определились со структурой, можно приступать к выбору инструментов и технологий для ее реализации.
Помимо составления диаграммы архитектуры, приведенной выше, которую также часто называют архитектурой на основе компонентов , Вы можете захотеть углубиться в каждый ее раздел для того, чтобы убедиться в том, что ничего не упустили. Также обратите свое внимание и на другие диаграммы, такие как:
- Диаграмма состояния и последовательностию. Диаграммы состояний отражают спецификации Вашей архитектуры (например, спецификации фазы управления данными, экспериментами и производством) и то, как различные фазы и объекты взаимодействуют друг с другом.
- Еще одна диаграмма, на которую стоит обратить внимание - диаграмма активности.
Как Вы уже догадались, эта архитектура находится на 1 уровне зрелости MLOps .
Кстати, данная структура совершенно не зависит от решаемой Вами задачи ML. Это означает, что она может работать как над проектом по компьютерному зрению, так и над задачей по обработке естественного языка - здесь мы говорим об очевидном, но, конечно, некоторые спецификации управления данными будут другими.
Выбор способа реализации модели
Еще раз повторю тезис, высказанный ранее: поскольку MLOps еще только зарождается, создание эффективной системы ML подразумевает комбинацию передовых практикам и надежных инструментов, проверенных временем. По сути, это означает, что при выборе инструментов для реализации компонентов структуры в соответствии с Вашими требованиями и спецификациями Вы должны действовать осторожно и обдуманно.
Желательно, чтобы платформа охватывала весь горизонтальный стек (управление данными, экспериментами и моделями) и была динамичной для интеграции с существующей экосистемой или позволяла легко переносить ее в разные среды. К счастью, сообщество MLOps – одно из самых активных.
Выбирая инструменты (или «игрушки») для реализации архитектуры MLOps, важно учесть следующее:
- Как скоро Вам нужен MVP и сколько времени потребуется для его выпуска?
- Каковы результаты оценки рисков, которую Вы провели? Насколько важна безопасность платформы с точки зрения данных, модели и всей системы в целом?
- Сложно ли будет освоить этот инструмент и интегрировать его в существующую экосистему инструментов?
- (Если Вы работаете в команде) Есть ли у Вас в команде специалист, имеющий опыт использования конкретного инструмента или набора инструментов?
- Вписывается ли стоимость этих инструментов в выделенный Вами бюджет? С точки зрения стоимости подписки или лицензирования (если Вы покупаете), стоимости хостинга (если Вы создаете), стоимости обслуживания и так далее.
По сути, принимая решение о внедрении, Вы выбираете то, что больше всего подходит для Вашего проекта исходя из объема, требований, рисков и ограничений (таких как стоимость, скептицизм заинтересованных сторон и так далее).
Вернемся к нашему проекту! Для реализации компонентов я буду использовать только надежные инструменты. Поскольку мой бюджет ограничен, а масштабы проекта пока невелики, я также рассмотрю целесообразность применения решений MLOps с открытым исходным кодом и буду отталкиваться от соображений, связанных с инфраструктурой.
Инструменты, связанные с инфраструктурой
Для меня важно, чтобы вся система была переносимой и исполняемой в любом месте и не зависела от модели.
В качестве среды выполнения мы будем использовать Kubernetes, поскольку это разумно с точки зрения спецификаций, кроме того, это open-source решение.
Переносимость всей системы через Kubernetes обеспечит нам возможность легкого перехода от локального решения к облачному или гибридному, если возникнет такая необходимость.
Из-за ограниченности бюджета мы можем задать ограничение на ресурсы системы с помощью Kubernetes. Кроме того, у нас есть внутренняя операционная команда, которая уже хорошо знакома с ним.
Мы также можем использовать расширения Kubernetes для контроля доступа в масштабах всей системы в качестве меры безопасности.
NB: Я знаю о K8s (Kubernetes) для машинного обучения, но давайте просто представим, что мы не знаем о Kubeflow. В конце концов, это не будет окончательным вариантом архитектуры, верно? Мы обязательно извлечем уроки и вернемся к этой архитектуре когда-нибудь позже!
Инструменты сбора данных и управления характеристиками
Для хранения данных мы будем использовать PostgreSQL, эффективную базу данных с открытым исходным кодом, предназначенную для структурированных данных. Кроме того, большинство управляемых решений базируются именно на PostgreSQL и MySQL.
Нам также понадобится конвейер данных, и для написания ETL (Extract, Transform, Load) мы воспользуемся Apache Beam.
Для версионирования конвейера данных мы будем использовать Data Version Control (DVC), GIT-подобный инструмент с открытым исходным кодом.
Для хранилища данных мы будем использовать Feast, open-source продукт, который отлично интегрируется с другими инструментами хранения данных (PostgreSQL).
Инструменты для управления экспериментами и разработки моделей
Для управления экспериментами мы остановимся на neptune.ai, так как все необходимые метаданные об использовании оборудования (CPU и память) и значениях гиперпараметров регистрируются, их легко визуализировать, а обучение воспроизводимо.
Neptune также поможет нам с версионированием набора данных и отслеживанием версии набора данных, использованного в обучении.
Для разработки моделей мы будем использовать фреймворк, поддерживающий Python; мы выберем его в процессе реализации.
У меня сейчас нет спецификации для проведения распределенного обучения, поэтому я пока остановлюсь именно на этом варианте.
Управление производственной моделью
1. Инструменты развертывания
Для упаковки нашей модели для развертывания мы будем использовать Docker. Он поддерживается практически всеми платформами, работает в локальной сети и может использоваться в Kubernetes. На первое время вполне подойдет бесплатная версия.
Нашим протоколом API будет REST API, а в качестве шлюза API мы будем использовать Kong Gateway, open-source решение, поддерживающее Kubernetes, с установкой которого может справиться каждый!
Для развертывания кода модели воспользуемся GitHub Actions, поскольку код нашего проекта будет храниться в приватном репозитории GitHub. В случае локального использования за хостинг платить не нужно, однако мы все время будем следить за количеством используемых минут, чтобы понять, достаточно ли нам бесплатной версии или нет.
В зависимости от используемого нами фреймворка мы выберем инструмент обслуживания для развертывания нашей модели в качестве сервиса, будем выбирать между Flask и FastAPI. Возможно чуть позже мы рассмотрим целесообразность использования TensorFlow Serving, но пока двух фреймворков будет вполне достаточно.
2. Инструменты мониторинга
Для мониторинга работы нашей модели в производственной сфере мы будем использовать беспроигрышное open-source комбо Prometheus и Grafana.Prometheus – это БД, предназначенная для хранения данных мониторинга, а Grafana – это инсрумент визуализации отслеживаемых метрик и компонентов. Это действительно мощные и полезные инструменты.
Возможно, чуть позже для отправки уведомлений касательно мониторинга мы воспользуемся Prometheus’ Alertmanager .
Для фиксации системных метрик мы будем использовать Elasticsearch из стека ELK, еще один open-source продукт, поддерживаемый многими популярными платформами.
3. Инструменты управления моделью
Несмотря на то, что neptune.ai - это в первую очередь трекер тестов, он также может служить и реестром моделей для каждого тестового прогона. Версии моделей можно регистрировать для отслеживания их происхождения.
Для планирования и оркестровки рабочих процессов мы будем использовать Apache Airflow, пожалуй, самый распространенный инструмент оркестровки.
4. Инструменты регулирования модели
Для объяснения рекомендаций модели мы будем использовать SHAP, поскольку она может дать нам общее объяснение того, почему модель делает те или иные прогнозы.
На этом выбор способа реализации закончен - Вы видите, что наша модель была построена на основе структуры и соответствовала всем требованиям, которые мы определили на этапе планирования. Теперь мы продолжим использовать рассмотренную ранее архитектуру AWS.
Операционная деятельность
Мы смогли определить сквозную архитектуру и операционную модель на ранних этапах рабочего процесса ML.
Мы позаботились о том, чтобы интегрировать непрерывный мониторинг и измерение рабочей нагрузки машинного обучения.
Мы разработали стратегию переобучения модели на основе постановки задачи, требований и бюджета.
Мы внедрили компоненты для версионирования нашей модели и артефактов в конвейере обучения.
Автоматизированный рабочий процесс и фиксация кода обучения в инструменте рабочего процесса обеспечивают непрерывную интеграцию и развертывание нашей модели.
Безопасность
До сих пор мы обеспечивали только прослеживаемость данных и моделей, что является хорошим дополнением.
В процессе внедрения большинство инструментов, которые мы будем использовать, обеспечивают контроль уровня доступа, поэтому мы можем следовать лучшим практикам безопасности.
Мы можем рассчитывать на планирование других мер, таких как безопасность операций для нашей производственной среды, аварийное восстановление и шифрование данных из потоковых источников данных в пути и в состоянии покоя.
Аудит мер безопасности - это то, что позволит нам сделать данная архитектура.
Надежность
До сих пор нам удавалось сделать нашу систему независимой от времени выполнения, обучить модель один раз и запустить ее в любом месте.
Единственное, что нам нужно будет сделать с Apache Beam и Apache Airflow, - это реализовать тестируемость данных, которые попадают в конвейер данных..
Эффективность
Kubernetes может ограничить ресурсы для выполнения нашей рабочей нагрузки и автоматически масштабирует нагрузку, чтобы оптимизировать ресурсы для нашей ML-нагрузки.
Мониторинг системных метрик с помощью Prometheus и Grafana поможет нам отслеживать использование ресурсов нашей моделью.
Наши инструменты мониторинга обеспечат непрерывный мониторинг и измерение производительности системы с помощью системных метрик.
Оптимизация затрат
Наша архитектура позволяет передавать потоковые данные любого размера, как большие, так и маленькие - мы всегда можем рассмотреть возможность экспериментов с различными размерами.
В настоящее время большинство наших инструментов размещено на локальном компьютере, но поскольку наша среда выполнения переносима, мы всегда можем перенести ее в управляемую инфраструктуру.
Мы можем ограничить ресурсы, используемые нашей ML-нагрузкой, указав это в YAML-файле для Kubernetes.
В самом начале я сказал, что поставлю перед Вами задачу. Вот она:
Как создать систему обнаружения факта мошенничества, которая должна быть интегрирована с сервисом управления заказами для бизнеса, гарантирующего выполнение заказа в течение следующего дня?
Не стесняйтесь определять бизнес так, как Вам хочется, но, возможно, через какое-то время Вам захочется подумать о более масштабном проекте.
Если Вы готовы к решению этой задачи, Вы можете найти пример эталонной архитектуры, которую я разработал (на основе этого вопроса), в разделе «Ресурсы для выбора лучшей архитектуры MLOps для Вашего проекта» в конце этой статьи. Удачи!
Теперь Ваша очередь: как выбрать наиболее оптимальную архитектуру MLOps для Вашего проекта?
Чтобы выбрать архитектуру, максимально подходящую для Вашего проекта, я рекомендую сделать следующее:
Поймите и четко сформулируйте требования, объем и ограничения, необходимые для реализации проекта: Рекомендую просмотреть серию видео, состоящую из 3 частей, подготовленную Майклом Перлином. Благодаря ей Вы поймете, с чего стоит начать. Другие ресурсы можно найти в разделе «Справочники и ресурсы». В Ваших требованиях должны быть четко сформулированы бизнес-цели, а также то, что именно представляет собой оптимальный пользовательский опыт.
Разработайте структуру системы на основе требований и пока не думайте о реализации или технологиях, которые будут вписываться в эту структуру. Ваша главная цель - определить структуру в соответствии с требованиями, сформулированными на предыдущем этапе. Я рекомендую посмотреть, что сделали/делают другие на этом этапе в плане структуры/архитектуры своей системы. (В разделе ресурсов в конце этой статьи я привел ссылки на центры, опыт которых Вы можете перенять).
Настало время определиться со способом реализации! Выбирая инструменты и технологии, убедитесь, что они достаточно надежны для любого этапа ML-конвейера, в котором они будут использоваться. Если это инструмент мониторинга, убедитесь в том, что он масштабируемый и обладает всеми необходимыми Вам функциями.
Наконец, обоснуйте свой выбор архитектуры, используя принципы проектирования и лучшие практики от AWS или любой другой хороший шаблон.
Поймите, что Ваша архитектура лишь формирует фундамент и дает Вам представление о том, как должна быть построена система ML. Она не должна запирать Вас в жесткие рамки, а только лишь указывать путь. Поймите, Вы можете вносить коррективы по мере итеративного построения системы ML. Именно поэтому Agile ML создание ПО - это путь, по которому нужно идти для того, чтобы быстро обнаружить проблемы или даже выявить лучшие инструменты или платформы, которые могут помочь Вам в реализации Вашей задумки и обеспечить наиболее оптимальную систему ML в течение определенного периода времени.
Парочка полезных советов:
Следование лучшим практикам + надежный инструментарий и способ реализации + выпуск MVP как можно раньше (для того, чтобы можно было итеративно построить оптимальное решение).
Вы должны начать продумывать и планировать архитектуру MLOps на самых ранних этапах жизненного цикла проекта ML. Это поможет Вам скоординировать действия и найти «мертвые зоны» в разработке и внедрении.
Заключение
В этой статье мы поговорили о следующем:
- Общие архитектурные паттерны MLOps для обучения и обслуживания,
- Как выбрать оптимальную архитектуру MLOps для Вашего проекта,
- Схема выбора оптимальной архитектуры MLOps для Вашего проекта,


