

MLOps: непрерывная доставка и конвейеры автоматизации в машинном обучении
В этом документе рассматриваются методы реализации и автоматизации непрерывной интеграции (CI), непрерывной доставки (CD) и непрерывного обучения (CT) для систем машинного обучения (ML).
Data Science и ML становятся основными способами решения сложных современных проблем, преобразования отраслей и создания бизнес-ценности во всех возможных областях. В настоящее время в нашем распоряжении имеются все необходимые компоненты для эффективного применения ML:
- Большие наборы данных
- Недорогие вычислительные ресурсы
- Специализированные ускорители ML на различных облачных платформах
- Заметныйй прогресс в различных областях исследований ML (таких как компьютерное зрение, понимание естественного языка, генеративный ИИ и системы рекомендательного ИИ).

Поэтому многие компании инвестируют большие суммы в свои команды специалистов по Data Science, а также в широкие возможности ML для разработки прогностических моделей, которые могут принести реальную пользу своим конечным пользователям.
Этот документ предназначен для специалистов Data Science и инженеров ML, которые хотят применить принципы DevOps к системам ML (MLOps). MLOps - это культура и практика ML-инжиниринга, направленная на объединение разработки ML-систем (Dev) и эксплуатации ML-систем (Ops). Применение MLOps на практике означает, что Вы выступаете за автоматизацию и мониторинг всех этапов создания ML-системы, включая интеграцию, тестирование, выпуск, развертывание и управление инфраструктурой.
Специалисты, занимающиеся изучением данных, могут реализовать и обучить ML-модель на автономном наборе данных. Основная проблема заключается не в создании модели ML, а в создании интегрированной системы ML и ее непрерывной эксплуатации в производстве. За долгую историю существования производственных ML-сервисов в компании Google мы узнали, что в эксплуатации ML-систем в производстве есть множество подводных камней. Некоторые из них описаны в книге Машинное обучение: Высокопроцентная кредитная карта технического долга.
Как показано на следующей диаграмме, лишь небольшая часть реальной системы ML состоит из кода ML. Окружающих элементов очень много, при этом все они достаточно сложны.
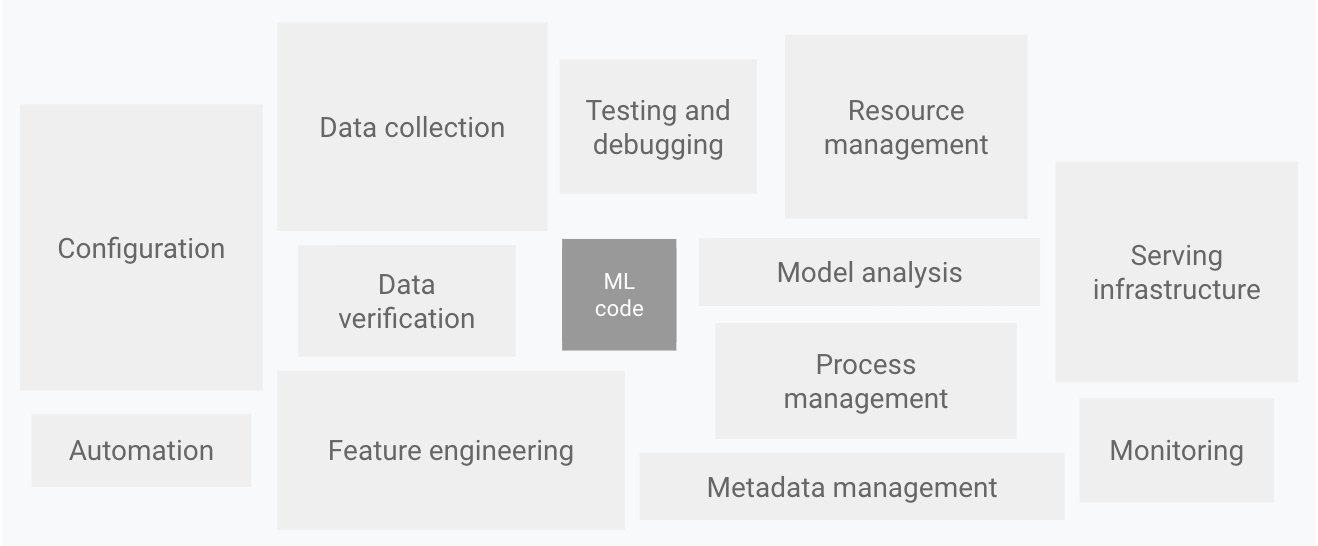
На предыдущей схеме показаны следующие компоненты системы:
- Конфигурация
- Автоматизация
- Сбор данных
- Проверка данных
- Тестирование и отладка
- Управление ресурсами
- Анализ моделей
- Управление процессами и метаданными
- Инфраструктура обслуживания
- Мониторинг
Для разработки и эксплуатации таких сложных решений к системам ML можно применить принципы DevOps (MLOps). В этом документе рассматриваются концепции, которые следует учитывать при создании среды MLOps для ключевых практик Data Science, таких как CI, CD и CT.
В данной статье рассматриваются следующие темы:
- DevOps vs MLOps
- Шаги по разработке модели ML
- Уровни зрелости MLOps
- MlOps для генеративного ИИ
DevOps vs MLOps
DevOps является достаточно популярной практикой при разработке и эксплуатации крупномасштабных программных систем. Эта практика дает такие преимущества, как сокращение циклов разработки, увеличение скорости развертывания и надежные релизы. Чтобы добиться всех этих преимуществ, в разработку программных систем необходимо ввести следующие две концепции:
- Непрерывная интеграция (CI)
- Непрерывная доставка (CD)
Система ML - это программная система, поэтому для обеспечения надежности ее создания и эксплуатации в масштабе применяются специальные методы.
Системы ML отличаются от других программных систем следующим образом:
- Навыки работы в команде: В проекте ML команда обычно состоит из специалистов по изучению данных или исследователей ML, которые занимаются анализом данных, разработкой моделей и тестированием. Эти люди не обязательно должны быть опытными инженерами-программистами, способными создавать сервисы производственного класса.
- Разработка: ML является экспериментальным по своей природе. Вы должны попробовать различные функции, алгоритмы, методы моделирования и конфигурации параметров, только так Вы сможете найти то, что лучше всего подходит для решения Вашей проблемы. Основная сложность заключается в отслеживании того, что сработало, а что нет, а также в обеспечении воспроизводимости при повторном использовании кода.
- Тестирование: Тестирование системы ML является более сложным, чем тестирование других программных систем. В дополнение к обычным модульным и интеграционным тестам Вам потребуется проверка данных, оценка качества обученной модели и проверка модели.
- Развертывание: В системах ML развертывание не так просто, как развертывание обученной в автономном режиме модели ML в качестве службы прогнозов. Системы ML могут потребовать развертывания многоступенчатого конвейера для автоматического переобучения. Этот конвейер еще больше усложняет задачу и требует автоматизации шагов, которые выполняются специалистами, изучающими данные, вручную.
- Производство: Производительность ML-моделей может снижаться не только из-за неоптимального кодирования, но и из-за постоянно меняющихся профилей данных. Другими словами, модели могут разрушаться гораздо сильнее, чем обычные программные системы. Поэтому необходимо отслеживать сводную статистику данных и контролировать производительность модели в режиме онлайн для того, чтобы отправлять уведомления или откатываться назад, когда фактические значения начинают отклоняться от ожидаемых.
ML и другие программные системы схожи в непрерывной интеграции контроля исходных текстов, модульном тестировании, интеграционном тестировании и непрерывной доставке программного модуля или пакета. Однако в ML есть несколько заметных отличий:
- CI - это уже не только тестирование и проверка кода и компонентов, но и тестирование и проверка данных, схем данных и моделей.
- CD - это уже не отдельный программный пакет или сервис, а целая система (конвейер обучения ML), которая должна автоматически развернуть другой сервис (сервис предсказания моделей).
- CT - это новое свойство, уникальное для систем ML, которое связано с автоматическим переобучением и обслуживанием моделей.
В следующем разделе рассматриваются типичные шаги по обучению и оценке ML-модели для использования в качестве службы построения прогнозов.
Шаги Data Science для ML
В любом проекте ML после определения сценария использования и установления критериев успеха процесс доставки модели ML в производство включает следующие шаги. Эти шаги можно выполнить вручную или с помощью автоматического конвейера.
- Извлечение данных: Вы выбираете и интегрируете данные из различных источников данных для решения задачи ML.
- Анализ данных: для определения данных, необходимых для построения модели ML выполняетcя разведочный анализ данных (EDA). Последствия этого процесса следующие:
- Понимание схемы данных и характеристик, ожидаемых от модели.
- Определение подготовки данных и разработки функций, необходимых для модели.
- Подготовка данных: Данные подготавливаются к выполнению задачи ML. Подготовка включает в себя очистку данных, в ходе которой они разделяются на обучающие, проверочные и тестовые наборы. Также применяются преобразования данных и инженерия функций для модели, решающей целевую задачу. Результатом этого этапа является получение данных в подготовленном формате.
- Обучение модели: Специалист по изучению данных реализует различные алгоритмы для обучения ML-моделей. Результатом этого этапа является получение обученной модели.
- Оценка модели: Модель оценивается на тестовом наборе. Результатом этого этапа является получение набора метрик для оценки качества модели.
- Валидация модели: Подтверждает, что модель пригодна для развертывания, что ее прогностические характеристики удовлетворяют всем требованиям.
- Использование модели: Проверенная и одобренная модель развертывается в целевой среде для составления прогнозов. Это развертывание может быть одним из следующих:
- Микросервисы с REST API для обслуживания онлайн-прогнозов.
- Встроенная модель для мобильных устройств.
- Часть системы пакетного прогнозирования.
- Мониторинг модели: Прогностическая эффективность модели важна для возможного запуска новой итерации процесса ML.
Уровень автоматизации всех этих этапов определяет зрелость процесса ML, который отражает скорость обучения новых моделей с учетом новых данных или новых реализаций. В следующих разделах описаны три уровня MLOps, начиная с самого распространенного, который не предполагает никакой автоматизации, и заканчивая автоматизацией как ML, так и CI/CD конвейеров.
MLOps уровень 0: ручной процесс
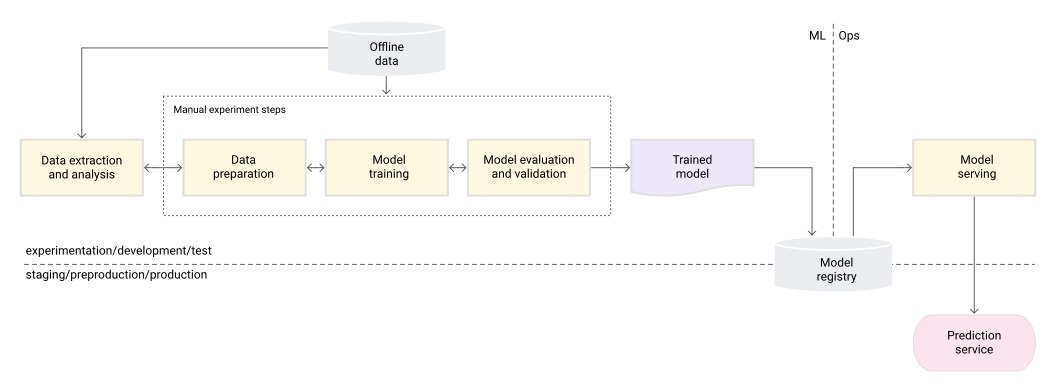
Во многих командах есть специалисты по изучению данных и исследователи ML, которые могут создавать самые современные модели ML, но при этом процесс их создания и развертывания полностью ручной. Это считается базовым уровнем зрелости или уровнем 0. На следующей диаграмме отображен рабочий процесс, осуществляемый вручную.
Характеристики
Список основных характеристик процесса MLOps уровня 0, изображенного на рисунке 2:
- Ручной, основанный на сценариях и интерактивный процесс: Каждый шаг, включая анализ, и подготовку данных, обучение модели и ее проверку выполняется вручную. Данный процесс обычно управляется экспериментальным кодом, который в интерактивном режиме пишется и выполняется в блокнотах специалистами по анализу данных до тех пор, пока не будет создана работоспособная модель.
- Разрыв связи между ML и операциями: Этот процесс разделяет ученых, создающих модель, и инженеров, которые обслуживают модель в качестве сервиса прогнозирования. Ученые, изучающие данные, передают обученную модель в качестве артефакта команде инженеров для развертывания в их инфраструктуре API. Эта передача может включать в себя помещение обученной модели в хранилище, проверку объекта модели в репозитории кода или загрузку в реестр моделей. Затем инженеры, которые развертывают модель, должны обеспечить доступность необходимых функций в производстве для обслуживания с низкой задержкой, что может привести к перекосам в обслуживании при обучении.
- Итерации выпуска: Этот процесс предполагает, что Ваша команда Data Science управляет несколькими моделями, которые меняются не часто - либо меняют реализацию модели, либо переобучают модель на основе новых данных. Новая версия модели развертывается всего пару раз в год.
- Отсутствие CI: поскольку в реализации предполагается мало изменений, CI игнорируется. Обычно тестирование кода входит в блокноты или выполнение скриптов. Скрипты и блокноты, реализующие этапы эксперимента, контролируются исходным кодом, в них создаются такие артефакты, как обученные модели, метрики оценки и визуализации.
- Отсутствие CD: Поскольку развертывание версий моделей происходит нечасто, CD не рассматривается.
- Развертывание относится к службе прогнозирования: Процесс касается только развертывания обученной модели в качестве сервиса ghjuyjpjd (например, микросервиса с REST API), а не развертывания всей системы ML.
- Отсутствие активного мониторинга производительности: Процесс не отслеживает и не регистрирует прогнозы и действия модели, что необходимо для обнаружения снижения производительности модели.
У команды дата-инженеров может быть своя сложная система настройки, тестирования и развертывания API, включая безопасность, регрессионное, нагрузочное и канареечное тестирование. Кроме того, прежде чем модель будет переведена на обслуживание всего трафика запросов на прогнозирование, производственное развертывание новой версии ML-модели проходит через A/B-тестирование или онлайн-эксперименты.
Трудности
MLOps уровня 0 характерны для многих компаний, которые еще только начинают применять ML в своей деятельности. Этого ручного процесса, основанного на изучении данных, может быть достаточно в том случае, если модели меняются или обучаются редко. На практике модели часто ломаются, они не могут адаптироваться к изменениям среды или к изменениям в данных, которые описывают эту самую среду.
Чтобы решить эти проблемы и сохранить точность модели в процессе производства, необходимо сделать следующее:
- Внимательно следите за качеством модели в производстве: Регулярный мониторинг позволяет вовремя обнаружить снижение производительности и устаревание модели. Это служит сигналом к новой итерации экспериментов и (ручному) переобучению модели на новых данных.
- Регулярно переобучайте производственные модели: Чтобы улавливать развивающиеся и возникающие закономерности, необходимо переобучать модель на самых свежих данных. Например, если Ваше приложение рекомендует модные товары с помощью ML, его рекомендации должны быть адаптированы к самым последним тенденциям.
- Постоянно экспериментируйте с новыми реализациями для создания идеальной модели: Чтобы использовать последние идеи и достижения в области технологий, необходимо пробовать новые реализации, такие как разработка признаков, архитектура модели и гиперпараметры. Например, если Вы используете компьютерное зрение для обнаружения лиц, но новые передовые методы могут повысить точность их обнаружения.
Для решения проблем, связанных с ручным процессом, полезны практики MLOps для CI/CD и CT. Развернув конвейер обучения ML, Вы сможете включить CT, а также настроить систему CI/CD для быстрого тестирования, сборки и развертывания новых реализаций конвейера ML. Более подробно эти возможности рассматриваются в следующих разделах.
MLOps уровень 1: автоматизация конвейера ML
Цель 1 уровня - непрерывное обучение модели путем автоматизации конвейера ML. Для автоматизации процесса использования новых данных для переобучения моделей в производстве необходимо внедрить в конвейер автоматизированные этапы проверки данных и моделей, а также триггеры конвейера и управление метаданными.
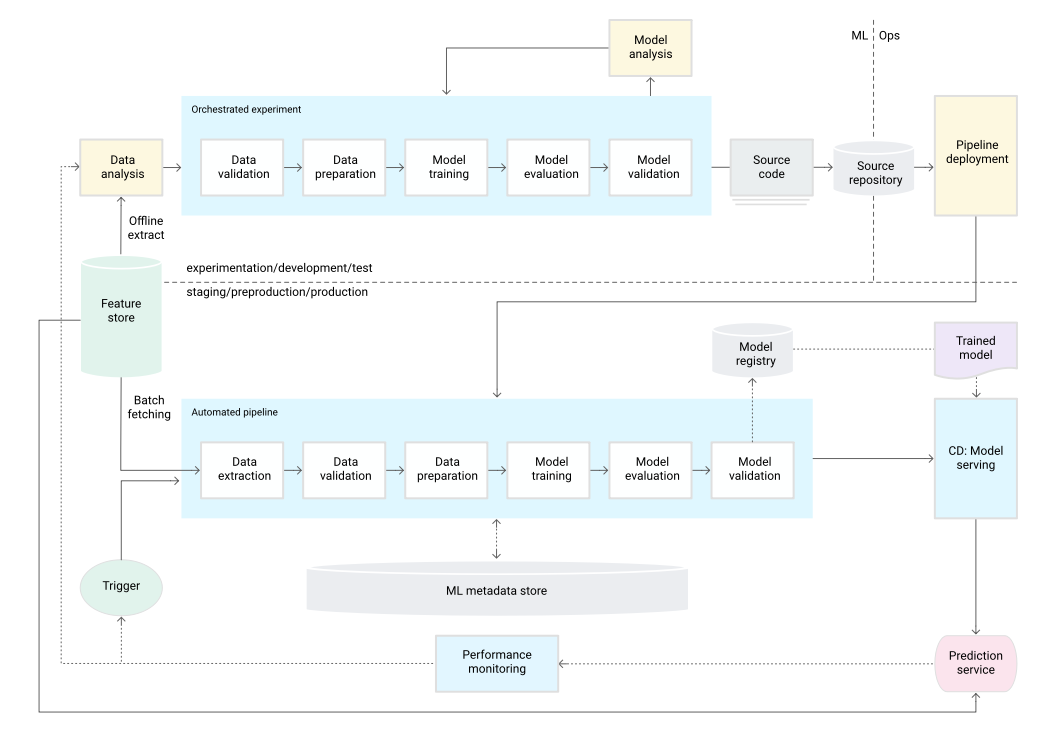
На следующем рисунке представлена подробня схема автоматизированного ML-конвейера для CT.
Характеристики
Список основных характеристик процесса MLOps уровня 1, изображенного на рисунке 3:
- Быстрый эксперимент: Этапы ML-эксперимента оркестрованы. Переход между этапами автоматизирован, что приводит к быстрой итерации экспериментов и лучшей готовности к переводу всего конвейера в производство.
- CT модели в производстве: Модель автоматически обучается в производстве на свежих данных на основе триггеров конвейера, которые обсуждаются в следующем разделе.
- Экспериментально-операционная симметрия: Реализация конвейера, используемая в среде разработки или эксперимента, используется в предпроизводственной и производственной среде, что является ключевым аспектом практики MLOps для унификации DevOps.
-
Модулированный код для компонентов и конвейеров: Для построения конвейеров ML компоненты должны быть многократно используемыми, композитными и потенциально разделяемыми между конвейерами ML. Поэтому, хотя код EDA может по-прежнему храниться в блокнотах, исходный код компонентов должен быть модульным. Кроме того, в идеале компоненты должны быть контейнеризированы для того, чтобы можно было сделать следующее:
- Отделить среду выполнения от среды выполнения пользовательского кода.
- Обеспечить воспроизводимость кода в средах разработки и производства.
- Изолировать каждый компонент в конвейере. Компоненты могут иметь собственную версию среды выполнения, разные языки и библиотеки.
- Непрерывная доставка моделей: Конвейер ML в производстве непрерывно предоставляет услуги прогнозирования для новых моделей, обученных на новых данных. Этап развертывания модели, на котором обученная и проверенная модель используется в качестве службы предсказаний для онлайн-прогнозирования, автоматизирован.
- Развертывание конвейера: На уровне 0 Вы развертываете обученную модель в качестве службы прогнозов на производстве. На уровне 1 Вы развертываете целый конвейер обучения, который запускается автоматически.
Дополнительные компоненты
В этом разделе рассматриваются компоненты, которые необходимо добавить в архитектуру для обеспечения непрерывного обучения ML.
Проверка данных и модели
Когда Вы развертываете конвейер ML в производстве, один или несколько триггеров, рассмотренных в разделе «Триггеры конвейера ML», автоматически запускают конвейер. Конвейер ожидает новых, «живых» данных для создания новой версии модели, которая обучается на новых данных (как показано на рисунке 3). Поэтому в производственном конвейере должны быть предусмотрены шаги по проверке данных и проверке модели для обеспечения следующего:
- Проверка данных: Этот шаг необходим перед обучением модели для того, чтобы решить, следует ли повторно обучить модель или лучше остановить конвейер. Это решение принимается автоматически, если конвейер выявил следующее:
- Перекосы в схеме данных: Эти искажения считаются аномальными, поэтому входные данные, которые не соответствуют ожидаемой схеме, поступают на последующие этапы конвейера, включая этапы обработки данных и обучения модели. В этом случае следует остановить конвейер для того, чтобы команда специалистов по Data Science могла провести расследование. К перекосам в схеме относятся получение неожиданных признаков, получение не всех ожидаемых признаков или получение признаков с неожиданными значениями.
- Перекосы в значениях данных: Эти перекосы представляют собой значительные изменения в статистических свойствах данных, что означает то, что модели данных меняются, и Вам необходимо запустить переобучение модели, чтобы учесть все эти изменения.
- Проверка модели: Этот шаг выполняется после успешного обучения модели на основе новых данных. Вы оцениваете и проверяете модель перед ее внедрением в производство. Этот этап проверки модели в автономном режиме состоит из следующих действий:
- Получение значений метрики оценки с помощью обученной модели на тестовом наборе данных для оценки прогностического качества модели.
- Сравнение значений метрик оценки, полученных новой обученной моделью, с метриками текущей моделью, например, с производственной моделью, базовой моделью или другими моделями. Так Вы сможете убедиться в том, что новая модель демонстрирует лучшую производительность, чем текущая модель. Как только Вы в этом убедитесь, Вы сможете запустить ее в производство.
- Убедитесь в том, что производительность модели соответствует сегментам данных. Например, Ваша новая обученная модель оттока клиентов может дать в целом более высокую точность прогнозирования по сравнению с предыдущей моделью, но значения точности по регионам клиентов могут иметь большой разброс.
- Убедитесь в том, что Вы протестировали свою модель для развертывания, включая ее совместимость с инфраструктурой и согласованность с API сервиса прогнозирования.
В дополнение к проверке офлайн-модели, новая развернутая модель должна пройти проверку онлайн-модели в канареечном развертывании или A/B-тестировании.
Хранилище характеристик
Дополнительным компонентом для автоматизации конвейера ML первого уровня является хранилище характеристик. Хранилище характеристик - это централизованный репозиторий, в котором стандартизированы определение, хранение и доступ к признакам для обучения и обслуживания, который должен предоставлять API как для высокопроизводительной пакетной обработки, так и для замедленной обработки значений признаков в режиме реального времени, а также поддерживать рабочие нагрузки как при обучении, так и при обслуживании модели.
Хранилище характеристик помогает специалистам Data Science сделать следующее:
- Обнаружение и повторное использование имеющихся наборов признаков для своих сущностей вместо повторного создания таких же или похожих признаков.
- Избегайте наличия похожих признаков с разными определениями, поддерживая признаки и связанные с ними метаданные.
- Предоставляйте актуальные значения признаков из хранилища признаков.
- Избегайте перекосов в обслуживании при обучении, используя хранилище признаков в качестве источника данных для экспериментов, непрерывного обучения и онлайн-сервиса. Такой подход позволяет убедиться, что функции, используемые для обучения, совпадают с теми, которые используются в следующих случаях:
- Для проведения экспериментов специалисты по исследованию данных могут получить экстракт из хранилища признаков, необходимый для проведения эксперимента.
- Для непрерывного обучения автоматизированный конвейер обучения ML может получить пакет актуальных значений признаков из набора данных, которые используются для обучения модели.
- Для онлайн-прогнозирования служба прогнозирования может получать пакетные значения признаков, относящихся к запрашиваемому объекту, например демографические характеристики клиента, характеристики продукта и характеристики агрегации текущей сессии.
- Для онлайн-прогнозирования и поиска признаков служба прогнозирования определяет соответствующие признаки для сущности. Например, если сущность является клиентом, соответствующие признаки могут включать возраст, историю покупок и поведение в браузере. Служба группирует значения этих признаков вместе и извлекает все необходимые признаки для сущности сразу, а не по отдельности. Такой метод поиска помогает повысить эффективность, особенно если Вам нужно управлять сразу несколькими сущностями.
Управление метаданными
Информация о работе ML-конвейера фиксируется для того, чтобы помочь в отслеживании данных и артефактов, их воспроизводимости и сравнении. Она также помогает отлаживать ошибки и аномалии. При каждом выполнении конвейера в хранилище метаданных ML записываются следующие метаданные:
- Версии конвейера и компонентов, которые были выполнены.
- Дата начала и окончания, время и продолжительность выполнения каждого шага конвейера.
- Исполнитель конвейера.
- Аргументы параметров, которые были переданы конвейеру.
- Указатели на артефакты, созданные на каждом этапе конвейера, такие как местоположение подготовленных данных, аномалии при проверке, вычисленная статистика и извлеченная лексика из категориальных признаков. Отслеживание этих промежуточных результатов помогает возобновить конвейер с самого последнего шага, если конвейер остановился из-за неудачного шага, без необходимости повторно выполнять уже завершенные шаги.
- Указатель на предыдущую обученную модель, если Вам нужно вернуться к предыдущей версии модели или вывести метрики оценки для предыдущей версии модели, когда конвейеру предоставляются новые тестовые данные на этапе проверки модели.
- Метрики оценки модели, получаемые на этапе оценки модели как для обучающих, так и для тестовых наборов. Эти метрики помогают сравнить производительность вновь обученной модели с производительностью предыдущей модели на этапе проверки модели.
Триггеры конвейера ML
Вы можете автоматизировать производственные конвейеры ML для переобучения моделей с использованием новых данных:
- По требованию: Специальное ручное обслуживание конвейера.
- По расписанию: Новые помеченные данные систематически предоставляются системе ML на ежедневной, еженедельной или ежемесячной основе. Частота переобучения также зависит от того, как часто меняются шаблоны данных и насколько дорого обходится переобучение моделей.
- В зависимости от наличия новых обучающих данных: Новые данные не являются систематически доступными для системы ML, а предоставляются от случая к случаю, когда новые данные собираются и становятся доступными в исходных базах данных.
- В случае снижения производительности модели: Модель переобучается при заметном снижении производительности.
- При значительных изменениях в распределении данных (дрифт концепта). Производительность онлайн-модели оценить сложно, но если Вы заметили значительные изменения в распределениях данных по признакам, которые используются для прогнозирования, знайте, что эти изменения указывают на то, что Ваша модель устарела и ее необходимо переобучить на свежих данных.
Трудности
Если предположить, что новые реализации конвейера развертываются не часто, и Вы управляете всего несколькими конвейерами, то тестирование конвейера и его компонентов обычно осуществляется вручную. Кроме того, Вы вручную развертываете новые реализации конвейера. Вы также передаете протестированный исходный код конвейера ИТ-команде для развертывания в целевой среде. Такая схема подходит в том случае, если Вы развертываете новые модели на основе новых данных, а не на основе новых идей ML.
Однако Вам обязательно необходимо опробовать новые идеи ML и быстро развернуть новые реализации компонентов ML. Если Вы управляете множеством конвейеров ML в производстве, то Вам просто необходима настройка CI/CD для автоматизации сборки, тестирования и развертывания конвейеров ML.
MLOps уровень 2: автоматизация конвейера CI/CD
Для быстрого и при этом надежного обновления конвейеров в производстве Вам нужна надежная автоматизированная система CI/CD, которая позволяет специалистам по анализу данных быстро исследовать новые идеи в области разработки функций, архитектуры моделей и гиперпараметров. Они могут реализовывать эти идеи и автоматически собирать, тестировать и разворачивать новые компоненты конвейера в целевой среде.
На следующей схеме показана реализация ML-конвейера с использованием CI/CD, обладающего характеристиками автоматизированного ML-конвейера плюс автоматизированными процедурами CI/CD.
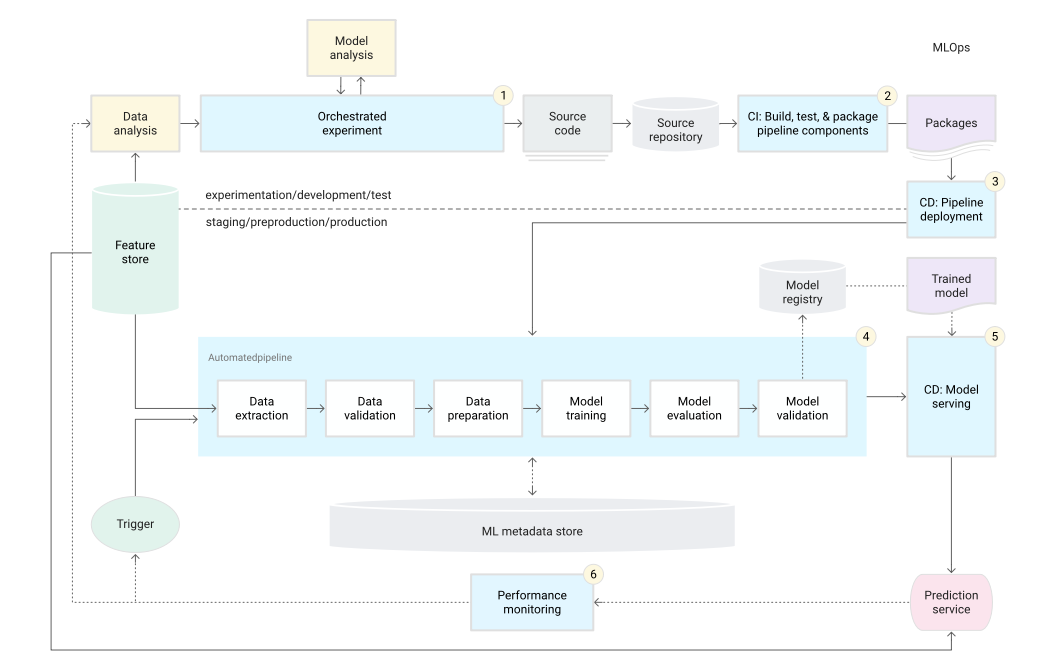
Эта настройка MLOps включает в себя следующие компоненты:
- Контроль источников
- Сервисы тестирования и сборки
- Сервисы развертывания
- Реестр моделей
- Хранилище характеристик
- Хранилище метаданных ML
- Оркестратор пайплайнов ML
Характеристики
На следующей схеме показаны этапы конвейера автоматизации ML CI/CD:
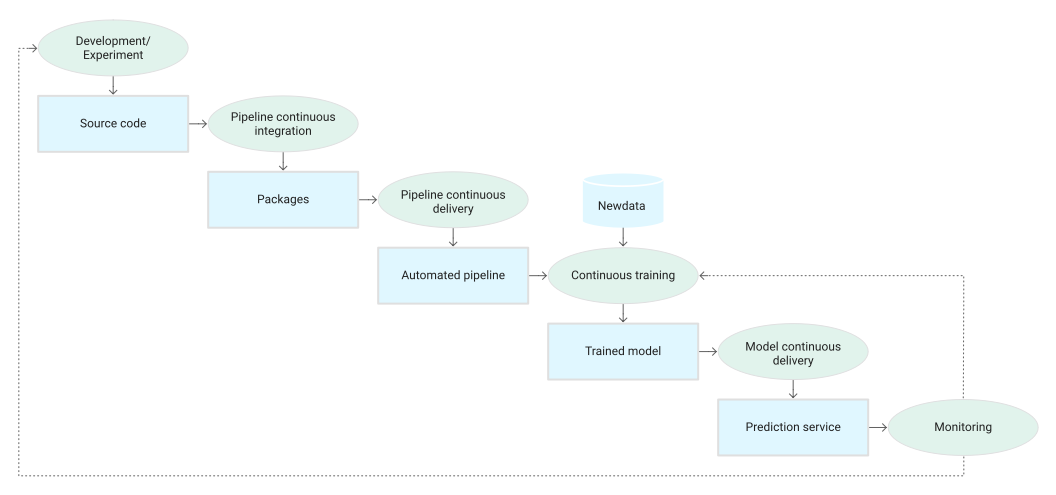
Конвейер состоит из следующих этапов:
- Разработка и эксперименты: Вы итеративно пробуете новые алгоритмы ML и новое моделирование. Результатом этого этапа является получение исходного кода шагов ML-конвейера, который затем размещается в репозитории исходных текстов.
- Непрерывная интеграция конвейера: Сборка исходного кода и запуск различных тестов. Результатом этого этапа являются компоненты конвейера (пакеты, исполняемые файлы и артефакты), которые будут развернуты на более позднем этапе.
- Конвейер непрерывной доставки: Вы развертываете артефакты, созданные на этапе CI, в целевой среде. Результатом этого этапа является развернутый конвейер с новой реализацией модели.
- Автоматизированный запуск: Конвейер автоматически выполняется в производстве по расписанию или в ответ на триггер. Результатом этого этапа является обученная модель, которая помещается в реестр моделей.
- Непрерывная доставка модели: Вы предоставляете обученную модель в качестве сервиса предсказаний для прогнозирования. Результатом этого этапа является развернутая служба предсказаний модели.
- Мониторинг: Вы собираете статистику о производительности модели на основе реальных данных. Результатом этого этапа является триггер для выполнения конвейера или нового цикла эксперимента.
Этап анализа данных по-прежнему выполняется вручную специалистами по анализу данных до того момента, как конвейер начнет новую итерацию эксперимента. Этап анализа модели также выполняется вручную.
Непрерывная интеграция
При такой настройке конвейер и его компоненты собираются, тестируются и упаковываются при фиксации или размещении нового кода в репозитории исходного кода. Помимо сборки пакетов, образов контейнеров и исполняемых файлов, процесс CI может включать в себя следующие тесты:
- Юнит-тестирование логики разработки функций.
- Юнит-тестирование различных методов, реализованных в Вашей модели. Например, у Вас есть функция, принимающая категориальный столбец данных, и Вы кодируете эту функцию как одноточечный признак.
- Тестирование того, что обучение модели прошло успешно(то есть потери модели уменьшаются за счет итераций).
- Проверка того, что при обучении модели нет значений NaN, возникающих из-за деления на ноль или манипуляций с малыми или большими значениями.
- Проверка того, что каждый компонент конвейера производит ожидаемые артефакты.
- Тестирование интеграции между компонентами конвейера.
Непрерывная доставка
На этом уровне Ваша система непрерывно поставляет новые реализации конвейеров в целевую среду, которая, в свою очередь, предоставляет услуги прогнозирования только что обученной модели. Для быстрой и надежной непрерывной доставки конвейеров и моделей Вам следует учесть следующее:
- Проверка совместимости модели с целевой инфраструктурой перед ее развертыванием. Например, необходимо убедиться в том, что пакеты, необходимые для модели, установлены в обслуживающей среде, а также то, что имеются все необходимые ресурсы памяти, вычислительной техники и ускорителей.
- Тестирование службы прогнозирования путем вызова API службы с ожидаемыми входными данными и получения ожидаемого ответа. Обычно этот тест позволяет выявить проблемы, которые могут возникнуть при обновлении версии модели, когда она ожидает другой входной информации.
- Тестирование производительности службы прогнозирования, которое включает в себя нагрузочное тестирование службы для получения таких показателей, как количество запросов в секунду (QPS) и задержка модели.
- Проверка данных для переобучения или пакетного прогнозирования.
- Проверка соответствия моделей целевым показателям эффективности прогнозирования до их развертывания.
- Автоматическое развертывание в тестовой среде, например, развертывание, инициируемое переносом кода в ветку разработки.
- Полуавтоматическое развертывание в предпроизводственной среде, например, развертывание, инициируемое слиянием кода в основную ветку после одобрения изменений рецензентами.
- Ручное развертывание в производственной среде после нескольких успешных запусков конвейера на предпроизводственной среде.
Подводя итог, можно сказать, что внедрение ML в производственную среду означает не только развертывание модели в виде API для прогнозирования. Скорее, речь идет о развертывании конвейера ML, который может автоматизировать переобучение и развертывание новых моделей. Создание системы CI/CD позволяет автоматически тестировать и развертывать новые реализации конвейера. Такая система позволяет эффективно справляться с быстрыми изменениями в данных и бизнес-среде. Не обязательно сразу переводить все процессы с одного уровня на другой, Вы можете внедрять эти практики постепенно. Так Вы сможете повысить уровень автоматизации разработки и производства систем ML.


