

Понимание модели согласованности Apache Iceberg, часть 2
В этой статье мы рассмотрим средства контроля параллелизма и проверки данных на конфликты в Apache Iceberg, которые предоставляют вычислительным машинам движки для предложения транзакций с уровнем изоляции Serializable и Snapshot. Мы сосредоточимся на сценариях с несколькими писателями, как и во всей этой серии статей, посвязенных форматам таблиц.
Корректность Iceberg в сценариях с несколькими писателями
Iceberg поддерживает возможность одновременной записи несколькими писателями в одну и ту же таблицу (а также в разные таблицы, хотя это выходит за рамки данной статьи). Упрощенная модель записи состоит из нескольких шагов:
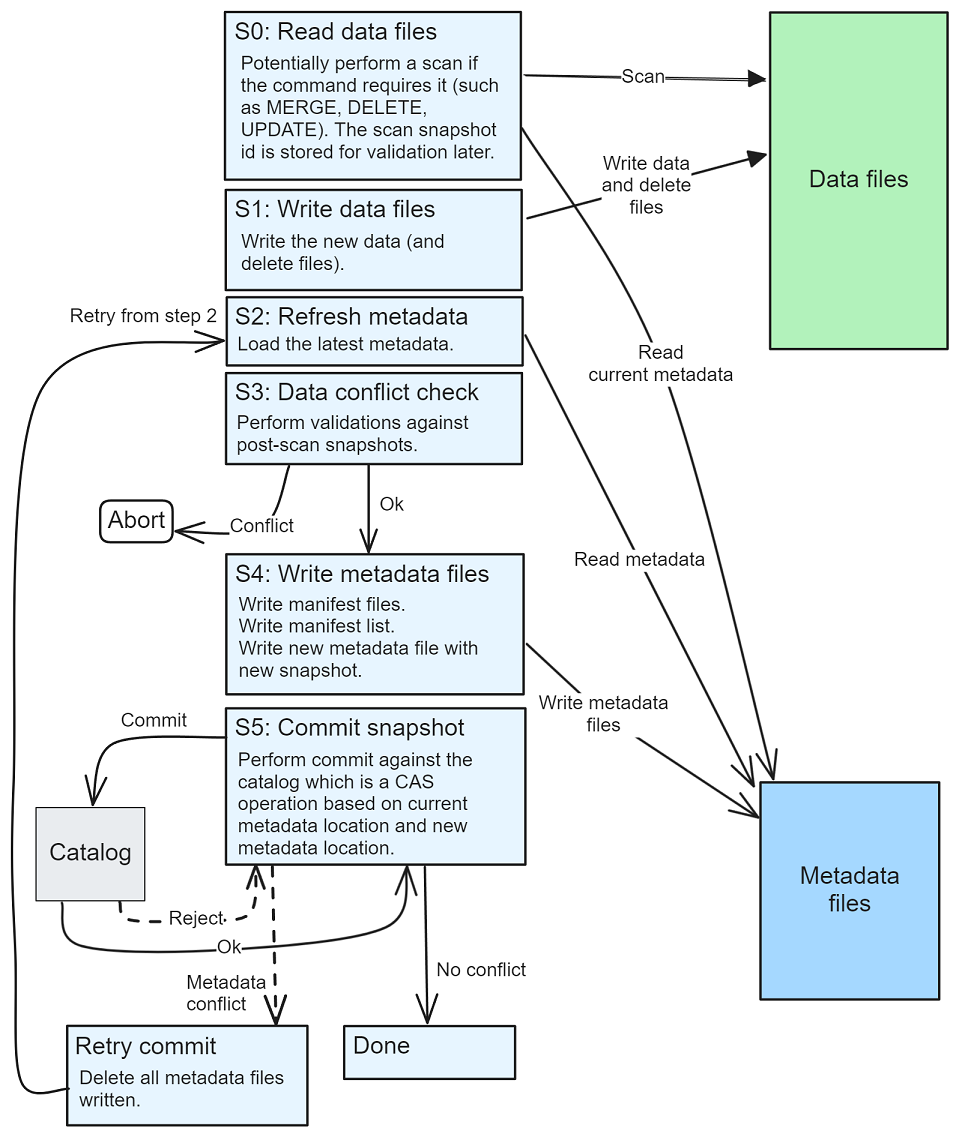
Специфика этих шагов зависит от типа выполняемой операции записи, существует несколько различных типов операций.
Проверка данных на конфликты + коммит файла метаданных
Основой обеспечения согласованности данных в Iceberg являются проверка данных на конфликты и атомарный коммит файла метаданных.
Коммит файла метаданных - это операция сравнения и замены, при которой записывающее устройство предоставляет текущее местоположение метаданных и новое местоположение файла метаданных, который оно только что записало. Чтобы фиксация была безопасной, каталог должен выполнить атомарный CAS. Если текущее местоположение файла метаданных, предоставленное писателем, не совпадает с текущим местоположением, известным каталогу, коммит будет отклонен. Это гарантирует то, что коммит произойдет только в том случае, если новые метаданные были записаны на основе текущих метаданных, а не устаревшей версии. Если писатель основывает свои метаданные на устаревшем файле метаданных и может зафиксировать их, все зафиксированные изменения, которые произошли в актуальной текущей версии метаданных, будут потеряны.

Здесь важно понимать, что версия метаданных, используемая при сканировании таблицы, и версия, используемая в качестве основы для записи новых метаданных, могут быть разными. Пока операция находится в фазе чтения и записи, другая операция может зафиксировать новый снимок - этот снимок будет загружен на шаге 2, иображенном выше. Это не всегда приводит к конфликту, как мы увидим далее.
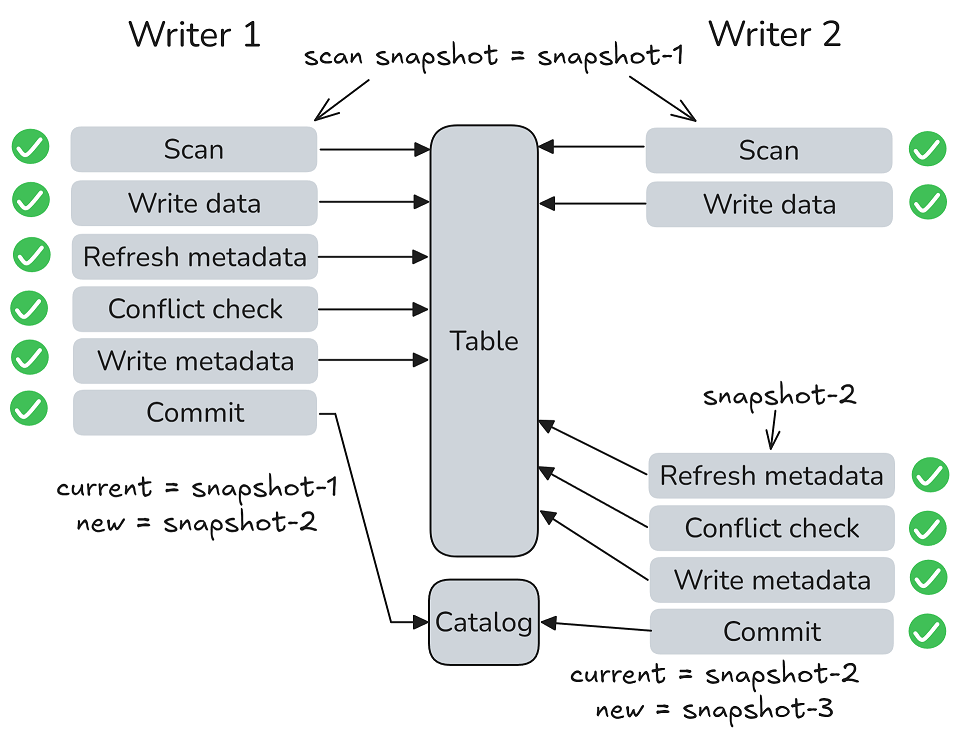
Однако при другом чередовании писатель 2 обновляет свои метаданные до коммита писателя 1, поэтому его коммит метаданных не пройдет (поскольку обновленные метаданные являются устаревшими).
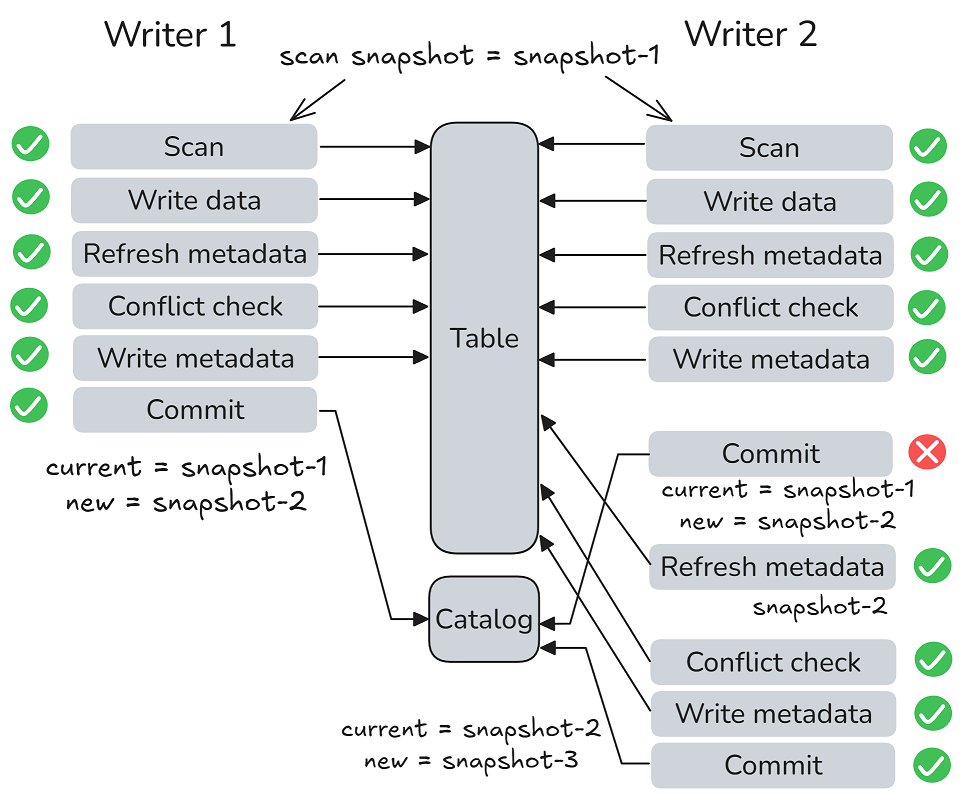
В случае отказа писателю не нужно прерывать операцию, он может повторить коммит, если ни одно из изменений данных в его операции не конфликтует со снапшотами, зафиксированными после его сканирующего снапшота.
Когда писатель сталкивается с отклонением коммита метаданных, ему необходимо повторить коммит следующим образом:
- Обновление метаданных.
- Повторный запуск проверки конфликта данных.
- Повторная запись файлов метаданных на основе обновленных метаданных.
- Повторное выполнение фиксации каталога с использованием обновленного местоположения метаданных в качестве текущего местоположения.
Но что, если обнаружен конфликт данных?
Проверка данных на конфликт (которая представляет собой набор проверок на основе метаданных) пытается определить, есть ли:
- явные конфликты файлов, например, две операции пытаются логически удалить один и тот же файл данных.
- потенциальные конфликты данных, основанные на фильтрах строк (подробнее об этом я напишу в самое ближайшее время)
Возвращаясь к последовательностям двух писателей, представим, что операции писателя 1 и писателя 2 конфликтуют между собой. При таком чередовании писатель 2 не обнаруживает конфликта в первый раз, но после отклонения коммита метаданных вторая проверка конфликта данных (основанная на обновленных метаданных моментального снимка-2) потерпит неудачу.
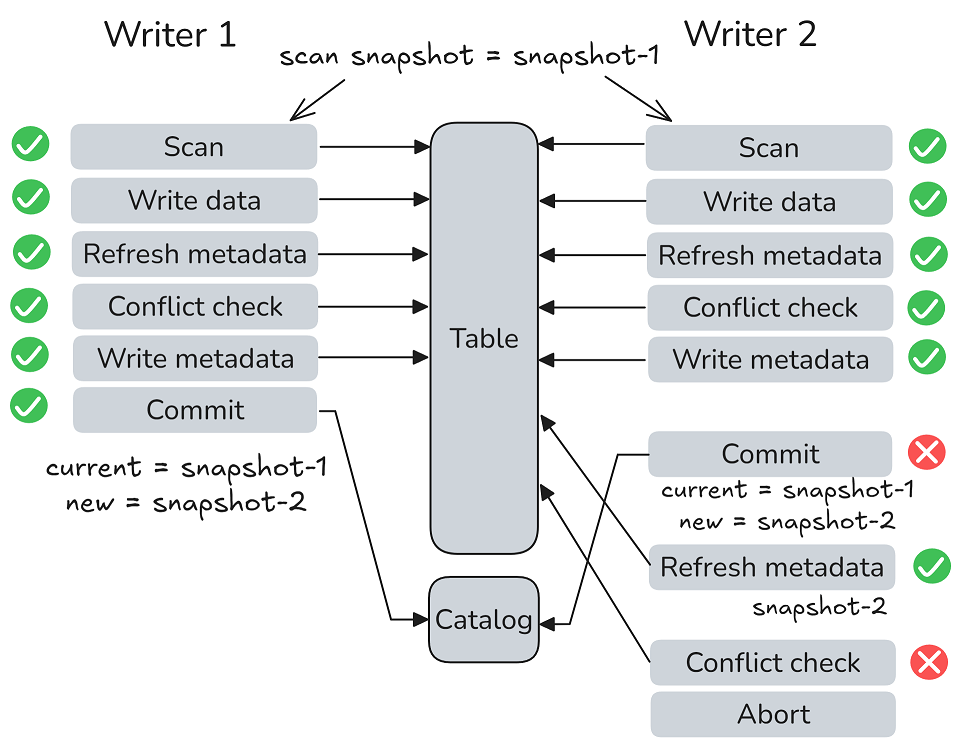
Возвращаясь к последовательностям двух писателей, представим, что операции писателя 1 и писателя 2 конфликтуют. При таком чередовании писатель 2 не обнаруживает конфликта в первый раз, но после отклонения фиксации метаданных вторая проверка конфликта данных (основанная на обновленных метаданныхмоментального снимка-2) терпит неудачу.
Этот высокоуровневый процесс выполняется для всех типов операций, но последовательность шагов для каждого типа операции разная.
Фильтры конфликтов данных
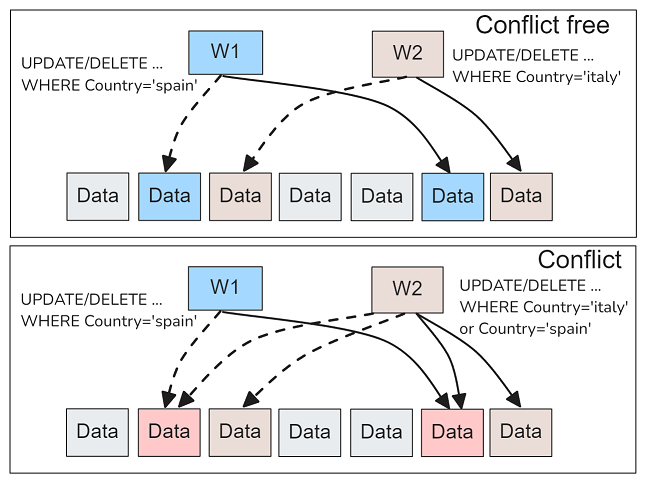
Проверка данных на наличие конфликта - это набор проверок на основе метаданных (если использовать этот термин в кодовой базе). Многие из проверок могут включать в себя необязательный фильтр конфликтов данных, который представляет собой предикат, основанный на строках. Без этого фильтра некоторые проверки оказываются слишком громоздкими и приводят к обнаружению конфликтов, которых на самом деле нет. Например, одна из проверок ищет добавленные файлы, которые могут конфликтовать с операцией фиксации. Без фильтра конфликтов данных проверка будет провалена, если какой-либо файл данных был добавлен в снимок после сканирования. При наличии фильтров конфликтов данных две операции, затрагивающие разные наборы данных, могут пройти проверку и избежать необходимости прерывания одной операции.
Насколько мне известно, в случае Apache Iceberg фильтры конфликтов данных уникальны. Они работают путем фильтрации записей манифеста, которые не могут содержать данные, соответствующие фильтру. Вычислительные машины могут передавать некоторые предикаты запросов в саму Iceberg, чтобы фаза планирования Iceberg могла отсеивать файлы данных. Вычислительный движок может установить эти фильтры запросов как фильтры конфликтов данных.
Проверки обычно считывают манифесты каждого моментального снимка после сканирования, пытаясь найти записи (данные/удаленные файлы), которые могут нарушать соответствующее правило валидации. В процессе чтения записей манифеста применяются фильтры конфликтов данных, чтобы уменьшить число возможных записей манифеста для оценки на соответствие правилу.
Записи манифеста содержат две важные части информации, которые используются при их проверке на соответствие фильтру:
- Спецификация раздела.
- Минимальная/максимальная статистика столбцов для каждого столбца.
Фильтрация записей манифеста осуществляется следующим образом:
Если фильтр конфликта данных содержит все столбцы спецификации разделов, то сам файл манифеста пропускается, если значения спецификации разделов не соответствуют фильтру. Например, если запись манифеста относится к разделу «color=red», но фильтр color == «blue», то запись пропускается.
Каждая запись манифеста (не пропущенная на основании разделов) оценивается путем сравнения предиката фильтра со статистикой столбцов. Если предикат потенциально совпадает с верхней и нижней границами, определенными в статистике столбцов, то запись манифеста является совпадением. Если совпадения нет, то запись пропускается.
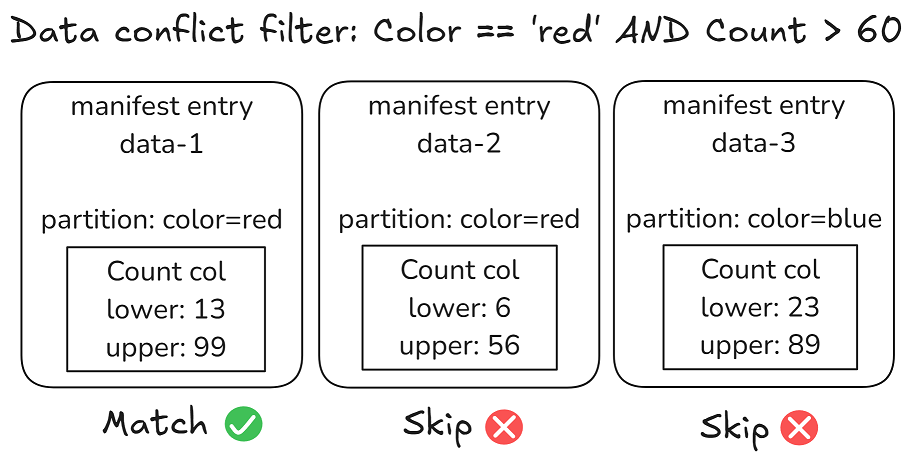
Этот же процесс применяется и для удаления файлов, однако есть несколько отличий:
- Записи манифеста в файлах удаления не хранят статистику столбцов таблицы, как это делают файлы данных. Поэтому к этим записям манифеста можно применять только предикаты, основанные на спецификации разделов.
- Записи манифеста удаленных файлов хранят путь и позицию файла данных в статистике столбцов «путь к файлу удаления» и «позиция», но только если файл удаления ссылается на один файл данных. Я еще не видел того, чтобы какие-либо вычислительные движки использовали эти столбцы статистики.
Когда вычислительные движки устанавливают фильтр конфликтов данных, они тем самым снижают вероятность возникновения конфликтов данных, хотя эффективность этого фильтра во многом зависит от партиционирования и хорошей кластеризации данных. Apache Spark устанавливает фильтр конфликтов данных для всех предикатов, которые могут быть вытеснены в Iceberg.
Операции и их проверки данных на наличие конфликта
В части 1 мы рассмотрели операции COW и MOR, а также процесс уплотнения. В этой части мы сделаем то же самое, но будем ссылаться на названия интерфейсов этих операций в модуле Iceberg API.
В Iceberg существует четыре типа операций:
- APPEND: Операция добавляет только файлы данных.
- OVERWRITE: Операция выполняет обновление/удаление на уровне строки. OVERWRITE может быть COW или MOR.
- REPLACE: Операция уплотнения, которая заменяет набор файлов новыми (логически те же данные, только переписанные в виде набора меньшего количества файлов, возможно, сгруппированных).
- DELETE: Операция только удаляет файлы.
Эти типы операций соответствуют четырем операциям, которые я хочу рассмотреть в этой статье (есть еще несколько, но я не хочу вдаваться в подробности):
- AppendFiles (модуль API)
- Тип APPEND
- Реализации: FastAppend и MergeAppend в основном модуле. MergeAppend выполняет дополнительную работу по объединению файлов манифеста для того, чтобы контролировать количество файлов манифеста, избегая необходимости их уплотнения.
- OverwriteFiles (модуль API):
- Тип OVERWRITE
- COW на уровне строк для UPDATE/DELETE
- Реализация: BaseOverwriteFiles (основной модуль).
- RowDelta (модуль API)
- Тип OVERWRITE
- MOR на уровне строк для UPDATE/DELETE.
- Реализация: BaseRowDelta (основной модуль).
- RewriteFiles (модуль API)
- Тип REPLACE.
- Реализация: BaseRewriteFiles (основной модуль).
Каждая операция реализует проверку данных на наличие конфликтов по-своему, но все они имеют общую высокоуровневую логику процесса коммита, о которой я рассказывал выше.
Эти операции позволяют вычислительным движкам регистрировать добавленные и логически удаленные файлы в рамках фаз чтения/записи и, наконец, вызывать метод commit() (где шаги 2-5 выполняются внутри библиотеки Iceberg).
Операция AppendFiles
Вычислительный движокм вызывает метод appendFile(DataFile file) для каждого файла данных, который он записал, а затем вызывает commit().
Это самая простая операция, поскольку она включает в себя только добавление новых файлов данных, никаких проверок на наличие конфликтов она не выполняет.
Iceberg не предоставляет первичных ключей и не дает гарантий от дублирования. Например, если два писателя выполнят одну и ту же команду INSERT INTO Favourites(Name, FavColor, FavLetter) VALUES('jack', 'red', 'A'), то в таблице окажутся две одинаковые строки. Поскольку Iceberg не поддерживает первичные ключи, операции добавления не проверяются на наличие конфликтов, поскольку предполагается, что никакая другая операция не может конфликтовать с ней. Обратное может быть не верно, поскольку другие операции могут считать, что операция добавления может конфликтовать с ними.
Операция OverwriteFiles (copy-on-write)
Операция OverwriteFiles позволяет вычислительному движку добавлять и логически удалять файлы данных. Вычислительный движок может вызывать:
- addFile(DataFile file) для каждого файла данных, который он записал и хочет добавить в новый снапшот (мы будем называть это добавленным набором).
- deleteFile(DataFile file) для каждого файла данных, который он хочет логически удалить в новом снимке (мы будем называть это удаленным набором).
Наконец, движок вызывает commit(), где добавленный и удаленный наборы проверяются и фиксируются.
Между параллельными писателями существует ряд возможных конфликтов:
- Две операции OverwriteFiles обновляют строку в одном и том же файле данных. Обе операции логически удаляют один и тот же файл, но каждая из них записывает новую версию этого файла. Такой конфликт также возможен между операциями OverwriteFiles и RewriteFiles (уплотнение).
- Операция OverwriteFiles, выполняющая обновление или удаление, конфликтует с операцией RowDelta, выполняющей обновление или удаление. Сначала фиксируется RowDelta, затем операция OverwriteFiles удаляет файл данных, на который ссылается файл удаления RowDelta.
Давайте рассмотрим первый пример. Рисунок, приведенный ниже, описывает, как snapshot-1 был текущим snapshot, когда вычислительный движок запустил две параллельные операции OverwriteFiles, выполняющие команды UPDATE (операции A и B). Обе команды обновляют разные строки файла данных data-1, используя копирование при записи. Операция A фиксирует, а операция B собирается зафиксировать.
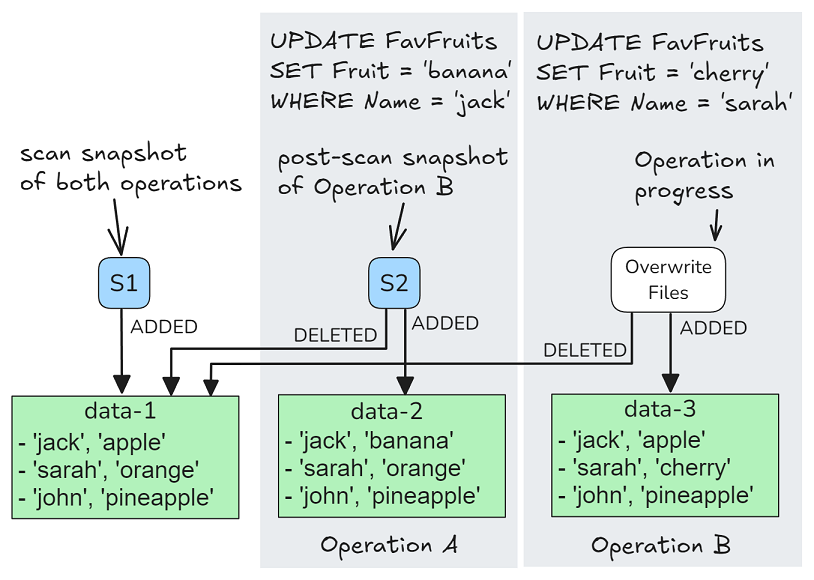
Если бы операция B вообще не выполняла проверки данных на наличие конфликта и, следовательно, успешно выполнила бы коммит, это привело бы к непоследовательной работе с файлами метаданных. Данные-1 не были бы членами набора данных, в то время как данные-2 и данные-3 были бы членами набора данных, создавая дублирование и конфликтующие значения для «Jack» и «Sarah».
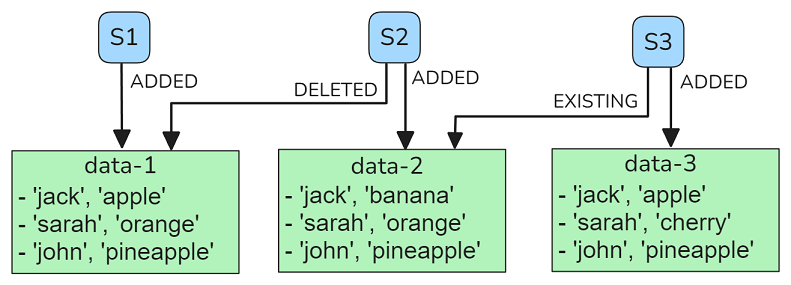
Причина заключается в том, что при таком чередовании операция B обновила свои метаданные сразу после коммита операции A, поэтому она могла видеть снапшот-2. Она основывала свои изменения на снимке-2, который удалил данные-1. Когда операция B записывала свои метаданные, она полностью отфильтровала данные-1, так как они были удалены на моментальном снимке-2, и создала новый файл манифеста для данных-3. Файл manifest-list включал файлы манифеста, в которых перечислялись данные-2 и данные-3.
Если это непонятно, то прочитайте первую часть, где подробно рассказывается о том, как манипулировать файлами манифеста.
Обнаружение конфликтов в OverwriteFiles позволяет обнаружить и предотвратить этот и другие конфликты. OverwriteFiles предлагает вычислительному движку три проверки на наличие конфликта:
- Проверка отсутствия путей удаления запускается в том случае, если включена одна из двух следующих проверок.
- Проверка отсутствия новых удалений для файлов данных с помощью метода validateNoConflictingDeletes().
- Добавлена проверка файлов данных с помощью метода validateNoConflictingData().
Ошибка проверки отсутствия путей удаления
Я начну именно с этой проверки, поскольку она является основной защитой от конфликтов OverwriteFiles/OverwriteFiles и OverwriteFiles/RewriteFiles. Она включается в том случае, когда включена любая из двух других проверок.
Эта проверка выполняется на этапе записи метаданных (после основного этапа проверки) сразу после чтения физических манифестов и преобразования их в логические манифесты. В процессе чтения физических и логических манифестов любая запись манифеста со статусом ADDED или EXISTING, входящая в удаленный набор операции, преобразуется в DELETED. После загрузки логических манифестов эта проверка на наличие конфликтов гарантирует, что все файлы данных из удаленного набора появятся как записи со статусом DELETED в логических файлах манифеста, если они не прошли проверку на достоверность.
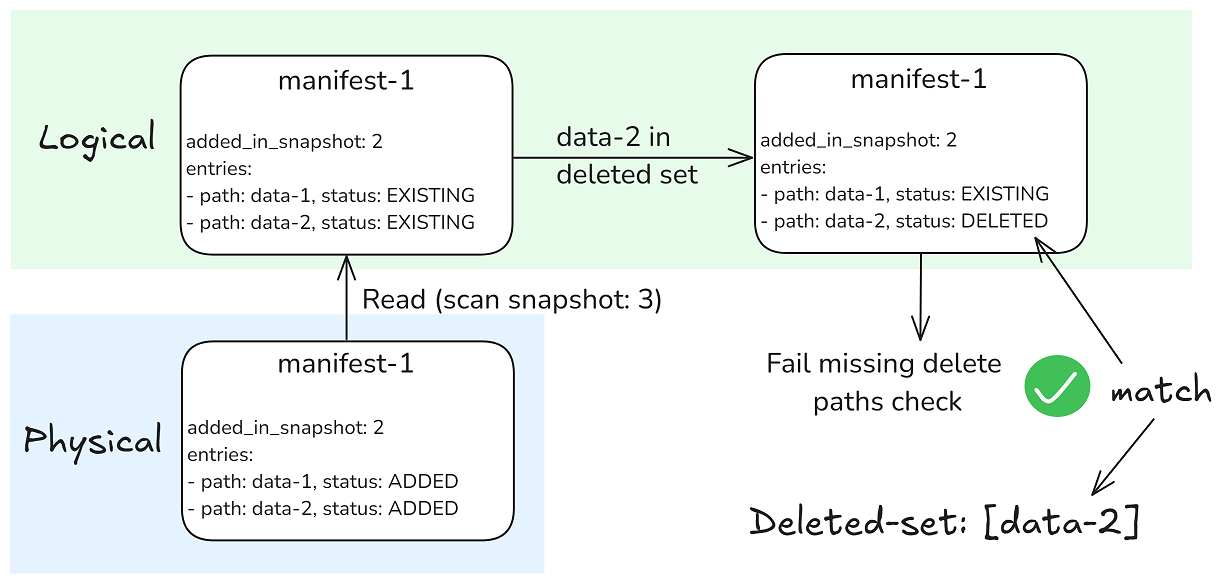
В другом примере можно увидеть, как проверка терпит неудачу:
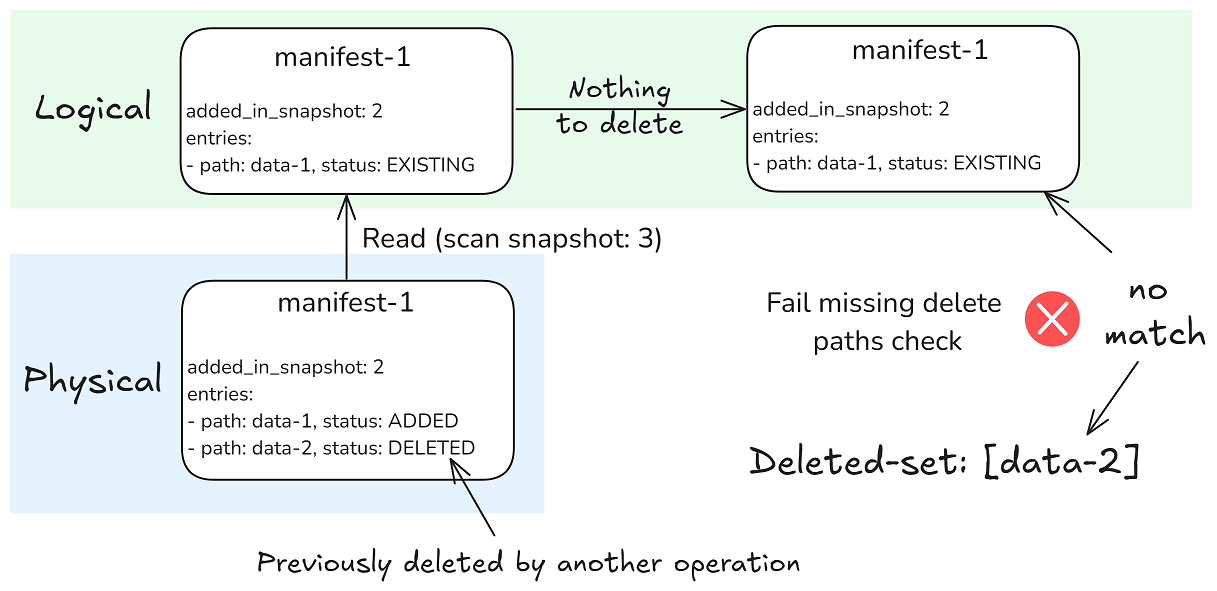
В нашем примере с операцией A/B эта проверка не позволяет операции B выполнить коммит. У операции B есть удаленный набор [data-1]; однако, когда она читает логические манифесты, data-1 отфильтровывается, поскольку он уже был удален в снапшоте-2. Эта проверка не проходит, так как данные-1 не указаны ни в одном логическом манифесте. Таким образом, непоследовательного коммита удается избежать.
Отсутствие новых удалений для проверки файлов данных
Эта проверка перебирает все снимки после сканирования и проверяет, соответствуют ли удаленные файлы следующим параметрам:
- Порядковый номер файла удаления > порядкового номера снимка сканирования (т. е. добавляется после снимка сканирования).
- Добавлено как часть операции DELETE или OVERWRITE.
- Соответствует необязательному фильтру конфликтов данных.
- Ссылается на файл данных, который был логически удален этой операцией.
Фильтр конфликтов данных действует на файлы удаления только в том случае, если фильтр включает столбцы спецификации разделов. Это позволяет исключить удаление файлов разделов, которые не соответствуют фильтру.
OverwriteFiles может (логически) удалять файлы данных, но не добавлять файлы удаления. Другая операция может добавить новые файлы удаления, если это операция RowDelta (которая является слиянием при чтении). Помните, что вычислительные движки, такие как Apache Spark, позволяют отдельно настраивать команды UPDATE, DELETE и MERGE на использование COW или MOR. Эта проверка предотвращает конфликт изменения уровня строки COW (OverwriteFiles) с зафиксированной операцией MOR (RowDelta).
Проверка добавленного файла данных
Эта проверка перебирает все снимки после сканирования и проверяет, соответствуют ли записи в манифесте следующим параметрам:
- статус=ADDED
- Добавляется как часть операции типа APPEND или OVERWRITE (но не REPLACE). Помните, что REPLACE используется только при уплотнении, которое не изменяет данные логически, а только оптимизирует их хранение.
- Соответствие любым (необязательным) фильтрам конфликтов данных.
Если какие-либо записи манифеста совпадают, то сразу же обнаруживается конфликт, операция должна быть прервана. При этой проверке следует использовать фильтр конфликтов данных. Spark включает эту проверку только для уровня изоляции Serializable для того, чтобы избежать одновременных операций, вносящих изменения в данные, которые соответствуют одним и тем же фильтрам запросов.
Запуск проверок
Вычислительный движок может включить эти проверки с помощью следующих методов интерфейса OverwriteFiles:
- validateNoConflictingData()
- validateNoConflictingDeletes()
Apache Spark включает обе функции при изоляции Serializable и только validateNoConflictingDeletes() при изоляции Snapshot. Только одна из них необходима для включения проверки, которая критична для OverwriteFiles, поскольку позволяет избежать конфликтов с другими OverwriteFiles или RewriteFiles (уплотнение). validateNoConflictingDeletes() критична для OverwriteFiles, поскольку позволяет избежать конфликтов с операциями RowDelta.
Операция RowDelta (merge-on-read)
Операция RowDelta позволяет вычислительному движку добавлять файлы данных и файлы удаления (удаление по позиции или по равенству). Вычислительный движок может вызвать:
- addRows(DataFile file) для каждого файла данных, который он записал и хочет добавить в новый снапшот (мы будем называть это added-set).
- addDeletes(DeleteFile deletes) для каждого файла удаления, который он хочет добавить в новый снимок (мы будем называть это набором delete-set).
Наконец, движок вызывает commit(), где добавленный набор и удаленный набор проверяются и фиксируются.
Существует ряд возможных конфликтов данных между параллельными писателями:
- Эта операция создала файл удаления, ссылающийся на файл данных, который был логически удален другой операцией, например OverwriteFiles или RewriteFiles (уплотнение).
- Две операции RowDelta изменяют один и тот же ряд. Одна удаляет строку, а другая обновляет ее. В итоге мы получаем два файла удаления, указывающих на один и тот же исходный ряд, и один новый файл данных с обновленным рядом. Операция удаления фактически не работает.
Давайте рассмотрим первый конфликт, в котором DELETE настроен на использование COW, а UPDATE - на использование MOR.
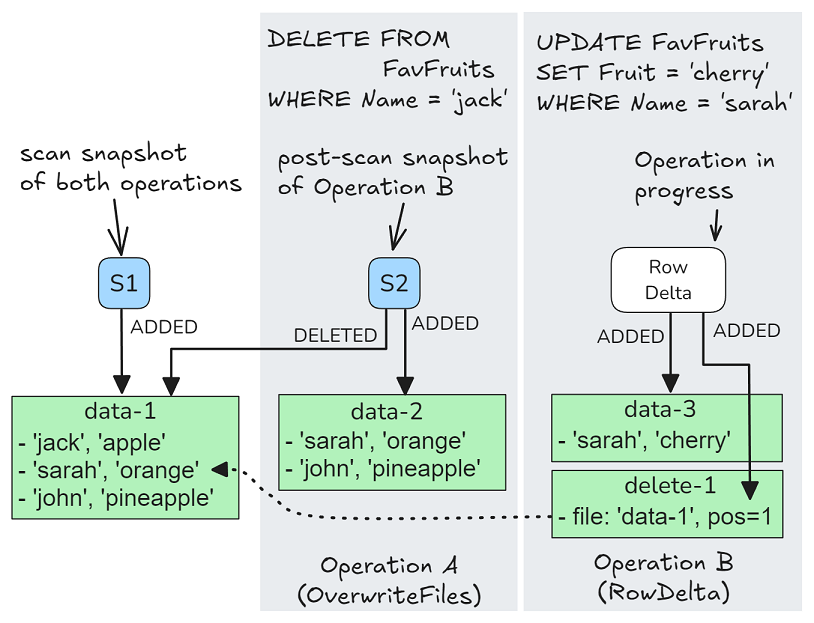
Если бы операция B не выполняла никаких проверок на наличие конфликта, то таблица имела бы следующий вид:
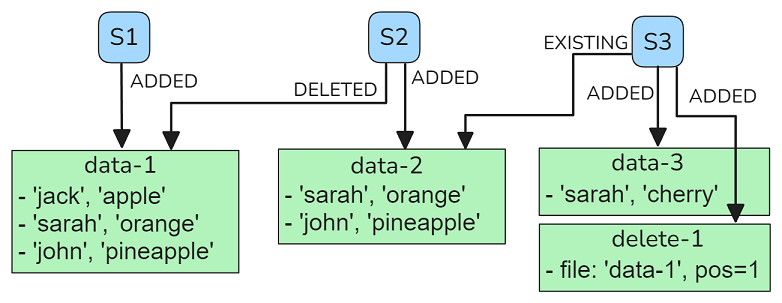
Но для предотвращения этого и других конфликтов существует специальная проверка данных.
- Проверка существующих файлов данных, всегда включена.
- Проверка на отсутствие новых файлов удаления не производится, с помощью метода validateNoConflictingDeleteFiles().
- Проверка добавленных файлов данных с помощью метода validateNoConflictingDataFiles().
Проверка существующих файлов данных
В ходе этой проверки выполняется итерация снимков после сканирования. Коме того, проходит проверка на предмет того, соответствуют ли файлы данных следующим параметрам:
- статус=DELETED
- Удаленные данные как часть операции типа REPLACE или OVERWRITE.
- Если вычислительный движок вызывает validateDeletedFiles(), то он также включает манифесты, добавленные операцией типа DELETE.
- На него ссылается удаляемый файл, добавляемый этой операцией.
Если какой-либо элемент манифеста соответствует вышеуказанному, то проверка завершится неудачей.
В нашем примере с операцией A/B эта проверка будет неудачной. Операция B ссылается на данные-1 в своем файле удаления, но данные-1 не являются членом набора данных в моментальном снимке-2.
Проверка на отсутствие новых файлов удаления
При этой проверке выполняется итерация снимков после сканирования. Проходит проверка на предмет того, соответствуют ли все удаленные файлы следующим параметрам:
- статус=ADDED
- Порядковый номер файла удаления > порядкового номера снимка сканирования (т.е. добавлен после снимка сканирования). Мы заботимся только о новых удалениях, но порядковые номера накладывают ограничения на то, к каким строкам применяется удаление по равенству - удаление по равенству с порядковым номером выше, чем порядковый номер снимка сканирования, что может привести к недействительности результатов фазы чтения.
- Добавляется как часть операции типа OVERWRITE или DELETE.
- Соответствие любым (необязательным) фильтрам конфликтов данных.
Фильтр конфликтов данных действует на файлы удаления только в том случае, если фильтр включает столбцы спецификации разделов. Это позволяет исключить файлы удаления разделов, которые не соответствуют фильтру.
Если какие-либо файлы удаления соответствуют выше указанным параметрам, то проверка не пройдет. Без фильтра конфликтов данных эта проверка будет неудачной, если какая-либо другая операция RowDelta зафиксировала файл удаления в снимке после сканирования. Это серьезно ограничивает параллелизм операций RowDelta. Фильтр конфликтов данных может фильтровать файлы удаления только на основе спецификации раздела, поэтому правильная разбивка на разделы для топологии с несколькими писателями очень важна.
Без этой проверки возможен случай «неудаления». По сути, это две операции RowDelta, одна из которых является удалением по позиции (хотя она также применима к удалению по равенству), а другая - обновлением, причем обе нацелены на одну и ту же строку. Со следующим чередованием:
- Писатель 1 запускает обновление, UPDATE Fruits SET FavFruit = 'banana' WHERE Name = 'jack'.
- Писатель 2 запускает удаление DELETE FROM Fruits WHERE Name = 'jack'.
- Писатель 1 добавляет delete-1, который аннулирует существующую строку «jack» в data-1. Он также добавляет данные-2 с [«jack», «banana»].
- Писатель 2 добавляет delete-2, который аннулирует существующую строку «jack» в data-1.
- Писатель 1 обновляет метаданные, выполняет проверку на конфликт, записывает метаданные и фиксирует метаданные-2 со снапшотом-2.
- Автор 2 обновляет метаданные и видит снапшот-2. Он не выполняет проверку и не видит конфликта, при этом фиксирует снапшот-3.
В этот момент читатель все еще может прочитать [«jack», «banana»] из данных-2, несмотря на то, что операция delete уже якобы удалила все строки WHERE Name = 'jack'. Независимо от того, рассматриваем ли мы общее упорядочивание операции A, затем B, или B,а затем A, в итоговой версии таблицы не должно быть строки «jack».
Проверка добавленныз файлов данных
Точно такую же проверку может вызвать OverwriteFiles.
Операция RewriteFiles (уплотнение)
Выполняются две проверки, о которых мы уже рассказывали ранее:
- Невозможность проверки отсутствия путей удаления, всегда включен.
- Проверка отсутствия новых удалений для файлов данных, всегда включена.
Это предотвращает конфликты с операциями OverwriteFiles, RowDelta и другими операциями RewriteFiles.
Резюме
Эту статью ни в коем случае нельзя назвать на все 100% исчерпывающей, поскольку есть еще несколько операций, которые я не стал рассматривать. Кроме того, существует несколько дополнительных способов использования рассмотренных нами операций. Однако охватить абсолютно все - это очень большая и серьезная работа, и я уверен, что нам все-таки удалось рассмотреть достаточно много ключевых понятий.
Apache Iceberg предлагает своим пользователям различные проверки (проверки данных на наличие конфликтов), необходимые для уровней изоляции транзакций Snapshot и Serializable. Эти уровни изоляции не обязательно применяются к операциям добавления, поскольку в них вообще нет проверок на наличие конфликтов - то есть конфликты Append/Append возникнуть в принципе не могут, поскольку Iceberg не моделирует семантику первичного ключа. Уровни изоляции применяются к операциям копирования при записи и слияния при чтении и уплотнения.
Apache Spark:
- для Snapshot (SI) включает все проверки, кроме проверки добавленных файлов данных.
- для Serializable включает все проверки SI, а также включает проверку добавленных файлов данных для того, чтобы гарантировать, что одновременная операция A не может добавить данные, соответствующие предикату запроса, вытесняемого операцией B.
Я не проводил бенчмаркинга Iceberg или других форматов таблиц, хотя это и входит в мой список дел. Но с теоретической точки зрения разбиение на разделы и кластеризация важны только для предотвращения ненужных ошибок валидации (а также конфликтов данных).
- Проверка добавленных файлов данных (изоляция Serializable) сработает в том случае, если какой-либо файл данных будет добавлен параллельной операцией (соответствующей фильтрам конфликта данных). Поэтому выравнивание писателей по разделам и включение всех столбцов разделов в фильтры конфликтов данных будет полезно в топологиях с несколькими писателями, чтобы писатели не могли конфликтовать друг с другом. Это эффективно только в том случае, если выбранная схема разделения не является временной. Если она основана только на времени, то использование топологии Spark/Flink, в которой данные перемешиваются по ключу (ключам) сортировки, значительно улучшит кластеризацию, и поэтому фильтры конфликтов данных, соответствующие кластеризации, могут быть эффективными при оценке статистики столбцов.
- Проверка отсутствия новых удаленных файлов (изоляция Snapshot, MOR) сработает в том случае, если были добавлены новые удаленные файлы, соответствующие фильтру конфликта данных. Фильтр эффективен для файлов удаления только в том случае, если он содержит столбцы спецификации раздела. Поэтому необходимо выравнивание писателей по разделам. Кластеризация не должна иметь преимуществ в отношении параллельности этой проверки. Однако, учитывая, что записи манифеста файла удаления содержат путь к файлу данных ссылки в статистике столбцов, если файл удаления содержит только один файл данных, то, возможно, это можно использовать в случае, когда разделение основано исключительно на времени. Файлы удаления должны содержать только ссылки на один файл данных до тех пор, пока компакция не удалит их. Таким образом, Iceberg может использовать проверку, которая гарантирует, что файлы удаления, зафиксированные в снимке после сканирования, не затрагивают те же файлы и, возможно, те же строки, что и текущая операция RowDelta.


