

Быстрая и легкая интеграция Kafka со Spring Boot
Краткая инструкция по осуществлению быстрой и легкой интеграции Kafka со Spring Boot.
Важность обработки данных в режиме реального времени и обеспечения бесперебойной связи между различными частями приложения переоценить трудно. Одной из технологий, которая получила значительное распространение для обеспечения таких возможностей, сталп Apache Kafka. В этой статье мы разберемся в том, что такое Kafka, каковы ее ключевые особенности и как она вписывается в экосистему Spring Boot.
Что такое Apache Kafka?
Apache Kafka - это платформа с открытым исходным кодом, предназначенная для распределенной потоковой передачи событий. Изначально она была разработана инженерами компании LinkedIn, а затем вошла в состав Apache Software Foundation. Kafka была разработана для решения проблем, связанных с обработкой огромных объемов данных в режиме реального времени, что делает ее идеальным решением для приложений, требующих высокой пропускной способности, отказоустойчивости и оперативной потоковой передачи данных.

Зачем нужна Apache Kafka?
Возможности Kafka практически безграничны и делают его мощным инструментом, пригодным для реализации самых разных сценариев.
- Обработка данных в режиме реального времени: Kafka отлично справляется с потоками данных, поступающих в режиме реального времени, что делает ее идеальным решением для приложений, требующих мгновенного обновления данных и обработки, управляемой событиями.
- Масштабируемость: Распределенная природа Kafka обеспечивает плавную масштабируемость, позволяя обрабатывать большие объемы данных без ущерба для производительности.
- Отказоустойчивость: Механизм репликации Kafka гарантирует, что данные не будут потеряны даже в случае сбоев в работе брокера.
- Поиск событий: Kafka является фундаментальным компонентом архитектуры событийного сорсинга, в которой изменения состояния приложения фиксируются в виде серии событий.
- Агрегация журналов: Kafka играет ключевую роль, облегчая сбор и хранение изменений состояния приложения в виде последовательной серии событий.
Ключевые концепты Kafka
- Топики: Kafka организует данные в топики, которые по сути являются категориями или каналами, в которых публикуются записи.
- Продюсеры: Продюсеры отвечают за отправку данных в топики Kafka. Их можно считать источниками потока данных.
- Консюмеры: Консюмеры подписываются на топики и обрабатывают записи, отправленные продюсерами. Они являются получателями потоков данных.
- Брокеры: Кластеры Kafka состоят из брокеров, которые хранят данные и управляют распределением записей по топикам.
- Разделы: Каждая тема может быть разделена на разделы, которые позволяют выполнять параллельную обработку и распределять данные по кластеру.
Основы архитектуры Kafka
В архитектуре Kafka сообщения являются сердцем системы. Производители создают и отправляют сообщения в определенные топики, которые в свою очередь выступают в роли категорий. Эти топики делятся на разделы для того, чтобы обеспечить эффективную параллельную обработку данных.
Консюмеры подписываются на топики и получают сообщения из разделов. Каждый раздел одновременно назначается только одному консюмеру, что обеспечивает оптимальное распределение нагрузки. Консюмеры обрабатывают сообщения в зависимости от своих потребностей, будь то аналитика, хранение или другие приложения.
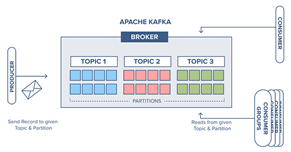
Такая архитектура позволяет Kafka эффективно обрабатывать огромные потоки данных, обеспечивая отказоустойчивость и масштабируемость. Это надежная основа для конвейеров данных в режиме реального времени, приложений, управляемых событиями, и многого-много другого.
Теперь, когда мы разобрались с принципами работы Kafka, давайте погрузимся в код!
Установка Kafka в Spring Boot: написание кода
Прежде чем приступить к работе, необходимо, чтобы в Вашей локальной среде стабильно работал сервер Kafka.
Нам нужно добавить зависимость spring-kafka maven в pom.xml.
        <dependency>
            <groupId>org.springframework.kafka</groupId>
            <artifactId>spring-kafka</artifactId>
        </dependency>
Настройка продюсера
Чтобы начать создавать сообщения, создадим фабрику. Она служит руководством для формирования экземпляров продюсеров Kafka.
Далее используем шаблон KafkaTemplate, который предлагает простые методы для отправки сообщений в определенные топики Kafka.
Экземпляры продюсера разработаны таким образом, что использование одного экземпляра в контексте Вашего приложения может повысить производительность в целом. Это также относится и к экземплярам KafkaTemplate.
@Configuration
public class KafkaProducerConfig {
    @Bean
    public ProducerFactory<String, String> producerFactory() {
        Map<String, Object> configProps = new HashMap<>();
        configProps.put(           ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,            bootstrapAddress);         configProps.put(           ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,            StringSerializer.class);         configProps.put(           ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,            StringSerializer.class);         return new DefaultKafkaProducerFactory<>(configProps);
    }     @Bean
    public KafkaTemplate<String, String> kafkaTemplate() {
        return new KafkaTemplate<>(producerFactory());
    } }
В приведенном выше фрагменте кода мы настраиваем продюсера с помощью свойств ProducerConfig. Вот разбивка основных используемых свойств:
-
BOOTSTRAP_SERVERS_CONFIGЭто свойство определяет адреса брокеровKafka, которые представляют собой список пар хост-порт, разделенных запятыми. -
KEY_SERIALIZER_CLASS_CONFIGandVALUE_SERIALIZER_CLASS_CONFIG: Эти свойства определяют, как ключ и значение сообщения будут сериализованы перед отправкой вKafka. В этом примере для сериализации ключа и значениямы используемStringSerializer.
Итак, в этом случае наш файл свойств должен содержать значение 'bootstrap-server'.
spring.kafka.bootstrap-servers=localhost:9092
Все службы, используемые в этой статье, предполагают работу на порту по умолчанию.
Создание топиков Kafka
Мы будем отправлять сообщения в топик. Поэтому перед отправкой сообщений необходимо создать топик.
@Configuration
public class KafkaTopic {
    @Bean
    public NewTopic topic1() {
        return TopicBuilder.name("topic-1").build();
    }     @Bean
    public NewTopic topic2() {
        return TopicBuilder.name("topic-2").partitions(3).build();
    } }
AKafkaAdmin отвечает за создание новых топиков в нашем брокере. В Spring Boot KafkaAdmin регистрируется автоматически.
Здесь мы создали топик-1 с 1 разделом (по умолчанию) и топик-2 с 3 разделами. TopicBuilder предоставляет различные методы для создания топиков.
Отправка сообщений
KafkaTemplate Имеет различные методы для отправки сообщений топикам:
@Component
@Slf4j
public class KafkaSender {
    @Autowired
    private KafkaTemplateString, String> kafkaTemplate;
        public void sendMessage(String message, String topicName) {
        log.info("Sending : {}", message);
        log.info("--------------------------------");
        kafkaTemplate.send(topicName, message);     } }
Для публикации сообщения достаточно вызвать метод send() с сообщением и именем топика в качестве параметров.
Настройка консюмера
KafkaMessageListenerContainerFactory получает все сообщения из всех топиков в одном потоке. Для этого нам нужно настроить consumerFacotry.
@Configuration
@EnableKafka
public class KafkaConsumer {
    @Value("${spring.kafka.bootstrap-servers}")
    private String bootstrapServers;
    @Bean
    public ConsumerFactoryString, String> consumerFactory() {
        Map<String, Object> props = new HashMap<>();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,                 bootstrapServers);         props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,                 StringDeserializer.class);         props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class);         return new DefaultKafkaConsumerFactory<>(props);
    } }
Далее нам нужно потреблять сообщения с помощью аннотации @KafkaListener. Для этого мы используем аннотацию @EnableKafka в конфигурации консюмера. Она указывает Spring просканировать аннотацию @KafkaListener и сконфигурировать инфраструктуру, необходимую для обработки сообщений Kafka.
@Component
@Slf4j
public class KafkaListenerExample {
    @KafkaListener(topics = "topic-1", groupId = "group1")
    void listener(String data) {
        log.info("Received message [{}] in group1", data);
    }
GroupId - это строка, которая однозначно идентифицирует группу потребительских процессов, к которой принадлежит данный консюмер. Мы можем указать несколько тем для прослушивания в рамках одной группы консюмеров. Точно так же несколько методов могут прослушивать один и тот же топиков.
@KafkaListener(topics = "topic-1,topic-2", groupId = "group1")
void listener(@Payload String data,
              @Header(KafkaHeaders.RECEIVED_PARTITION) int partition,
              @Header(KafkaHeaders.OFFSET) int offset) {
    log.info("Received message [{}] from group1, partition-{} with offset-{}",
            data,             partition,             offset); }
Мы также можем получить некоторые полезные метаданные о потребляемом сообщении с помощью аннотации @Header().
Потребление сообщений из определенного раздела с начальным смещением
В некоторых случаях нужно будет потреблять сообщения из определенного раздела топика Kafka, начиная с определенного смещения. Это может быть полезно в том случае, если Вы хотите повторно обработать определенные сообщения или иметь тонкий контроль над тем, с чего начать их потребление.
@KafkaListener(
  groupId = "group2",   topicPartitions = @TopicPartition(topic = "topic-2",   partitionOffsets = {     @PartitionOffset(partition = "0", initialOffset = "0"),      @PartitionOffset(partition = "3", initialOffset = "0")}))
public void listenToPartition(
  @Payload String message,
  @Header(KafkaHeaders.RECEIVED_PARTITION_ID) int partition) {
      log.info("Received Message [{}] from partition-{}",
               message,                partition); }
Задавая initialOffset равным «0», мы даем Kafka указание начинать потребление сообщений с начала раздела. Если Вы хотите просто указать раздел без initialOffset, напишите следующее:
@KafkaListener(groupId = "group2", topicPartitions
  = @TopicPartition(topic = "topicName", partitions = { "0", "3" }))
KafkaListner на уровне класса
Аннотация на уровне класса подходит в том случае, когда Вы хотите сгруппировать логику обработки связанных сообщений. Сообщения из этих топиков будут распределяться по методам внутри класса в зависимости от их параметров.
@Component
@Slf4j
@KafkaListener(id = "class-level", topics = "multi-type")
class KafkaClassListener {
  @KafkaHandler
  void listenString(String message) {
    log.info("KafkaHandler [String] {}", message);
  }   @KafkaHandler(isDefault = true)
  void listenDefault(Object object) {
    log.info("KafkaHandler [Default] {}", object);
  } }
Таким образом, мы можем сгруппировать методы, которые будут потреблять данные из определенных топиков. Здесь мы можем перехватывать различные типы данных с помощью методов, аннотированных @KafkaHandler. Параметры метода будут определять способ получения данных, и если ни один из типов данных не совпадает, будет применен метод по умолчанию.
Теперь, когда мы рассмотрели основы работы продюсеров и консюмеров с использованием строковых сообщений, давайте изучим различные сценарии и случаи использования.
Использование RoutingKafkaTemplate
Мы можем использовать RoutingKafkaTemplate, когда есть несколько продюсеров с различными конфигурациями, и мы хотим выбрать продюсера на основе имени топиков во время выполнения.
@Bean
public RoutingKafkaTemplate routingTemplate(GenericApplicationContext context) {
    // ProducerFactory with Bytes serializer
    Map<String, Object> props = new HashMap<>();
    props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);     props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class);     props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, ByteArraySerializer.class);     DefaultKafkaProducerFactory<Object, Object> bytesPF = new DefaultKafkaProducerFactory<>(props);
    context.registerBean(DefaultKafkaProducerFactory.class, "bytesPF", bytesPF);
    // ProducerFactory with String serializer
    props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class);     DefaultKafkaProducerFactory<Object, Object> stringPF = new DefaultKafkaProducerFactory<>(props);
    Map<Pattern, ProducerFactory<Object, Object>> map = new LinkedHashMap<>();
    map.put(Pattern.compile(".*-bytes"), bytesPF);
    map.put(Pattern.compile("strings-.*"), stringPF);
    return new RoutingKafkaTemplate(map);
}
RoutingKafkaTemplate направляет сообщения к первому экземпляру фабрики, который соответствует заданному имени топика из карты regex и ProducerFactoryinstances. Шаблон strings-.* должен быть первым, если есть еще два шаблона, str-.* и strings-.*, потому что в противном случае шаблон str-.* будет «перекрывать» его.
В приведенном выше примере мы создали два шаблона - .*-bytes и strings-.*. Сериализация сообщений зависит от имени топика, используемой во время выполнения. Имена тем, заканчивающиеся на '-bytes', будут использовать байтовый сериализатор, а начинающиеся на strings-.* - StringSerializer.
Фильтрация сообщений
Все сообщения, соответствующие критериям фильтра, будут отброшены еще до того, как попадут к слушателю. Здесь сообщения, содержащие слово «игнорировать», будут отброшены.
@Bean
public KafkaListenerContainerFactory<ConcurrentMessageListenerContainer<String, String>> kafkaListenerContainerFactory() {
    ConcurrentKafkaListenerContainerFactory<String, String> factory =             new ConcurrentKafkaListenerContainerFactory<>();
    factory.setConsumerFactory(consumerFactory());     factory.setRecordFilterStrategy(record -> record.value().contains("ignored"));
    return factory;
}
Слушатель включен в FilteringMessageListenerAdapter. Этот адаптер опирается на реализацию RecordFilterStrategy, в которой мы определяем метод фильтрации. Вы можете просто добавить одну строку в Вашу текущую фабрику консюмеров для того, чтобы вызвать фильтр.
Пользовательские сообщения
Теперь давайте рассмотрим, как отправить или получить объект Java. В нашем примере мы будем отправлять и получать объекты User.
@Data
@AllArgsConstructor
@NoArgsConstructor
public class User {
    String msg; }
Настройка продюсера и консюмера
Мы будем использовать JSON Serializer для конфигурации значений продюсера:
@Bean
public ProducerFactory<String, User> userProducerFactory() {
    Map<String, Object> configProps = new HashMap<>();
    configProps.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);     configProps.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class);     configProps.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, JsonSerializer.class);     return new DefaultKafkaProducerFactory<>(configProps);
} @Bean
public KafkaTemplate<String, User> userKafkaTemplate() {
    return new KafkaTemplate<>(userProducerFactory());
}
А для консюмеров это будет десериализатор JSON:
public ConsumerFactory<String, User> userConsumerFactory() {
    Map<String, Object> props = new HashMap<>();
    props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);     return new DefaultKafkaConsumerFactory<>(props, new StringDeserializer(), new JsonDeserializer>(User.class));
} @Bean
public ConcurrentKafkaListenerContainerFactory<String, User> userKafkaListenerContainerFactory() {
    ConcurrentKafkaListenerContainerFactory<String, User> factory = new ConcurrentKafkaListenerContainerFactory<>();
    factory.setConsumerFactory(userConsumerFactory());     return factory;
}
Сериализатор и десериализатор JSON в spring-kafka используют библиотеку Jackson, которая отвечает за преобразование объектов Java в байты и наоборот.
        <dependency>
            <groupId>com.fasterxml.jackson.core</groupId>
            <artifactId>jackson-databind</artifactId>
            <version>2.12.7.1</version>
        </dependency>
Это необязательная зависимость, если Вы хотите ее использовать, используйте ту же версию, что и spring-kafka.
Отправка объектов Java
Давайте отправим объект User с помощью созданного нами шаблона userKafkaTemplate().
@Component
@Slf4j
public class KafkaSender {
    @Autowired
    private KafkaTemplate<String, User> userKafkaTemplate;
    void sendCustomMessage(User user, String topicName) {
        log.info("Sending Json Serializer : {}", user);
        log.info("--------------------------------");
        userKafkaTemplate.send(topicName, user);     }
Получение объектов Java
@Component
@Slf4j
public class KafkaListenerExample {
    @KafkaListener(topics = "topic-3", groupId = "user-group",
            containerFactory = "userKafkaListenerContainerFactory")
    void listenerWithMessageConverter(User user) {
        log.info("Received message through MessageConverterUserListener [{}]", user);
    }
Поскольку у нас несколько контейнеров слушателей, мы указываем, какую фабрику контейнеров нужно использовать.
Если мы не укажем атрибут containerFactory, то по умолчанию будет использоваться kafkaListenerContainerFactory, которая в нашем случае использует StringSerializer и StringDeserializer.
Заключение
В этой статье мы начали с основ и разобрались с базовыми концепциями Kafka. Мы также объяснили, как настроить Kafka в приложении Spring Boot, и рассказали о том, как создавать и потреблять сообщения с помощью шаблонов и слушателей Kafka. Кроме того, мы рассказали о работе с различными типами сообщений, маршрутизации сообщений, фильтрации сообщений и преобразовании пользовательских форматов данных.
Kafka - это универсальный и мощный инструмент для создания конвейеров данных, работающих в режиме реального времени и событийно-ориентированных приложений. Мы искренне надеемся, что данная статья снабдила Вас знаниями, необходимыми для ее эффективного использования.
Изучение Kafka – очень интересный процесс, поэтому продолжайте экспериментировать и создавать что-то новое, ведь возможности Kafka безграничны. Счастливого пути!


