

Прокачка SQL–запросов с помощью DBeaver
Скорее всего, для Вас нет ничего хуже, когда Ваш запрос занимает слишком много времени, и я Вас очень хорошо понимаю.
Медленный запрос может привести к серьезным проблемам с производительностью приложения или заставить Вас потратить свое драгоценное время на анализ данных. Присоединяйтесь, давайте попробуем разобраться с этими муторными запросами раз и навсегда с помощью некоторых простых советов.
Пришло время засучить рукава и приступить к работе. Давайте создадим пример таблицы, который будем использовать в дальнейшем. Пожалуйста, пропустите этот раздел, если у Вас уже есть готовый пример таблицы или даже целая база данных. Нам понадобится база данных MySQL и программа DBeaver.
Пару слов о DBeaver
DBeaver (community edition) - это бесплатный инструмент с открытым исходным кодом, совместимый с различными базами данных. Одна из его примечательных особенностей – это визуальное выделение индексов и первичных ключей в столбцах любого результата запроса SELECT. Это особенно полезно, когда структура базы данных неизвестна, так как это позволяет легко идентифицировать индексы и первичные ключи.

Пример таблицы
Мы будем работать с таблицей под названием Clients, созданной следующим образом:
-- test_medium.clients definition
CREATE TABLE `clients` (  `Id` varchar(100) NOT NULL,  `Name` varchar(100) DEFAULT NULL,  `Address` varchar(100) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL,  `Telephone` varchar(20) DEFAULT NULL,  `Country` varchar(100) DEFAULT NULL,  `City` varchar(100) DEFAULT NULL,  `ZipCode` varchar(10) DEFAULT NULL,  PRIMARY KEY (`Id`),  KEY `clients_Country_IDX` (`Country`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
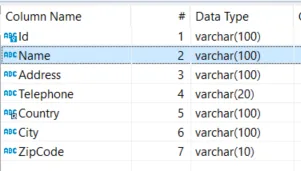
Мы «заселили» ее 500,000 случайными записями, воспользовавшись специальным решением под названием Faker Python library (создает файлы CSV и затем импортирует их в БД).
Идентификация индексов и первичных ключей
Есть отличный способ определить индексы и первичные ключи (далее PK) конкретной таблицы:
SHOW INDEX FROM clients;
В результате выполнения предыдущего запроса Вы увидите следующее:

Но если Вы выполните простой запрос Select, Вы также сможете определить PKs и индексированные столбцы:
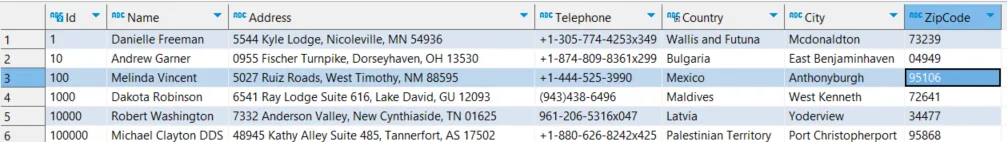
Укажите столбцы ID и Country:

Значки в типе данных столбца - это PK и индексированный столбец соответственно.
А что насчет производительности?
Вот видите! DBeaver не улучшит производительность сам по себе. Давайте рассмотрим, как же ее можно повысить:
Where
Сравним запросы:
SELECT * FROM clients;
SELECT * FROM clients c WHERE Country ='Colombia'; SELECT * FROM clients c WHERE City ='Madrid'; SHOW PROFILES;
Результат:
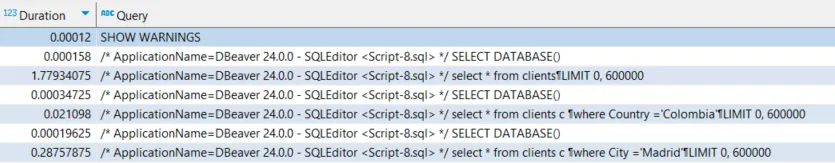
На получение искомых данных у нас ушло 1.779 секунд.
Если мы выполним запрос SELECT с предложением WHERE, фильтрующим по Country (индексированный столбец), то на возврат данных уйдет 0,021 секунды. Если мы запустим запрос с оператором WHERE, фильтрующим, например, по City (неиндексированный столбец), то Вы увидите большее время выполнения, в данном случае 0,287 секунды, что в 10 раз больше…
Order by
Применение предложения ORDER BY может привести к снижению производительности, особенно при использовании с неиндексированными столбцами:
SELECT * FROM clients c
 WHERE Country ='Colombia' ORDER BY Id; SELECT * FROM clients c WHERE Country ='Colombia' ORDER BY City ; SHOW PROFILES;
Результат запроса:

Упорядочивание результатов по City занимает 0,031 секунды, что на 0,01 секунды дольше. На первый взгляд это кажется незначительным, но когда Вы имеете дело с миллионами или миллиардами записей, поверьте, это имеет значение…
Использование JOIN
Как мы уже говорили ранее, определение индексов и PK определяет разницу между быстрым или медленным запросом; то же самое происходит и здесь. Если мы используем оператор join, СУБД необходимо отфильтровать и сравнить данные в таблицах, поэтому при использовании неиндексированных столбцов это займет больше времени, чем при использовании индексированных столбцов.
Нормализация
Лучшая практика при работе с базами данных - следовать принципам нормализации. Начало работы с третьей нормальной формы (3NF) помогает уменьшить избыточность данных, хранящихся в таблицах, что является конечной целью нормализации. Упрощая базу данных и избегая дублирования информации, мы можем поддерживать данные в неизменном состоянии.
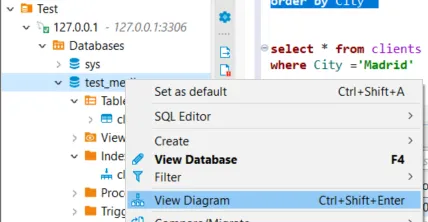
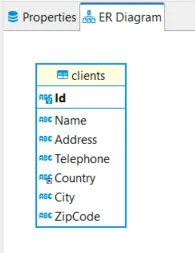
Здесь DBeaver предлагает инструмент, который может наглядно показать Вам диаграмму отношений сущностей (ERD). ERD наглядно показывает, как между собой в приложении или в базе данных связаны сущности. Она дает четкое представление об их взаимодействии и помогает эффективно спроектировать структуру системы или базы данных. Для этого нам нужно просто щелкнуть правой кнопкой мыши базу данных, а затем нажать «Просмотр диаграммы»:
В зависимости от базы данных отображение диаграммы может занять некоторое время. Пример нашей базы данных:
Выбор нужных столбцов
Выбор всех столбцов в таблице может занять больше времени, чем выбор только нужных столбцов:
SELECT * FROM clients c
 WHERE Country ='Colombia' ORDER BY City; SELECT id, Name FROM clients c WHERE Country ='Colombia' ORDER BY City; SHOW PROFILES;
Результат запроса:

Выбор всех столбцов занял 0,038 секунды, а выбор только двух – всего 0,010 секунды. Обратите внимание, что это более актуально при использовании оператора JOIN, поскольку использование * вернет все столбцы таблиц.
Limit
Этот пункт ограничивает количество записей, возвращаемых оператором Select. Это особенно полезно при составлении сложных запросов, так как позволяет немного сократить время, затрачиваемое на возврат данных:
SELECT id, Name FROM clients c
 WHERE Country ='Colombia' ORDER BY City LIMIT 5000; SELECT id, Name FROM clients c WHERE Country ='Colombia' ORDER BY City LIMIT 10; SHOW PROFILES;
Результат запроса:

Ограничение количества записей до 5000 заняло 0,005 секунды, а ограничение до 10 - 0,004 секунды.
Заключение
Эта статья презентует DBeaver как исключительно полезный инструмент с открытым исходным кодом, предназначенный для оптимизации SQL-запросов. В ней освещаются основные возможности DBeaver, такие как визуальное отображение индексов и первичных ключей. В статье также рассматриваются различные методы оптимизации производительности для различных SQL-запросов и следование принципам нормализации. Мы также рассмотрели библиотеку Faker Python, которая помогает нам генерировать примеры данных для нашей базы данных. Эти советы и рекомендации помогут пользователям сэкономить время, силы и средства за счет оптимизации времени отклика запросов. В завершении подчеркивается полезность применения концепции «меньше - значит больше» в привязке к запросам к базам данных.


