

Понимание архитектуры Trino: раскрываем весь потенциал распределенных SQL-запросов
Trino - это распределенный SQL-движок, предназначенный для анализа данных.
В этой статье мы погрузимся во внутреннюю работу Trino и постараемся получить полное представление о его архитектуре и возможностях (предполагается, что Вы его уже установили и запустили).
Координатор и рабочие узлы кластера
Trino - это распределенный SQL-движок, напоминающий базы данных и механизмы запросов в стиле массивно-параллельной обработки (MPP). Помимо вертикального масштабирования Trino способен распределять всю обработку по кластеру серверов и в горизонтальном режиме. Это означает, что для получения большей вычислительной мощности Вы можете добавить несколько узлов.

Trino способен эффективно обрабатывать SQL-запросы к большим объемам данных на кластере компьютеров или узлов. На каждом узле он запускает односерверный процесс. Несколько узлов, на которых работает Trino и которые настроены на взаимодействие друг с другом, образуют кластер Trino.
Давайте посмотрим, как происходит взаимодействие между координатором и рабочими узлами внутри кластера.
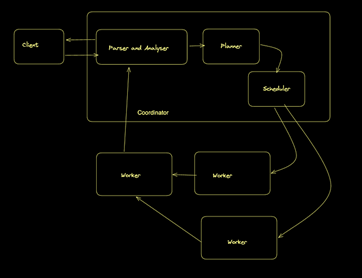
Координатор взаимодействует с рабочими узлами, назначая им работу и обновляя статус запущенных процессов, а также получает результаты верхнего уровня для передачи пользователям. Рабочие узлы общаются друг с другом для того, чтобы получить данные из вышестоящих задач, выполняемых на других рабочих узлах. Рабочие узлы получают результаты из источника данных.
Координатор - это сервер Trino, который обрабатывает входящие запросы и для их выполнения организовывает деятельность рабочих узлов.
Рабочий узел - это сервер Trino, отвечающий за выполнение задач и обработку данных.
Как правило, на координаторе работает служба обнаружения, которая позволяет рабочим узлам регистрироваться в кластере.
NB: все коммуникации и передача данных между клиентами, координаторами и рабочими узлами происходят через HTTP/HTTPS.
Планирование запросов
Постараемся понять принцип работы планировщика запросов Trino на примере:
SELECT
 ( SELECT name
 FROM region r
 WHERE regionkey = n.regionkey
 ) AS region_name,
 n.name AS nation_name,
 sum(totalprice) orders_sum
 FROM nation n, orders o, customer c
 WHERE n.nationkey = c.nationkey
 AND c.custkey = o.custkey
 GROUP BY n.nationkey, regionkey, n.name ORDER BY orders_sum DESC
 LIMIT 5;
- Запрос SELECT, использующий три таблицы в предложении FROM, неявно определяет CROSS
- JOIN между таблицами стран, заказов и клиентов
- Условие WHERE для сохранения совпадающих строк из таблиц «Нации», «Заказы» и «Клиенты».
- Агрегация с использованием GROUP BY regionkey для агрегирования значений заказов для каждой страны
- Подзапрос (SELECT name FROM region WHERE regionkey = n.regionkey) для извлечения названия региона из таблицы region; обратите внимание, что этот запрос коррелирован, как если бы он должен был выполняться независимо для каждой строки содержащегося набора результатов
- Определение порядка, ORDER BY orders_sum DESC, для сортировки результата перед возвратом пользователю
- Определено ограничение в пять строк (чтобы вернуть только страны с наибольшими суммами заказов и отфильтровать все остальные).
Шаг 1: парсинг и анализ
Прежде чем планировать выполнение запроса, его необходимо разобрать на части и проанализировать.
В рамках этой задачи Trino выполняет 3 ключевых шага:
1. Идентификация таблиц, используемых в запросе
2. Идентификация столбцов, используемых в запросе
3. Идентификация ссылок на поля в значениях ROW
Шаг 2: первоначальное планирование запросов
План запроса можно рассматривать как программу, которая выдает результаты запроса. Напомним, что SQL - это декларативный язык: пользователь пишет SQL-запрос для того, чтобы указать данные, которые он хочет получить от системы. В отличие от императивной программы, пользователь не указывает, как нужно обработать данные для того, чтобы получить желаемый результат. Эта часть работы остается на усмотрение планировщика и оптимизатора запросов, которые определяют последовательность шагов по обработке данных для получения желаемого результата.
Эту последовательность шагов часто называют планом запроса.
Производительность планов сильно различается, поэтому планировщик и оптимизатор Trino пытаются определить наиболее оптимальный план. Планы, которые всегда дают одинаковые результаты, называются эквивалентными.
 Limit[5]
  - Sort[orders_sum DESC]     - LateralJoin[2]       - Aggregate[by nationkey...; orders_sum := sum(totalprice)]        - Filter[c.nationkey = n.nationkey AND c.custkey = o.custkey]
          - CrossJoin             - CrossJoin               - TableScan[nation]               - TableScan[orders]             - TableScan[customer]       - EnforceSingleRow[region_name := r.name]         - Filter[r.regionkey = n.regionkey]
          - TableScan[region]
Теперь рассмотрим вычислительную сложность этого плана запроса.
Если N, O, C и R представляют собой количество строк в таблицах nation, orders, customer и region соответственно, то мы увидим следующее:
- TableScan[orders] считывает таблицу заказов, возвращая O строк, поэтому его сложность равна Ω(O). Аналогично, два других TableScan возвращают N и C строк; таким образом, их сложность составляет ΩN и ΩC соответственно.
- CrossJoin над таблицами TableScan[nation] и TableScan[orders] объединяет данные из таблиц nation и orders; поэтому его сложность составляет Ω(N × O).
- CrossJoin, упомянутый выше, объединяет предыдущий CrossJoin, который создал N × O строк, с TableScan[customer], который объединяет данные из таблицы customer, поэтому его сложность составляет Ω(N × O × C).
- TableScan[region] в нижней части имеет сложность Ω(R). Однако из-за LateralJoin она вызывается N раз, причем N - это количество строк, возвращаемых в результате агрегации. Таким образом, в целом эта операция требует Ω(R × N) вычислительных затрат.
- Операция Sort должна упорядочить набор из N строк, поэтому она не может завершиться быстрее N × log(N).
Алгебраических формул на сегодня достаточно. Пришло время посмотреть, что все это значит на практике!
Рассмотрим пример популярного Интернет-сайта со 100 миллионами покупателей из 200 стран, которые в общей сложности сделали 1 миллиард заказов. Для CrossJoin этих двух таблиц необходимо материализовать 20 квинтиллионов (20 000 000 000 000 000 000 000 000 000 000 000 000 000 000) строк. Для того, чтобы вычислить промежуточные данные для нашего запроса кластеру из 100 узлов, обрабатывающему 1 миллион строк в секунду на каждом узле, потребуется более 63 столетий…
Разумеется, Trino даже и не будет пытаться осуществить столь наивный план. Однако у наивного плана есть своя роль - он служит мостом между двумя мирами: миром языка SQL и его семантических правил и миром оптимизаций запросов. Роль оптимизации запросов заключается в преобразовании начального плана в эквивалентный план, который может быть выполнен как можно быстрее, по крайней мере, за разумное время, учитывая ограниченные ресурсы кластера Trino.
Правило оптимизации Trino
Predicate pushdown - это, пожалуй, самая важная и самая простая для понимания оптимизация. Ее роль заключается в том, чтобы переместить условие фильтрации как можно ближе к источнику данных. В результате сокращение числа данных происходит как можно раньше. В нашем случае данная оптимизация преобразует фильтр в более простой фильтр, в результате чего мы получаем более простой план:
...
- Aggregate[by nationkey...; orders_sum := sum(totalprice)]   - Filter[c.nationkey = n.nationkey AND c.custkey = o.custkey]  // original filter
    - CrossJoin       - CrossJoin         - TableScan[nation]         - TableScan[orders]       - TableScan[customer] ... ... - Aggregate[by nationkey...; orders_sum := sum(totalprice)]   - Filter[c.nationkey = n.nationkey]
    - InnerJoin[o.custkey = c.custkey]       - CrossJoin         - TableScan[nation]         - TableScan[orders]       - TableScan[customer]
Существовавшее ранее «большее» объединение теперь преобразовано в InnerJoin по условию равенства. Не вдаваясь в подробности, предположим, что такое соединение может быть эффективно реализовано в распределенной системе с вычислительной сложностью, равной количеству создаваемых строк. Это означает, что в результате вытеснения предикатов CrossJoin «по крайней мере» Ω(N × O × C) был заменен на Join, который «точно» Θ(N × O).
DuckDB и Trino на благо MDS
Отправляясь на гоночную трассу, Вы выбираете гоночный автомобиль. Вы не едете на внедорожнике. Гоночным автомобилем для работы с базами данных является DuckDB, предназначенный для быстрых запросов к большим массивам данных. Отсутствующие в нем функции не умаляют его достоинств, минимализм - главный принцип дизайна в мире контейнеров современного стека данных.
Однако знать ограничения DuckDB просто необходимо. DuckDB не предназначена для транзакционных рабочих нагрузок, что делает ее непригодной для сценариев записи с высоким параллелизмом. DuckDB предлагает два варианта параллелизма: один процесс может одновременно читать и записывать в базу данных, или несколько процессов могут одновременно только читать.
Еще один аспект, который следует учитывать, - отсутствие функций управления пользователями, что делает DuckDB подходящим вариантом для отдельных пользователей, а не для коллектива, где может потребоваться контроль доступа и разрешения других пользователей.
Несмотря на все эти особенности, DuckDB отлично справляется с аналитическими задачами, если они соответствуют ее назначению.
Как насчет того, чтобы использовать его с Трино?

Для повышения эффективности совместной работы мы можем использовать Trino в сочетании с коннектором источника DuckDB. Обратите внимание на то, что на данный момент у Trino нет собственного решения, поэтому воспользуемся коннектором Iceberg.
Заключение: как раскрыть весь потенциал Trino
В этой статье мы раскрыли хитроумные механизмы, на которых основан Trino, универсальный распределенный движок запросов SQL. Предположим, что Вы уже установили и настроили Trino, и теперь у Вас есть более четкое понимание того, как он оптимизирует и обрабатывает запросы, а также обеспечивает отказоустойчивость системы и безопасность данных. Способность Trino легко подключаться к различным источникам данных с помощью таких коннекторов, как Iceberg, открывает перед пользователями широкие возможности для совместной работы с данными.
Trino является одним из самых ценных инструментов для организаций, стремящихся раскрыть весь потенциал своих корпоративных данных.
Изучайте Trino, экспериментируйте с его функциями и взаимодействуйте с его активным сообществом. Пусть Trino станет для Вас надежным спутником и помощником в поисках новых идей и решений.


