

Зачем платформе данных нужен пользовательский интерфейс?
Современные платформы данных действительно сложны. Если Вы посмотрите на эталонные архитектуры, как, например, на архитектуру A16Z, представленную ниже, то увидите, что она содержит более 30 блоков. Каждый блок может быть одним или несколькими инструментами, в зависимости от того, как Вы его спроектируете. Возможно, в Вашей платформе данных все эти блоки не пригодятся, но знайте, что большинство платформ данных, которые мы видим сегодня, как правило, содержат 10+ инструментов.
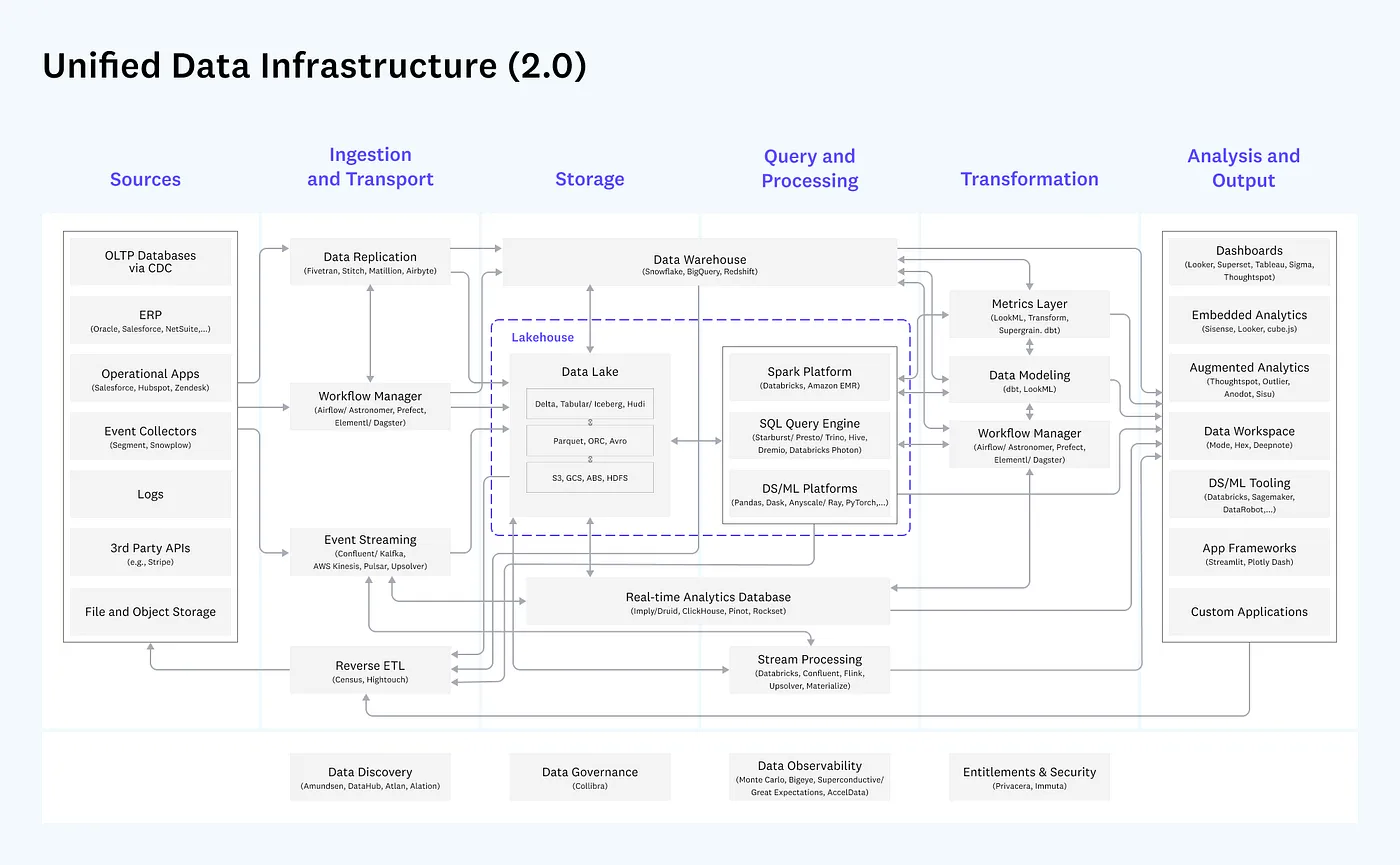
Создание платформы данных для небольшой команды - это НЕ самое сложное
В мире данных опыта создания подобных платформ данных предостаточно. Если Вы обратитесь к облачному поставщику, то получите многие из этих инструментов из коробки, для дальнейшей настройки Вам потребуется лишь простой скрипт terraform. Или, если Вы действительно хотите упростить процесс, соберите все вместе в консоли. Подумайте об объединении нескольких сервисов AWS со Snowflake, о настройке Databricks в Azure или даже о запуске старого доброго кластера Cloudera Hadoop на месте. Сегодня создание платформы данных, способной обрабатывать несколько сценариев использования, - это вопрос нескольких дней, недель или, в крайнем случае, нескольких месяцев.
Набор инструментов vs интегрированный опыт
В результате Вы, как правило, получаете лишь оптимизированный набор инструментов, что создает несколько проблем:
- Вы не сняли с себя когнитивной нагрузки: Каждый разработчик должен понимать каждый из инструментов платформы данных и комбинировать их таким образом, чтобы они подходили для конкретного случая использования.
- Нет интерфейсов: Сложно изменить или обновить инструмент. Каждый сценарий использования представляет собой набор скриптов, которые запускают базовые инструменты. Изменение или обновление инструментов означает поломку всех сценариев использования.
- Трудно увидеть общую картину: Что-то не так с дашбордом? Это потому, что какой-то случайный блокнот, расположенный на 5 шагов выше по течению, содержит ошибку. Вам нужно проверить всю систему CICD, чтобы узнать, какое последнее развертывание было сделано для этого блокнота, а затем открыть github, чтобы проверить последнее изменение.
Опять же, все это вполне терпимо, если Вы создаете несколько сценариев использования с небольшой централизованной командой по работе с данными.

Но что делать, если Вы хотите децентрализовать эту команду?
Data mesh, Data Science, self-service BI, … Можете называть это как угодно, но все в любом случае сводится к тому, чтобы дать каждому сотруднику возможность эффективно работать с данными. И тому есть очевидная причина: бизнес-пользователи должны использовать данные для того, чтобы сделать свою жизнь проще…
Повторю еще раз для тех, кто в кассе: Бизнес-пользователи должны использовать данные для того, чтобы облегчить себе жизнь.
Не верите? Зайдите в любое подразделение компании и посмотрите, какие безумно сложные вещи Ваши сотрудники делают с помощью Excel и Access. Проверьте, какие суперпродвинутые конвейеры данных они строят в своем инструменте для создания дашбордов. Посмотрите, как некоторые аналитики тратят по 7 дней в месяц на ручную консолидацию данных из разных систем и представление результатов в Powerpoint…
В одной крупной компании, в которой было только 1 монолитное хранилище данных, мы выполнили очень сложный и интересный проект. Одна команда отвечала за создание всех сценариев использования. На это уходило от 6 месяцев до 2 лет, а бэклог у них был на 9 месяцев. Мы создали платформу самообслуживания данных, в течение 3 месяцев мы приняли 100 с лишним вариантов использования от 200 с лишним бизнес-пользователей, которые подключались к данным с помощью MS Access ежедневно. «О ужас!»? Нет, это потрясающе. По крайней мере, мы знаем, кто и для каких целей использует те или иные наборы данных. Есть ли инструменты лучше, чем Access? Да. Будет ли в их бизнес-логике полный беспорядок? Да. Это наш главный приоритет? Нет.
Я хочу сказать следующее: после того как эти пользователи перейдут на платформу, Вы уже не сможете отделаться простым пакетом с инструментами.
Обязательная аналогия с автомобилем
Ни один инженерный блог не обходится без аналогии с автомобилем. В своей книге под названием Стратегия Платформы Г. Хоуп доказывает, что автомобильная промышленность уже давно отошла от подхода «набор инструментов». Если производитель хочет выпустить новую модель (= создать новый вариант использования), он не заглядывает на длинную полку с инструментами, как на схеме A16Z, приведенной выше. Он не выбирает поршень, руль, радиатор, ... и не начинают комбинировать все это для своей конкретной модели.»
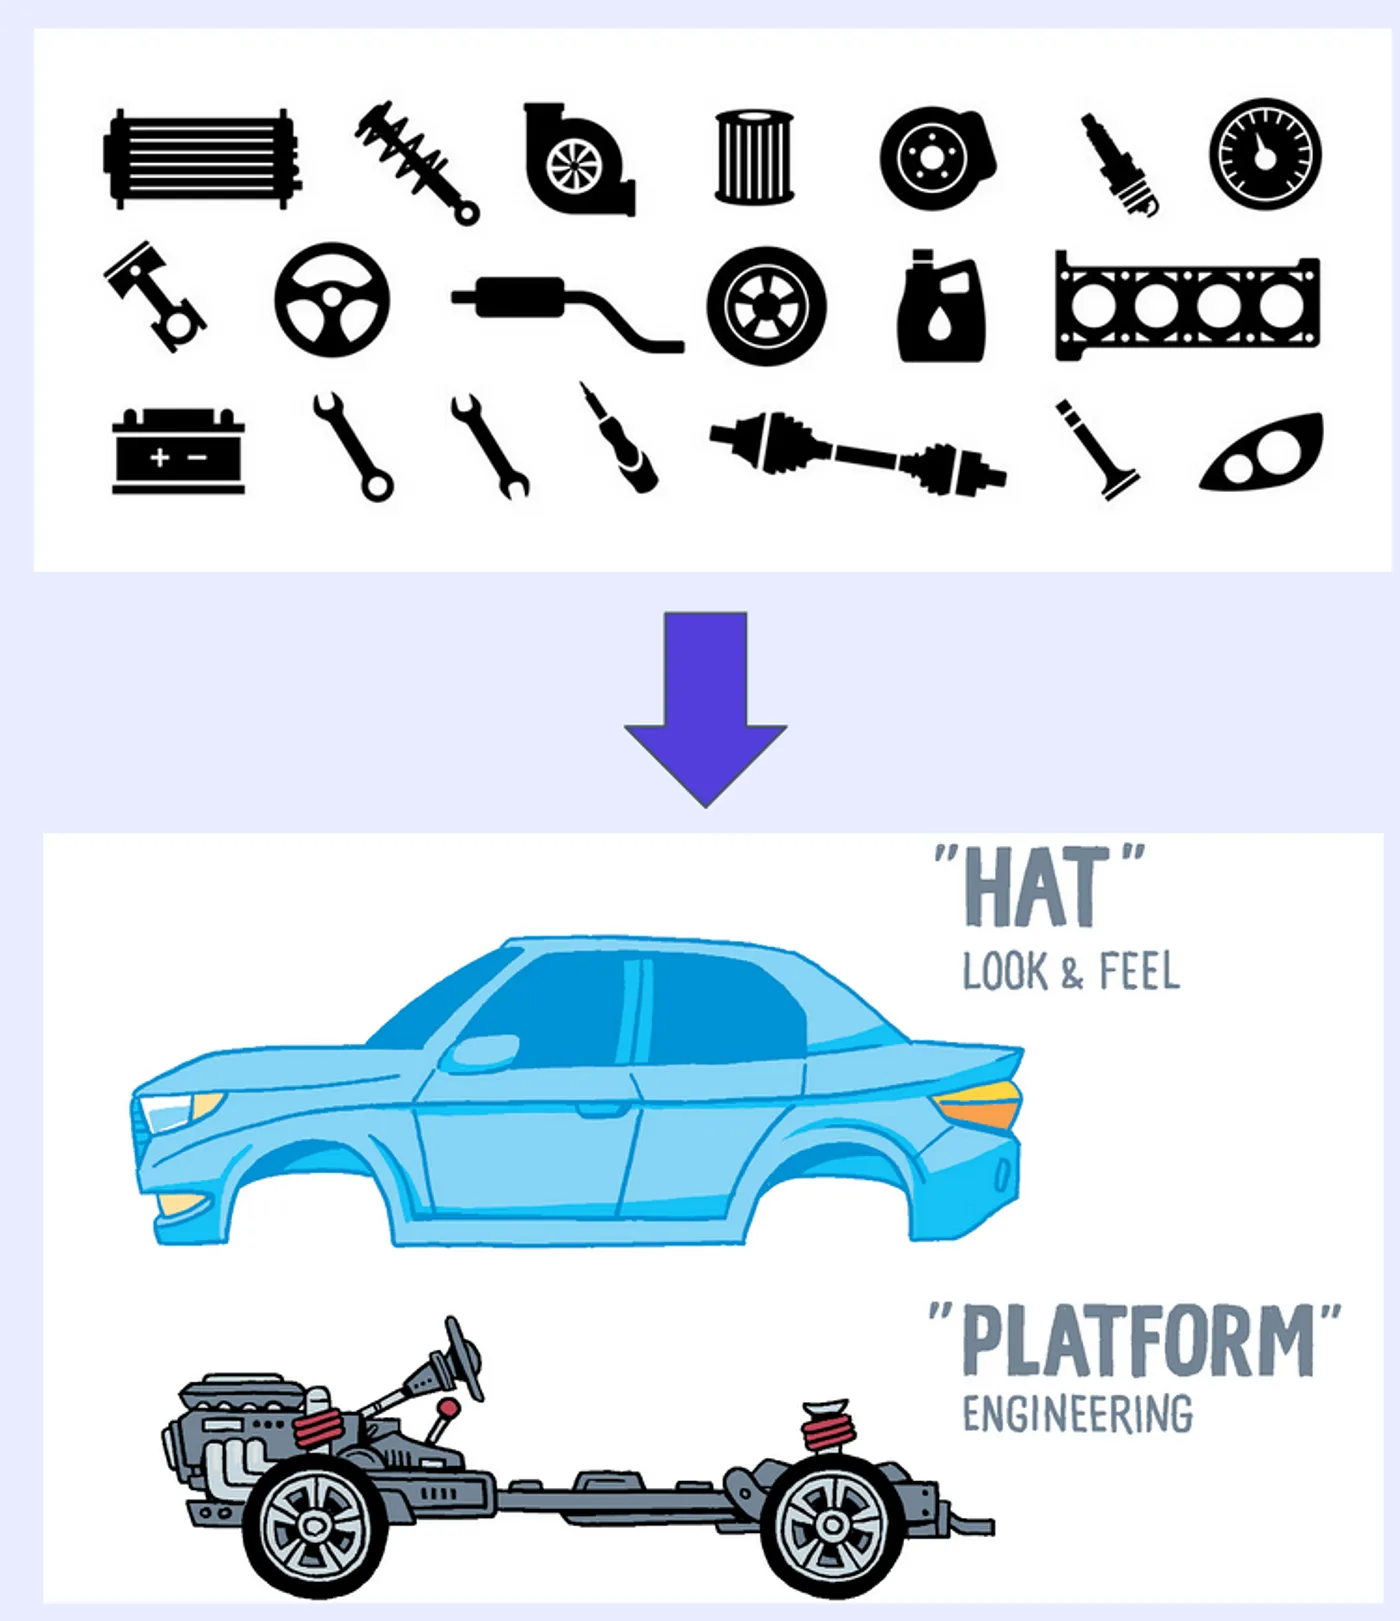
Вместо этого он создает платформу и позволяет строить на ее основе множество разных моделей. Это дает несколько преимуществ (по сравнению с подходом «набор инструментов):
- Снижение когнитивной нагрузки: Все инженерные аспекты управления автомобилем абстрагированы. Команда разработчиков платформы может сосредоточиться на производительности, долговечности и экономической эффективности платформы. Команда разработчиков моделей может сосредоточиться на потребительском опыте.
- Интерфейс , понятный для разработчиков моделей: Им нужно только убедиться, что водитель может пользоваться рулем и педалями. Им не нужно знать, как тормоза и подвеска интегрированы с колесами.
- Возможность увидеть общую картину: Как часть интерфейса, разработчики платформы отображают состояние на дашборде: «Требуется замена масла» и т.д. Для получения более продвинутых сообщений о состоянии специалисты могут подключиться к CAN-шине автомобиля.
Вернемся к платформе данных
Команды, занимающиеся платформами данных, должны применять такой же подход и к платформам данных. Вместо того чтобы просто предлагать набор инструментов своим командам, они должны подумать о том, какие возможности они хотят предложить своим командам и какие интерфейсы им нужны для этого.
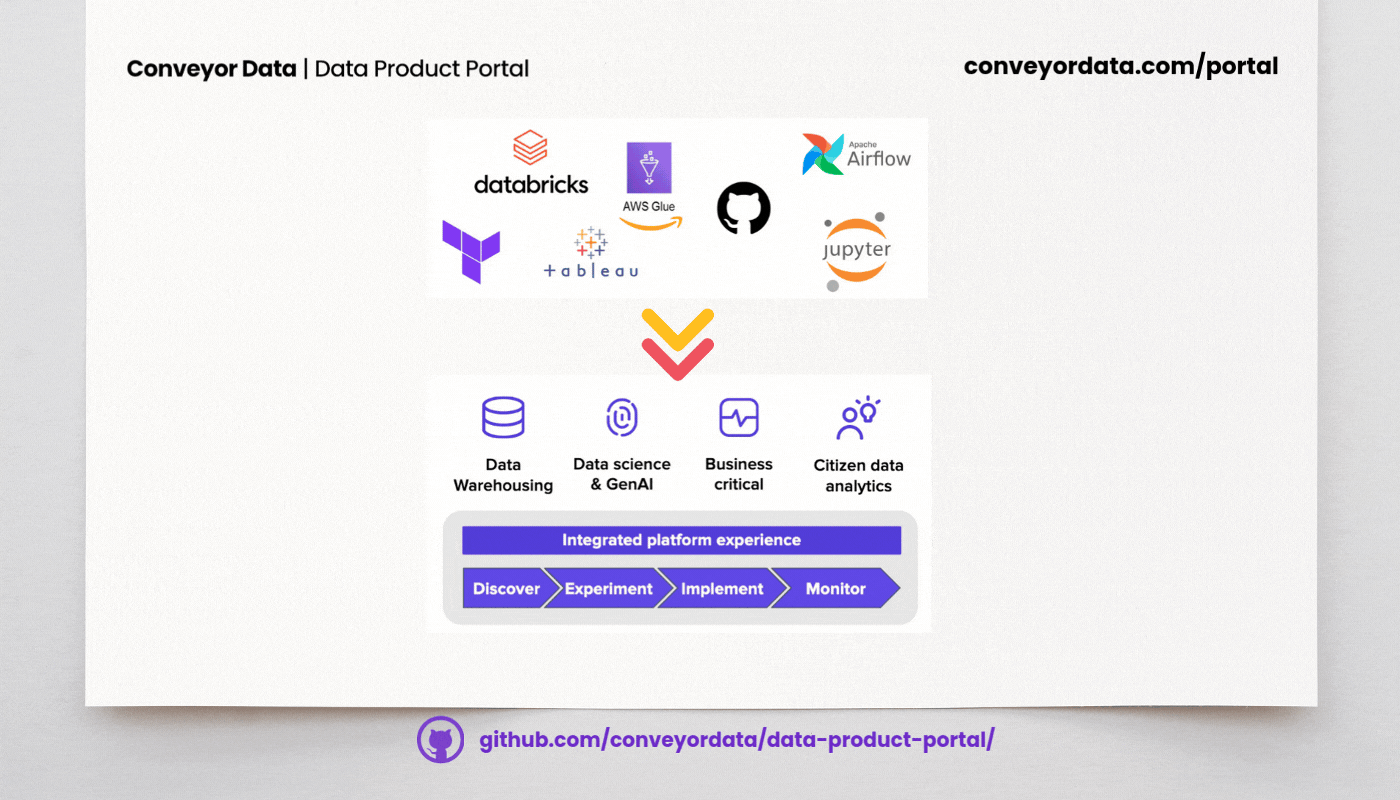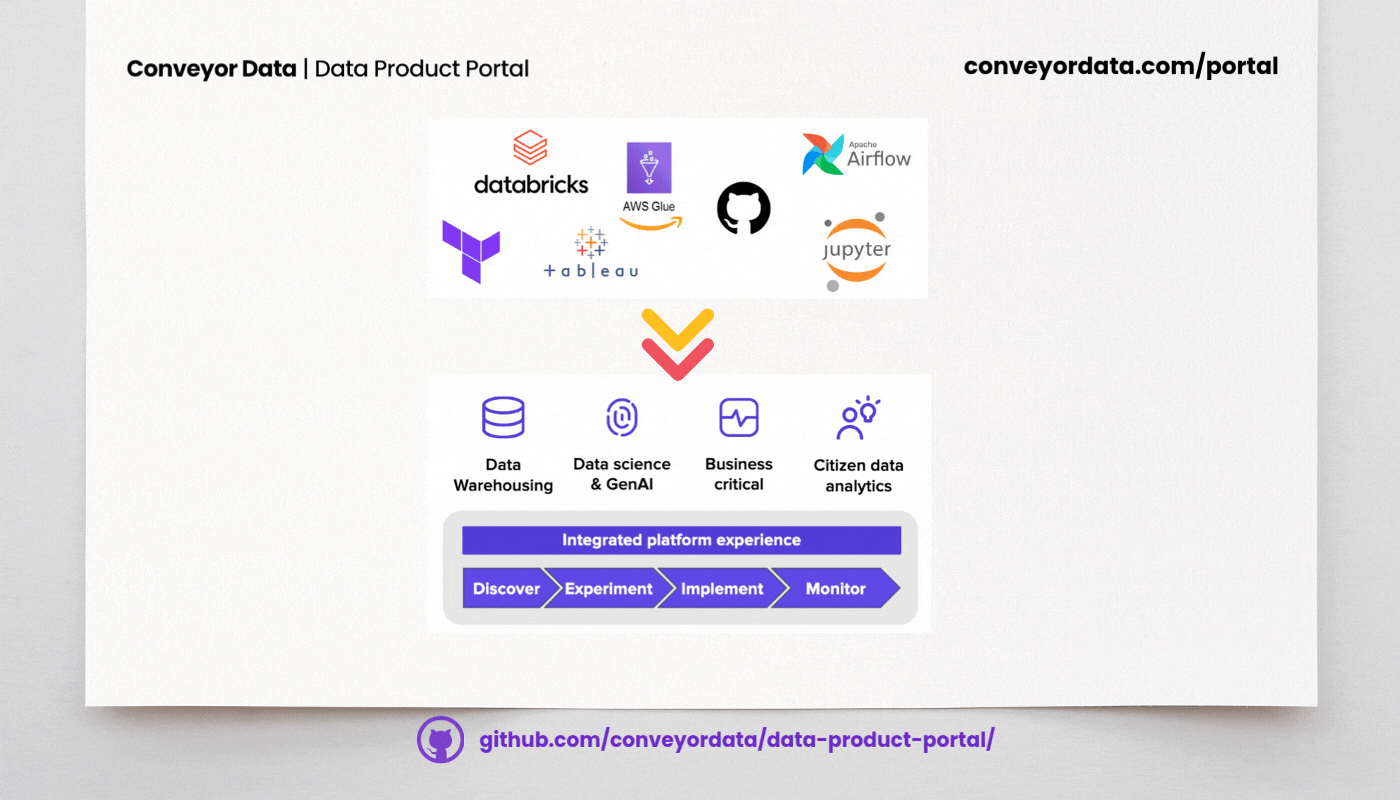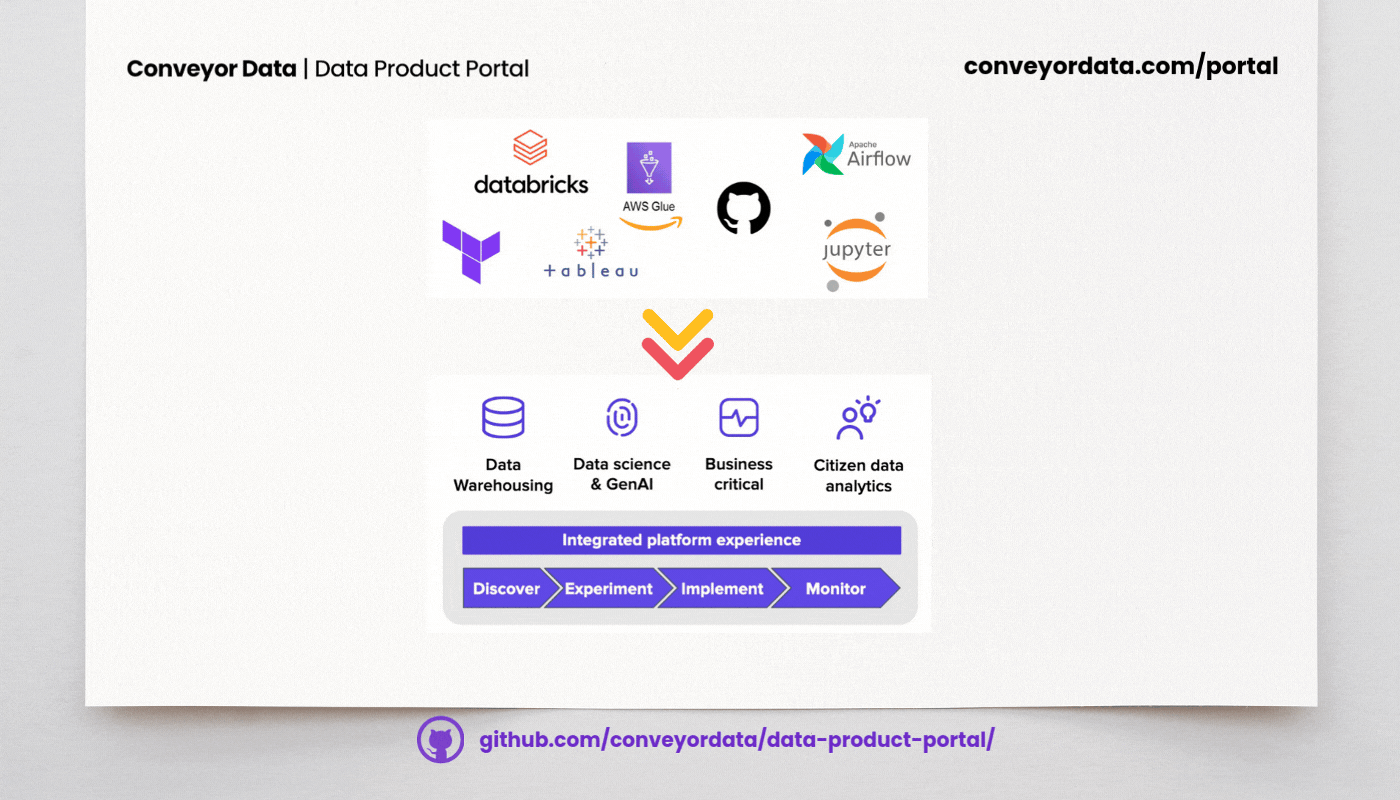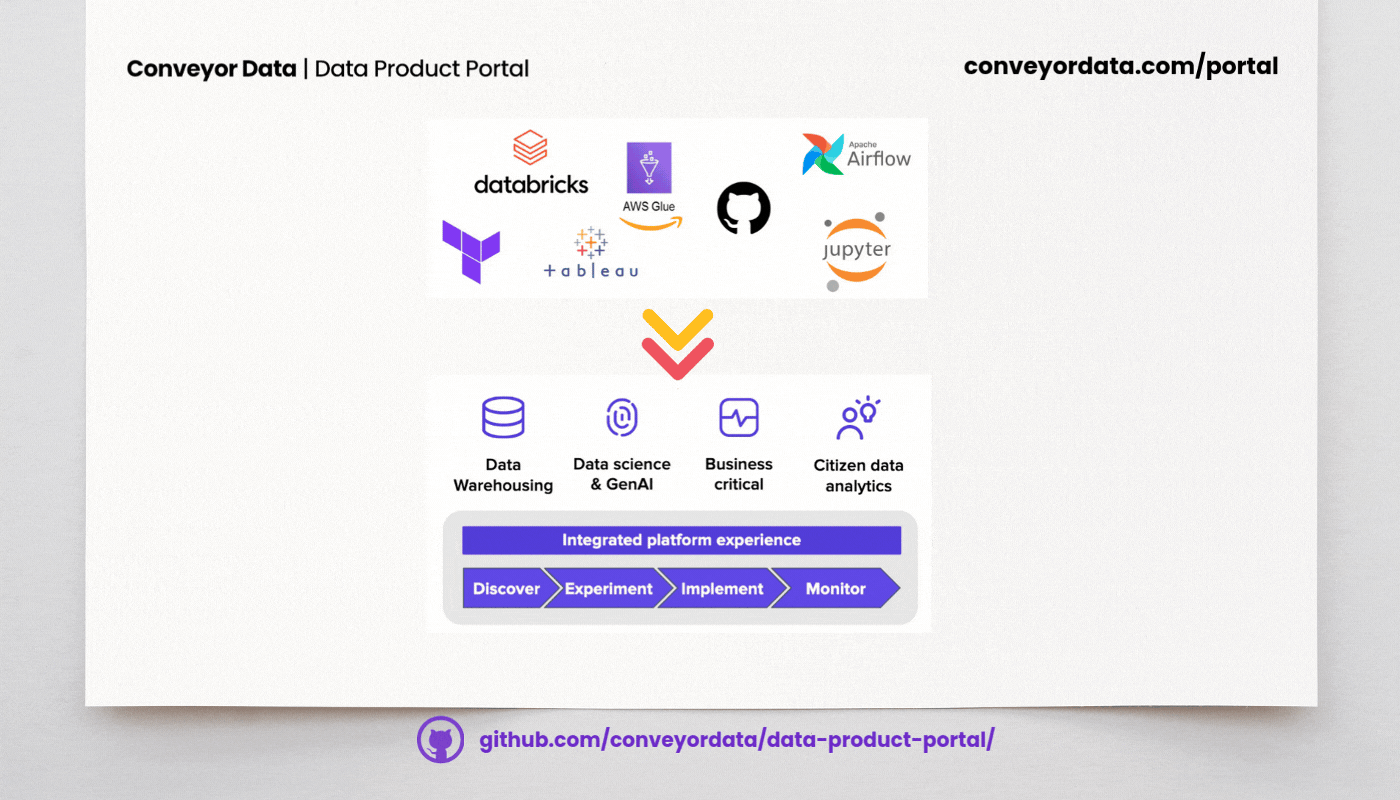
В разных компаниях этот интерфейс может быть разным. Это также зависит от того, на каком уровне зрелости находится та или иная платформа. В целом существует 4 архетипа сценариев использования, которые можно построить на платформе данных:
- DWH: Интеграция источников данных, отслеживание исторических изменений, создание отчетов
- Data science & нейросети: Используйте данные для того, чтобы делать прогнозы, давать рекомендации или советы.
- Критически важные для бизнеса сценарии использования: Работа с серьезными SLA, интегрированная с бизнес-процессами
- Аналитика данных: ее также часто называют «аналитикой последней мили»: данные решения позволяют бизнес-пользователям выполнять простые преобразования и создавать дашборды.
Каждый из этих прототипов сценариев использования проходит через те же 4 фазы: Открытие, Эксперимент, Реализация, Мониторинг. И, возможно, даже «закат». Компании по-разному называют эти этапы, а иногда делают их более детализированными. Фаза Открытие может быть связана с разработкой бизнес-кейса, согласованием со стратегией компании, определением необходимых источников данных, получением одобрения бюджета и т. д.
Команды разработчиков сценариев использования понимают концепции в целом и не обязаны разбираться в таких понятиях, как «Airflow DAG», «Iceberg Table» или «pip install». Ваша задача - предложить им асфальтированные дороги, чтобы они могли выбрать «Я хочу сделать новый сценарий использования Data science», и тут волшебным образом создавался бы git-репо, строился конвейер данных mlops, добавлялось хранилище моделей и т.д.
Пример интерфейса с нашего портала продуктов данных
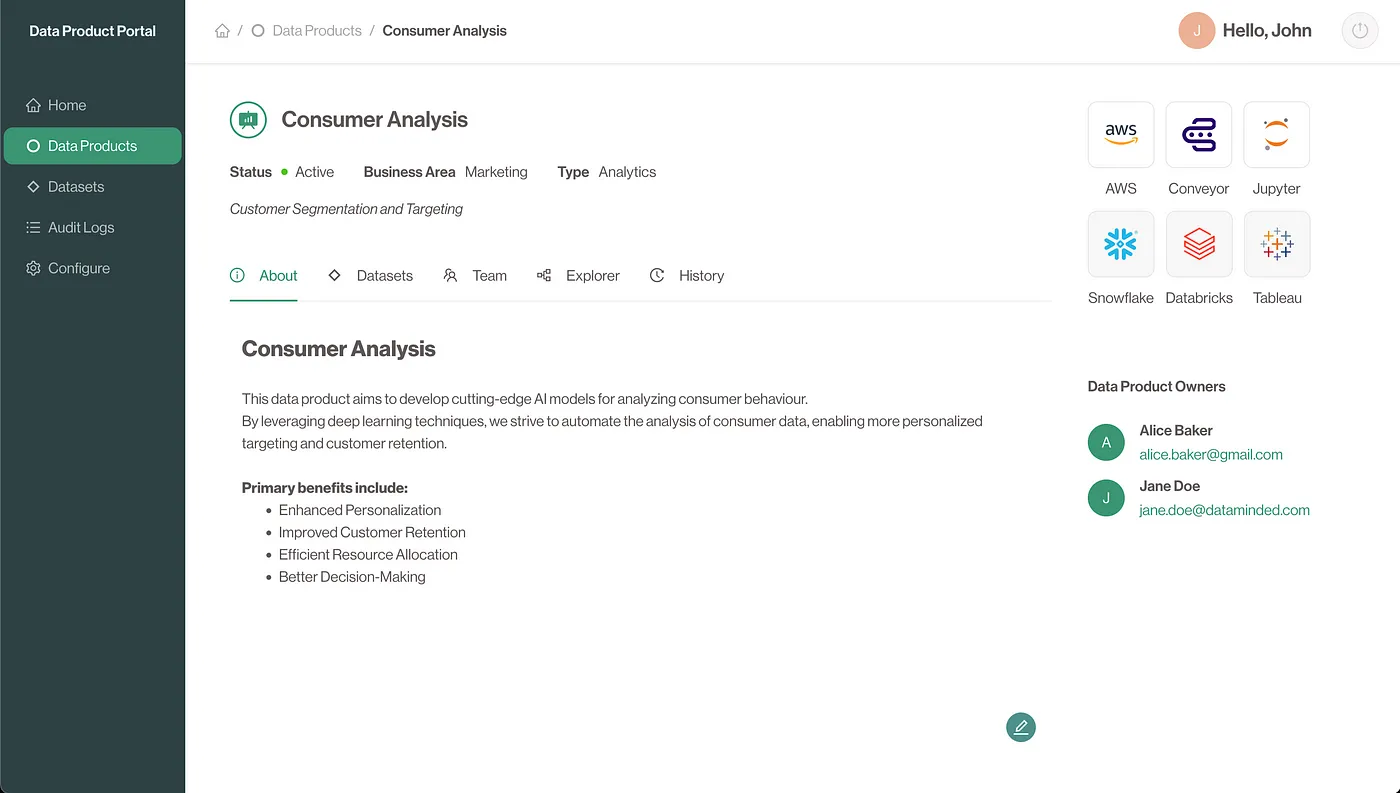
В прошлом месяце мы выпустили совершенно новый, полностью open-source проект: Портал продуктов данных . Для команд, которые хотят работать с подходом «Продукт данных», это отличный способ предоставить независимый от технологии интерфейс командам, занимающимся разработкой сценариев использования. Команды, работающие с прикладными задачами, могут определять новые продукты данных, добавлять пользователей в продукты данных, связывать наборы данных с продуктами данных... А за кулисами все это переводится на Вашу конкретную инфраструктуру, будь то Snowflake, Databricks или AWS.
Вот несколько скриншотов из нашей документации по API, которые помогут Вам понять, какой именно интерфейс мы предлагаем:
Рис.04
Не вдаваясь в подробности о каждой конечной точке, можно сказать, что этот интерфейс позволяет создавать и настраивать продукты данных независимым от технологии способом. Как это воплощается в реальном инструментарии - это уже другой вопрос.
И, конечно, не каждый пользователь разбирается в«API». И здесь на помощь приходит веб-UI.
Заключение
Смысл этой статьи в том, что, будучи инженером платформы, Вы должны делать больше, чем просто предлагать пользователям набор инструментов. Вы должны разработать интерфейс платформы данных, который не зависит от технологии и отвечает конкретным потребностям Вашей компании.
Если Вы разделяете принципы подхода «Продукт данных», тогда загляните на наш Портал продукта данных, который доступен на Github.


