

JOIN в ClickHouse... в 100 раз быстрее
Недавно мы представили два новых запроса на выгрузку в ClickHouse, которые будут доступны в версии ClickHouse 24.4. Эти изменения улучшают производительность JOIN во многих производственных сценариях, в некоторых случаях увеличивая скорость обработки запросов в сотни раз 9!)
Улучшение #1: pushdown предиката JOIN с помощью классов эквивалентности
Pushdown предикатов - это техника оптимизации запросов, используемая в системах управления базами данных для значительного сокращения объема данных, обрабатываемых запросом.
В ClickHouse, как и в большинстве других баз данных SQL, выполнение запроса делится на несколько этапов:
- Парсинг запроса.
- Анализ запроса.
- Построение логического плана запроса.
- Оптимизациялогического плана запроса.
- Построение физического плана запроса.
- Оптимизация физического плана запроса.
- Выполнение физического плана запроса.
В большинстве баз данных логический план запроса представляет собой дерево, в котором каждый узел – оператор реляционной алгебры а листья дерева плана запроса - источники данных, обычно сканы таблиц.
Представлять шаги плана запроса очень добно с помощью реляционной алгебры. Реляционная алгебра и ее операторы хорошо изучены, существует множество известных оптимизаций.
Одной из них является pushdown предиката.

Pushdown предиката повышает производительность запросов, приближая предикаты к операторам, которые сканируют данные. Ранняя фильтрация помогает последующим шагам плана запроса обрабатывать гораздо меньше данных, оптимизирует использование индексов и - в распределенных базах данных - значительно сокращает объем передачи данных между узлами.
Данный вид оптимизации может быть применен к большинству операторов реляционной алгебры, таких как проекции, агрегации, сортировки и объединения. Но наиболее важной оптимизацией является оптимизация предикатов шага JOIN, просто потому, что операторы JOIN обычно создают огромные объемы данных.
Важно отметить, что для некоторых операторов целесообразно передавать только часть предиката. В таком случае предикат сначала разбивается на части. В базах данных имеет смысл хранить предикаты в конъюнктивной нормальной форме, применяя, при необходимости, оптимизацию pushdown отдельно для каждой конъюнкции.
Пример:
CREATE TABLE test_table_1 (id UInt64, value String) ENGINE=MergeTree ORDER BY id;
CREATE TABLE test_table_2 (id UInt64, value String) ENGINE=MergeTree ORDER BY id;

INSERT INTO test_table_1 SELECT number, number FROM numbers(150000000);
INSERT INTO test_table_2 SELECT number, number FROM numbers(150000000);
SELECT * FROM test_table_1 AS lhs
INNER JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_1.id = 5;

Elapsed: 22.130 sec.
Processed 150.01 million rows, 3.79 GB (6.78 million rows/s., 171.21 MB/s.)
Peak memory usage: 18.41 GiB.
Давайте посмотрим на логический план ClickHouse для данного запроса:
EXPLAIN
SELECT * FROM test_table_1 AS lhs
INNER JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_1.id = 5
SETTINGS optimize_move_to_prewhere = 0

┌─explain──────────────────────────────────────────────────────────────────────┐
│ Expression ((Project names + (Projection + )))                               │
│   Join (JOIN FillRightFirst)                                                 │
│     Filter (( + (JOIN actions + Change column names to column identifiers))) │
│       ReadFromMergeTree (default.test_table_1)                               │
│     Expression ((JOIN actions + Change column names to column identifiers))  │
│       ReadFromMergeTree (default.test_table_2)                               │
└──────────────────────────────────────────────────────────────────────────────┘
В этом примере предикат перемещается на ЛЕВУЮ сторону JOIN. Обратите внимание, что я добавил SETTINGS optimize_move_to_prewhere = 0, потому что иначе шаг Filter был бы преобразован в PREWHERE для левой таблицы.
До версии ClickHouse 24.4 для JOINов использовалась простая версия оптимизации перетаскивания предикатов. Примечательно, что она не учитывала классы эквивалентности объединяемых столбцов (то есть эквивалентные столбцы после выполнения JOIN).
В PR #61216 мы представили более сложный анализ предикатов, который использует классы эквивалентности и может преобразовывать предикаты, применяемые к одной стороне JOIN, в предикаты, которые могут быть применены к другой стороне JOIN. Кроме того, предикат будет разбит на различные части, и только безопасные части будут перенесены вниз.
Рассмотрим пример:
SELECT * FROM test_table_1 AS lhs
INNER JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_1.id = 5;
- В этом примере столбец id из test_table_1 эквивалентен столбцу id из test_table_2, и мы можем преобразовать предикат test_table_1.id = 5 в test_table_2.id = 5, а также перенести его в нужную таблицу.
- Оптимизация pushdown фильтра для разных типов JOIN имеет разную логику:
- Для INNER JOIN мы можем перенести все предикаты на обе стороны JOIN. Мы также можем преобразовать предикаты, использующие только эквивалентные столбцы, со стороны LEFT в сторону RIGHT и наоборот.
- Для объединений LEFT/RIGHT мы можем переместить условия, использующие только столбцы из таблицы LEFT/RIGHT, на сторону объединения LEFT/RIGHT. Мы также можем преобразовать предикаты, использующие только эквивалентные столбцы, со стороны LEFT в сторону RIGHT для LEFT JOIN и со стороны RIGHT в сторону LEFT для RIGHT JOIN.
Давайте посмотрим на план запроса после внедрения этой оптимизации:
EXPLAIN
SELECT * FROM test_table_1 AS lhs
INNER JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_1.id = 5
SETTINGS optimize_move_to_prewhere = 0
┌─explain──────────────────────────────────────────────────────────────────────┐
│ Expression ((Project names + (Projection + )))                               │
│   Join (JOIN FillRightFirst)                                                 │
│     Filter (( + (JOIN actions + Change column names to column identifiers))) │
│       ReadFromMergeTree (default.test_table_1)                               │
│     Filter (( + (JOIN actions + Change column names to column identifiers))) │
│       ReadFromMergeTree (default.test_table_2)                               │
└──────────────────────────────────────────────────────────────────────────────┘
Теперь предикат может быть перенесен как на левую, так и на правую сторону JOIN. Мы также видим улучшение производительности запросов с INNER, LEFT и RIGHT JOIN в абсолютных цифрах:
SELECT * FROM test_table_1 AS lhs
INNER JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE lhs.id = 5

Before:

Elapsed: 22.130 sec.
Processed 150.01 million rows, 3.79 GB (6.78 million rows/s., 171.21 MB/s.)
Peak memory usage: 18.41 GiB.

After:

Elapsed: 0.005 sec.
Processed 16.38 thousand rows, 131.19 KB (3.21 million rows/s., 25.73 MB/s.)
Peak memory usage: 579.28 KiB.


SELECT * FROM test_table_1 AS lhs
LEFT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE lhs.id = 5;

Before:

Elapsed: 22.680 sec.
Processed 150.01 million rows, 3.79 GB (6.61 million rows/s., 167.06 MB/s.)
Peak memory usage: 18.42 GiB.

After:

Elapsed: 0.005 sec.
Processed 16.38 thousand rows, 131.19 KB (3.30 million rows/s., 26.45 MB/s.)
Peak memory usage: 579.28 KiB.


SELECT * FROM test_table_1 AS lhs
RIGHT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE rhs.id = 5;

Before:

Elapsed: 22.680 sec.
Processed 150.01 million rows, 3.79 GB (6.61 million rows/s., 167.06 MB/s.)
Peak memory usage: 18.42 GiB.

After:

Elapsed: 0.005 sec.
Processed 16.38 thousand rows, 131.19 KB (3.30 million rows/s., 26.45 MB/s.)
Peak memory usage: 579.28 KiB.
Полные результаты тестов на производительность от ClickHouse доступны по ссылке.
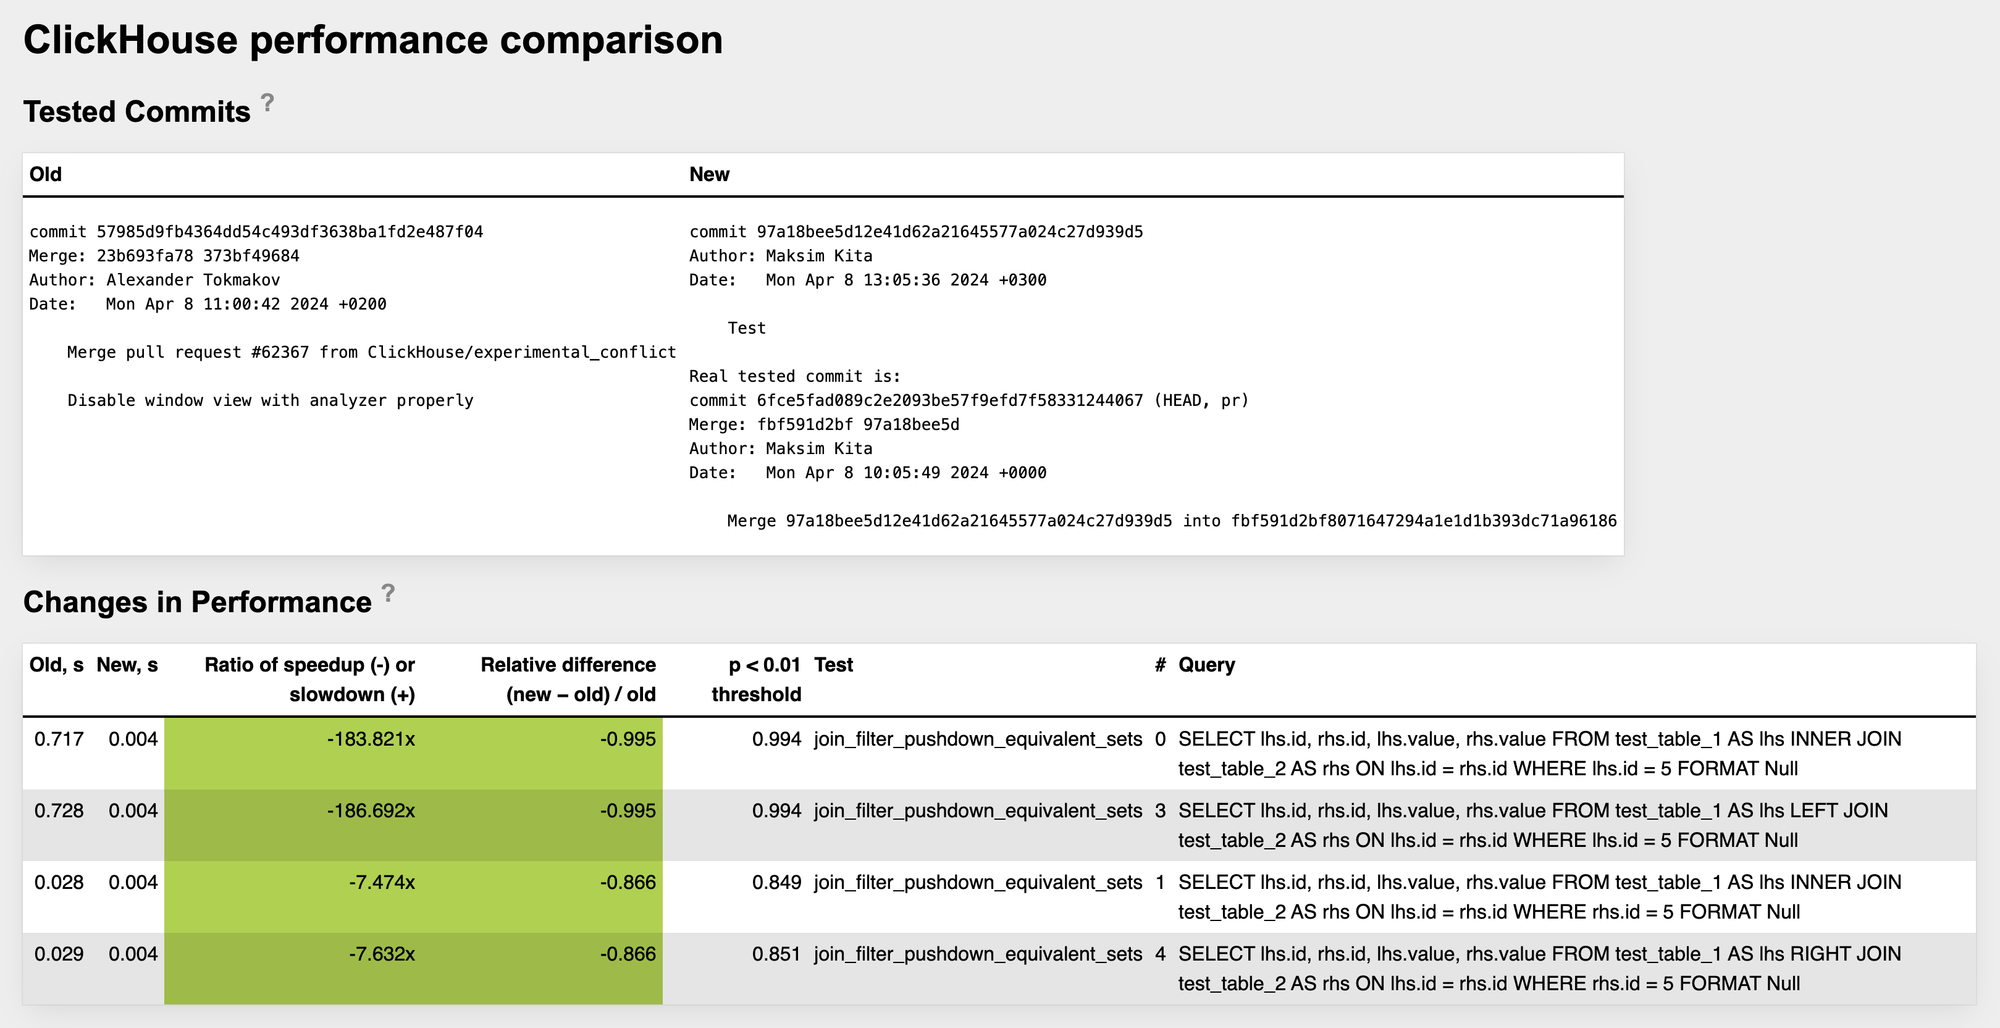
Эта оптимизация решает несколько проблем ClickHouse. Вот несколько примеров:
Улучшение #2: автоматическая конвертация OUTER to INNER JOIN
Мы внесли еще одно изменение, которое позволяет ClickHouse автоматически преобразовывать OUTER JOIN в INNER JOIN, если предикат после JOIN фильтрует все несмежные строки со значениями по умолчанию.
Эта техника дает дополнительные возможности для оптимизации, поскольку после преобразования JOIN из OUTER в INNER мы можем применять предикат pushdown в большем количестве сценариев.
Используя ту же таблицу, что и в предыдущей оптимизации...
SELECT * FROM test_table_1 AS lhs
LEFT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_2.id = 5

Elapsed: 27.680 sec.
Processed 300.00 million rows, 7.58 GB (10.84 million rows/s., 273.77 MB/s.)
Peak memory usage: 18.46 GiB.
Логический план запроса выглядит так:
EXPLAIN actions = 1
SELECT * FROM test_table_1 AS lhs
LEFT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_2.id = 5

┌─explain─────────────────────────────────────────────┐
│ Expression ((Project names + Projection))           │
│   Filter ((WHERE + DROP unused columns after JOIN)) │
│     Join (JOIN FillRightFirst)                      │
│     Type: LEFT                                      │
│     Strictness: ALL                                 │
│     Algorithm: HashJoin                             │
│     Clauses: [(__table1.id) = (__table2.id)]        │
│     ...                                             │
└─────────────────────────────────────────────────────┘
Примечание:
При actions = 1 мы можем увидеть больше деталей плана запроса, таких как тип JOIN, конкретные действия, которые будут выполнены, и другую полезную информацию. Обратите внимание, что я сохранил только ключевую часть плана запроса для того, чтобы мы могли увидеть, что у нас тип LEFT JOIN.
В этом примере предикат test_table_2.id = 5 всегда будет фильтровать несмежные строки из LEFT JOIN со значениями по умолчанию.
В #62907 мы представили анализ, который может автоматически преобразовать OUTER JOIN в INNER JOIN. В ходе этого анализа мы можем понять, что предикат после OUTER JOIN всегда будет фильтровать несмежные строки со значениями по умолчанию. В этом случае мы можем преобразовать OUTER JOIN в INNER JOIN.
Для этого мы попытаемся выполнить константное сворачивание предиката, выполняемого после OUTER JOIN, где мы заменим все столбцы с правой/левой стороны для LEFT/RIGHT JOIN на столбцы с постоянными значениями по умолчанию. Если результатом складывания предиката является постоянное значение False или NULL, мы можем преобразовать OUTER JOIN в INNER JOIN.
Вот план запроса после реализации этой оптимизации:
EXPLAIN actions = 1
SELECT * FROM test_table_1 AS lhs
LEFT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_2.id = 5

┌─explain────────────────────────────────────────┐
│ Expression ((Project names + (Projection + ))) │
│   Join (JOIN FillRightFirst)                   │
│   Type: INNER                                  │
│   Strictness: ALL                              │
│   Algorithm: HashJoin                          │
│   Clauses: [(__table1.id) = (__table2.id)]     │
│   ...                                          │
└────────────────────────────────────────────────┘
Здесь LEFT JOIN заменен на INNER JOIN. Мы видим, что шаг фильтрации уменьшился, поскольку для INNER JOIN лучше передавать test_table_2.id = 5 на обе стороны JOIN.
После применения оптимизации есть заметное улучшение производительности исходного запроса:
SELECT * FROM test_table_1 AS lhs
LEFT JOIN test_table_2 AS rhs ON lhs.id = rhs.id
WHERE test_table_2.id = 5

Before:

Elapsed: 27.680 sec.
Processed 300.00 million rows, 7.58 GB (10.84 million rows/s., 273.77 MB/s.)
Peak memory usage: 18.46 GiB.

After:

Elapsed: 0.004 sec.
Processed 16.38 thousand rows, 131.19 KB (3.96 million rows/s., 31.74 MB/s.)
Peak memory usage: 578.27 KiB.
В результатах тестирования производительности для INNER, LEFT и RIGHT JOIN мы видим значимое улучшение обработки запросов.
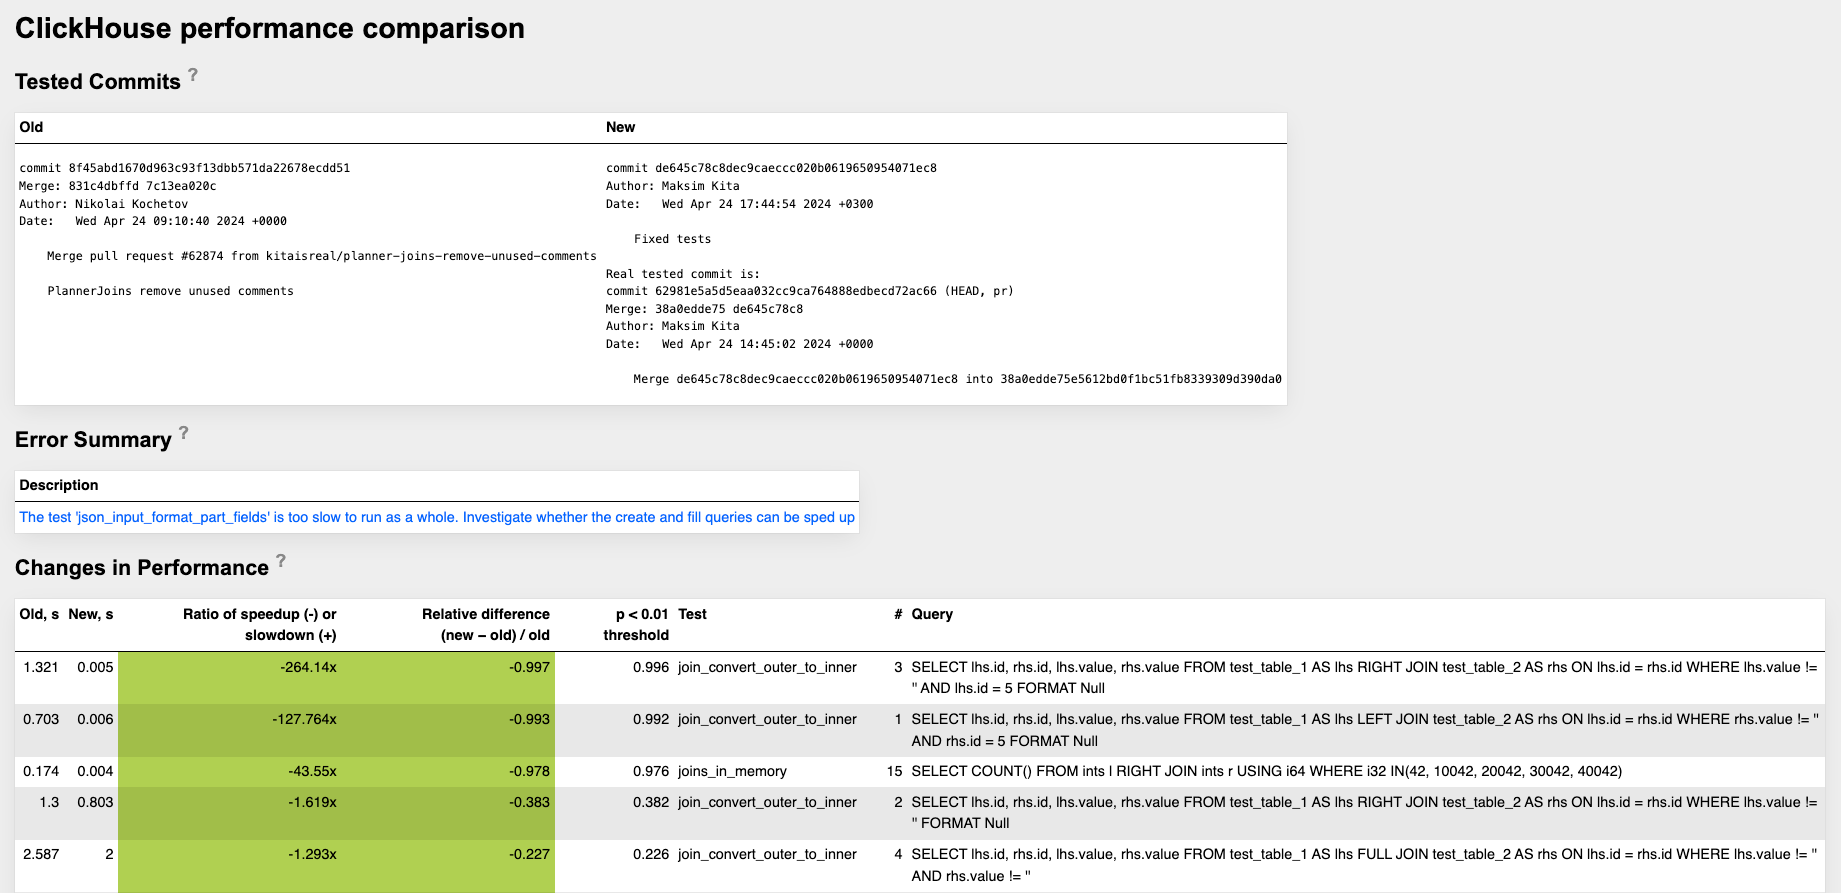
Заключение
В базах данных значительного повышения производительности можно добиться за счет использования высокоуровневых логических оптимизаций поверх плана запроса. Такие оптимизации хорошо работают вместе и могут быть объединены для обеспечения еще большего повышения производительности, как мы Вам и показали.
Эти два улучшения, которые доступны в ClickHouse 24.4, значительно повысили производительность JOIN во многих производственных сценариях ClickHouse.


