

Как компания Lyft сменила Druid на ClickHouse
В Lyft для аналитики в режиме, близком к реальному времени, и субсекундной аналитики мы использовали такие системы, как ClickHouse и Apache Druid. Системы субсекундных запросов позволяют исследовать данные практически в режиме реального времени и выполнять запросы с низкой задержкой и высокой пропускной способностью, что особенно хорошо для работы с данными временных рядов. Для наших клиентов это означает ускоренную аналитику данных в режиме реального времени и оперативное принятие решений, а тажк возможность построения точных прогнозов. Основанных на самой свежей информации. В целом, эти системы позволяют нам принимать своевременные юизнес-решения с точными прогнозами.
В этой статье мы расскажем Вам о том, как в Lyft используется Druid и что побудило нас перейти на ClickHouse в качестве системы субсекундной аналитики.
Druid в Lyft
Apache Druid -это распределенное хранилище данных с открытым исходным кодом, предназначенное для выполнения субсекундных запросов к данным реального времени и историческим данным. Druid обеспечивает низкую задержку (в реальном времени) при получении данных, гибкое исследование данных и быструю агрегацию данных, что приводит к субсекундным задержкам запросов.
В компании Lyft мы начали использовать Druid около шести лет назад в качестве первой интерактивной системы запросов в субсекундном пространстве. Изначально мы использовали Druid для геопространственных запросов практически в режиме реального времени и высокой производительности на наборах данных с высокой кардинальностью. Он также позволил нам оптимизировать работу с данными временных рядов и событий в масштабе.
Druid использует концепцию сегментов - единицы хранения, которая позволяет выполнять параллельные запросы и хранить данные в столбцах, а также эффективно сжимать и извлекать данные.
Архитектура Druid в компании Lyft
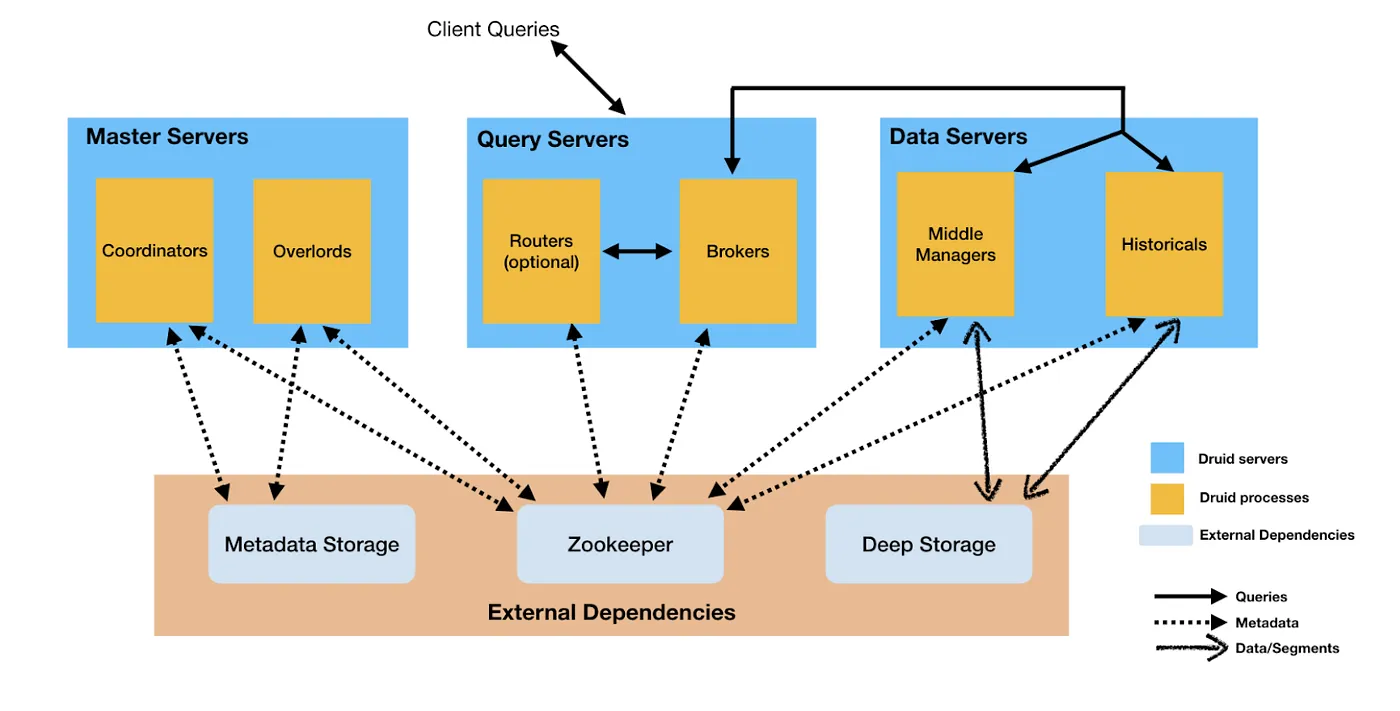
Поскольку Lyft является магазином Kubernetes, мы запустили все вышеперечисленные процессы в наших подсистемах Kubernetes с состоянием и без состояния в пространствах имен сервисов. Внешние зависимости для Druid управлялись нашими командами персистенции, а для глубокого хранения наших сегментов мы использовали Amazon S3.

Производительность Druid
Для повышения производительности запросов в Druid мы в первую очередь сосредоточились на двух типах оптимизации: rollup и compaction.
1. В компании Lyft мы использовали rollup как технику предварительной обработки данных, которая агрегирует и уменьшает степень детализации данных перед их хранением в сегментах. Предварительное агрегирование данных на этапе их получения позволило оптимизировать производительность запросов и снизить затраты на хранение данных.
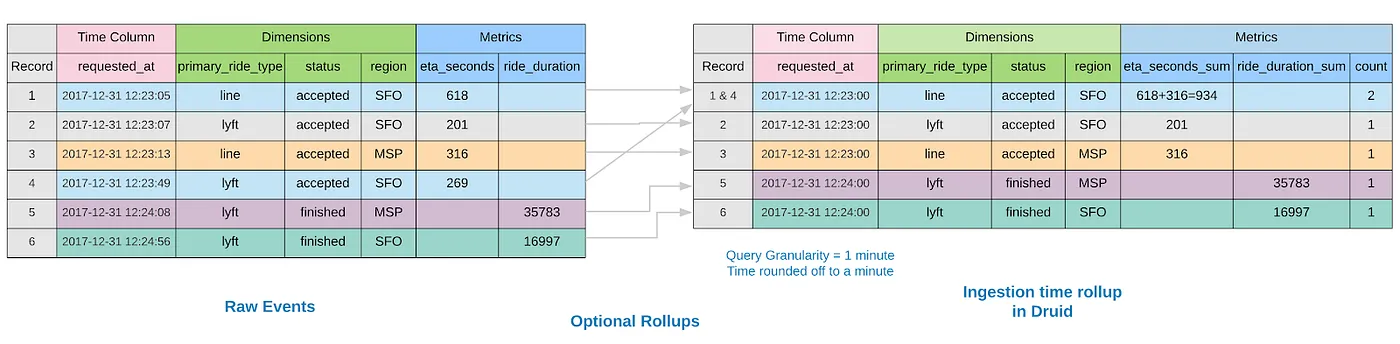
2. Compaction использует пакетную обработку для объединения множества небольших фрагментированных сегментов в меньшее количество оптимизированных сегментов, что еще больше повышает производительность запроса.
Захват данных в системе Druid
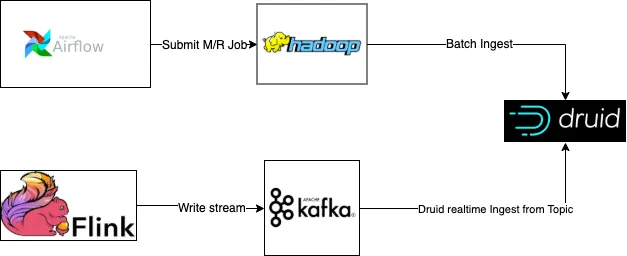
Наш конвейер обработки данныхпредполагает два способа ввода данных в Druid - верхний процесс предназначен для пакетного ввода, нижний - для ввода в реальном времени.
Ввод данных в режиме реального времение
События из нашего аналитического конвейера реального времени были настроены на отправку в наше внутреннее приложение Flink, потоковую передачу в Kafka и запись в Druid. Это была наша основная форма приема информации.
Пакетный ввод данных
Наш конвейер пакетного ввода данных служил в качестве резервного метода ввода данных для резервного заполнения и задач обслуживания, в частности:
- Заполнения, покрывающие любые потери данных или простои в режиме реального времени.
- Задачи обслуживания, такие как уплотнение сегментов
Настройки ввода данных в Druid
Для того чтобы подключить к Druid конкретный сценарий использования, нашим клиентам нужно было обеспечить потоковую передачу событий в наше приложение Flink с правильными преобразованиями, если это было необходимо, и определить файлы proto для сериализации и десериализации данных в Kafka, чтобы подготовить их к вводу в Druid. Затем им нужно было определить спецификацию вхождения, которая указывает Druid, как обрабатывать вводимые данные.
Спецификация вхождения в Druid содержало следующее:
- Схема источника данных: имя, гранулярность запроса/сегмента, временная метка, размерность, метрики и т. д.
- ioConfig: Информация о сервере Kafka, имена тем и т. д. (например, tuningConfig)
druid: {
ioConfig: {
taskCount: 3
replicas: 2
taskDuration: PT15M
completionTimeout: PT60M
earlyMessageRejectionPeriod: PT2H
}
tuningConfig: {
intermediatePersistPeriod: PT5M,
maxRowsPerSegment: 15000000
maxRowsInMemory: 500000
resetOffsetAutomatically: true
}
}
kafka {
partitions: 3
}
В каких случаях компания Lyft использовала Druid
С помощью Druid были реализованы важные сценарии использования Lyft, включая модели ценообразования и кампании, созданные и проанализированные нашей командой по кампаниям и коммуникациям. Кроме того, наша команда экспериментаторов использовала хранилище данных для анализа данных последних экспериментов.
Управление Druid и некоторые основные трудности
В компании Lyft основными пользователями Druid были инженеры по обработке данных и разработчики программного обеспечения. Одним из основных препятствий, с которым мы столкнулись при привлечении новых пользователей, было резкое увеличение объема работ по написанию и сопровождению спецификаций поглощения данных, а также понимание различных механизмов настройки для каждого случая использования.
Это требовало следующего:
- Обеспечения правильного формата вводимых данных
- Исправления последующих конвейеров ввода данных для случаев использования с любыми изменениями в предыдущих версиях.
- Создания файлов спецификаций для пользователей, хорошо разбирающихся в семантике Python/SQL, но не в технологиях, специфичных для Druid
Эти блоки затрудняли поиск новых клиентов и повышение уровня внедрения. Со временем из-за отсутствия окупаемости инвестиций в Druid стали вкладывать недостаточно средств, несмотря на существующие и активно используемые критические сценарии использования для отслеживания расходов, краткосрочного прогнозирования и сигнализации.
Примерно в это же время компания Lyft стала работать гораздо бережливее, реализуя различные инициативы по сокращению расходов. Для новых инженеров платформы это создало более сложную кривую обучения. Эта фаза экономии означала, что мы расставили приоритеты и поэтому не могли быстро обновлять или поддерживать последние исправления производительности Druid.
Кроме того, когда около трех лет назад Lyft перешла на Kubernetes Compute, появился дополнительный уровень сложности, что увеличило трудозатраты команды, поскольку в обновленной системе работало несколько кластеров Druid с большим количеством компонентов.
Учитывая все эти факторы, мы хотели сделать шаг назад и переоценить свой выбор, чтобы понять, могут ли другие технологии принести нам более результативный эффект.
ClickHouse в Lyft
Что такое ClickHouse?
ClickHouse - это база данных с открытым исходным кодом, ориентированная на столбцы и предназначенная для аналитической обработки данных в режиме онлайн. Одним из отличительных факторов ClickHouse является высокая производительность, обусловленная сочетанием таких факторов, как хранение и обработка данных на основе столбцов, сжатие данных и индексирование.
Первоначальный вариант использования
В 2020 году, пока команда платформы данных управляла Druid, команда рынка рассматривала новый набор требований:
- Создаваемые данные должны быть немедленно доступны для запросов в режиме, близком к реальному времени
- Задержки в секундах для создания дашбордов.
- Ввод данных для быстрой нарезки наборов данных. (Например: сколько поездок было совершено за последние 2 часа в регионе SF?)
- Поддержка вложенных данных
- Поддержка ввода данных как в режиме реального времени, так и в пакетном режиме.
- Встроенная дедупликация данных в месте назначения
Хотя последняя версия Druid предоставляет нам некоторые из этих возможностей, такие как вложенные соединения (v0.18), другие требования, такие как дедупликация в месте назначения, оставались неудовлетворенными. Используя наш существующий стек, мы рассматривали возможность выполнения дедупликации на потоковом уровне, а не в месте назначения.
Однако две основные причины не позволили нам реализовать эту идею:
- Мы хотели выполнять это на уровне Destination Storage, чтобы дедуплицировать данные между потоковой и пакетной загрузкой.
- Потоковые решения требуют установки окна изменяемости для каждой сущности (например, 24 часа за поездку). Это было жесткое требование со стороны бизнеса из-за возможных сценариев обновления уже записанных в хранилище транзакционных сущностей. К этому добавлялась потребность в том, чтобы сущность можно было запросить как можно скорее (например, в конце поездки, если не раньше).
В итоге мы пришли к выводу, что должны иметь возможность перезаписывать записи по мере необходимости, используя средства дедупирования. С учетом всех этих входных данных мы решили остановиться на ClickHouse.
Решение: ClickHouse или Druid?
ClickHouse набрал обороты благодаря нашим сценариям использования рыночных площадок, что привело нас к ряду вопросов: стоит ли нам расширяться на другие сценарии использования? Может ли ClickHouse поддерживать все наши сценарии использования Druid? Стоит ли нам продолжать использовать обе системы или объединить их в одну?
После тщательного и глубокого анализа стоимости, управления инфраструктурой и общих преимуществ мы решили расширить ClickHouse и закрыть Druid, перенеся все существующие сценарии использования Druid в ClickHouse. Ниже перечислены некоторые преимущества ClickHouse по сравнению с Dru:
- Упрощенное управление инфраструктурой - в связи с переходом Lyft на более компактную команду и архитектуру было решено перейти на систему с меньшими требованиями к управлению и обслуживанию. Druid, благодаря своей модульной конструкции, оказалась более сложной в обслуживании системой.
- Сокращение сроков обучения - наши пользователи хорошо разбираются в семантике Python и SQL по сравнению с Java и т. д. Благодаря более знакомому языку и инструментарию, освоение их сценариев использования займет меньше времени. Например, определение ключа сортировки и типа двигателя в определениях объектов с TTL будет более коротким процессом обучения по сравнению с определением этих параметров в спецификации Druid.
- Дедупликация данных - рассматривается в разделе «Начальный пример использования» выше.
- Стоимость - для Lyft, как компании, использующей Kubernetes Compute, запуск ClickHouse через Druid значительно сократил вычислительные ресурсы. Более экономный режим работы с лучшими определениями TTL при 1/8 стоимости был большим плюсом.
- Специализированные движки - типы движков ClickHouse Replicated*, Replacing* и Kafka Engine - позволяют Lyft нативно управлять всасыванием на основе Kafka, а также поддерживать высокую доступность (HA) за счет репликации на разных узлах.
Бенчмаркинг, производительность и миграция
Мы создали набор тестов для бенчмаркинга и провели их в контролируемой среде, сравнивая производительность запросов в ClickHouse и Druid.
Мы привлекли к этим тестам всех заинтересованных пользователей и взяли запросы, выполняющиеся в нашей производственной системе Druid, динамически преобразовали их в синтаксис ClickHouse и запустили оба запроса в Druid и ClickHouse соответственно,а затем Мы сравнили задержки запросов и выявили узкие места в ClickHouse.
В паре наших экспериментальных примеров использования ClickHouse мы наблюдали ненадежную (скачкообразную, повышенную) производительность задержки из-за ключа сортировки таблицы и запроса, приводящего к полному сканированию таблицы. Поскольку форма запроса была постоянной, а запрашиваемые данные можно было агрегировать предварительно, помогло добавление проекций в ClickHouse.
Проекции - это, по сути, предварительно вычисленные представления ваших данных, которые вычисляют только необходимые столбцы, и вместо того чтобы выполнять полное сканирование таблицы, ClickHouse просто сканирует столбец проекции. Помимо улучшения производительности запросов для пары экспериментальных случаев, проекции также помогли сократить количество операций ввода-вывода.
Мы измеряли корректность (по количеству возвращенных строк и разнице между точными результатами таблицы) и задержку, а также использовали многоуровневую миграцию с использованием ClickHouse на 1%, 5%, 10%, 20%, 50% и затем 100%. В итоге мы получили выигрыш в задержке, о чем поговорим в последующих разделах.
Архитектура ClickHouse в Lyft
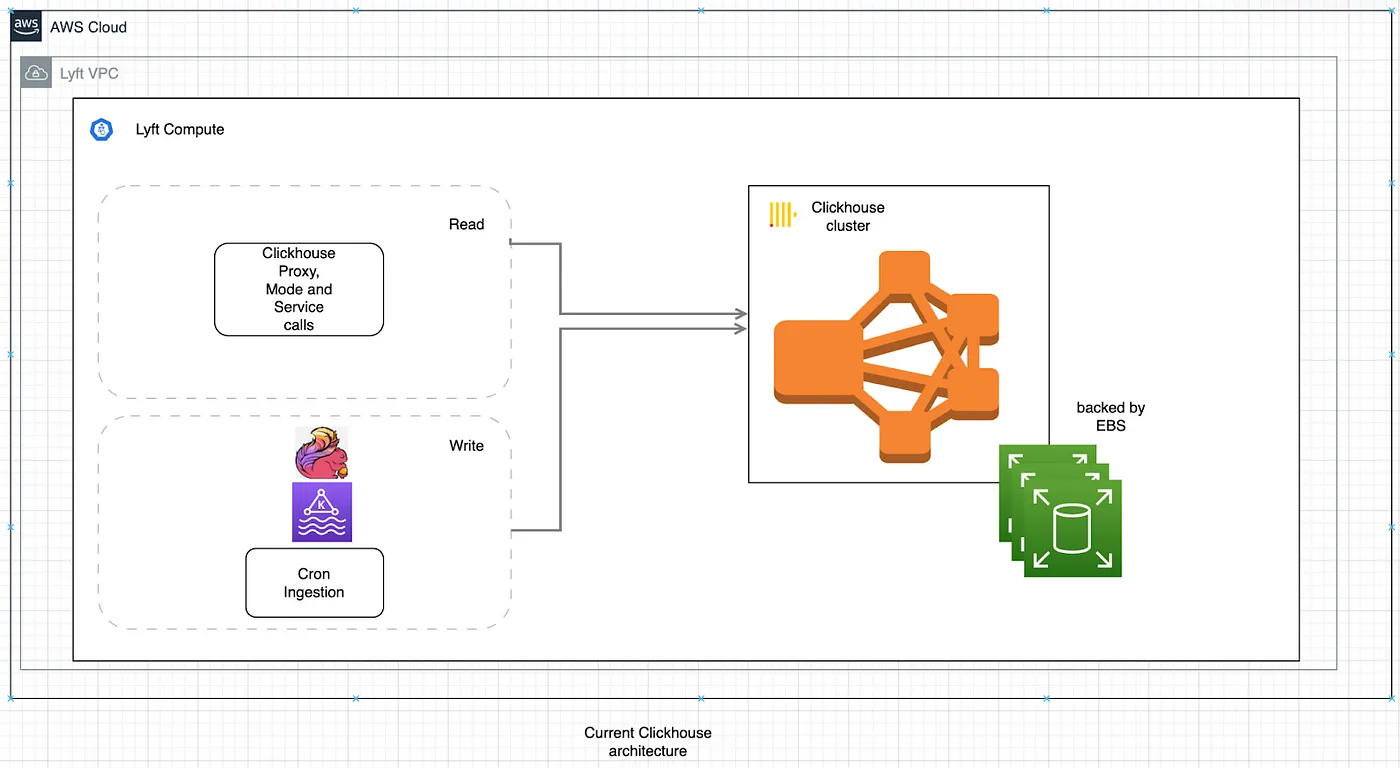
Для развертывания кластеров ClickHouse мы использовали Оператора Kubernetes от Altinity . В настоящее время мы используем версию ClickHouse 21.7 и планируем обновиться до последней версии. В качестве хранилища мы используем расположенные вместе тома EBS в нашем государственном кластере Kubernetes. Мы запускаем наши кластеры в режиме HA с вычислительными инстансами общего назначения AWS M5-типа, при этом объекты базы данных реплицируются между узлами. В настоящее время мы не используем шардинг на наших кластерах, но есть планы по оптимизации производительности кластера по мере расширения масштаба.
Ввод данных ClickHouse подробно рассматривается ниже. Запросы на чтение в ClickHouse выполняются через наш внутренний прокси-сервер с ACL и инструментами визуализации, такими как Mode.
Ввод данных ClickHouse
В нашей инфраструктуре ClickHouse мы обрабатываем входящие данные с помощью трех отдельных конвейеров.
- Kafka → ClickHouse: эти данные используются в основном нашими сервисами, работающими по модели pub-sub. ClickHouse является одним из подписчиков на эти данные. В ClickHouse есть встроенная поддержка KafkaTableEngine, которая использует механизм чтения из тем кластера Kafka, основанный на извлечении. Ежедневно в ClickHouse поступает до 2 миллиардов записей из кластера Kafka.
- Kinesis → Flink → ClickHouse: Эта схема я пополняет данные о наших мероприятиях в ClickHouse. Команды по организации мероприятий, которым нужны данные в ClickHouse для аналитики, подключаются через этот механизм. Lyft генерирует около 600 миллионов строк в день в ClickHouse только за счет поглощения данных из Flink.
- Trino → Cron → ClickHouse: Мы также поддерживаем пакетный ввод данных из наших автономных систем через Trino. В основном это используется для экспорта наборов данных, полученных в результате анализа состояния рынка, для быстрого определения состояния рынка.
В дальнейшем мы будем изучать возможность объединения наших конвейеров реального времени, чтобы вводить все через Kafka для упрощения архитектуры и снижения затрат.
Оптимизация ClickHouse
Ключ сортировки
Ключ сортировки помогает определить, как данные физически организованы на диске, а также в разы ускоряет выполнение запросов. Если данные отсортированы по определенным столбцам, часто используемым в запросах, база данных может пропускать большие порции нерелевантных данных во время выполнения запроса. Для наших наборов данных, основанных на временных рядах, многие таблицы отсортированы по времени события (event_time или occurred_at time). Это также помогает при выполнении запросов на основе временных диапазонов. Наряду с уменьшением объема операций ввода-вывода за счет последовательного доступа к таким данным, ключи сортировки значительно повышают производительность запросов.
Выбор правильного ключа сортировки можно легко определить исходя из типа запросов, которые будут выполняться к этим наборам данных.
Индексы Skip
При запросе данных с фильтрами, где ключ сортировки не определен, мы рискуем получить полное сканирование каждого столбца, чтобы применить предложение WHERE. Для оценки таких неиндексированных запросов мы используем индексы Skip, где ClickHouse использует индексный файл, чтобы понять, какие блоки данных могут быть пропущены. В компании Lyft мы в основном использовали индексы minmax для повышения производительности запросов.
ALTER TABLE <database>.<table> ON cluster <cluster> ADD INDEX logged_at_idx (logged_at) TYPE minmax GRANULARITY 8192
Затем мы материализуем этот пример индекса на уже существующих данных. Это позволяет ClickHouse пропускать ненужные блоки данных и минимизировать операции ввода-вывода при выполнении запросов, что снижает наши сквозные задержки.
Проекции
Одним из требований наших клиентов при переносе было сохранение или снижение задержки. Хотя большинство транспилированных запросов ClickHouse выполнялись с более быстрым временем выполнения, наши другие запросы, которые регулярно опрашивали последние временные метки экспериментов, были намного медленнее.
Мы использовали возможности проекций ClickHouse, в частности создали и материализовали проекцию SELECT max(occurred_at) для предварительного вычисления и хранения последней временной метки. С помощью этой проекции сканируется только пара тысяч строк, а не вся таблица, что ускоряет проверку состояния с ~20 секунд до субсекунды.
В каких случаях мы используем ClickHouse
Сегодня мы используем ClickHouse для следующих целей:
- Состояние рынка
- Отчетность по политике в отношении велосипедов и скутеров
- Отслеживание расходов
- Прогнозирование и рыночные сигналы
- Эксперименты
- Кампании
В компании Lyft мы ежедневно получаем десятки миллионов строк и выполняем миллионы запросов на чтение в ClickHouse, объемы постоянно растут. В месяц это означает чтение и запись более 25 ТБ данных.
Проблемы, связанные с управлением ClickHouse
Хотя процесс миграции прошел гладко, в обновленной системе возникли некоторые проблемы:
- Производительность кэширования запросов - иногда мы наблюдаем значительную переменную задержку, что затрудняет выполнение обещание по SLA для определенных рабочих нагрузок. Использование кэша запросов с соответствующим размером кэша и TTL помогает. На начальном этапе, когда кэш наполняется, производительность запросов может меняться, но скачки задержек очень кратковременны.
- Проблемы Kafka с интеграцией MSK - мы широко используем Kafka Table Engine, который является механизмом ингестирования на основе тяги и поддерживается в ClickHouse. В Kafka Table Engine схема аутентификации, используемая для SASL, - SCRAM-SHA-256. librdkafka - это библиотека на языке C, используемая ClickHouse для получения данных из Kafka. При попытке получить данные из Amazon Managed Kafka (AWS MSK) для нового случая использования оказалось, что механизм SASL AWS_MSK_IAM (механизм SASL от AWS) не поддерживается в librdkafka (Confluent). Решение здесь - попробовать Kafka Connect / MSK Connect, чем мы и займемся после обновления ClickHouse.
- Устойчивость конвейера ввода данных - наш Flink в ClickHouse основан на модели push, и когда ZooKeeper выполняет разрешение конфликтов, он может пометить таблицу как доступную для чтения, что приведет к сбоям в модели push. Мы изучим более эффективный подход на основе push с Kafka Connect в ClickHouse и используем Kafka между Flink и ClickHouse для потоковой записи и хранения в Kafka, в то время как Kafka Connect может пакетно записывать в ClickHouse..
Что дальше?
Есть три основные области для расширения ClickHouse в Lyft:
- Стабилизация архитектуры пакетного ввода данных с помощью потокового ввода данных Kinesis через Kafka - мы работаем над стабилизацией нашей архитектуры пакетного ввода данных с переходом на более устойчивую платформу оркестровки Apache Airflow, которая в основном используется в Lyft.
- Перенос Flink SQL в ClickHouse - определенные преобразования Flink могут быть выполнены непосредственно в месте назначения в ClickHouse. Мы планируем использовать ClickHouse для множества новых сценариев использования.
- Отказ от ZooKeeper - в настоящее время мы используем Apache ZooKeeper для управления состояниями в ClickHouse. В ближайшее время мы обновим ClickHouse и изучим ClickHouse Keeper для того, чтобы уменьшить зависимость от внешних компонентов.


